
はじめに
TYPESAFE AI から、テキストではなく「構造化された決定」を返すことに特化した新しいモデル Jev が公開された。
https://typesafe.ai/
従来の LLM とは性格が異なり、選択肢からの選択や分類といったタスクに向くという。
公開直後ではあるが、弊社が開発・公開している無料の統計解析 Web アプリ Reactive Stat の「AI から統計処理の提案を受ける」機能へ実際に組み込んでみたところ、期待以上に速く・確実だった。本記事はその使い方と所感の記録である。
Reactive Stat — ブラウザだけで使える無料の統計ソフト
信頼性の高い R で統計解析を行い、その結果を AI が解説する。
今回 Jev を使った機能「AI から統計処理の提案を受ける」は、手元にデータがあって「何を調べたいか」は決まっているものの、どの統計手法を使えばよいか分からない、というときに、データと目的から適切な手法を提案するものである。
実際に稼働中: https://www.emuyn.net/stats/get_ai_proposal

このタスクを一般化すると、「選択肢の中から適切なものを選ばせ、その理由も書かせる」という頻出パターンになる。問い合わせのルーティング、ドキュメントのタグ付け、手法や商品の推薦などが該当する。これを LLM 単独で行うと、次の問題が起きやすい。
- 選択肢に無い値を出力する (ハルシネーション)
- 選択の確からしさが数値で得られない
- 毎回の推論が重く、応答が数十秒かかる
本記事では、TYPESAFE AI の決定モデル Jev を使い、「選択は Jev、説明文は LLM」という役割分担 (ハイブリッド構成) でこれらを解消した事例を、API 呼び出しコードとともに整理する。統計解析 Web アプリで「データと目的から適切な統計手法を選ぶ」機能に適用したが、パターン自体は分類・ルーティング全般に再利用できる。
Jev (System One モデル) の特徴
Jev は「テキストを生成する」モデルではなく、「構造化された決定を返す」モデルである。
- 事前定義した型の値しか返さない。選択肢に無い値や型エラーが構造的に発生しない
- 出力に確信度が付く。各選択肢に校正済み確率 (probability)、回答全体に確信度 (confidence) が付随する
- 高速・低コスト。応答は 1 〜 1.5 秒程度。入力は $0.042/M、出力は無料
-
質問型は 3 種。
choice(選択肢から 1 つ)、score(順序尺度で採点)、noul(Yes/No 確率)
一方で、自由文の生成 (理由や要約) はできない。そこは従来の LLM が担う。この境界を意識することが設計の出発点になる。
設計方針: 決定は Jev、説明は LLM
処理を 2 段に分ける。
入力 (目的 + 対象データの要約)
  │
  ├─① Jev (choice) ──→ 選択肢を確率つきでランキング   … 約1.5秒。まず即表示
  │
  └─② LLM ──────────→ 確定した選択肢についてのみ理由文を生成 … 数十秒。後から埋める
- ① で「何を選ぶか」を確定させる。選択肢集合 (criteria) は Jev に渡すので、返ってくる値は必ずその集合内。捏造が起きない
- ② の LLM には、もう選択肢集合を渡さない。「①で確定したこの項目について理由を書け」と指示するだけでよい。入力が大幅に減り、説明生成も速くなる
- ① の結果 (ランキングと確信度) を先に画面へ出し、② の理由文は後から各項目に差し込む。体感速度が改善する
Jev API の使い方
エンドポイントと認証
POST https://api.typesafe.ai/v1/systemone- ヘッダ
Authorization: Bearer <API_KEY> - モデル
jev-latest
リクエスト (choice の例)
state に判断材料 (目的や対象データの要約) を、criteria に選択肢とその説明を渡す。criteria は {選択肢名: 説明} の連想配列で、選択肢は最大 255 個まで指定できる。
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -d '{
    "state": "2群(投与/対照)で連続値の検査値に差があるか調べたい。検査値は非正規(歪度1.8)。",
    "model": "jev-latest",
    "questions": {
      "method": {
        "type": "choice",
        "instructions": "データと目的に最も適した手法を1つ選べ。",
        "criteria": {
          "対応のない群間の検定": "2群の連続量の差を検定。非正規ならノンパラメトリック",
          "相関と回帰": "2つの連続変数の関連・予測",
          "分割表": "クロス集計・関連・オッズ比"
        }
      }
    }
  }'
(実際にはもっと複雑な配列を渡しているが、ここでは説明目的ですので簡略化しています)
レスポンス
{
  "answers": {
    "method": {
      "type": "choice",
      "choice": "対応のない群間の検定",
      "confidence": 0.91,
      "probabilities": {
        "対応のない群間の検定": 0.91,
        "相関と回帰": 0.06,
        "分割表": 0.03
      }
    }
  },
  "usage": { "input_tokens": 12346, "output_tokens": 34 }
}
-
choice: 最も確率の高い選択肢 -
probabilities: 全選択肢の確率分布 (合計 1.0)。降順に並べれば上位 N のランキングになる -
confidence: 確率の集中度。低いほど「判断が割れている」ことを示す
実装の要点
① 選択肢を確率順にランキングする
probabilities を降順にし、しきい値以上の上位数件を取り出す。以下は PHP の例だが、考え方は言語を問わない。
$answer = $response['answers']['method'];
$probs  = $answer['probabilities'];
arsort($probs);                       // 確率の降順

$ranked = [];
foreach ($probs as $name => $p) {
    if (count($ranked) >= 4) break;                 // 最大4件
    if ($p < 0.05 && count($ranked) >= 1) break;    // 0.05未満は足切り(最低1件は残す)
    $ranked[] = ['name' => $name, 'probability' => $p];
}
// $ranked と $answer['confidence'] をフロントへ返す
選択肢名 (criteria のキー) を、そのまま画面のリンクや後続処理の識別子として使えるように設計しておくと、choice の値を直接キーにできて扱いやすい。
② 確定した選択肢について理由文を LLM に書かせる
②では選択肢集合を渡さず、①で確定した項目だけを渡す。プロンプトは「渡された項目について理由を書け。項目の追加・変更は禁止」と制約する。フロント側の 2 段呼び出しは次のようになる。
// ① 決定
const jev = (await axios.post('/api/jev', { state })).data;   // { ranked, confidence }
render(jev.ranked, jev.confidence);                           // まずランキングを即表示

// ② 説明 (確定項目のみを渡す。選択肢集合は渡さない)
const items = jev.ranked.map((r, i) => `${i + 1}. ${r.name}`).join('\n');
const reasons = (await axios.post('/api/llm', {
  instruction: '以下の確定項目について、それぞれ適する理由を書け。項目の追加・変更は禁止。',
  items,
  state,
})).data;
mergeReasons(reasons);                                        // 各項目に理由文を差し込む
確信度の活用
confidence は「回答の内容」とは別の軸として使うと効果的である。
- 高いとき: 上位 1 件を主提案として提示
- 低いとき (例: 0.5 未満): 「判断が割れています」と明示し、下位候補も併記する、あるいは人間の確認を促す
choice が「何を」を、confidence が「そのまま採用してよいか」を教える、と捉えるとよい。
実測値
統計手法カタログ 85 件 (choice の上限 255 に収まるため分割不要) を対象にした際の実測は次の通り。
| 指標 | 値 |
|---|---|
| Jev の応答時間 | 約 1 秒 |
| Jev の入力トークン | 約 15,000 (選択肢集合を毎回送るため) |
| Jev のコスト | 約 $0.0005 / 回 |
| 説明文生成 (LLM) | 約 25 秒 |
確信度の挙動も直感に合う。目的が明確なケースでは confidence が 0.8 以上で単一候補に集中し、判断が割れるケースでは値が下がり、複数候補が拮抗した。
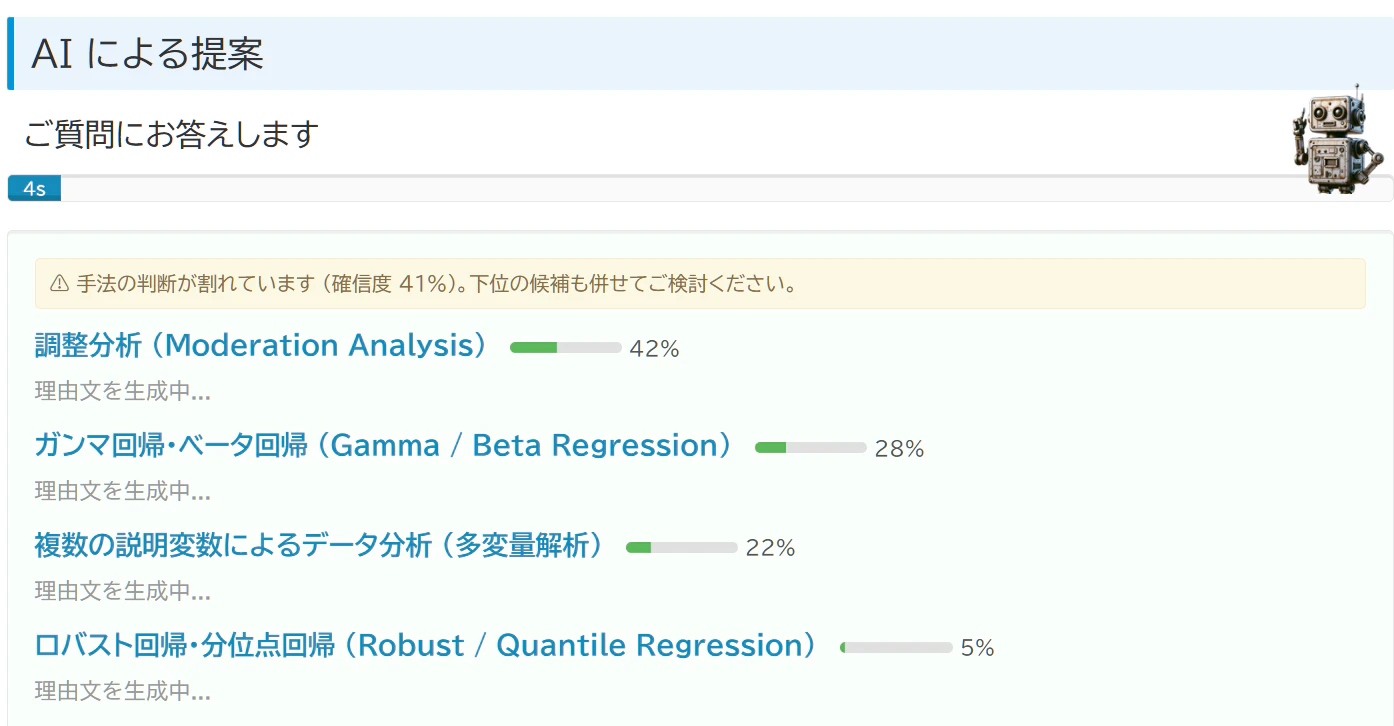
(この中間段階の表示までは本当に一瞬です)
まとめ
- 選択肢が有限なタスクは、LLM ではなく 決定モデル (Jev) で選ばせると、捏造ゼロ・確信度つき・高速という 3 点を同時に得られる
- 説明文が必要なら、Jev で決定 → LLM で説明のハイブリッドにする。LLM には選択肢集合を渡さず確定項目だけを渡すことで、入力が減り高速化する。ハルシネーションが入り込む余地がない
-
probabilitiesでランキング、confidenceで採用可否を分岐する、という 2 軸の使い分けが実運用の鍵になる
実際にこの構成で動いている機能は、Reactive Stat (ブラウザだけで使える無料の統計ソフト) の「AI から統計処理の提案を受ける」で試せます。
https://www.emuyn.net/stats/get_ai_proposal
参考
- Jev / System One の紹介: https://typesafe.ai/blog/introducing-system-one-models-and-jev
- Quickstart: https://docs.typesafe.ai/introduction/quickstart
-
choiceの仕様: https://docs.typesafe.ai/primitives/choice