

AIスクレイパーとは?構築済み・プロンプト型の選び方と、抽出結果を検証する手順
AIスクレイパーとは、AIがWebページの内容を解析し、商品名や価格などの項目を自動で抽出してCSVやJSON形式で出力するツールです。始め方は以下の3ステップです。
- 対象サイトに構築済みのスクレイパーが存在するか確認する。
- 存在しない場合は、取得したい項目を自然言語の指示で伝えてスクレイパーを作成する。
- 10〜20件を元ページと照合してから、定期実行に切り替える。
Bright Data では、構築済みの Web Scraper API が利用できるサイトであればそれを使用し、対象外のサイトは Scraper Studio にプロンプトを渡して作成します。サイトが変更された場合は Scraper Studio が自己修復します。毎月5,000クレジットの無料枠があり、クレジットカードは不要です。コードを書かない単発作業であれば、Thunderbit のようなブラウザ拡張機能も選択肢となります。
AIスクレイパーとは何ですか?従来のスクレイピングとの違いは?
AIスクレイパーは、ページ内容をAIが解析して項目を特定し、表形式のデータとして出力するツールです。処理は「HTMLの取得」「AIによる項目の解釈」「CSVやJSON形式での出力」の3段階で進みます。従来型のスクレイピングがCSSセレクタ・XPath(HTML上の位置を指定する記法)で取得位置を固定するのに対し、AI型は自然言語の指示や自動提案された項目名を手掛かりに、ページごとの構造の違いを吸収します。
| 比較項目 | 従来型(CSSセレクタ・XPath) | AI型 |
|---|---|---|
| 設定方法 | サイトごとにHTML構造を調べて取得位置を記述 | 取得したい項目名や自然言語の指示を入力 |
| サイト変更への耐性 | 要素の位置が変わると即座に破損 | 意味に基づいて項目を探すため耐性は高い(完全ではない) |
| コスト | 初期の開発工数が大きい(実行時の単価は小さい) | 設定工数は小さい(課金形態は製品によって異なる) |
| 出力の揺れ | 同一ページであれば常に同一の結果 | 実行ごとに表記の差や欠損が生じる可能性あり |
AIが担うのは「解釈」のみであり、HTMLの取得とブロック回避は別の層です。AIスクレイパーを選ぶ際は、以下の3層に分けて考えると判断を誤りにくくなります。
- 取得層:ページのHTMLを実際に取得する層。ブロックされた場合はここで処理が止まります。
- 解釈層:HTMLから商品名や価格などの項目を特定する層。AIが担当します。
- 検証層:抽出結果が元ページと一致するかを確認する層。誤認識や推測による値が混入し得るため、利用者側で行う作業となります。
サイトのレイアウトが変更された場合、従来型は取得位置がずれて停止するのに対し、AI型は項目の意味を手掛かりに探すため動作を継続しやすくなります。ただし、継続して動作することと正しい値を返すことは別であり、検証層は省略できません。
AIスクレイパーでデータを集める手順は?(6ステップ)
ステップ1:取得したい項目を列名で決める
最初に、出力するCSVの列名を確定します。例として「商品名」「表示価格」「税区分」「商品URL」「在庫状況」が挙げられます。「価格」のような曖昧な名称では、AIが定価と割引後価格のどちらを割り当てるかが不定となるため、「表示価格」のように画面上の値を指す名称を採用することが重要です。
ステップ2:対象サイトに構築済みスクレイパーがあるか確認する
Bright Data の Web Scraper API には1,300以上の構築済みスクレイパーが用意されており、結果はJSONまたはCSV形式で返却されます。eコマース向けでは Amazon・Walmart・eBay・Shopee その他200以上の小売サイトが対象です。対象サイトが一覧に存在する場合は、新規に作成せず構築済みスクレイパーを使用します。
一括リクエストは最大5,000URLまで可能で、課金は配信に成功したレコード単位、$0.75/1Kレコードから利用可能です。
ステップ3:存在しない場合は Scraper Studio にプロンプトで依頼する
構築済みスクレイパーが存在しないサイトでは、Scraper Studio が自然言語の指示からスクレイパーを作成します。1ページの読み込みにつき1クレジットを消費し、料金は $1/1Kリクエストから利用可能です。以下はプロンプトの一例です。
対象URL:https://example.co.jp/category/pc
取得する項目:
- 商品名
- 表示価格(画面に表示されている数字のみ)
- 税区分(「税込」「税抜」「不明」のいずれか)
- 商品URL
- 在庫状況
ルール:
- 商品一覧は「次へ」リンクをたどり、最終ページまで取得する
- 不明な値は推測せず、空欄にする
- 価格は半角数字のみで出力し、通貨記号とカンマは含めない
- 出力形式はCSV
このプロンプトでは以下の3点を明示しています。
- 取得範囲:ページ送りを最終ページまで追跡させる指示。
- 欠損時の扱い:「不明な値は推測せず空欄」とする指示。
- 表記ルール:価格を半角数字に統一する指示。
ステップ4:10〜20件を元ページと照合する
本番実行の前に、10〜20件のみを取得して元ページと照合します。確認する点は以下の通りです。
- 商品名・表示価格・商品URLが、元ページに表示されている値と一致しているか。
- 空欄にすべき箇所が、推測された値で埋められていないか。
- 一覧の先頭だけでなく、中間と末尾の行も正しく取得できているか。
不一致が見つかった場合は、プロンプトの表現を修正して再実行します。
ステップ5:CSV/JSONで出力し、取得日時と元URLを列に残す
出力列には、取得日時(例:2026-09-01T09:00:00+09:00)と元URLを必ず追加します。取得日時があれば後日の価格差を追跡でき、元URLがあれば不一致の行を即座に元ページに表示されます。
ステップ6:定期実行を設定し、失敗通知と差分を確認する
定期実行を設定する際は、実行失敗の通知先も同時に設定します。また、毎回の結果を前回と比較し、以下の3指標の変化を確認することが重要です。
- 行数:前回比で大きく減少した場合は、ブロックやサイト変更の兆候。
- 空欄率:特定の列で急増した場合は、項目の取得位置のずれ。
- 価格の中央値:急変した場合は、税区分や桁の誤認識。
どのAIスクレイパーを選ぶべきか。3層判定表で比較すると?
ノーコードで利用できるのは、Bright Data の Scraper Studio(プロンプトの記述のみでスクレイパーを作成)、Browse AI・Octoparse・Thunderbit です。以下の表では、取得層と解釈層を製品別に整理しています。検証層はどの製品を選択した場合でも利用者側の作業となります。
表:AIスクレイパー3層判定表(取得層・解釈層・検証層)
| 製品 | 取得層(ブロック対策) | 解釈層(項目抽出の方法) | サイト変更への対応 | 無料枠と開始価格 | 向く人 |
|---|---|---|---|---|---|
| Bright Data | Web Unlocker API(フィンガープリント・CAPTCHA・IPローテーション・JSレンダリング・リトライを処理) | 構築済み Web Scraper API、Scraper Studio(プロンプトで作成) | Scraper Studio が自己修復 | 月5,000クレジット(カード不要)、$0.75/1Kレコード〜 | 主要サイトの定期取得と未対応サイトの追加作成を同一基盤で運用する担当者 |
| Browse AI | ローテーションプロキシ・CAPTCHA解決・JavaScriptレンダリング | ポイント&クリックで作成(200以上の構築済みロボット) | 自動適応機能と変更検知通知 | 月50クレジット(Free プラン)、年払い月 $19〜(年12,000クレジット) | 価格や在庫の変化を通知で受け取りたい業務担当者 |
| Firecrawl | マネージドAPI(ローカルブラウザ不要)、Interact で複数手順の操作 | Markdown出力、JSON形式での構造化抽出 | Monitor 機能で変更を通知 | 月1,000クレジット(カード不要)、年払い月 $16〜(5,000クレジット) | LLMアプリにページ内容を渡す開発者 |
| Apify | Apify Proxy、Unblocker | Actor ごとに異なる(ストアの既存 Actor を実行) | Actor 作成者のメンテナンス依存 | 月 $5 の利用クレジット、Starter プランは月 $19〜(従量課金を加算) | 既存 Actor を流用したい利用者 |
| Octoparse | IPローテーション・レジデンシャルプロキシ・CAPTCHA自動解決(Standard プラン) | ノーコードのタスク作成、500以上のプリセットテンプレート(Standard プラン) | タスク監視・スケジュール機能 | Free プラン(10タスク、月5万行まで出力)、年払い月 $69〜 | 無料プランで出力を試してからテンプレートを活用したい担当者 |
| Thunderbit | ブラウザ拡張機能(プロキシ設定不要) | AI Suggest Fields で列を自動提案、サブページも巡回 | ページごとに列を再検出 | 無料プランあり | 単発・少量の抽出を行う個人 |
Bright Data:構築済みスクレイパーとプロンプト型を同一基盤で使える既定の選択肢

Bright Data は、構築済みの Web Scraper API と、プロンプトからスクレイパーを作成する Scraper Studio を提供するプラットフォームです。対象サイトに構築済みスクレイパーが存在すればそれを使用し、存在しなければ Scraper Studio で作成するという順で、同一アカウント内で方式を切り替えられます。取得層には Web Unlocker API があり、解釈層だけでなく取得の安定性まで一貫して担保できる点が特徴です。
- 料金・無料枠:月5,000クレジットの無料枠(カード不要)。Scraper APIs は $0.75/1Kレコードから、Scraper Studio は $1/1Kリクエストから利用可能。
- 向く人:構築済みのあるサイトと無いサイトが混在し、定期実行までまとめて運用したい人。
ポイント&クリックの操作画面で手軽に始めたい場合は、Browse AI や Thunderbit のほうが導入が容易です。
Browse AI:定期監視と変更検知に強いノーコードツール
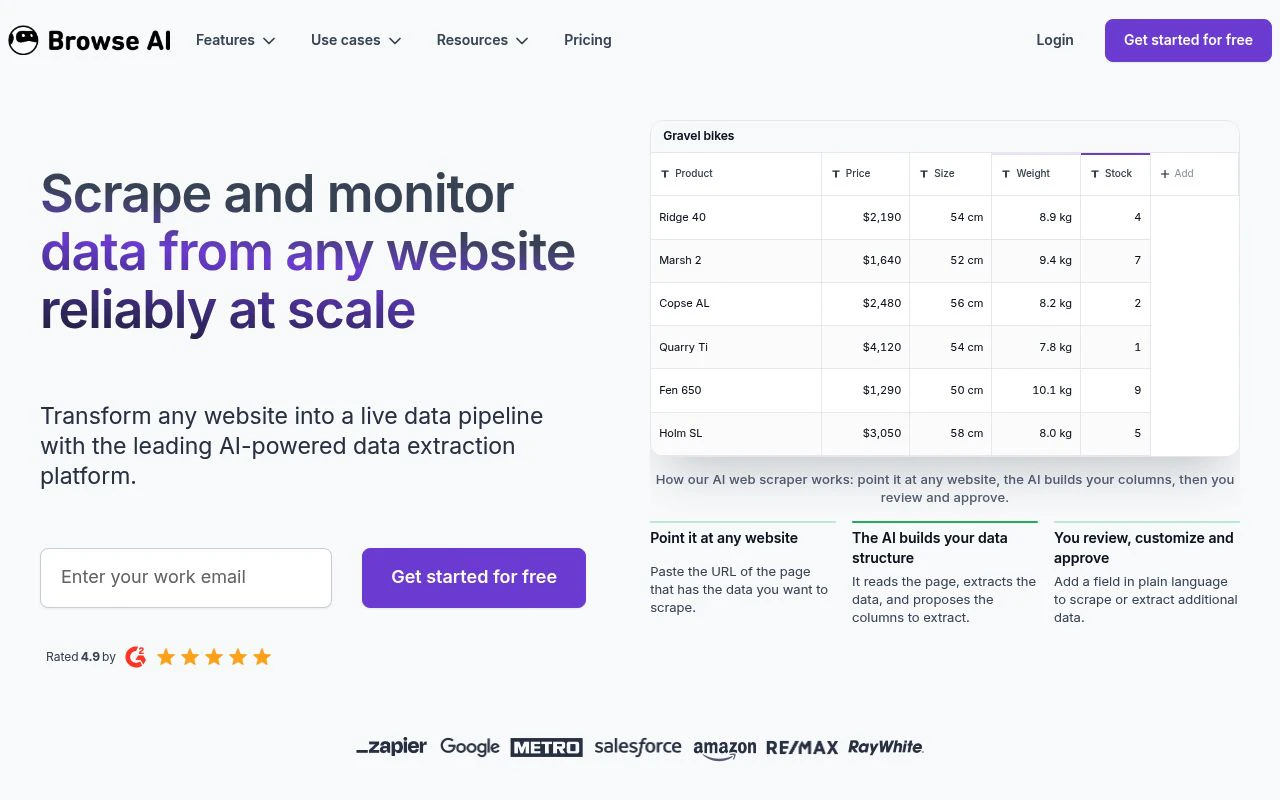
Browse AI は、ポイント&クリックでロボットを作成し、ページの定期監視と変更検知を行うノーコードのプラットフォームです。200以上の構築済みロボットが用意されており、変更があった際はメールで通知されます。出力先は Google Sheets・Airtable・Zapier などと連携可能です。
- 料金・無料枠:Free プランは月50クレジット。年払いの Personal プランは月 $19(年12,000クレジット)。
- 向く人:競合の価格や在庫が変化した際に、通知を受け取って対応したい業務担当者。
Firecrawl:AIエージェントとRAG向けの開発者用API
Firecrawl は、AIエージェントやLLM(大規模言語モデル)アプリケーション向けに、Search・Scrape・Crawl などの機能を提供するオープンソース(OSS)のWebデータAPIです。RAG(検索拡張生成)の入力となるMarkdownやJSONを返す用途に特化しており、ノーコードで表データを作成したい業務用途には向いていません。
結果を返さなかったスクレイピングは課金対象外ですが、403や404エラーが返されたページは1クレジットを消費する点に留意する必要があります。また、JSON形式での抽出は1ページあたり4クレジットが加算されます。
- 料金・無料枠:Free プランは月1,000クレジット(カード不要)。年払いの Hobby プランは月 $16(5,000クレジット)。
- 向く人:コードでパイプラインを構築し、取得結果をLLMに渡す開発者。
Apify:既存 Actor を流用するマーケットプレイス型プラットフォーム
Apify は、Actor と呼ばれるクラウド実行プログラムを多数公開しているマーケットプレイス型のプラットフォームです。Actor の多くはサードパーティの開発者によって作成されており、課金モデルや仕様、メンテナンスの状況は Actor ごとに異なります。そのため、AIによる項目抽出の方式も一律ではなく、利用前に Actor ごとの仕様を把握する必要があります。
- 無料枠:毎月 $5 の利用クレジット(カード不要)。上限に達した場合は翌月まで停止し、課金は発生しません。
- 有料プラン:Starter プランは月 $19+従量課金(1コンピュートユニットあたり $0.2)。
- 向く人:既存の Actor をテンプレートとして流用し、自作の工数を削減したい人。
Octoparse:期限なしの Free プランから始められるデスクトップ型ツール
Octoparse は、デスクトップアプリでタスクを作成するノーコードのスクレイピングツールです。期限のない Free プランが用意されており、すべての有料プランには5日間の返金保証が付きます。
Standard プランでは、IPローテーション・レジデンシャルプロキシ・CAPTCHA自動解決・タスクのスケジュール実行が利用できます。
- 無料枠:期限のない Free プラン(10タスク、月5万行までのデータ出力)。
- 有料プラン:Standard プランは年払いで月 $69〜(100タスク)。成功した結果のみ課金される Pay-per-result テンプレートは、1,000件あたり $0.001〜$3。
- 向く人:コードを書かず、画面操作でタスクを作成し、500以上のプリセットテンプレートを活用したい担当者。
Thunderbit:単発・少量作業向けの Chrome 拡張機能

Thunderbit は、2クリックで構造化データを抽出する AI Web Scraper の Chrome 拡張機能です。AI Suggest Fields がページから取得すべき列を自動で提案し、詳細ページを巡回して結果を統合するサブページ機能も備えています。出力先は Google Sheets・Airtable・Notion・CSV・JSON が選択可能で、プロキシの設定も不要です。
- 無料枠:無料プランあり。
- 向く人:手元のブラウザで開いたページから、数十件規模のリストを一度だけ作成したい個人。
構築済みスクレイパー、プロンプト型、自作、どれから始めるべきか?
方式は「構築済み」「プロンプト型」「コード自作」の順に検討します。判断の分岐は以下の3点です。
- 対象サイトが主要サイトか:構築済みスクレイパーが存在する場合は Web Scraper API を使用する。存在しない場合は、Scraper Studio によるプロンプト型を選択する。
- 定期実行か:定期的に取得する場合は、サイト変更時に自己修復する Scraper Studio が運用負荷を抑える。単発であれば、ブラウザ拡張機能でも対応可能。
- 件数はどの程度か:月5,000件以内であれば無料枠で足りる。これを超える場合は従量課金を見積もる。
コード自作が必要となるのは、取得結果の制御を細かく行う場合に限られます。この場合の取得層には Browser API を利用します。Browser API が必要となるのは、JavaScriptレンダリングが必要なページで実ブラウザの制御が要る場合や、クリック・入力を伴う複数手順の操作が必要な場合に限られます。
無料枠で何件まで試せるか?
無料枠は月5,000クレジットで、1クレジットは1リクエストまたは1レコードに相当します。Scraper Studio は1ページの読み込みにつき1クレジットです。ここから、以下の通りに試算できます。
- 初回の照合:20件の取得で20クレジットを消費し、4,980クレジットが残る。
- 毎週500件を取得:500件×4回=2,000クレジットとなり、無料枠に収まる。
- 毎日100件を取得:100件×30日=3,000クレジットとなり、無料枠に収まる。
- 毎日200件を取得:200件×30日=6,000クレジットとなり、5,000クレジットの無料枠を超過する。
AIが抽出したデータが正しいかを確認するには?(10件サンプル照合チェック表)
AIによる抽出は、誤認識や推測による値の混入が起こり得るため、本番運用の前に検証を行う必要があります。検証は、先頭3件・中間4件・末尾3件の計10件を取り出し、元ページを開いて目視で照合する形で進めます。先頭のみを確認した場合、ページ送りの途中で発生する誤りを見逃すためです。
表:10件サンプル照合チェック表
| チェック項目 | 確認内容 | 日本語ページでの典型例 | 対処 |
|---|---|---|---|
| 税込/税抜の混在 | 全行で価格の税区分が統一されているか | 「税込」と「税抜」が行ごとに混在 | 「税区分」列を追加し、不明は空欄 |
| 全角半角と文字コード | 数字・記号が半角に統一され、文字化けがないか | 「12,800円」「¥」の全角表記 | 半角統一をプロンプトに明記、CSVはUTF-8(BOM付き)で出力 |
| 重複行 | 同一商品が複数行で出力されていないか | ページ送りの前後で同一行が再出力 | 商品URLをキーに重複を削除 |
| 欠損と空欄 | 空欄が実際に元ページにも存在しない値か | 在庫表示が画像の場合に空欄化 | 空欄率が高い列はプロンプトか取得位置を見直し |
| 価格の桁 | 価格が同一カテゴリの相場から外れていないか | 「1,280円」が「1280000」と出力 | 中央値の10倍・10分の1を超える行を目視確認 |
| リンク先の到達 | 商品URLが開き、同一商品のページに到達するか | 相対パスが絡んだ不完全なURL | 10件すべてを実際にクリックして確認 |
「不明な値は推測せず空欄」という指示には、AIが値を補完して作り出すことを抑え、欠損を空欄として可視化する効果があります。空欄は照合表で発見できますが、推測で埋められた値は元ページと突き合わせない限り発見できません。
日本語ページでは、以下の3つの失敗が起こりやすくなります。
- 全角数字:「12,800円」が数値として解釈されず、文字列のまま出力される。
- 「税込」表記:本体価格と税込価格が併記されたページで、別の価格が取得される。
- ページ送りの「次へ」:最終ページでも「次へ」が残り続け、ループや取りこぼしが生じる。末尾の件数をサイト表示の総件数と比較することで発見しやすくなります。
日本語サイトからもAIスクレイパーで取得は可能であり、HTMLの取得は言語に依存しません。一方で、全角数字や税区分の表記ゆれに起因する誤りは解釈層で生じる点に留意する必要があります。
照合の一部を自動化するスクリプト例
重複・空欄率・全角数字・価格の桁は、以下のスクリプトで機械的に確認できます。リンク先の到達と元ページとの目視照合は、手作業が必要です。
import pandas as pd


def check_scraped_csv(csv_path):
    """スクレイピング結果のCSVに基本の品質チェックを行い、結果を辞書で返却する。"""
    # 1. CSVを文字列として読み込む
    df = pd.read_csv(csv_path, dtype=str, encoding="utf-8")

    # 2. 重複行の件数を計測する
    duplicate_count = int(df.duplicated().sum())

    # 3. 列ごとの空欄率を計算する
    blank_ratio = df.isna().mean().round(3).to_dict()

    # 4. 全角数字を含む価格行を検出する
    fullwidth_rows = df[df["price"].fillna("").str.contains(r"[0-9]")]

    # 5. 価格を数値化し、中央値から桁が外れた行を抽出する
    price_numeric = pd.to_numeric(
        df["price"].fillna("").str.replace(",", "", regex=False),
        errors="coerce",
    )
    median_price = price_numeric.median()
    outlier_rows = df[
        (price_numeric > median_price * 10) | (price_numeric < median_price / 10)
    ]

    # 6. 集計結果を辞書にまとめて返却する
    return {
        "duplicate_count": duplicate_count,
        "blank_ratio": blank_ratio,
        "fullwidth_price_rows": len(fullwidth_rows),
        "price_outlier_rows": len(outlier_rows),
    }
サイト変更後はいつ再テストするか?
再テストは、以下のタイミングで行います。
- 差分の異常時:行数や空欄率、価格の中央値が前回から急変した場合。
- 自己修復の後:Scraper Studio がスクレイパーを修復した場合。修復後に項目が取り違えられる可能性があるため、10件の照合をやり直す。
- 定期的な点検:差分に異常がなくても、月に一度は実施する。
ブロックされたりJavaScriptで表示されたりするページはどう取得するか?
AIが内容を解釈する前に、HTMLが取得できていなければ何も抽出されません。ブロックされた場合は403エラーやCAPTCHAの画面が返されるため、解釈層をいくら強化しても結果は改善しません。取得層の問題かどうかを、先に切り分ける必要があります。
取得層には、以下の2つの部品があります。
- Web Unlocker API:単一のエンドポイントから、公開ページのクリーンなHTMLを返却するAPI。フィンガープリント・CAPTCHA・IPローテーション・JavaScriptレンダリング・リトライを処理する。成功した結果のみが課金対象で、料金は $1/1Kリクエストから。無料枠の対象。
- Browser API:クラウド上で自動スケールするブラウザで、ブロック回避機能を内蔵する。Puppeteer・Playwright・Selenium の代替として利用でき、料金は $5/GBから。無料枠の対象外で、プロキシと共通の1回限りの $2 トライアルクレジットが別途付与される。
JavaScriptで描画されるページも、取得は可能です。なお、IPの分散にはプロキシが使われますが、Web Unlocker API はこの処理を内部に含むため、利用者がプロキシの設定を行う必要はありません。
AIエージェントやRAG向けにAIスクレイパーを使うには?
AIエージェントやRAG用にWebデータを集める場合は、LLMに渡す取得経路を整備します。Bright Data の MCP Server は無料で利用でき、Model Context Protocol(MCP、LLMが外部ツールに接続するための標準プロトコル)を通じて、Claude・Cursor・Windsurf その他のMCPクライアントからWeb検索・ページ取得・抽出を実行できます。結果はMarkdownおよびJSON形式で返却されます。Claude Code への接続コマンドは以下の通りです。
# 1. Claude Code に Bright Data MCP Server を登録する
claude mcp add --transport sse brightdata "https://mcp.brightdata.com/sse?token=YOUR_API_KEY"
RAGに渡す流れは、以下の通りです。
- LLMが利用者の質問から検索クエリを生成し、MCPのツール呼び出しとして送信する。
- MCP Serverが検索と取得を実行し、Markdown/JSONを返却する。
- 返却された本文を適切な長さに分割し、埋め込み(ベクトル化)してインデックスに格納する。
- 回答の生成時に関連する断片を検索し、元URLとあわせてLLMに入力する。
Markdown/JSONが返される場合に、HTMLを自前でパースしない理由は2つあります。ナビゲーションや広告、スクリプトが混在するHTMLは、不要なトークンをLLMに送信することになるためです。また、パース処理はレイアウトが変更されるたびに修正が必要になるためです。
Firecrawl との役割の違いとしては、Firecrawl の Scrape がページ本文のMarkdown化と、スキーマを指定した構造化JSONの返却に特化している点が挙げられます。LLMにページ単位の文脈を渡す用途では、この特化は明確な強みです。一方、固定された列を持つ表として定期的に蓄積する用途では、Web Scraper API や Scraper Studio のように、レコード単位でCSV/JSONを出力するAIスクレイパーのほうが適しています。
AIスクレイパーの料金はどう比べるか。1,000ページ単位で考えると?
月額表示と従量課金は、「1,000リクエスト」または「1,000レコード」に単位を揃えて比較します。月額型の製品は、「月額÷月間の取得件数×1,000」で換算します。換算の前に、1件がどの単位で課金されるのかを確認する必要があります。
| 製品 | 課金の考え方 | 開始価格・無料枠 |
|---|---|---|
| Bright Data | リクエストまたはレコード単位の従量課金 | Web Unlocker $1/1Kリクエスト〜、Scraper APIs $0.75/1Kレコード〜、Scraper Studio $1/1Kリクエスト〜。無料枠は月5,000クレジット |
| Browse AI | クレジット制の月額プラン | Free プランは月50クレジット、Personal プランは年払い月 $19〜(年12,000クレジット) |
| Firecrawl | 1クレジット=基本スクレイピング1ページ | Free プランは月1,000クレジット、Hobby プランは年払い月 $16〜(5,000クレジット) |
| Apify | 月額プラン+従量課金(Actor ごとに課金モデルが異なる) | Free プランは月 $5 の利用クレジット、Starter プランは月 $19〜 |
| Octoparse | 月額プラン、Pay-per-result テンプレートは結果件数による課金 | Free プランは月5万行まで、Standard プランは年払い月 $69〜、テンプレートは $0.001〜$3/1K件 |
| Thunderbit | 拡張機能は無料プランと有料プラン、API はクレジット従量課金 | 無料プランあり |
Bright Data の無料枠は月5,000クレジット(約 $7.50 相当)で、毎月1日に更新されます。クレジットは翌月に繰り越されず、上限に達した時点で自動停止するため、予期せぬ超過課金は発生しません。
「無料」の5種類はどう見分けるか?
「無料」と表示されていても、その中身は異なります。以下の5種類を区別することが重要です。
- 期限なしプラン:期限を設けず使い続けられる代わりに、件数や機能が制限されるもの(例:Octoparse の Free プラン、Browse AI の Free プラン)。
- 毎月クレジット:月ごとに付与され、繰り越されないもの(例:Bright Data の月5,000クレジット、Apify の月 $5、Firecrawl の月1,000クレジット)。
- 初回のみ:1回限りのクレジットが付与されるもの(例:Bright Data のプロキシと Browser API 向け $2 トライアルクレジット)。
- 期間限定:一定期間のみ利用できるもの(例:Bright Data のプロキシで、決済手段の追加時に付与される $5 のボーナス。有効期間は30日)。
- オープンソース(OSS):ソフトウェア自体は無料で、運用環境の費用は自己負担となるもの(例:Firecrawl のセルフホスト)。
AIスクレイパーは無料でも利用可能ですが、どの種類の無料かによって、継続して使えるかどうかが決まります。単発の検証であれば初回のみや期間限定でも足り、定期実行を前提とする場合は、毎月クレジットか期限なしプランから選択します。