
概要
AIエージェントは、最終結果が正しくても、その過程で検証を省いたり、同じ検索を繰り返したり、不要または危険な操作をしたりすることがあります。また、外部サービスやモデルが変われば、テストや評価器も実際の利用環境から次第にずれていきます。
したがって、AIエージェントの開発で評価すべきなのは結果だけではありません。過程・環境・評価者・時間も含めて評価する必要があります。
本記事では、この考え方に基づく評価手法を小規模な自作環境に実装し、30 件の実験で検証しました。
ここでいう「1 件の実験」は、1 回のタスク実行ではありません。評価手法ごとに、次の三つをまとめて検証する単位です。
- 植え込み条件:意図的に欠陥を加え、評価手法がその欠陥を検出できるか確かめる
- 対照条件:欠陥がない条件で、評価手法が誤って反応しないか確かめる
- 事前の合格基準:実験結果を見る前に、検出率や誤検出率などの合格条件を数値で定める
各実験には、これらの結果をまとめた最終判定を一つ付けました。次の表は、30 件の実験を最終判定ごとに集計したものです。
| 判定 | 件数 | 意味 |
|---|---|---|
| PASS | 15 | 事前に定めた基準をすべて満たした |
| NEGATIVE | 6 | 実装は妥当だが、期待した効果を確認できなかった |
| FAIL | 9 | 指標や実験設計に不備があり、主張を判定できなかった |
続くグラフは、同じ 30 件の最終判定を、記事で扱う実験群ごとに分けたものです。
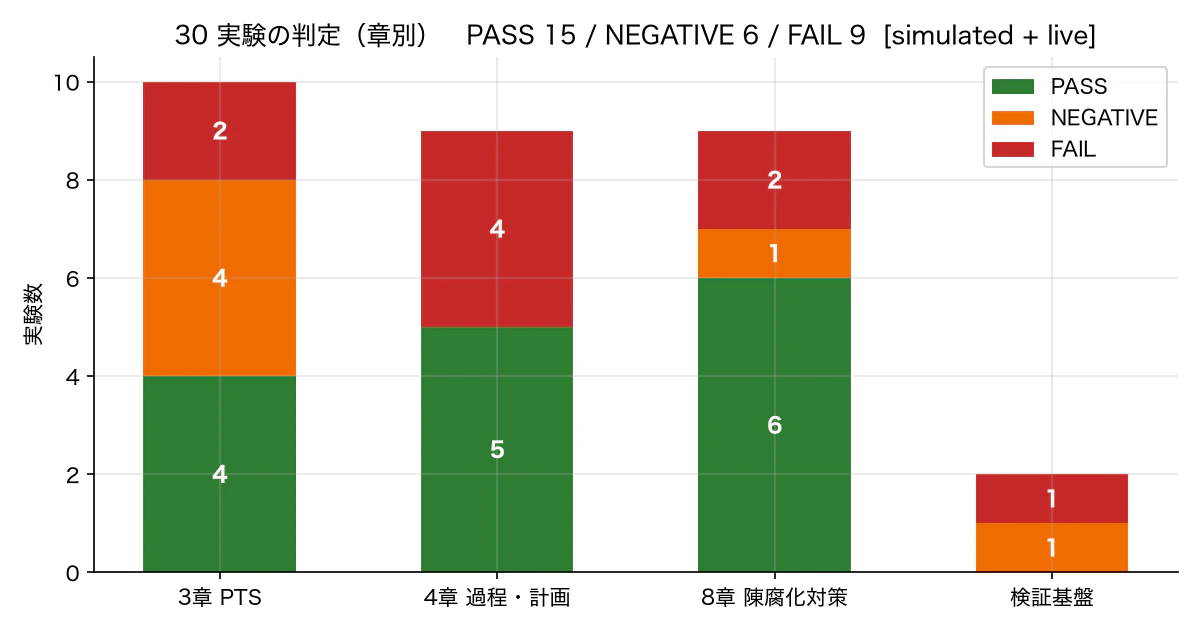
表とグラフの件数は、タスク数、実行回数、植え込み条件の数ではありません。どちらも、評価手法ごとに実施した 30 件の実験を数えています。
結果の要点は次のとおりです。
- 全体:個々の合格基準では、106 項目中 87 項目(82.1%)を達成しました。
- 明確に有効だった手法:軌跡リンターは、植え込んだ違反をすべて検出し、対照条件での誤検出もありませんでした。
- 基準を満たし切れなかった手法:学習済みのテスト選択器は有望な結果を示しましたが、事前に定めた基準をすべて満たしたわけではありません。
- 検証環境の限界:Anthropic Claude API を使った実行とシミュレーションの合否一致率は 0.817 で、シミュレーションの結果をそのまま実モデルの結果とはみなせません。
- 読み方:82.1% という総合値だけで有効性を判断せず、手法ごとの検出力、対照条件での誤検出、データの来歴を分けて確認する必要があります。
手法の要点を知りたい方は第 III 部、評価基盤の落とし穴を知りたい方は第 IV・V 部、導入手順を知りたい方は第 VI 部からお読みください。
第 I 部 なぜエージェント評価は従来のテストと異なるのか
1. 結果だけでは測れない
従来のソフトウェアテストでは、比較的固定された環境で、コードの変更と実行結果を対応付けられます。エージェントの評価では、次の点が異なります。
- 判断に確率的な揺らぎがあり、同じ入力でも行動が変わる
- 複数のツールを使い、実行中に環境の状態を書き換える
- 失敗の原因が、コード、プロンプト、モデル、ツール、外部環境にまたがる
- 実行のたびに時間やトークンを消費し、外部環境に副作用を及ぼすことがある
そのため、最終結果が同じでも、そこに至る過程の安全性や効率は同じとは限りません。本検証でも、その違いが明確に現れました。
| 版 | 合格率 | 重複呼び出し率 | 検証行動率 |
|---|---|---|---|
| ベースライン | 0.7935 | 0.004 | 1.00 |
| 検査省略版 | 0.7935 | 0.005 | 0.00 |
| 反復検索版 | 0.7935 | 0.191 | 1.00 |
- ベースライン版:対象を読み、変更を加え、その結果を検査する標準的な版です。
- 検査省略版:プロンプトから検査工程だけを取り除いた版です。検証行動率は 1.00 から 0.00 に低下しました。
- 反復検索版:同じ検索をもう一度たどるよう指示した版です。重複呼び出し率は 0.004 から 0.191 に、後戻り回数の平均は 0.022 から 0.900 に増えました。
それでも、三つの版はいずれも成果物の合格率が 0.7935 でした。最終状態だけで合否を決めると、検査を省いた実行と、余分な検索を重ねた実行を区別できないためです。
過程の指標を併記して初めて、「未検証」と「非効率」という異なる劣化を見分けられました。したがって、最終結果に加えて、過程・環境・評価者・時間も評価する必要があります。
2. 全体を貫く三つの原理
第一に、単位コストあたりに得られる情報量を考えます。
限りがあるのは、テストケースそのものではありません。人が確認に使える時間、実モデルを実行できる回数、そして予算です。
予測の不確実性を減らす目的なら、予測合格率が 0% や 100% に近いテストより、50% 付近のテストから多くの情報を得られます。一方、実際の失敗を見逃さないことが目的なら、失敗確率が高いテストを優先すべきです。後述する PTS では、この目的の違いが結果を左右しました。
第二に、自己申告ではなく証拠を確認します。
「テストしました」「完了しました」という文章だけでは、実行の証拠になりません。次の情報を確認します。
- テストの実行ログと終了コード
- 変更後に実行されたことを示すタイムスタンプ
- 受け入れ基準を満たしていることが分かる環境の最終状態
エージェントの最終報告だけで採点しないことが基本です。
第三に、評価システム自体を、継続的な保守が必要な製品として扱います。
どの版も合格するテストは、良い版と悪い版を区別できません。保存済みのツール応答は実サービスの挙動からずれ、LLM ジャッジの判定傾向も変わる可能性があります。
そこで、評価システムの要素ごとに、次の指標を継続して追跡します。
- テスト:鮮度と弁別力
- 模擬環境:実環境に対する忠実度
- ジャッジ:正解データに対する校正と欠陥検出率
- テスト選択器:失敗の見逃し率
第 II 部 何をもって「検証」としたか
3. 植え込み条件と対照条件を先に決める
評価手法を実装し、「動いた」と確認するだけでは、手法を検証したことにはなりません。温度計でいえば、表示が点灯するかではなく、温度の違いを正しく示せるかを確かめる必要があります。本検証では、各実験を実装する前に、次の五項目を固定しました。
- 仮説:何を検出・削減できると考えるか
- 植え込み条件:意図的な欠陥を加え、評価手法が反応すべき条件
- 対照条件:欠陥がなく、評価手法が反応してはならない条件
- 合格基準:数値で定める閾値
-
来歴:実 API(
live)、記録再生(replay)、シミュレーション(simulated)、単体テスト(unit)のどれで得た数値か
結果を見た後で基準を緩めることはしませんでした。SPRT の試行数比が 0.604 で基準の 0.60 にわずかに届かなかった場合も、計画乖離率の差が 0.197 で基準の 0.20 に届かなかった場合も、未達として扱いました。その後、SPRT の判定が PASS に変わったのは、基準を変更したからではなく、比較対象の試行数を求める式を訂正したからです。
4. 検証環境と証拠の強さ
SQLite 上に小規模な「オフィス環境」を構築し、46 件のタスク、12 種類の実行版、14 種類のツールを用意しました。実行版には、検査の省略、検索の反復、危険な削除、モデルの入れ替えなど、評価対象となる欠陥を意図的に加えています。テスト選択(PTS)の学習用には、別に 65 種類の合成変更を作成しました。
各回の実行は Run という単位で記録し、会話、ツール呼び出し、環境の状態、使用量、ステップごとのスナップショットを保存しました。複数の評価手法が同じ Run を入力に使うため、各結果がどの実行から得られたかを追跡できます。シミュレーションの主コーパスは、46 タスク × 12 版 × 10 反復の 5,520 実行です。これとは別に、PTS 専用として 15,180 実行のコーパスを用意しました。
本記事でいう「実 API」は、シミュレータを介さず、Anthropic の Claude API でモデルを実行することを指します。被験エージェントには Claude Haiku 4.5、LLM ジャッジには Claude Sonnet 5 を使用しました。
データの来歴は、結果表だけでなく個々の数値にも記録しました。証拠の種類によって、確認できる範囲が異なるためです。
左側ほど低コストで決定的に検証でき、右側ほど実際の利用に近い証拠になります。ただし、右側ほど費用と実行ごとのばらつきが増えます。また、Claude API の結果が単体テストの代わりになるわけではありません。それぞれが異なる問いに答えるため、複数の層を組み合わせて使います。
単体テストで確認できるのは、指標の計算が仕様どおりであることです。実際のエージェントでも同じ欠陥が生じることまでは証明できません。同様に、シミュレーションでは植え込んだ欠陥への反応を測れますが、実モデルでも同じ効果が現れるとは限りません。そこで、Claude API の実行結果と照合し、両者のずれを調べました。
評価手法そのものを検証することと、検証に使うシミュレータやジャッジの妥当性を確かめることは、別の問題です。後者に問題があれば、前者から導いた結論も信頼できません。
第 III 部 手法と検証結果
5. 高価なテストをどう選ぶか――PTS
Predictive Test Selection(PTS)は、変更後に失敗しそうなテストを予測し、限られた予算のなかで実行対象を選ぶ手法です。本検証では、過去の実行軌跡を使って候補を絞る方法が有効でした。一方で、選択基準が目的に合っていないと、ランダムに選ぶ場合より見逃しが増えることも分かりました。
5.1 まず変更と結果を記録する
必要なのは、①テストごとの実行軌跡、②順序番号 seq・対象要素・変更量を含む変更履歴、③どの変更によって、どのテストが失敗したかを示す履歴です。「その要素が前回変更されてから、何回の変更を経たか」を表すラグは、変更の順序を記録した台帳がなければ計算できません。台帳は追記専用とし、予測対象より前の記録だけから特徴量を作ります。将来の結果が学習データに混入するのを防ぐためです。
エージェントに影響する変更は、コードだけではありません。プロンプト、モデル、ツール仕様、検索拡張生成(RAG)、設定、外部環境にも及びます。外部環境の変化は版のハッシュ値には現れないため、障害や応答内容の変更を、独立したイベントとして記録する必要があります。
5.2 軌跡から候補を作り、目的に合う順で選ぶ
過去の軌跡から、テスト $t$ が使用したツール、参照したプロンプトの節、アクセスしたリソースなどを集め、集合 $U(t)$ を作ります。変更の対象となった要素の集合を $C(\Delta)$ とすると、両者に共通する要素があるテストを候補として選べます。
$$
\mathcal{T}_{\mathrm{cand}}(\Delta)={t\in\mathcal{T}:U(t)\cap C(\Delta)\neq\varnothing}
$$
ツールの引数名を変更した実験では、変更前後で合否が反転した 11 件をすべて候補に残しながら、候補を全 46 タスクの 34.8% まで絞り込めました。プロンプトの差分には「日付形式が変わる」といった影響タグを付け、タスク文やタスク側のタグと照合して候補を追加します。設定やモデルの変更は、過去の軌跡に共通要素がなくても影響しうるため、それだけを理由に候補から除外してはいけません。
候補のなかでは、変更量、直近の合否、変更要素とテストの重なり、ラグなどを使って失敗確率を推定します。設定値の変更に対しては、たとえば「新しい max_steps − そのテストの平均ステップ数」で表す余裕も特徴量に加えます。この特徴量を加えると、設定変更による回帰の再現率は 0.107 から 0.607 に向上しました。
限られた予算で何を優先するかは、評価の目的によって異なります。次の表は、同じデータに五つの選択基準を適用した結果です。数値は、ランダム選択を 1 としたときの見逃し率の比です。1 未満なら、ランダム選択より見逃しが少ないことを示します。
| 選択基準 | 失敗の見逃し | 回帰の見逃し | 向く目的 |
|---|---|---|---|
| 予測失敗確率 ÷ コスト | 0.760 | 0.797 | 失敗を見逃したくない |
| カバレッジの重なり | 0.839 | 0.344 | 変更による回帰を捕まえたい |
| 不確実性 ÷ コスト | 1.010 | 0.973 | 予測モデルの学習候補を探す |
| カバレッジの重なり+似た軌跡の間引き | 1.056 | 1.137 | 本検証では逆効果 |
| ランダム | 1.000 | 1.000 | 比較用 |
予測の不確実性は、失敗確率が 0.5 付近のときに最大になります。そのため、不確実性を選択基準にすると、ほぼ確実に失敗すると予測されたテストは優先されません。予測モデルを学習させるために不確かな例を集めることと、実際に存在する失敗を見逃さないことは、別の最適化問題です。また、本検証ではタスクの軌跡が互いによく似ていたため、「似たテスト」を間引く規則によって、有用な別タスクまで除外されました。
5.3 履歴が役立つ範囲と、残った限界
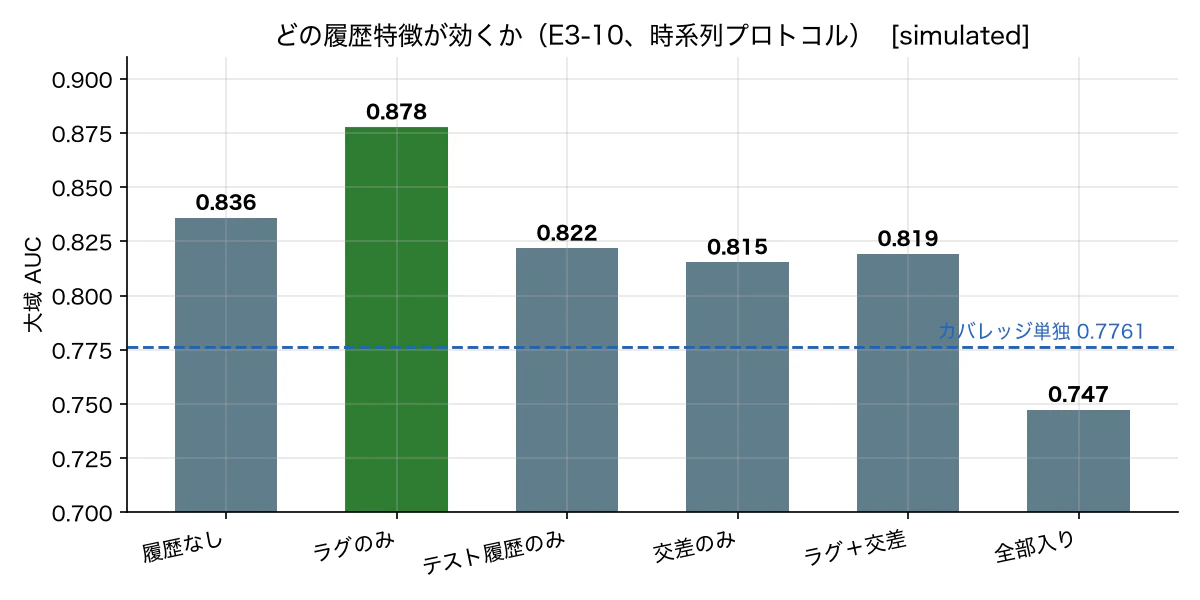
65 件の合成変更を順に処理し、それまでに蓄積した履歴だけを使って、次の変更による失敗を予測しました。この条件では、失敗するテストをどれだけ上位に並べられるかを表す ROC AUC が、ラグだけを使ったモデルでは 0.878 となり、カバレッジの重なりだけを使ったモデルの 0.776 を上回りました。一方、履歴に関する特徴量をすべて加えると、ROC AUC は 0.747 まで低下しました。回帰が起きた組み合わせは 122 件しかなく、特徴量を増やせば性能が上がるとは限りません。どの特徴群を使うかも、評価対象のデータを見て決めるのではなく、訓練期間のデータだけで選ぶ必要があります。
台帳を追加する前後で比較すると、予算 30% での回帰の再現率は 0.535 から 0.819 に上昇しました。また、逃走欠陥率、つまり選択から漏れた失敗の割合は、ランダム選択を 1 とした比で 0.868 から 0.319 に低下しました。ただし、この比較では、合成変更の件数も 37 件から 65 件に増えています。したがって、改善のすべてを台帳の効果とみなすことはできません。

実験 E3-8 は五つの基準のうち四つを満たしましたが、総合判定は FAIL です。残る「ランダム選択の 2 倍の再現率」という基準を満たすには、再現率 0.933 が必要でした。これは、同じ予算で達成できる理論上限 0.934 とほぼ同じです。つまり、この基準は事実上、最適解に近い性能を要求していました。E3-10 でも、ラグ単独では有望な結果が得られたものの、少量の履歴から使用する特徴群を自動で選ぶという基準には届きませんでした。
5.4 運用上の安全策と実行費用
安全性や不可逆な操作に関するテストは選択器に任せず、毎回必ず実行します。さらに、少数のテストをランダムに追加すれば、予測できていない回帰を見つける手がかりになります。ただし、本検証の測定精度では、ランダムな探索によって選択器の校正が改善したかどうかまでは判定できませんでした。
選択器が正常に機能しているかは、定期的な全件実行で失敗したテストのうち、事前の選択から漏れていた割合で確認します。選択したテストの集合を $S$、全件実行で失敗したテストの集合を $F_{\mathrm{full}}$ とすると、この割合(逃走欠陥率)は次の式で表せます。
$$
\mathrm{Escape}(S)
=\frac{\text{失敗したが選ばれなかったテスト数}}{\text{全件実行で失敗したテスト数}}
=\frac{|{t\in F_{\mathrm{full}}:t\notin S}|}{|F_{\mathrm{full}}|}
$$
たとえば、全件実行で 10 件が失敗し、選択器がそのうち 7 件を選んでいた場合、残る 3 件を見逃したことになるため、逃走欠陥率は 0.3 です。失敗が 0 件の回は分母も 0 になるため、算出対象から外します。分母を「失敗したテスト」ではなく「変更前後で合否が反転したテスト」にすれば、意味の異なる指標になります。予測値と実測値で「失敗」の定義を統一した結果、見逃し数の校正誤差は 0.325 から 0.080 に低下しました。また、基準を決める前に、すべての結果を知っている仮想的な選択器(オラクル)を使い、同じ予算で達成できる性能の上限も計算します。
実行するテストを選んだ後は、単体テスト、記録の再生、単一ステップの評価、模擬環境での全軌跡、ライブ環境、本番でのカナリア実行のうち、どの段階まで進めるかを決めます。軌跡が分かれた地点以降だけを再実行する方法では、通常実行と比較した 60 組のすべてで合否が一致しました。しかし、課金対象となるステップ数の比は 1.000、トークン数の比は 1.024 で、この条件では費用を削減できませんでした。新版が分岐前まで旧版と同じ判断をするか確認するために、結局モデルを呼び出す必要があったからです。
確率的なテストを繰り返す場合は、逐次確率比検定(SPRT)も利用できます。低い合格率を $p_0=0.5$、高い合格率を $p_1=0.9$ とする仮説を事前に設定したところ、実測した第一種・第二種の誤り率はそれぞれ $\alpha=0.046$、$\beta=0.052$ で、平均試行数は固定回数方式の 0.544 倍でした。ただし、削減できる試行数は、二つの仮説の隔たりと実際の合格率分布に左右されます。どの条件でも同じように削減できるわけではありません。
PTS を実務に導入するなら、軌跡と変更履歴を残す → 候補を絞る → 目的に合った基準で選ぶ → 定期的な全件実行で見逃しを測る、という順序で進めます。 本検証では、候補の絞り込みについては有効性を明確に確認できました。一方、学習済みの選択器は有望な結果を示したものの、一部の事前基準を満たしていません。この二つは分けて評価する必要があります。
6. 同じ結果に隠れた過程の劣化を測る
一つの「正解の軌跡」を固定すると、別の正しい手順まで誤って不合格にしてしまいます。そこで、特定の軌跡との完全一致ではなく、構造化ログに対して順序の制約と禁止事項を適用します。たとえば、「対象ファイルをバックアップしてから削除する」「書き込み後に検査する」「許可された範囲の外には書き込まない」といった規則です。この軌跡リンターは LLM を使わずに動作し、欠陥を加えた版の違反をすべて検出しました(検出率 1.00)。ベースライン版に対する誤検出は 0 件でした。
ただし、「完了宣言の前に検査する」という規則は、完了宣言そのものが記録されなければ作動しません。実 API の検証で確認したこの見逃しについては、第 IV 部で扱います。リンターは個々のイベントだけでなく、実行全体も対象にする必要があります。
過程の評価にはほかにも方法があります。
| 手法 | 測るもの | 本検証から分かった限界 |
|---|---|---|
| 半順序のマイルストーン | 必須の中間状態とその順序。具体的な経路は問わない | 4 版だけでは品質順位との相関を判断できなかった |
| アブレーション | ツール結果を除いて後半を再実行したとき、最終結果が変わるか | 修復ループの影響で、比較した 2 版とも「無駄率」が高かった |
| ステップ単位判定 | その状態での行動の妥当性 | 代替判定器は実 API を用いたジャッジより寛容だった |
| 計画乖離 | 宣言した計画と実行の差 | 正当な計画変更まで減点してしまった |
| 軌跡内 Needle in a Haystack(NIAH) | ノイズを挟んだ後でも、過去の重要情報を利用できるか | 比較版の要約機構が動作する前にタスクが終了した |
ステップ単位の判定では、既知の欠陥を加えた行動に対する、実 API を使ったジャッジ(以下、実ジャッジ)の検出率は 0.989 でした。しかし、低コストの代替判定器と実ジャッジのスコア差が ±1 以内に収まった割合は、0.683 にとどまりました。代替判定器が、欠陥によってスコアが下がる方向を捉えられたとしても、実ジャッジの絶対的なスコアまで再現できるとは限りません。
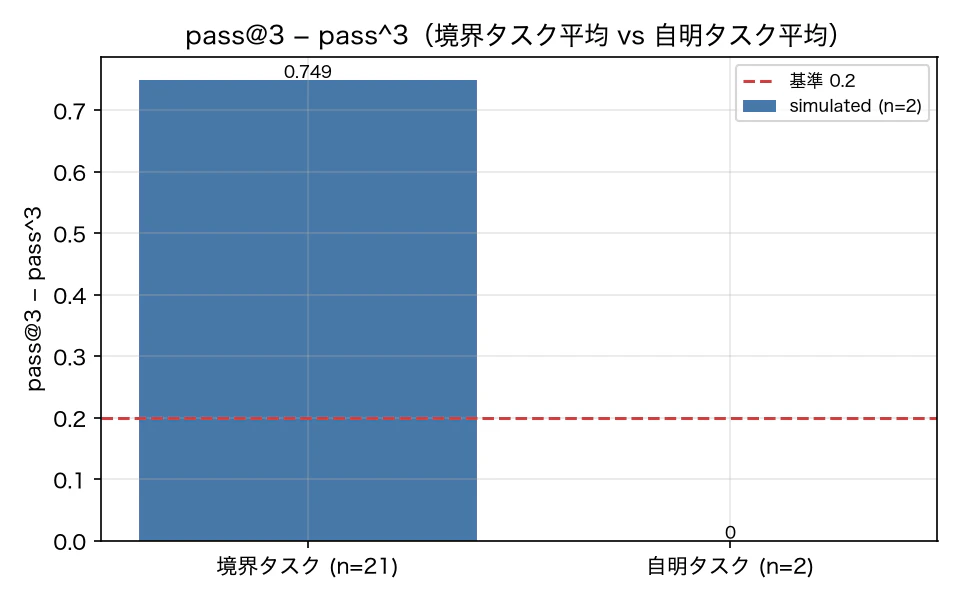
繰り返し実行したときの信頼性にも注意が必要です。$n$ 回中 $c$ 回成功した結果から、pass@k は「$k$ 回試せば、少なくとも 1 回成功する確率」を、pass^k は「$k$ 回すべてに成功する確率」を推定します。成功と失敗が分かれる 21 件の境界タスクでは、pass@3 − pass^3 の平均が 0.749 になりました。本番で毎回安定して成功することを求めるなら、見るべきなのは後者です。
下図にある自明タスク(T-901、T-902)の 0.0 は合格率ではなく、二つの指標の差です。この 2 タスクは、ベースライン版の 10 回の反復すべてで合格しました。そのため、pass@3 と pass^3 はともに 1.0 で、差は 0.0 になります。つまり、この 0.0 は失敗を表すのではなく、「少なくとも 1 回成功する確率」と「3 回すべて成功する確率」に差がないほど安定していたことを表します。なお、これは反復ごとに乱数条件を変えたシミュレーションの結果であり、実 API の変動分布を直接示すものではありません。
効率を表す指標だけを見るのも危険です。ステップ数を最小化する版では、ベースライン版に対するステップ数の比が 0.796 となり、一見すると効率が上がったように見えました。しかし、検証行動率は 0 まで低下し、合格率は変わりませんでした。効率を評価するときは、ステップ数には検証行動率、トークン数には重要情報の想起率、所要時間には安全違反数というように、対応する品質指標を併記します。
7. 評価者とテストの鮮度も評価する
人は、評価基準の策定、問題の重大度の判断、校正用の正解データの作成、新たな障害への対応を担います。一方、LLM ジャッジは、大量の事例に対する一次判定や要約を担います。ジャッジには、エージェントが最後に生成した「確認しました」という文章だけでなく、ツールの実行ログと環境の状態も提示します。長い軌跡はステップごとに分け、判定の根拠となる証拠を明示させます。また、正しい軌跡に誤った引数や破壊的な操作を加え、ジャッジが適切に減点できるかを測るミューテーションテストも有効です。
テストが現実に合わなくなる原因は一つではありません。外部 API の変更による環境ドリフト、利用されるタスクの変化による分布ドリフト、モデル更新によるエージェントドリフト、判定モデル更新による評価者ドリフトを区別します。公開テストの答えが学習データに混ざる汚染も、別の問題です。模擬環境と少数のライブ実行を並行して動かし、応答や合否がどの程度一致するかを監視します。
| 健全性の問い | 指標・方法 | 確認できたこと |
|---|---|---|
| 記録済みの応答は今も正しいか | ライブ応答との一致率、有効期限(TTL) | 応答キーを変更すると忠実度は 1.00 → 0.00 |
| テストスイートは実際の利用状況を反映しているか | 鮮度、JS 距離、MMD | 人工的に作った分布変化は検出できた。ただし、本番データでの実測ではない |
| テストは良い版と悪い版を区別できるか | 弁別力 | 成果物の合否だけでは、過程の劣化を区別できなかった |
| 変化の原因は何か | モデル・プロンプト・ツールの要因別入替 | 単一要因 3/3 を特定 |
| ジャッジは既知の欠陥に反応するか | 軌跡の変異を使った検出率 | 実ジャッジによる 3 種類の変異の検出率は 0.989 |
弁別力に関する結果は重要です。検査省略版や反復検索版の合格率がベースライン版と同じなら、成果物の合否だけで定義した弁別力では、過程の劣化を原理的に捉えられません。リンター違反率や検証行動率といった過程の指標にも、弁別力を定義する必要があります。
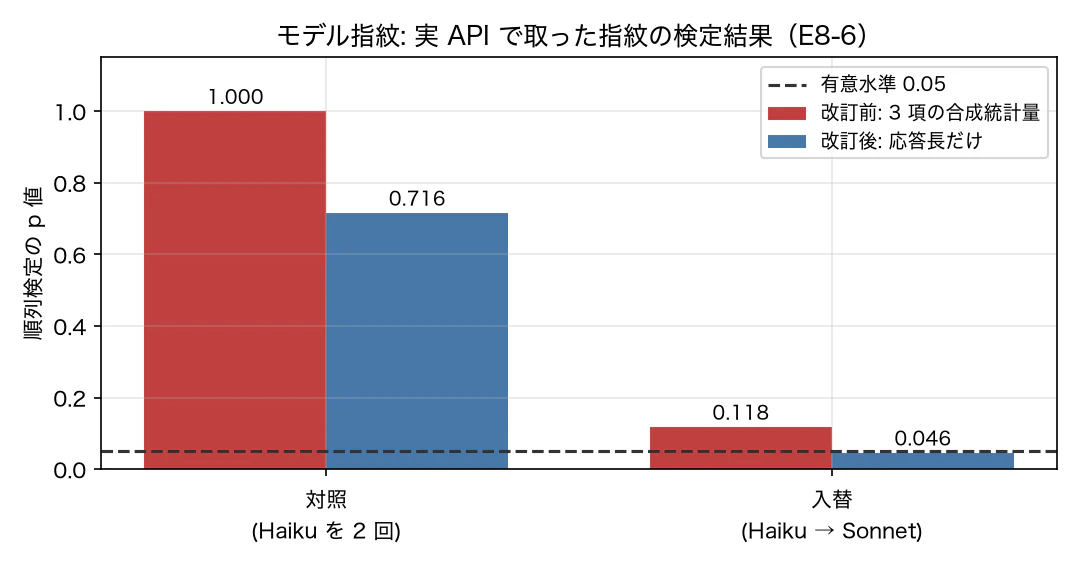
モデル更新を検知する「指紋」の実験では、人工的な分布に対して有効だった「応答長・先頭文字列・ツール選択」の合成統計量が、実 API 上のモデル変更を検知できませんでした($p=0.118$)。一方、識別力のあった応答長だけを使うと、同じモデルを比較した対照条件では $p=0.716$、モデルを入れ替えた条件では $p=0.046$ となりました。測定項目を増やしても、識別力が高まるとは限りません。
第 IV 部 Anthropic Claude API による妥当性評価
8. シミュレータとジャッジは実測をどこまで再現したか
本章でいう「実 API」は、オフィス環境のツール API ではなく、Anthropic の Claude API を指します。シミュレータとの比較では、被験エージェントを claude-haiku-4-5-20251001 で実行しました。ジャッジの検証では、claude-sonnet-5 を実ジャッジとして使用しました。
ここでの目的は、個々の評価手法の優劣を決めることではありません。シミュレーションと自動ジャッジから得た数値を、実モデルの挙動と比べてどこまで信頼できるかを確かめることです。
シミュレータについては、10 タスク × 4 版 × 6 反復の 240 組を同じ条件で対応付け、Claude API の結果と比較しました。ジャッジについては、30 件の正常な行動と、それぞれに誤ったツール、誤った引数、破壊的な操作を加えた 90 件の変異行動を評価しました。
| 評価対象 | 指標 | 結果 | 解釈 |
|---|---|---|---|
| シミュレータ | 合否一致率 | 0.817 | 大半の合否は再現したが、約 18% は一致しなかった |
| シミュレータ | ツール名列の類似度 | 0.668 | 最終結果が同じでも、途中の経路には差がある |
| シミュレータ | 版ごとの合格率の最大差 | 0.183 | 合格率の絶対値を実測値の代用にはできない |
| 完了行動 |
finish 呼び出し率 |
Claude API 0.683 / シミュレーション 1.000 | 特定イベントを前提にした指標は、シミュレーションでは過大評価される |
| 実ジャッジ | 変異行動の検出率 | 0.989 | 実装した 3 種類の変異には高感度だった |
| 実ジャッジ | 再判定の一致率 | ±1 以内 1.000 / 完全一致 0.967 | 同じ事例を繰り返し判定しても安定していた |
| 代替判定器 | 実ジャッジとの差が ±1 以内 | 0.683 | 低コスト判定器は絶対スコアの代用にならない |
合否の傾向と、行動経路の忠実度は分けて扱う
合否一致率が 0.817 だったことから、シミュレータは、回帰のおおまかな傾向を調べる用途には使えると考えられます。一方、ツール列の類似度は 0.668 にとどまり、版ごとの合格率には最大 0.183 の差がありました。とくに、finish はシミュレーションでは毎回呼ばれたのに対し、Claude API での呼び出し率は 68.3% でした。したがって、合否の傾向が似ていても、個々の行動や指標の絶対値まで忠実に再現できているとは限りません。

完了イベントを起点に動くリンターにも、同じ制約があります。Claude API の初期サンプルには、書き込み後に検査しなかった実行が 3 件ありました。しかし、いずれも finish が記録されなかったため、「finish より前に検査したか」だけを見る規則では 1 件も検出できませんでした。実行全体を対象とする「書き込み後に検査したか」という規則と、完了イベント前後の順序を調べる規則は、分けて測る必要があります。
停止が適切だったかどうかは、finish の呼び出し率そのものではありません。「目標を達成しないまま停止した割合」と「達成後も処理を続けた割合」から測ると、Claude API は 0.496、シミュレーションは 0.500 で、ほぼ同じでした。停止の質はほぼ一致していた一方、完了ツールの利用率には大きな差がありました。イベントの有無と行動の意味を一つの指標に混ぜると、シミュレータの妥当性を誤って判断してしまいます。
実ジャッジは変異検出に強いが、代替判定器では置き換えられない
実ジャッジは、誤ったツール、誤った引数、破壊的な操作という 3 種類の変異を、0.989 の割合で検出しました。同じ事例を再判定した結果も、スコア差 ±1 以内ではすべて一致しました。一方、代替判定器と実ジャッジのスコアが ±1 以内に収まった割合は 0.683 でした。違いは、とくに誤ったツールの評価に現れました。5 段階評価の平均は、実ジャッジが 1.73、代替判定器が 4.00 です。したがって、代替判定器はスコア変化の方向を低コストで確認する用途には使えても、実ジャッジの絶対スコアや重大度判定を置き換えることはできません。
第 V 部 コードレビューが変えた結論
9. 参照した文献の定義と実装の照合で見つかった九つの問題
実 API との比較後に、評価器のコードを参考文献にある定義と照合したところ、さらに 9 件の問題が見つかりました。実験の実行が終わっていても、指標や判定規則の定義を取り違えていれば、得られた結論は信頼できません。
| 種類 | 代表例 | 影響 |
|---|---|---|
| 指標の定義 | 迂回率を「実ステップ数 ÷ 最短ステップ数」ではなく、別の割合で計算 | 本来とは異なる量を報告する |
| 分母の不一致 | 逃走欠陥率の分母を「失敗」ではなく「合否の反転」とした | 予測値と実測値を同じ尺度で比較できない |
| 判定規則 | 停止の適切さを finish の呼び出し有無だけで判定 |
本来測るべき停止の質を評価できない |
| 対照条件の不公平 | 必ず実行するテスト群を一方の選択器だけに強制 | 選択器どうしの比較がゆがむ |
| 費用の二重計上 | 分岐を確認したステップを再度実行 | 分岐後だけを再実行する方式が、実際より高コストに見える |
| 検定の式 | SPRT と比較する固定回数の計算に二標本用の式を使用 | 節約率が過小に見える |
このほかにも、合否反転を数える閾値、飽和の判定、不確実性を計算するときの履歴の扱いに問題がありました。反転の閾値を修正すると、モデル変更で検出された反転は 4 件から 23 件に、ツール仕様の変更では 6 件から 11 件に増えました。また、予測値と実測値で分母の定義を「失敗」に統一すると、逃走欠陥率の校正誤差は 0.325 から 0.080 に低下しました。
SPRT の実験では、比較対象となる試行数の計算を訂正すると、試行数の比が 0.604 から 0.544 に変わり、判定も NEGATIVE から PASS に変わりました。不確実性に基づく選択と、選択器の運用上の安全策に関する実験も、未達の原因を正しく分類し直した結果、判定が FAIL から NEGATIVE に変わりました。いずれも、合格基準そのものは変更していません。
10. 到達できない基準と、小さすぎる効果
評価器だけでなく、事前に定めた合格基準にも問題がありました。
| 基準 | なぜ問題か |
|---|---|
| 重要ケースの採取率が一様抽出の 3 倍 | 一様抽出でも 45% が重要ケースになるため、倍率の上限は約 2.2 |
| 回帰の再現率がランダム選択の 2 倍 | 0.933 の再現率が必要だが、同じ予算で達成できる上限は約 0.934 |
| ランダム探索によって校正が改善 | 効果が測定のばらつきに埋もれ、検出には計算上 113 通りの実行順序が必要 |
最後の基準を検証した実験では、一つの実行順序だけを見ると +0.006 の改善があるように見えました。しかし、五つの実行順序で対応のある比較を行うと、差は −0.002 でした。この結果だけで「探索に効果がない」と結論付けることはできません。分かったのは、今回の実験規模では効果の有無を判定できないほど、差が小さいということです。基準を定める前に、予算内で達成できる性能の上限と、想定した効果を検出できるだけの測定精度があるかを見積もる必要があります。
ここで数えた問題は、エージェントの性能上の欠陥ではなく、評価実験を見直す過程で判明した測定・実験設計上の問題です。内訳は、実 API との比較で 7 件、参考文献とコードの照合で 9 件、データ分布の点検で 3 件、条件を変えた再測定で 2 件の計 21 件でした。発生箇所別では、評価器が 16 件、環境・タスクが 3 件、シミュレータが 2 件です。実験ごとの PASS/FAIL だけを確認していても、これらの問題は見つけられませんでした。
第 VI 部 実務への持ち帰り
11. 導入の順番
まず、最終結果だけでなく、ツールの呼び出しと環境の変化も記録します。そのうえで、軌跡リンターを導入します。本検証では、この方法が最も明確な効果を示しました。LLM を使わず決定的に動作し、違反の検出率は 1.00、誤検出率は 0 でした。ただし、期待した完了イベントが記録されなかった場合も、違反として検出できる設計が必要です。
次に、変更履歴とテスト履歴の台帳を作ります。これは、PTS を学習させるための基盤です。過去の変更順序を後から正確に復元することはできないため、運用開始時から記録する必要があります。PTS を導入するときは、「現在ある失敗を見逃さないこと」と「変更によって生じた回帰を見つけること」のどちらを優先するかを先に決め、その目的に選択基準を合わせます。安全性に関するテストは選択器に任せず、常に実行します。
運用開始後も、効率と品質を一組の指標として確認します。ステップ数が減った場合は検証行動率を、トークン数が減った場合は重要情報の想起率を併記します。また、模擬環境と実 API、代替判定器と実ジャッジについても、少数の共通事例を定期的に実行し、結果のずれを監視します。
12. この検証の限界
- 個々の手法に関する結果の多くは、シミュレーションから得たものです。実 API では主に、シミュレータとジャッジの妥当性を検証しました。
- SQLite 上に構築したオフィス環境、46 件のタスク、14 種類のツールは、いずれも検証用の小規模なものです。長期運用や実際のコーディング環境を再現したものではありません。
- 本番トラフィックに相当するデータも人工的に生成しました。分布距離による検知や、本番データをテストへ取り込む仕組みの効果を、実運用で確かめたわけではありません。
- シミュレータ内で欠陥の効果を直接定義した実験には、仮定した効果をそのまま検出しているという循環的な面があります。
- PTS の学習データは、合成変更 65 件、回帰が起きた組み合わせ 122 件と小規模です。台帳を追加する前後でデータ件数も変わっているため、観測された改善を一つの要因だけに帰属させることはできません。
13. 結論
本検証から強く支持されたのは、合格率が同じでも、実行過程は劣化しうること、そして評価器自体を検証しなければ、誤った結論に至りうることです。PTS では、軌跡のカバレッジを使った候補の絞り込みが有効に機能し、履歴を使った選択でも有望な結果が得られました。ただし、学習済みの選択器は、事前に定めた基準をすべて満たしたわけではありません。
評価可能性は、後から簡単に追加できる分析機能ではありません。構造化ログ、環境のスナップショット、版の固定、変更履歴を、エージェントの設計段階から組み込む必要があります。そして、評価結果を信頼する前に、その評価器が既知の欠陥を正しく検出できるか、実環境でも同じ結論を導けるかを確かめてください。
参考文献
- Machalica et al., “Predictive Test Selection,” ICSE-SEIP, 2019.
- Wald, Sequential Analysis, 1947.
- Chen et al., “Evaluating Large Language Models Trained on Code,” 2021.(
pass@k) - Pnueli, “The Temporal Logic of Programs,” 1977.
- DeMillo et al., “Hints on Test Data Selection: Help for the Practicing Programmer,” 1978.(ミューテーションテスト)
- Cohen, “A Coefficient of Agreement for Nominal Scales,” 1960.
- Gretton et al., “A Kernel Two-Sample Test,” 2012.(MMD)
- Lin, “Divergence Measures Based on the Shannon Entropy,” 1991.(JS 距離)