
はじめに
Codexを長く使っていると、だんだん指示が増えていきます。
「作業前にこのファイルを読んでください」「変更後は必ずこのチェックをしてください」「勝手に判断せず確認してください」「この順番で作業してください」「最後にもう一度全部確認してください」。
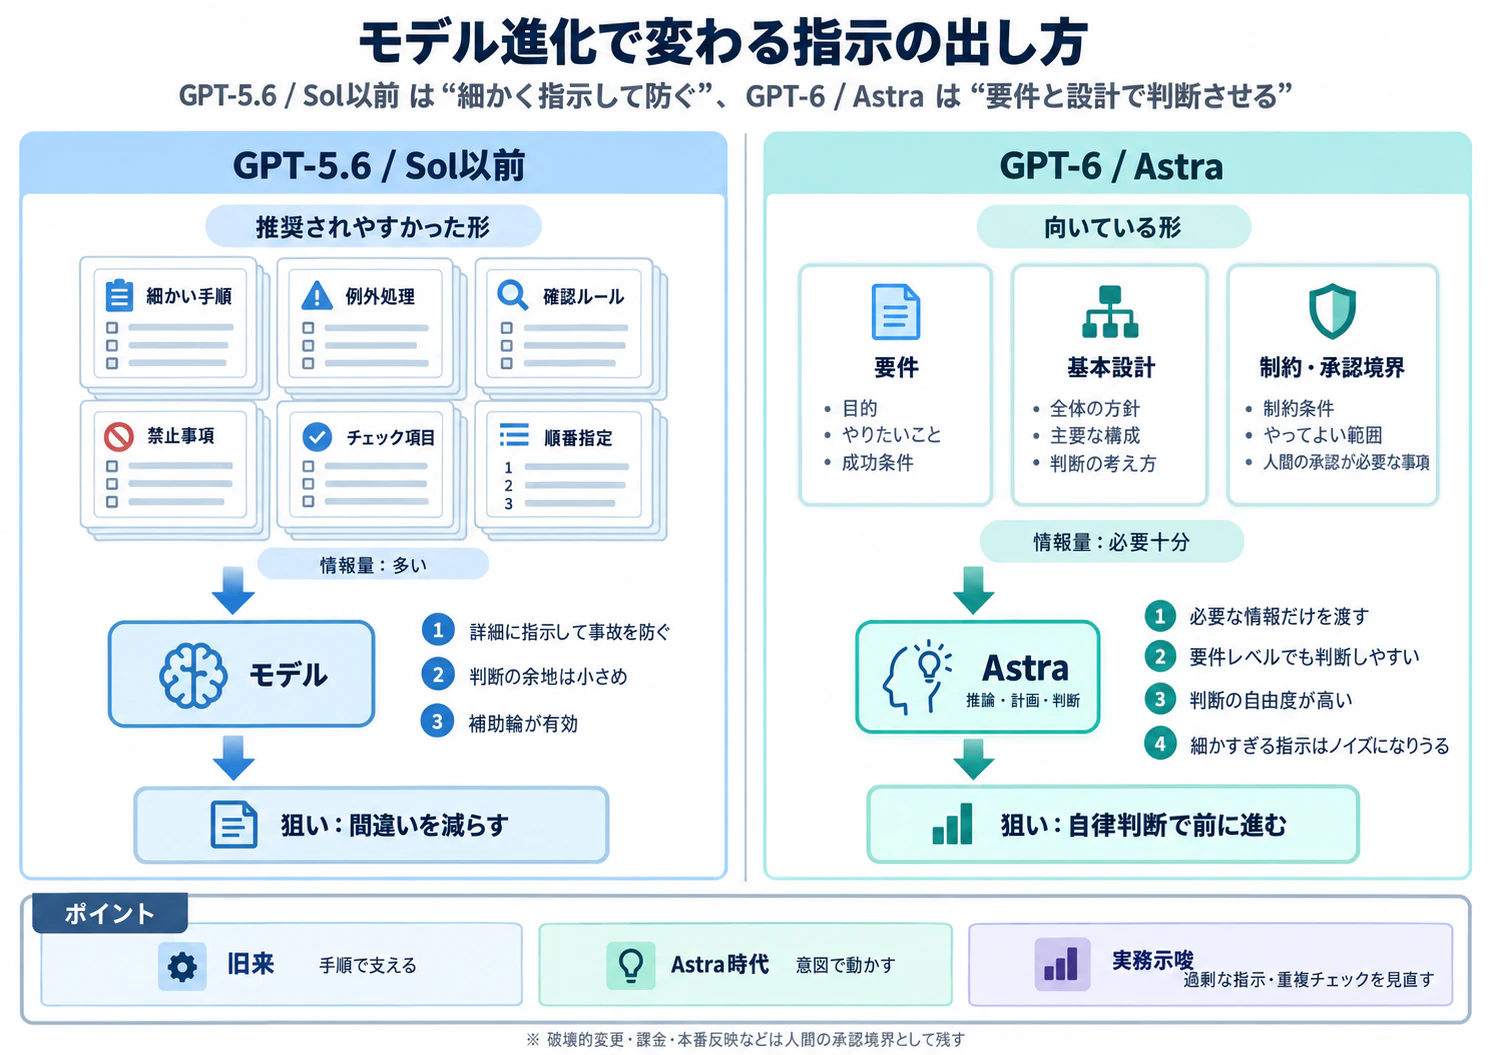
一つひとつには理由があります。以前のモデルで失敗したから追加したルールもあるでしょう。ところがGPT-6 Astraのようにモデル側の判断力が上がると、その「失敗しないための補助輪」が、逆にモデルの邪魔をする可能性があります。
OpenAIも2026年9月11日、GPT-6 Astra向けのSkillsやプロンプトについて、従来モデルで必要だった細かな手順や大量の指示を見直すよう案内しています。特に、SolやLuna向けには役立つ指示でも、Astraにとっては過剰な制約になり得るとしています。1 (OpenAI Developers)
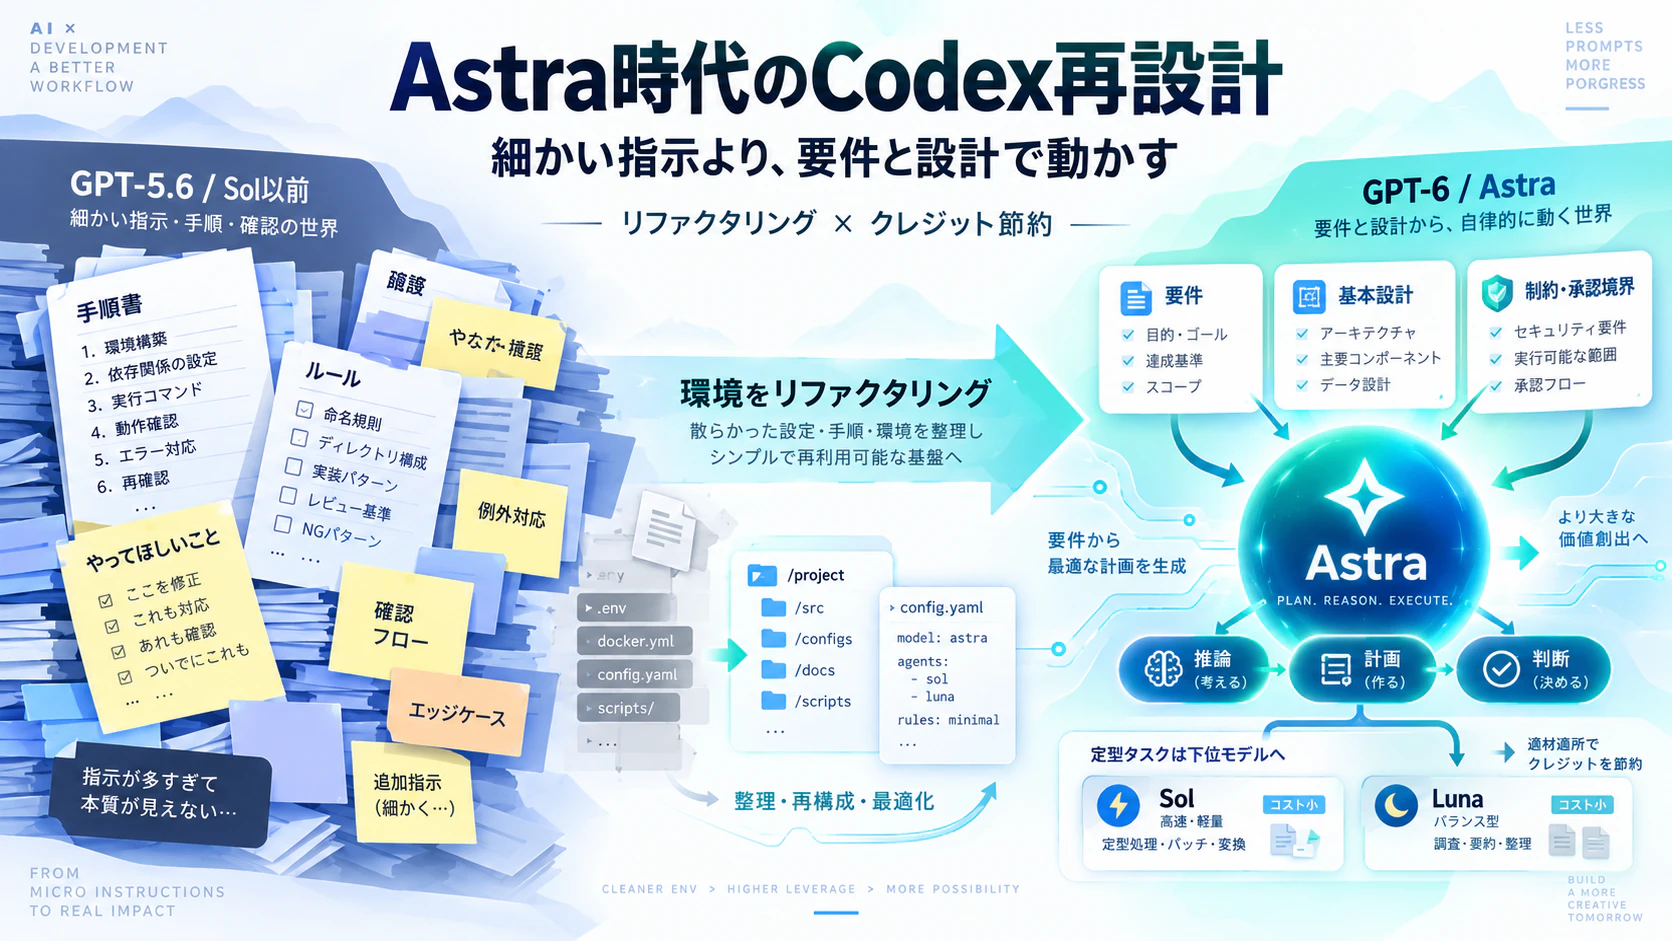
そこで本稿では、Astraを単に「新しい高性能モデル」として既存のCodex環境へ投入するのではなく、一度Astra自身にCodex環境をリファクタリングさせるという運用を考えます。
狙いは二つです。
- Astraが能力を発揮しやすい環境へ変える
- Astraを必要なところだけに使い、SolやLunaと組み合わせてクレジット消費を抑える
これはコードのリファクタリングというより、AIエージェントを動かす「環境そのもののリファクタリング」です。
1. 強いモデルに替えただけでは、環境は新しくならない
モデルが進化しても、古い指示は残る
Codexでは、AGENTS.md、Skills、設定ファイル、README、各種スクリプト、タスクごとのプロンプトなど、さまざまな場所からエージェントへ情報が渡されます。
問題は、これらが時間とともに積み上がっていくことです。
たとえば、過去のモデルがテストを忘れたので「必ずテストせよ」と書き、余計なファイルまで読んだので読むファイルを指定し、勝手に作業を進めたので「必ず確認せよ」と追記する。この繰り返しによって、環境は徐々に「弱いモデルでも事故を起こしにくい設計」へ最適化されます。
私はこの蓄積を、本稿では「モデル補償負債」と呼ぶことにします。
技術的負債が、過去の設計判断によって将来の変更コストを増やすものだとすれば、モデル補償負債は、過去のAIモデルの弱点を補うための指示が、新しいAIモデルの自由度や効率を下げてしまう状態です。
OpenAIもAstraについて、以前のモデルより指示追従能力が高く、SkillsやAGENTS.mdなどの指示の影響を受けやすいため、それらを監査することを推奨しています。2 (OpenAI Developers)
「念のため全部やる」がコストになる
典型的には、次のような変化が考えられます。
| 以前の指示 | Astraでは起こり得る問題 | 見直し方 |
|---|---|---|
| 作業前に設計書をすべて読む | 小さな修正でも大量のコンテキストを消費する | 必要な場合に参照する資料を示す |
| 変更後は全テストを実行する | 局所修正でも不要なテストまで走る | 影響範囲に応じてテストを選ばせる |
| 判断に迷ったら必ず確認する | 判断可能な内容でも作業が止まる | 止める必要がある境界だけ定義する |
| 手順を1から10まで固定する | より良い方法をAstraが選べない | 目的、制約、完了条件を中心にする |
| すべてのモデル向けに同じ指示を書く | Astraには過剰、Lunaには不足となる | 共通部分とモデル別補助を分離する |
OpenAIは、以前のモデルではテスト実行を促す必要があったものの、Astraでは自発的に確認するため、同じ指示を残すと不要なテストにつながる場合があると説明しています。さらに、すべての編集前に複数の資料を読ませるような指示は、コンテキストを消費し作業を遅くする例として挙げられています。1 (OpenAI Developers)
つまり、モデルの性能が上がったのに環境を変えなければ、高性能なモデルを、旧モデル用の補助輪を付けたまま走らせることになります。
2. 一度Astra自身にCodex環境をリファクタリングさせる
ここで発想を変えます。
人間がAGENTS.mdを一行ずつ読み、Skillsを整理し、READMEを修正し、設定ファイルを確認する必要はありません。
Astraにやらせればよいのです。
OpenAIの公式記事でも、新モデルへの移行を機に環境を整理し、Astra自身へ監査を依頼することが提案されています。1 (OpenAI Developers)
最初にバックアップを取る
ただし、環境そのものを変更させるので、元へ戻せる状態は作っておいた方が安全です。
Git管理しているのであれば、現在の状態を確認したうえでスナップショットとなるコミットやタグを残しておけば十分です。
git status
git add -A
git commit -m "chore: snapshot before Astra environment refactor"
git tag before-astra-refactor
未完成の変更まで不用意にコミットしないよう、実際にはgit diffなどで内容を確認してから実行します。
重要なのはバックアップ方法そのものではなく、Astraが大胆に整理しても元へ戻せることです。
Astraには「ファイル修正」ではなく「環境最適化」を依頼する
ここで「AGENTS.mdの○行目を削って」などと、人間が先回りして細かく指定してしまうと、Astraを使う意味が薄くなります。
まずは目的を渡します。
このCodex環境は、主にGPT-5.6 Sol以前のモデルを使いながら構築してきました。

GPT-6 Astraを主力として利用する前提で、このリポジトリとCodex環境を監査し、Astraが効率よく、自律的に、かつ安全に作業できる状態へリファクタリングしてください。

対象は必要に応じて判断してください。AGENTS.md、Skills、README、Codex設定、補助スクリプト、検証処理、Hooks、作業ルールなどを含めて構いません。

特に以下を確認してください。

・旧モデルの能力不足を補うために追加された、現在は過剰な指示
・同じ目的を重複して指示している箇所
・すべての作業で一律に実行している不要なチェック
・必要以上にAstraの判断を禁止しているルール
・毎回大量のファイルを読ませる指示
・Astra自身が判断できる内容を手順として固定している箇所
・矛盾している、または陳腐化した指示
・必要なときだけ読み込める形へ分離した方がよい情報

一方で、セキュリティ、破壊的変更、秘密情報、外部公開、本番環境、課金を伴う操作など、人間の承認が必要な境界は削除しないでください。

まず現状を調査し、変更方針を整理してください。その後、必要なファイルを実際に修正してください。

目的は「指示を減らすこと」ではなく、「Astraに必要な情報を必要なときだけ渡し、判断可能な範囲では自由に判断させること」です。

完了後、削除・統合・移動したルールと、残した重要な制約を簡潔に報告してください。
ポイントは、Astraへ「短くしろ」と指示しているのではありません。
Astra自身に、自分が働きやすい環境を設計させることです。
AGENTS.mdは「百科事典」ではなく「地図」にする
OpenAIはCodex運用について、大量の情報を一つのAGENTS.mdへ詰め込む方法ではなく、必要な資料へ辿り着くための「地図」として使う考え方を示しています。巨大な指示ファイルはコンテキストを圧迫し、すべてが重要に見えてしまい、更新されなくなる問題があるためです。3 (OpenAI)
これはAstraとの相性がよい考え方です。
人間が「このファイルを読め、この順番で処理しろ」と全部決めるのではなく、「データベース変更ならこの資料」「リリースならこの資料」と入口だけを教えます。
後はAstra自身に必要性を判断させます。
3. クレジット節約は「Astraを使わない」ことではない
Astraは強力ですが、当然ながら利用コストも重くなります。
2026年9月13日時点のOpenAIの案内では、Plusプランにおける5時間枠あたりのローカルタスク数の目安は、Astraが5~45件、Solが10~100件、Terraが25~200件、Lunaが250~2,000件です。これは固定されたメッセージ数ではなく、タスク、入出力量、推論設定などによって大きく変化し、別途週単位の制限も存在します。4 (OpenAI Help Center)
| モデル | Plusの5時間枠あたりローカルタスク目安 | 主な使いどころ |
|---|---|---|
| GPT-6 Astra | 5~45 | 設計、複雑な判断、横断分析、難しいリファクタリング |
| GPT-5.6 Sol | 10~100 | 通常の実装、レビュー、明確な設計に沿った変更 |
| GPT-5.6 Terra | 25~200 | 日常的な開発作業、中程度の処理 |
| GPT-5.6 Luna | 250~2,000 | 単純変更、機械的処理、明確な指示に基づく大量作業 |
ここから、「高いからAstraを使わない」と考えると少し違います。
Astraを使うべきなのは、判断の価値が高い場所です。
たとえば、Codex環境全体の設計をAstraに一度整理させ、その後の大量の単純作業をLunaへ回せれば、以降のすべての作業へ効いてきます。
逆に、文字列を34か所置換するだけの作業をAstraへ任せ続ける必要はありません。
つまり、モデルを「性能順」に使うのではなく、「判断密度」で使い分けます。
Astraは上流、SolやLunaは下流へ
一つの運用例は次のようになります。
| 作業 | 選択例 |
|---|---|
| 要件が曖昧な状態から設計を決める | Astra |
| リポジトリ全体を分析して構造を変更する | Astra |
| 原因不明の不具合を調査する | Astra |
| 決まった設計をコードへ落とす | Sol / Terra |
| 限定された範囲のリファクタリング | Sol |
| 単純置換や表記修正 | Luna |
| 明確なチェックリストによる確認 | Luna / Terra |
| 難しいレビューや設計妥当性確認 | Astra / Sol |
Astraの価値は「全部やらせること」ではなく、後工程の自由度を上げる判断をさせることにあります。
4. SolやLunaのために、Astra環境を汚さない
ここで問題になるのが、モデルの使い分けです。
Astra向けに指示を減らすと、SolやLunaでは少し情報が足りないケースが出てくるかもしれません。
だからといって、またAGENTS.mdへ細かな手順を大量に戻してしまうと、Astraの環境まで元に戻ります。
そこで、モデル固有の補助プロンプトを一時的に追加する方法を使います。
これはOpenAIが指摘している「SolやLunaには役立つ指示が、Astraを過剰に拘束する可能性がある」という問題への一つの対処方法でもあります。1 (OpenAI Developers)
たとえばLunaへ作業を切り替えるのであれば、ChatGPT側でそのタスク専用の補助プロンプトを作ります。
以下の作業をGPT-5.6 Lunaで実行します。

このCodex環境はGPT-6 Astra向けに最適化されており、モデル側の判断へ委ねている部分があります。

今回のタスクについて、Lunaでも安全かつ正確に実行できるよう、必要な判断手順、確認事項、対象範囲、完了条件だけを補足した実行プロンプトを作成してください。

恒久的なAGENTS.mdやSkillsを書き換えるのではなく、このタスクだけで使う一時的な補助プロンプトにしてください。

過剰な検証や、タスクと無関係なファイル読み込みは追加しないでください。
これなら、恒久環境はAstra基準のまま維持できます。
必要なときだけSol用、Luna用の「補助輪」を付け、終わったら外します。
これはソフトウェアでいえば、本体のコードへ大量の条件分岐を埋め込むのではなく、アダプターを外側へ置く設計に近い考え方です。
5. 意装開発なら、ファイル名すら人間が決めなくていい
ここまで来ると、README.mdをどう直すか、AGENTS.mdに何を書くか、どの設定ファイルを変更するかを人間がすべて把握する必要性も下がってきます。
本稿でいう「意装開発」は、人間が実装方法を細かく指示するのではなく、何を実現したいか、何を守るべきか、どこまで終われば完成かを自然言語で伝え、実装方法をAIエージェントへ委ねる開発方法です。
今回のCodex環境のリファクタリングも同じです。
人間が決めるのは主に次の四つです。
- 何を良くしたいのか
- 何を壊してはいけないのか
- どこまでAIへ判断を許可するのか
- 何をもって完了とするのか
その意図を満たすためにAGENTS.mdを変更するのか、Skillを分割するのか、READMEを整理するのか、設定ファイルを変えるのかは、Astraに調査させればよいわけです。
概念的には次のようになります。
人間の意図
   ↓
Astraによる環境監査
   ↓
Astra向けに軽量化されたCodex環境
   ↓
┌───────────────┬─────────────────┐
│ 難しい判断     │ 明確な実行       │
│ Astra         │ Sol/Terra/Luna  │
└───────────────┴─────────────────┘
                         ↑
               必要時だけ補助プロンプト
人間がコードやファイルを操作することから、AIが働く環境の意図を設計することへ役割が移っていきます。
これが意装開発をエージェント環境そのものへ適用した形です。
おわりに
Astraへモデルを変更するとき、モデル選択欄だけを変更して終わりにするのは少しもったいない使い方です。
Sol以前のモデルと何か月も付き合いながら作ったCodex環境には、そのモデルをうまく働かせるための工夫が大量に入っています。
しかし、モデルが変われば最適解も変わります。
そこで一度、Astra自身に環境を見せます。
「この環境はあなたより前のモデル向けに作った。あなたが働きやすいように整理してくれ」と頼むわけです。
そのうえで、設計や難しい判断はAstra、通常実装はSolやTerra、機械的な処理はLunaへ分けます。SolやLunaに追加説明が必要なら、そのときだけ補助プロンプトを追加します。
こうすれば、Astraの能力を旧モデル向けのルールで縛らず、同時にクレジットも節約できます。
AIエージェント時代には、コードだけでなく、AIが働く環境そのものにもリファクタリングが必要です。
そしてモデルがさらに進化したときには、また同じことをすればよいでしょう。
「前のモデルに合わせて作った環境を、新しいモデル自身に再設計させる」。
モデルの世代交代が速くなるほど、この考え方は重要になっていくはずです。
参考
-
OpenAI Developers「Rethinking skills and prompts for GPT-6 Astra」(2026年9月11日)。Astraでは旧モデル向けの過剰なSkills、AGENTS.md、タスクプロンプトを見直すこと、SolやLuna向けの指示がAstraを過剰に拘束する場合があること、Astra自身へ環境監査を依頼できることの根拠。(OpenAI Developers) ↩ ↩2 ↩3 ↩4
-
OpenAI「Model guidance」。GPT-6 Astraの指示追従特性と、AGENTS.mdやSkillsなどモデルへ影響する指示を監査する必要性の根拠。(OpenAI Developers) ↩
-
OpenAI「Harness engineering: leveraging Codex in an agent-first world」。巨大なAGENTS.mdではなく、リポジトリ知識への「地図」を与える設計の根拠。(OpenAI) ↩
-
OpenAI Help Center「Managing usage with GPT-6 Astra in Work and Codex」。Plusを含む各プランのAstra、Sol、Terra、Lunaの利用量目安の根拠。(OpenAI Help Center) ↩