
商品画像のロット番号が A7K-2291 でした。素朴な LANCZOS 補間で拡大すると、結果はぼやけているものの一文字も間違わずに読めます。同じ小さい画像を AI 超解像にかけると、五つのモデルすべてが A7K(2201 のような形に変えてしまいました。末尾の 9 の払いが消えて 0 になり、ハイフンが左括弧になっています。しかも AI 側の出力のほうが輪郭がくっきりしていて、見た目は明らかに「きれい」です。どちらを信じるか、という問題がここで発生します。
この話を数字で確かめるために、比較のやり方を少し変えました。世の中でよく見る「拡大前 / 拡大後」の並べ方では、正解にあたる画像が存在しないので、右側が本当に元に近いのかを判定できません。そこで順番を逆にしました。まず高解像度の元画像を用意し、LANCZOS で四分の一に縮小し、その小さい画像を元のサイズまで拡大し直します。元画像がそのまま正解データ(真値)になり、拡大結果と画素単位で差を取れるようになります。ここまでやると「似ているかどうか」が目の問題ではなく計算の問題に変わります。
サンプルは四点用意しました。自作の化粧品パッケージ画像(1200×1200、瓶面に 92px から 14px まで五段階の文字サイズを意図的に配置、ブランド名もロット番号も架空です)、Wikimedia Commons にある CC0 の空港駐機場の写真(第三者素材で、私が撮ったものではありません)、自作の注文書スクリーンショット(グレースケールの表、金額も伝票番号も架空です)、そして純黒の線画アイコンです。拡大には図映 ImgIng(https://imging.ai/ )の AI 高精細化を使いました。五段階のモデルがすべてブラウザ内のローカル推論で動くため、実行中に出入りするバイト数を Network パネルで押さえられます。測定側として、見えないサーバ処理が一段減るのは大きな利点でした。比較対象は Pillow の BICUBIC と LANCZOS です。
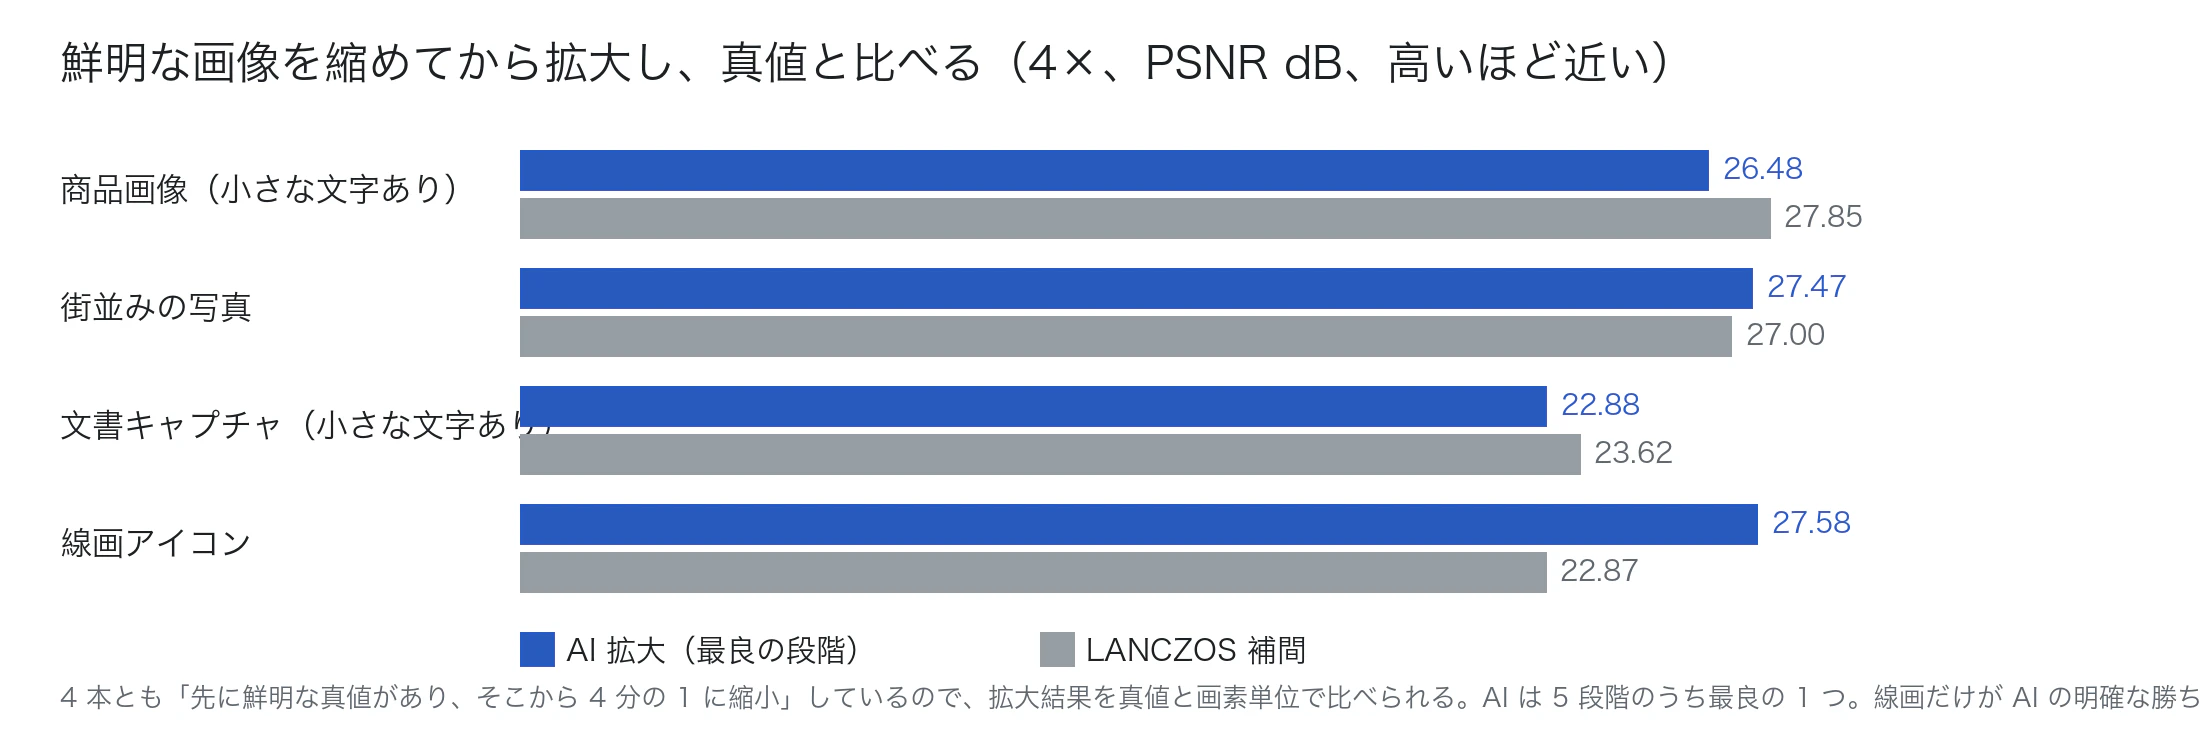
PSNR は真値との差を表す指標で、単位は dB、大きいほど近いという意味になります。結果は予想と違いました。商品画像は AI の最良が 26.48 dB、LANCZOS が 27.85 dB。文書スクリーンショットは AI が 22.88 dB、LANCZOS が 23.62 dB。この二点は、モデルを一切使わない補間のほうが元画像に近いという結果です。一方で街の写真は AI が 0.47 dB 勝ち、線画アイコンは 4.71 dB 勝ちました。線や図形に関しては AI 超解像が明確に強い、というのがこの四点から言えることです。
ですので「AI 拡大は補間に劣る」とは言えませんし、その逆も言えません。分かれ目は写真かスクリーンショットかでも、文字があるかないかでもなく、縮小後にその画線が何ピクセル残っているかでした。
商品画像を文字サイズごとに追うと段階がはっきり出ます。ブランドの大きな文字は 92px で、縮小後も 23 ピクセルの高さが残り、拡大後は形が完全で、輪郭は補間よりきれいです。ラテン文字の 44px は 11 ピクセル残り、これも使えます。内容量を示す「净含量 200 mL」の行(サンプルは中国語表記です)は 34px で縮小後 8.5 ピクセル、数字の 200 mL は正しいのに漢字が別の字に置き換わりました。20px の原材料表示は 5 ピクセルしか残らず、九文字のうち読めるのは多くて三文字です。写真のほうでも同じことが起きていて、機体に大きく入った社名は AI のほうが真値に近く直っている一方、同じ写真の中のより小さい URL の行は塗り潰されて消え、遠くの標識の数字は斜線模様や市松模様に描き換えられていました。
字体や言語や文字サイズが変われば、この境目は動きます。ここで挙げた数字はあくまでこの四点のサンプル上のものだと考えてください。
目視に依存しない証拠もひとつ取れました。文書サンプルの本文領域は真値では完全なグレースケールで、色のついた画素はゼロです。LANCZOS で拡大しても 0.000% のままでした。ところが AI は五段階すべてで色のついた画素を出していて、割合は 0.305% から 2.595%、ある段階では単一画素の RGB 三チャンネルの最大差が 98 に達しました。色は「復元」できません。小さい画像にその情報が存在しないからです。同じ小さい文字の領域で、画線の面積比は真値が 5.64% なのに AI は 7.10%、シャープネスは真値の 16.06 に対して 17.41 でした。元より画線が多く、元より鋭く、それでいて元との誤差は大きいという状態です。
指標の選び方にも落とし穴がありました。同じ出力を SSIM で採点すると、四点すべてで AI が勝ちます。SSIM は局所コントラストが戻ったことを評価する指標で、その一画が元と同じ一画かどうかは見ていません。二つの指標が正反対を指したときは最初スクリプトのミスを疑い、入力パスを二度確認しました。真値を用意していなければ、この食い違いに気づくことすらできなかったはずです。
手元で確かめる手順は簡単です。自分の業務で実際に扱う種類の高解像度画像を一枚選び、四分の一に縮小し、拡大し直して、元画像と同じ座標で小さい文字の行を並べて見比べてください。書き出し形式は必ず可逆のものに固定してください。既定の有損形式のままだと、エンコーダの劣化がモデルの誤差に混ざります。
現時点で私が使っている判断は三つです。線画・アイコン・ロゴ・ベタ面は AI 超解像を使う。風景や建材のような連続的な質感の写真は、わずかに勝つ程度なので急がないときに使う。小さい文字を含む商品画像や文書スクリーンショットは、まず補間で足りないか確かめる。そのうえで、伝票番号やロット番号、内容量や金額といった数値、小さい漢字の三種類は、どの拡大方式を使ったとしても元画像に戻って確認しています。なお人物写真や証明写真については今回一枚も試していないので、この結果からは何も言えません。