
未知の不透明リダイレクトを「推測でベンダー認定」しない:Chrome拡張の保守的分類器
私はメールプライバシー拡張機能 Mailshade の開発者です。公開版 1.0.7 では、既知ベンダーのパターンに一致しない不透明なメールリンクについて、確度が高い場合だけ警告候補にするローカル分類器を追加しました。この記事の目的は製品紹介ではなく、未知の URL を扱うときに、検出範囲を広げながら断定を増やさない設計を再利用できる形で整理することです。
構成と日本語の推敲には生成 AI の支援を使いました。ここに書く条件、しきい値、返却値、除外条件は、1.0.7 の固定コミット、テスト、実際のローカライズ済み UI と照合しています。コード例は説明用に短くしています。
先に結論:結果を 3 状態に分ける
リダイレクト判定を boolean だけにすると、次の二つが同じ true に見えてしまいます。
- 登録済みのパターンに一致し、ベンダーや抽出方式が分かる
- 未知のホストだが、構造上は不透明なメールリダイレクトらしい
この二つは根拠が違います。そこで返却値に認識状態を持たせます。
type Recognition = 'known' | 'heuristic' | 'none';

type UnwrappedLink = {
  original: string;
  real: string;
  vendor?: string;
  pattern?: string;
  mode: 'param' | 'base64-path' | 'pass-through';
  recognition: Recognition;
};
-
known: 登録済みパターンに一致した -
heuristic: 未知だが、独立した複数の構造的根拠を満たした -
none: どちらの根拠もない
重要なのは、heuristic では vendor と pattern を空のままにし、real === original を保つことです。分類器は警告の候補を作るだけで、転送先を発見したことにも、特定ベンダーを認定したことにもなりません。
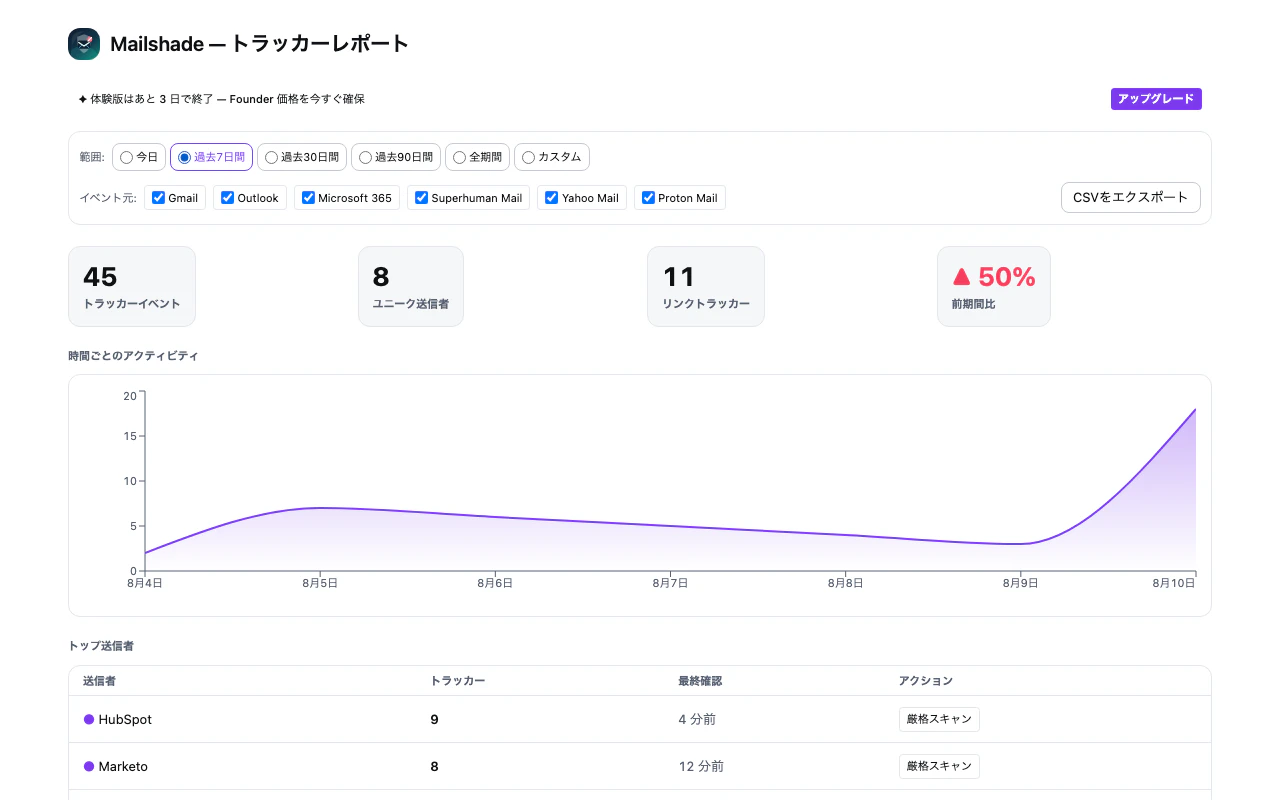
図1 — 公開版 1.0.7 の日本語 UI を、決定的なデモデータで再現した実キャプチャ。実メールボックスの利用結果ではありません。
既知パターンを先、ヒューリスティックを後にする
処理順は意図的に単純です。
for (const pattern of PATTERNS) {
  if (!pattern.matcher.test(input)) continue;

  const real = pattern.extract(parsed);
  return real
    ? { original: input, real, vendor: pattern.vendor,
        pattern: pattern.id, mode: pattern.mode, recognition: 'known' }
    : { original: input, real: input, vendor: pattern.vendor,
        pattern: pattern.id, mode: 'pass-through', recognition: 'known' };
}

if (isHighConfidenceOpaqueRedirect(input, parsed)) {
  return { original: input, real: input,
           vendor: undefined, pattern: undefined,
           mode: 'pass-through', recognition: 'heuristic' };
}

return passThroughResult(input); // recognition: 'none'
既知パターンは、失敗した抽出も含めて既知として扱えます。たとえばホストとパスは確実に既知でも、末尾がサーバー側でしか解決できないトークンなら、ベンダー情報を残した pass-through になります。
一方、ヒューリスティックは既知パターンが一つも一致しなかった場合だけ実行します。ここで既知の抽出器を推測で再利用したり、似ているベンダー名を付けたりしません。
第1段階:採点前に危険な形を落とす
分類器は「怪しさを足し算する」前に、対象外を明確にします。1.0.7 では次を満たさない入力を即座に除外します。
- 入力全体が 4,096 文字以下
https:- URL にユーザー名・パスワード・明示ポート・フラグメントがない
-
localhost、末尾ドット、不正なラベル、IP アドレスではない正規の公開ホスト名 - パスが 2 セグメント以上で、空セグメントがない
- 各パスセグメントを一度だけ安全に URI デコードできる
// を含むパスや末尾 / も除外します。最終セグメントが「最後の不透明値」というモデルから外れるためです。
この段階は誤検知だけでなく、パーサー差異や極端な入力に使う計算量も減らします。判定の入口を狭くすると、後段のスコアが説明しやすくなります。
第2段階:最後の値が本当に不透明かを確認する
最終セグメントは 64〜2,048 文字に制限し、URL-safe Base64 互換文字列または長い 16 進列だけを候補にします。ただし、文字種に合うだけでは足りません。
Base64 系なら、次を同時に求めます。
- 小文字を含む
- 大文字を含む
- 数字を含む
- 異なる文字が 16 種類以上
- Shannon entropy が 4 以上
16 進列なら、64 文字以上に加えて、異なる文字が 12 種類以上、entropy が 3.4 以上です。末尾の = は構文なので、entropy の計算対象から外します。
これにより、次のような「長いだけ」の値を弾けます。
aaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaa
1111111111111111111111111111111111111111111111111111111111111111
entropy はセキュリティ証明ではありません。ここでの役割は、短い ID や単調なスラッグを不透明トークンと取り違えないための一つの独立した根拠です。
第3段階:認証・解除・静的配信の経路を除外する
メール内の長いトークンは、追跡だけに使われるわけではありません。パスの前半に次の語が含まれる場合は候補から外します。
auth, reset, verify, invite, download,
assets, static, unsubscribe
完全一致だけではなく、区切り文字で分解した部分も確認します。たとえば password-reset のようなセグメントも除外対象です。
さらに、パスとクエリの名前・値を調べ、次のいずれかに http:// または https:// が埋め込まれていればヒューリスティックを使いません。
- 元の文字列
- URI デコードを一度行った文字列
- Base64URL を strict UTF-8 として一度復号した文字列
転送先 URL が明示されているなら、それは「未知の不透明トークン」という分類の対象外です。解読可能な値を不透明と呼ばないことが、状態名の意味を守ります。
第4段階:ホストとパスを別々の証拠として採点する
不透明トークンを満たした時点で基礎点は 4 です。ここにホストとパスの信号を加えます。
ホスト信号:+3
先頭ラベルが click、track、tracking、links、mail、redirect、go、r など、メール転送でよく使われる限定集合に入る場合だけ加点します。
パス信号
-
click、track、tracking、redirect、redir、またはtrk/tk+ 数字:+3 -
e、c、r、t、lの短いセグメント:最大 +2 - トークンより前のパスが 3 セグメント以上:+1
合計 8 点以上に加え、相関条件も必要です。
score >= 8 &&
((hostSignal && pathSignal >= 1) || pathSignal >= 5)
つまり、トークン単体では通りません。ホストが強い場合でもパスの根拠が一つ必要で、ホスト信号がなければパス側だけで 5 点必要です。
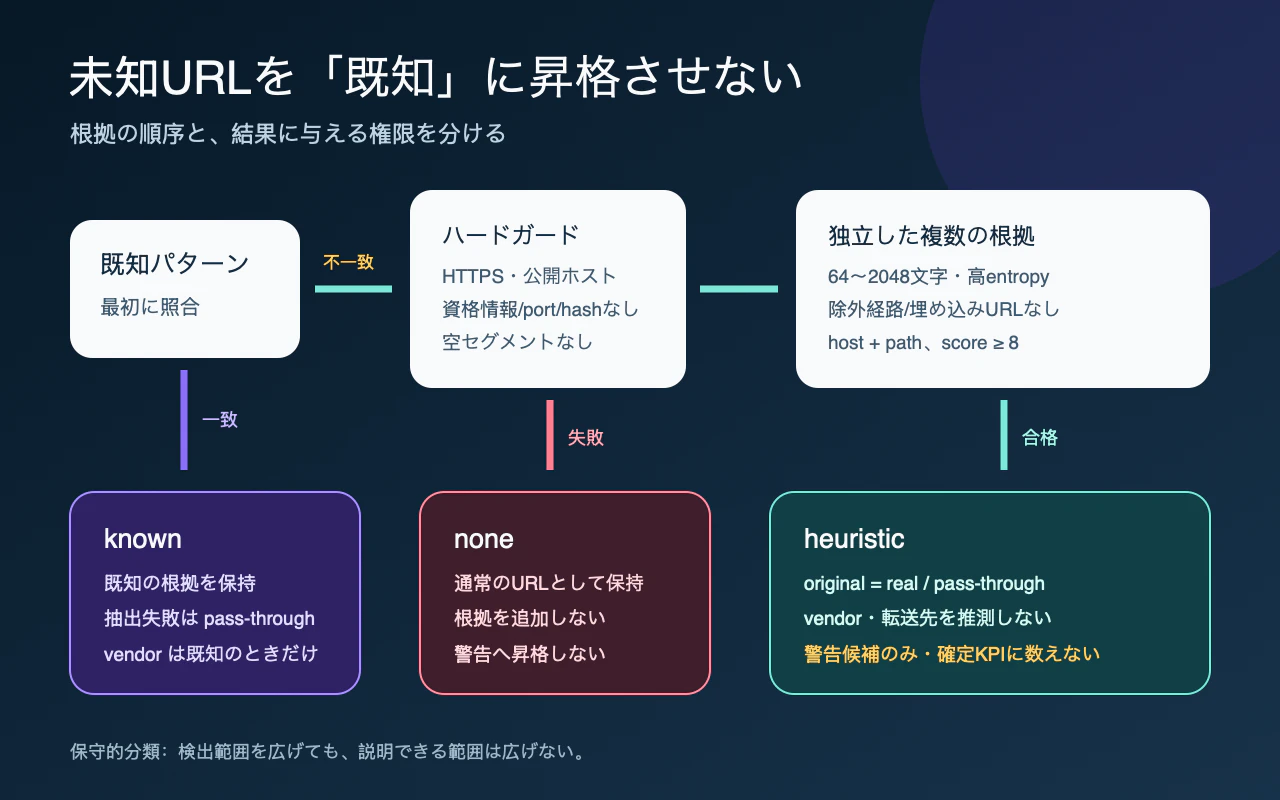
図2 — 判定順序と出力の境界。ヒューリスティックは「警告候補」であり、「既知ベンダー」でも「解読済み転送先」でもありません。
出力側でも断定を増やさない
厳しい入力条件を作っても、出力で扱いを誤ると意味がありません。heuristic の結果には次の制約を置きます。
{
  original: input,
  real: input,
  vendor: undefined,
  pattern: undefined,
  mode: 'pass-through',
  recognition: 'heuristic',
}
この状態から言えるのは、「構造上、不透明なメールリダイレクトらしいため、移動前に注意を促す」ということだけです。
- 特定ベンダー名を UI に出さない
- 直接の転送先が分かったように表示しない
- 確認済みのブロック件数やベンダー別 KPI に加算しない
- 解決のためにバックグラウンドで URL を先読みしない
- ユーザーの選択前に移動しない
分類器の精度だけでなく、分類結果がどの権限を持つかを型と集計の両方で制限する必要があります。
テストは陽性例より陰性例を厚くする
陽性 fixture は、独立した信号の組み合わせを変えて用意します。
- 追跡系の先頭ホスト + 強いパス + 高 entropy トークン
- 中立ホスト + 複数の強いパス信号 + 高 entropy トークン
- Base64URL 系と長い 16 進系の両方
陰性 fixture は、各ガードを一つずつ破ります。
-
http:、明示ポート、フラグメント、資格情報 - localhost、IPv4、末尾ドット、空のパスセグメント
- 63 文字以下または 2,049 文字以上のトークン
- 文字種や entropy が不足する長い文字列
-
reset、verify、unsubscribeを含む経路 - パスやクエリに平文・URI encoded・Base64URL の HTTP(S) 転送先
- 強いホストだけ、または深いパスだけで相関条件を満たさない URL
- 既知パターンに一致し、抽出に失敗する URL
最後のケースは特に重要です。既知パターンの抽出失敗は known + pass-through であり、heuristic に落としてはいけません。どの根拠が先に成立したかを保持するためです。
レビュー時のチェックリスト
- 既知パターン判定がヒューリスティックより先か
- ヒューリスティックにベンダー名や転送先を付けていないか
- HTTPS、公開ホスト、長さ、経路、entropy のガードが独立しているか
- 認証・解除・静的配信の長いトークンを除外しているか
- 埋め込み HTTP(S) 転送先を「不透明」と誤分類していないか
- ホストとパスの相関を要求しているか
- 元 URL を一切変更していないか
- 警告候補を確認済みイベントの KPI に混ぜていないか
- 各ガードを一つだけ破る陰性テストがあるか
未知の URL を完全に理解することはできません。しかし、「何を観測したか」「何を推測していないか」「その結果で何をしてよいか」を分離すれば、対応範囲を広げても説明可能性を失わずに済みます。
2026-08-19 追記:Mailshade 1.1.0 と比較結果の範囲
私は Mailshade の開発者です。公開版 1.1.0 は、2026-08-16 に実施したバージョン固定のネットワーク比較で Trocker 3.4.1 より良い結果を記録しました。1.1.0 と機能的に同等で、差分がバージョン番号と公開文書だけの 1.0.8 リリース候補は、既知トラッカー 43/43 ケースを通過し、無害な画像 59/59 ケースを維持しました。Trocker は 29/43 ケースを通過し、14 件のトラッカー出現を見逃し、3 件の無害な対照に影響しました。これは、この 2 バージョンと 102 件のネットワークケースに限った結果であり、市場全体や将来のバージョンに対する順位ではありません。
1.1.0 では、87 個のソース確認済みルールをホスト全体ではなくパス単位に限定しました。同じベンダーの無害な画像を残しながら、直接ピクセルと Gmail プロキシ URL に埋め込まれた元エンドポイントを同じカタログで判定します。Gmail、Outlook、Microsoft 365、Superhuman、Yahoo Mail、Proton Mail は、それぞれ明示的に有効化した場合だけ対象になります。
この記事で扱った不透明リダイレクトの境界も維持しています。対応するリンク操作は document start から監視し、修飾クリックと中クリックでも警告を重複表示しません。一方、転送先を検証できない URL は推測で解読せず、元 URL とヒューリスティックな根拠を保持します。レポートも「根拠」「確信度」「観測した結果」を別々に記録するようにしました。
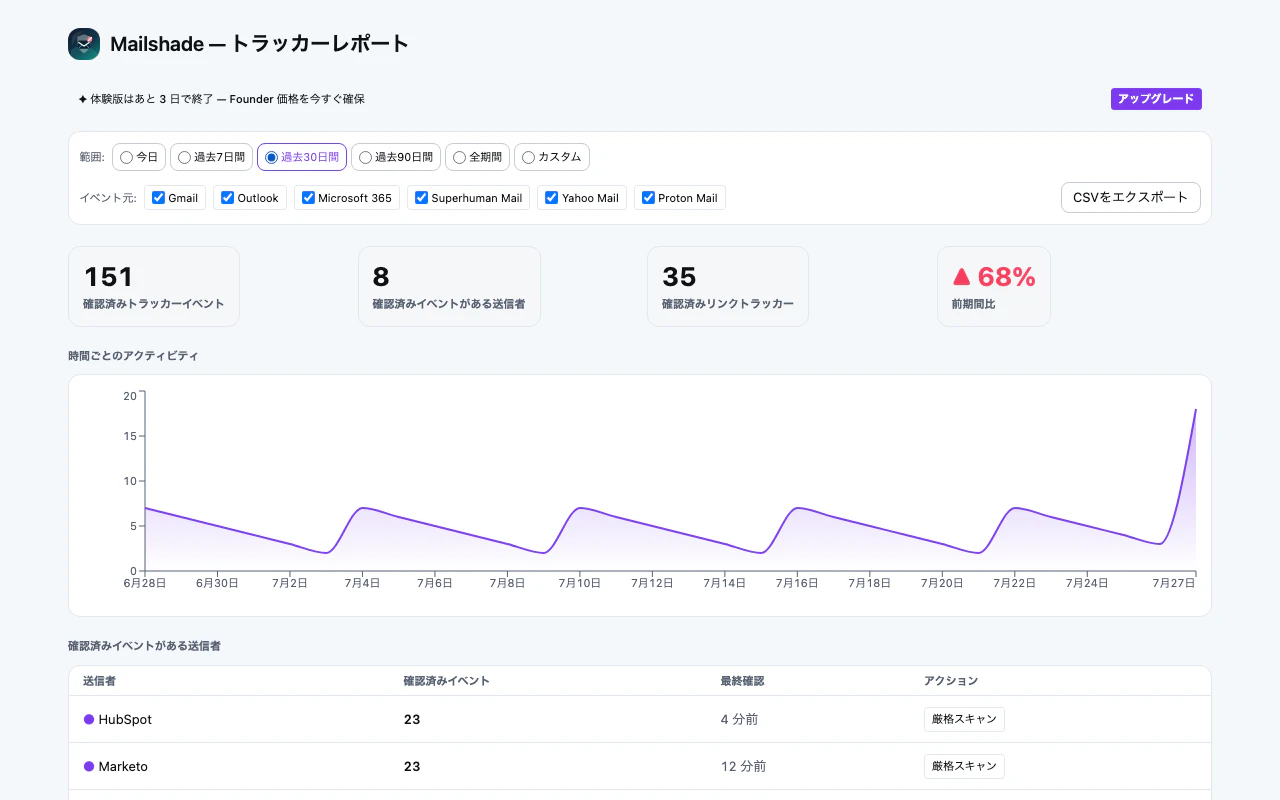
図3 — Mailshade 1.1.0 の日本語レポート UI。値は決定的なデモデータであり、実メールボックスの利用結果ではありません。
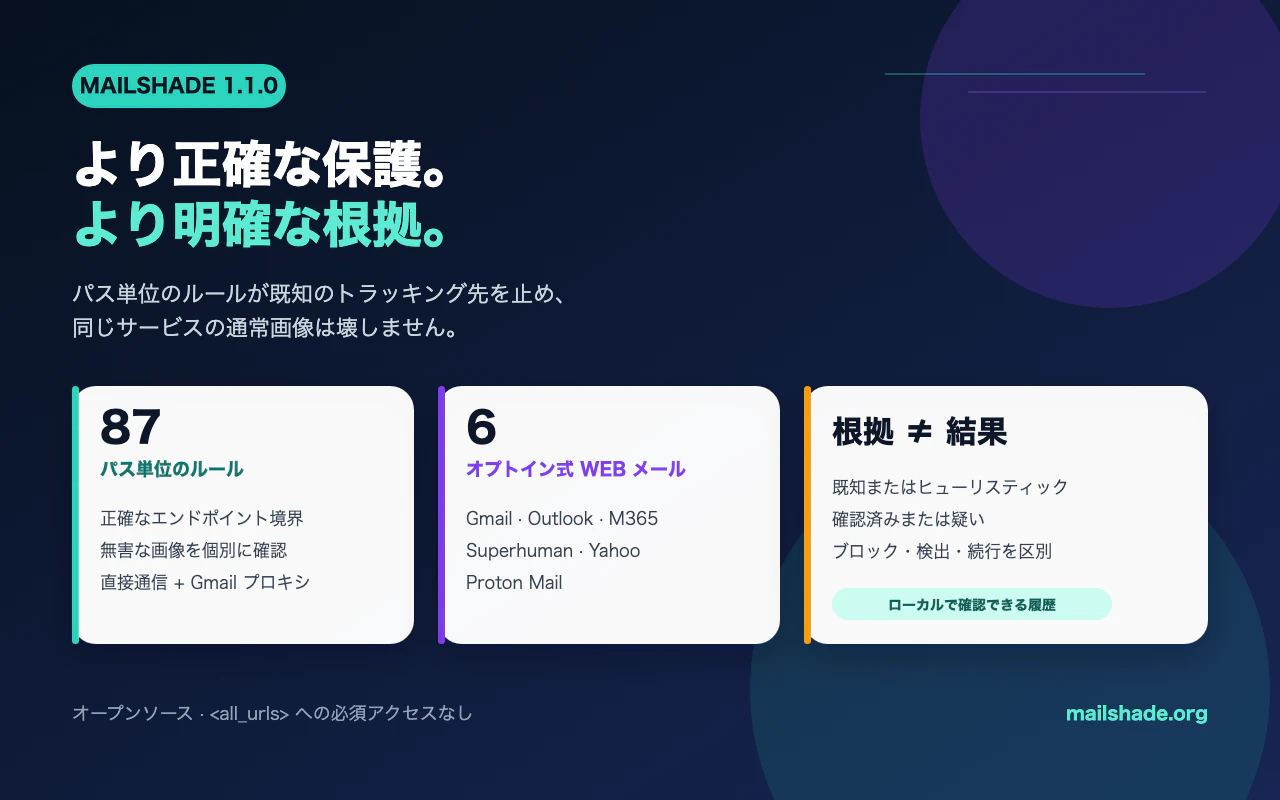
図4 — 6 種類のオプトイン式 Web メールで 87 個のパス単位ルールを使い、根拠と観測結果を分ける 1.1.0 の設計要約。
本文の整理には AI の支援を使い、技術内容は公開版 v1.1.0@a9f2374c6a5816c864143372552b924e001cc15f、テスト、公開 CRX の照合結果に対して確認しました。この記事の以前の記述は当時の公開版を説明する履歴として変更していません。