
はじめに
相関はあるが、実験は組めない。そんなデータを前にして、どちらが原因かを知りたくなることがあります。
そんな場合には統計的因果探索アルゴリズムLiNGAMが使えるかもしれません。
Pythonにはlingamパッケージが存在します。
Rにも既存のパッケージが一応あったのですが、使い方に少々癖があったのでPythonのlingamパッケージを移植する形で、「lingamr」パッケージを作成しCRANに公開しました。
この記事ではlingamrパッケージの中心となる Direct LiNGAM lingam_direct()の使い方について解説します。
LiNGAMには大きく2つの系統があります。信号処理のICA(独立成分分析)を応用したICA-LiNGAM(Shimizu et al. 2006)と、回帰分析を繰り返して直接推定するDirect LiNGAM(Shimizu et al. 2011)です。lingam_direct()が実装しているのは後者のDirect LiNGAMです。ICA-LiNGAMは局所最適解に陥る問題があり、Direct LiNGAMはそれを解消するために提案されました。
インストール
install.packages("lingamr")
lingam_direct()の使い方
入力するデータの形式
lingam_direct()の第一引数Xは、数値のみからなる行列またはdata.frameです。行が観測、列が変数(n_samples × n_features)で、欠損値・定数列・完全な多重共線性を含む列はエラーになります。
注意したいのは、形式だけではありません。LiNGAMは変数間の誤差項(ノイズ)が非ガウス分布であることを前提とするアルゴリズムです。誤差が正規分布に近いと、後述するcausal_orderの推定精度が落ちます。
サンプルデータの紹介
動作確認用にgenerate_lingam_sample_6()が用意されています。既知の因果構造を持つ6変数のデータを生成する関数で、真の構造は以下の通りです。
x3 -> x0 (係数 3.0)
x3 -> x2 (係数 6.0)
x0 -> x1 (係数 3.0)
x2 -> x1 (係数 2.0)
x0 -> x5 (係数 4.0)
x0 -> x4 (係数 8.0)
x2 -> x4 (係数 -1.0)
x3が唯一の外生変数(root)で、x0、x2がその子、x1、x4、x5が末端のleafという構造です。デフォルトの誤差分布はnoise_dist = "uniform"(一様分布、非ガウス)で、noise_dist = "gaussian"にするとLiNGAMがうまく機能しない例も試せます。
library(lingamr)

set.seed(42)
dat <- generate_lingam_sample_6(n = 1000)
head(dat$data, 3)
        x0        x1       x2        x3        x4        x5
1 2.814924 18.017120 4.543655 0.6333728 18.160090 12.236660
2 1.889685 10.956005 2.188091 0.3175366 13.172754  7.932657
3 1.008905  6.990652 1.953131 0.2409218  6.702107  4.797122
戻り値はlist(data, true_adjacency)で、dataが上記のdata.frame、true_adjacencyが真の隣接行列(検証用)です。
因果ダイアグラムで示すとこうなります。
plot_adjacency(dat$true_adjacency)

引数の説明
lingam_direct(
  X,
  prior_knowledge = NULL,
  apply_prior_knowledge_softly = FALSE,
  measure = "pwling",
  reg_method = "adaptive_lasso",
  lambda = "BIC",
  init_method = "ols"
)
| 引数 | デフォルト | 説明 |
|---|---|---|
X |
(必須) | 数値行列またはdata.frame(n_samples × n_features) |
prior_knowledge |
NULL |
事前知識行列(n_features × n_features)。0=directed pathなし、1=directed pathあり、-1=unknown |
apply_prior_knowledge_softly |
FALSE |
事前知識をハード制約ではなくソフト制約として適用するか |
measure |
"pwling" |
独立性の評価指標。"pwling"(ペアワイズ)または"kernel"(カーネルベース) |
reg_method |
"adaptive_lasso" |
隣接行列を推定する回帰手法 |
lambda |
"BIC" |
LASSO系手法の正則化パラメータ選択基準 |
init_method |
"ols" |
adaptive lassoの初期重み推定手法 |
reg_methodは、基本的にはデフォルトのadaptive_lassoのままで使うことをおすすめします。ols、lasso、ridgeは、それぞれの手法の挙動を比較して学ぶための選択肢と考えてください。参考までに、選択肢ごとの違いを載せておきます。
reg_method |
説明 |
|---|---|
"ols" |
通常の最小二乗法 |
"lasso" |
LASSO回帰 |
"adaptive_lasso" |
適応的LASSO回帰(デフォルト、おすすめ) |
"ridge" |
Ridge回帰。多重共線性に頑健だがスパースにはならない |
reg_methodをlasso系にした場合は、正則化の強さを決めるlambdaも選ぶ必要があります。
lambda |
説明 |
|---|---|
"lambda.min" |
CV予測誤差最小。予測精度重視 |
"lambda.1se" |
CVの1SEルール。過学習しにくい |
"AIC" |
AIC最小。高速 |
"BIC" |
BIC最小。高速かつ最もスパース(デフォルト) |
"oracle" |
oracle性を保証するλを選択。reg_method = "adaptive_lasso"専用 |
lambda = "oracle"はreg_method = "adaptive_lasso"以外を指定するとエラーになります("lasso"や"ridge"と組み合わせることはできません)。
measureを"kernel"にすると、サンプルサイズが1000を超える場合に不完全コレスキー分解による低ランク近似へ自動的に切り替わり、計算コストを抑えられます。
出力内容の説明
このサンプルデータを使って lingam_direct()を実行してみましょう。
library(glmnet)
model <- lingam_direct(dat$data)
model
Direct LiNGAM Result
  Variables : 6
  Causal order: x3 -> x2 -> x0 -> x4 -> x5 -> x1

Adjacency matrix (row = to, col = from):
      x0 x1     x2    x3 x4 x5
x0 0.000  0  0.000 3.033  0  0
x1 2.988  0  2.002 0.000  0  0
x2 0.000  0  0.000 5.993  0  0
x3 0.000  0  0.000 0.000  0  0
x4 8.000  0 -1.000 0.000  0  0
x5 4.015  0  0.000 0.000  0  0
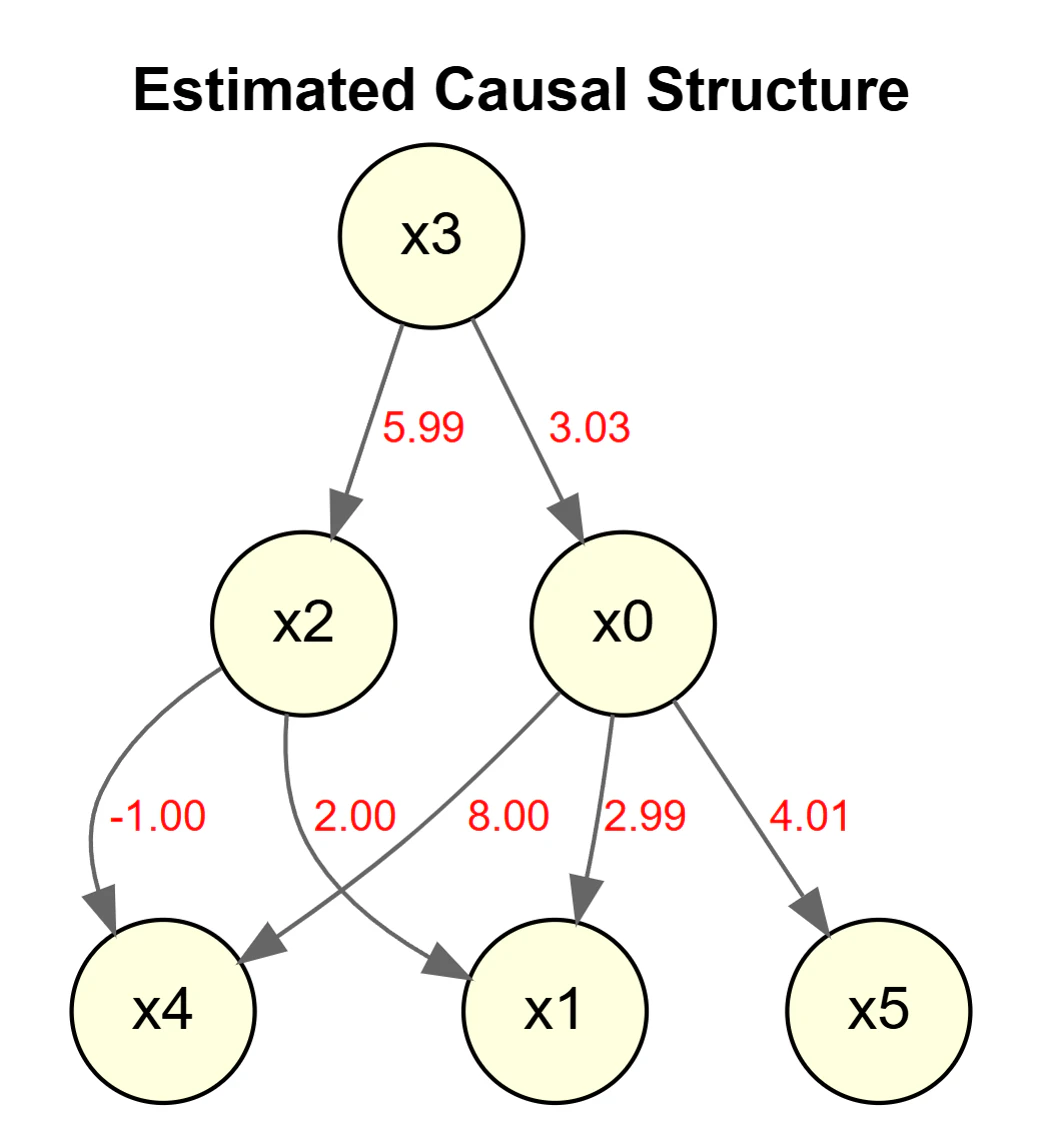
デフォルト(adaptive_lasso)では真の構造(7本のエッジ)がほぼそのまま復元されています。
戻り値の中身はLingamResultクラスのリストで、要素はこの2つだけです。
| 要素 | 型 | 説明 |
|---|---|---|
adjacency_matrix |
数値行列(n_features × n_features) |
隣接行列B |
causal_order |
整数ベクトル | 推定された因果順序(1-based index)。先頭ほど上流 |
隣接行列の添字規約に注意してください。B[i, j]は変数j → 変数iの因果係数を表します(print()の見出しにある通り「row = to, col = from」)。model$adjacency_matrix["x1", "x0"]のように読み、「x0からx1への係数」と解釈します。転置して読み違えると因果の向きが逆になるので要注意です。
causal_orderは変数名ではなく1-basedの列インデックスです。
model$causal_order
#> [1] 4 3 1 5 6 2
colnames(model$adjacency_matrix)[model$causal_order]とすれば、print()が表示している"x3 -> x2 -> x0 -> x4 -> x5 -> x1"と同じ変数名の並びが得られます。
可視化
推定した因果構造は、因果ダイアグラムの形で可視化できます。
DiagrammeRベースのplot_adjacency()を使います。
plot_adjacency(model$adjacency_matrix)
# 真の構造と見比べる
plot_adjacency(model$adjacency_matrix, true_B = dat$true_adjacency)

plot_adjacency()にtrue_Bを渡すと、真陽性(forestgreen)、偽陽性(firebrick)、偽陰性(darkorange、破線)を色分けして表示できるので、シミュレーションデータでの精度検証に便利です。
broom::tidy()
tidy()は隣接行列をエッジ1行ずつのlong形式data.frameに変換します。dplyrでのフィルタやggraphへの受け渡しに使いやすい形式です。
broom::tidy(model)
  from to  estimate
1   x0 x1  2.987705
2   x0 x4  8.000096
3   x0 x5  4.014962
4   x2 x1  2.001708
5   x2 x4 -1.000306
6   x3 x0  3.032952
7   x3 x2  5.992677
fromが原因、toが結果、estimateが係数です。threshold引数(デフォルト0)を指定すると、絶対値がその値以下のエッジを除外できます。
broom::glance()
glance()はモデル全体を1行に要約します。
broom::glance(model)
  n_variables n_edges                     causal_order
1           6       7 x3 -> x2 -> x0 -> x4 -> x5 -> x1
n_variablesが変数数、n_edgesが非ゼロ係数の本数、causal_orderが推定された因果順序を文字列にしたものです。複数のデータセットや条件でモデルを回して結果を比較する際、purrr::map_dfr()などで一覧化するのに向いています。
summary_lingam()で前提を確認する
lingam_direct()は、非ガウス性の前提が崩れているデータを渡しても、エラーを出さずに何かしらのcausal_orderを返してしまいます。数字が出てくる以上、それらしく見えてしまうのが厄介なところです。
summary_lingam()は、この前提が実際のデータで成り立っているかを検証してくれます。LiNGAMが依拠する2つの仮定、残差の独立性と残差の非ガウス性を一度に確認できます。
model <- lingam_direct(dat$data)
summary_lingam(dat$data, model)
=== Direct LiNGAM Model Summary ===
Variables:    6
Observations: 1000
Edges:        7
Causal order: x3 -> x2 -> x0 -> x4 -> x5 -> x1

--- Assumption 1: Independence of residuals ---
Method:           spearman
Dependent pairs:  0 / 15  (p < 0.050)
Min p-value:      0.0510
=> Residuals appear mutually independent (assumption supported).

--- Assumption 2: Non-Gaussianity of residuals ---
Method:           shapiro
Non-Gaussian:     6 / 6  (p <= 0.050)
=> All residuals are non-Gaussian (assumption supported).
真の構造通りの因果順序が推定でき、両方の仮定も支持されています。
では、誤差が正規分布に近いデータではどうなるでしょうか。generate_lingam_sample_6()にnoise_dist = "gaussian"を渡すだけで再現できます。
dat_g <- generate_lingam_sample_6(n = 1000, noise_dist = "gaussian")
model_g <- lingam_direct(dat_g$data)
summary_lingam(dat_g$data, model_g)
=== Direct LiNGAM Model Summary ===
Variables:    6
Observations: 1000
Edges:        9
Causal order: x1 -> x2 -> x5 -> x3 -> x4 -> x0

--- Assumption 1: Independence of residuals ---
Method:           spearman
Dependent pairs:  7 / 15  (p < 0.050)
Min p-value:      0.0000
=> WARNING: 7 residual pair(s) appear dependent. Model may be misspecified.

--- Assumption 2: Non-Gaussianity of residuals ---
Method:           shapiro
Non-Gaussian:     1 / 6  (p <= 0.050)
=> WARNING: 5 variable(s) appear Gaussian. LiNGAM may be unreliable.
lingam_direct()はここでもエラーなくcausal_orderを返しますが、真の構造(x3が最上流)とはかけ離れた順序(x1が最上流)になっており、独立性と非ガウス性のどちらの警告も出ています。summary_lingam()を挟まなければ、この破綻に気づく手段がありません。
引数の説明
| 引数 | デフォルト | 説明 |
|---|---|---|
X |
(必須) |
lingam_resultの推定に使った元データ |
lingam_result |
(必須) |
lingam_direct()の戻り値(LingamResultオブジェクト) |
independence_method |
"spearman" |
残差の独立性検定に使う相関係数。"spearman"/"pearson"/"kendall"
|
normality_method |
"shapiro" |
残差の正規性検定手法。"shapiro"/"ks"/"ad"/"lillie"/"jb"
|
alpha |
0.05 |
有意水準 |
BIC、AICのようなガウス尤度ベースの基準は、あえて含まれていません。「誤差は非ガウスである」というLiNGAMの前提と理論的に矛盾するためです。代わりに、前提そのものの検証結果を返す設計になっています。
出力内容の説明
戻り値はlingam_summaryクラスのリストです。主な要素は次の通りです。
| 要素 | 説明 |
|---|---|
n_variables, n_samples
|
変数の数、観測数 |
causal_order |
因果順序(変数名) |
n_edges |
推定されたエッジの本数 |
independence_p_values |
残差間の独立性検定のp値行列 |
n_dependent_pairs, n_pairs
|
p < alphaとなったペア数 / 全ペア数 |
min_independence_p |
独立性検定の最小p値 |
normality |
正規性検定の結果(lingam_normality_testオブジェクト) |
n_non_gaussian |
非ガウスと判定された変数の数 |
print()にそのまま渡せば、上で見た通りの整形済みレポートが得られます。個々の値を条件分岐に使いたい場合は、これらの要素に直接アクセスします。
s <- summary_lingam(dat$data, model)
s$n_dependent_pairs
#> [1] 0
s$n_non_gaussian
#> [1] 6
まとめ
lingam_direct()は、数値のdata.frameを渡すだけで因果構造を推定できるシンプルなインターフェースです。出力のLingamResultはprint()、autoplot()、plot_adjacency()、tidy()、glance()に対応しているので、探索から可視化、他ツールとの連携まで一通りこなせます。summary_lingam()を併用すれば、その推定が前提の上に立っているのか、それとも崩れた足場の上にあるのかを確認できます。
以上です。
Enjoy!