
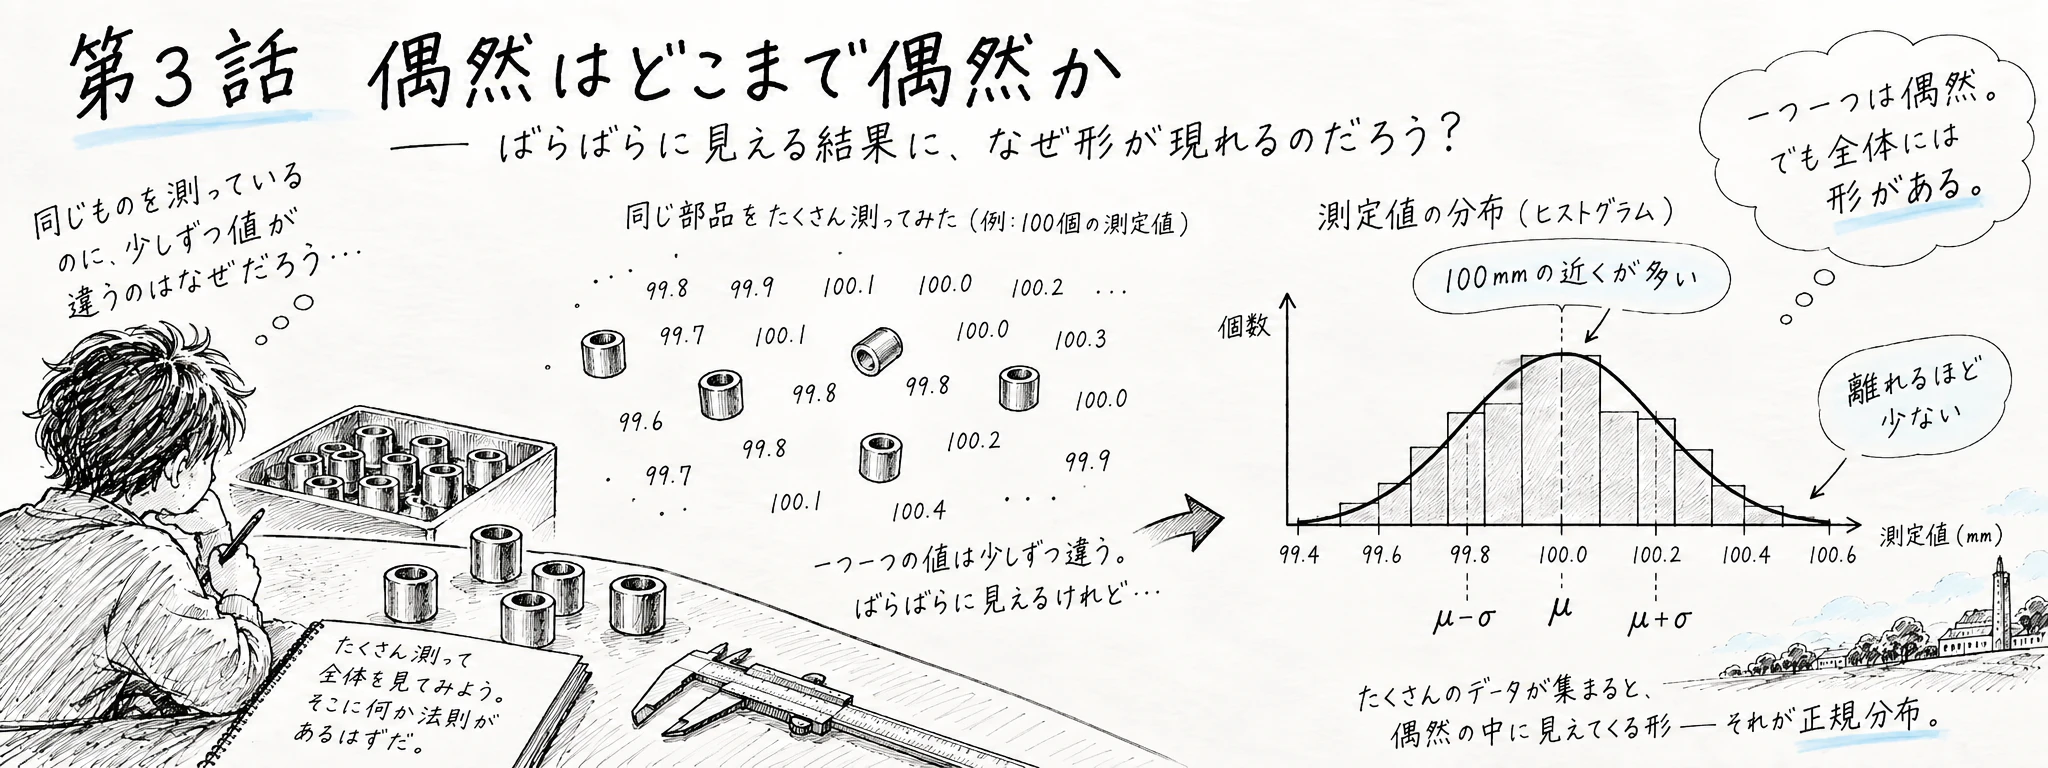
正規分布
f(x)=\frac{1}{\sqrt{2\pi\sigma^2}}
\exp\left(
-\frac{(x-\mu)^2}{2\sigma^2}
\right)
小さな謎
僕は町工場の工員。同じ材料、同じ機械で部品を作っているけれど長さを測ると少しずつ違う。
設計上はすべて「100.0 mm」のはずなのに、
99.8, 100.1, 100.0, 99.7, 100.2, ……
と、少しずつ違う。測定器がヒストグラムを出す。
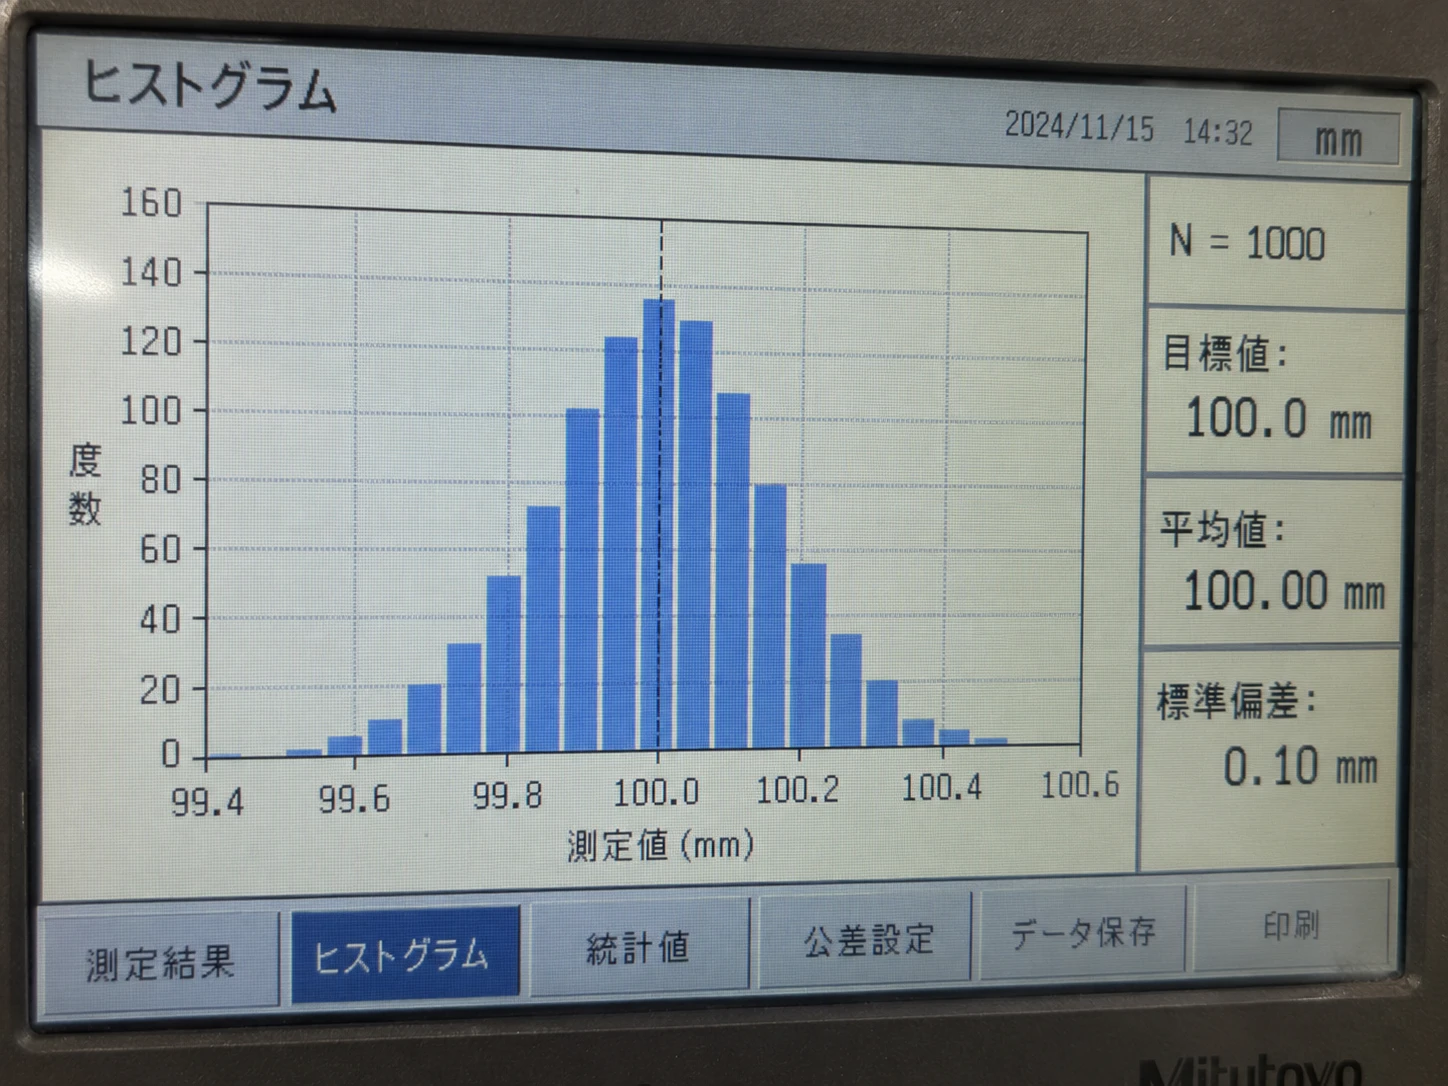
100 mmの近くが多く、離れるほど少なくなる。しかも左右ほぼ対称の、きれいな山となる。
偶然なら、もっとバラバラになってもいいはずだ。
なぜ偶然には「形」があるのだろう?
数式で謎解き
測定値を$X$とする。
また、今回の測定結果から、平均値
\mu=100.0\ \mathrm{mm}
標準偏差
\sigma=0.10\ \mathrm{mm}
であったとする。
このばらつきが正規分布に従うと考えると、
X\sim\mathcal{N}(100,\ 0.1^2)
と書ける。
ここで正規分布の性質として、
| 範囲 | 全データのうち |
|---|---|
| $\mu\pm\sigma$ | 約68.3% |
| $\mu\pm2\sigma$ | 約95.4% |
| $\mu\pm3\sigma$ | 約99.7% |
が入る、という特徴がある。
今回なら、
| 範囲 | 測定値 | 1000個なら期待される個数 |
|---|---|---|
| $\mu\pm\sigma$ | 99.9〜100.1 mm | 683個 |
| $\mu\pm2\sigma$ | 99.8〜100.2 mm | 954個 |
| $\mu\pm3\sigma$ | 99.7〜100.3 mm | 997個 |
となる。
つまり1000個のうち大部分は100mm近くに集まり、100mmから離れるほど個数は急速に少なくなる。
だからヒストグラムにすると、
中央が高く、左右に行くほど低くなる。
あの釣鐘型が現れる。
ここで中心式を出します。
f(x)=\frac{1}{\sqrt{2\pi\sigma^2}}
\exp\left(
-\frac{(x-\mu)^2}{2\sigma^2}
\right)
100.03mmになるか99.98mmになるか、一つ一つの部品については分からない。
しかし大量に、例えば1000個集めれば、どこにどれくらい集まるかは見えてくる。
一つ一つは偶然でも、その偶然の散らばり方には形がある。
それが正規分布である。
なぜ現実のさまざまな現象で正規分布が現れやすいのか。その背景の一つに、多数の小さな要因の和が正規分布に近づくことを示す「中心極限定理」がある。ここでは立ち入らない。
数式解説
正規分布は、次の式で表されます。
f(x)=
\frac{1}{\sqrt{2\pi\sigma^2}}
\exp\left(
-\frac{(x-\mu)^2}{2\sigma^2}
\right)
いきなり見ると、少し複雑に見えますが、内容は意外と単純です。
$x$:今見ている値
いま考えている測定値。例えば、$x=100.2$なら、
「100.2mmという測定値は、どれくらい起こりやすいのか」
を考えていることになる。
厳密には $f(x)$ はその値そのものの確率ではなく、確率密度(その周辺の起こりやすさ)を表す。
$\mu$:平均値(=分布の中心)
今回なら、$\mu=100.0$となっている。
正規分布では、この $\mu$ のところが山の中心となり、そこから左右に値が散らばっている。
$x-\mu$:中心からどれだけ離れているか
例えば、$x=100.2, \mu=100.0$ならば、
x-\mu=0.2
となる。つまり、平均から0.2mm離れているということ。
正規分布では、平均から離れるほど、その値は起こりにくくなっている。
$(x-\mu)^2$
では何故2乗するのか?平均より大きい値なら $x-\mu$ はプラス、平均より小さい値ならマイナスになる。
例えば、$100.2-100.0=0.2$ですが、$99.8-100.0=-0.2$ですが、どちらも平均から0.2mm離れているという意味では同じ。
そこで二乗すると、$0.2^2=(-0.2)^2$となり、平均から左右どちらに離れていても、同じ距離として扱えることとなる。
そして、これが、正規分布が左右対称になる理由の一つ。
$\sigma$:標準偏差。
どれくらいばらつく世界なのかを示す値。
今回は、$\sigma=0.1$となっている。これが小さいと測定値は平均の周りに集まり、大きいと広く散らばる。
つまり $\sigma$ は、この世界では、どのくらいの散らばりが普通なのかを表している。
$\displaystyle \exp\left(
-\frac{(x-\mu)^2}{2\sigma^2}
\right)$
正規分布の中心部分であり、平均から離れるほど急速に起こりにくくなるという性質を表している。
$\exp$ は指数関数で、$e^a$と同じもの。ここで重要なのは、指数の前にマイナスがついていること。つまり$e^{-a}$、これは$a$の値が大きくなると急速に小さくなっていく。

そして、$e^{-a^2}$の形なので、$|a|$、つまり0からの距離が大きくなるほど急速に小さくなる。左右対称のこんなグラフの形となる。

a=\frac{(x-\mu)}{\sqrt{2}\sigma}
と考えれば、
-a^2=-\frac{(x-\mu)^2}{2\sigma^2}
となる。平均 $\mu$ に測定値 $x$ が近づけば指数関数の値は1に近づき、離れるほど急速に0へ近づく。
つまり、
平均の近くは起こりやすい。
平均から遠くなるほど、急速に起こりにくくなる。
これが、あの釣鐘型を作っている。
$\displaystyle \frac{1}{\sqrt{2\pi\sigma^2}}$
最後に、この変わった式は何か?
まず、確率分布として扱うためには、確率密度を全範囲で積分した値が1になる必要がある。今の式を積分してみる(標準偏差なので $\sigma>0$ である)。
\int_{-\infty}^{\infty}\exp\left(
-\frac{(x-\mu)^2}{2\sigma^2}
\right)dx
ここで
z=\frac{x-\mu}{\sigma}
とおくと
x=\mu+\sigma z
なので、
dx=\sigma dz
また、
\frac{(x-\mu)^2}{2\sigma^2}=\frac{z^2}{2}
だから、
\int_{-\infty}^{\infty}
\exp\left(
-\frac{(x-\mu)^2}{2\sigma^2}
\right)dx=\sigma\int_{-\infty}^{\infty}e^{-z^2/2}\,dz
ここでガウス積分
\int_{-\infty}^{\infty}e^{-z^2/2}\,dz=\sqrt{2\pi}
を使うと、
\int_{-\infty}^{\infty}
\exp\left(
-\frac{(x-\mu)^2}{2\sigma^2}
\right)dx=\sigma\sqrt{2\pi}
となる。
ただ、確率密度として使うためには、全体の積分値を1にする必要があり、
\frac{1}{\sigma\sqrt{2\pi}}=\frac{1}{\sqrt{2\pi\sigma^2}}
を掛ける必要がある。
したがって正規分布では、
\int_{-\infty}^{\infty}
\frac{1}{\sqrt{2\pi\sigma^2}}
\exp\left(
-\frac{(x-\mu)^2}{2\sigma^2}
\right)dx
=1
になる。つまり、
\frac{1}{\sqrt{2\pi\sigma^2}}
は、正規分布を確率分布とするため、釣鐘型の山の面積をちょうど1にするための係数である。
触れるデモ
このデモでは、正規分布の3つの値を実際に動かして確かめられます。
- 平均 $\mu$ を動かすと、分布の中心が左右に移動する
- 標準偏差 $\sigma$ を動かすと、山の広がり方が変わる
- 測定値 $x$ を動かすと、その値が平均からどれくらい離れているかを $z$ スコアで確認できる
さらに「1000個の部品を作る」を押すと、設定した正規分布に従って1000個の測定値を生成する。
押すたびにヒストグラムの細かな形は変わるが、全体としては正規分布の曲線に近い山が現れる。
一つ一つの値は偶然でも、たくさん集めるとばらつきの形が見えてくる。
それを触って確かめるためのデモ。
See the Pen 03 by aokikenichi (@aokikenichi) on CodePen.
別分野への接続
まず品質管理。工場では、部品の寸法・重量・加工誤差などのばらつきを見る。
単に「平均との差」ではなく、何$\sigma$離れているかで異常を考える。
ここからいわゆる$3\sigma$管理にもつながる。
次に偏差値。偏差値は、
z=\frac{x-\mu}{\sigma}
で表される $z$ スコアを、平均50、標準偏差10になるように変換したもの。
偏差値=50+10z
つまり、「80点取った」ではなく、「集団の中でどれくらい珍しい80点か」を見る考え方。
さらに機械学習。
多くのモデルで、
\epsilon \sim \mathcal{N}(0,\sigma^2)
のようにノイズを正規分布で表現する。
線形回帰、ベイズ統計、カルマンフィルタ、VAE、拡散モデル
まで、正規分布は何度も登場する。
正規分布は、第3話だけの数式ではなく、この先、AIのさまざまな場所で何度も再会する。
この数式が提示する「世界観」
世界は完全には予測できない。
しかし、予測できないことにも構造がある。
一つ一つの部品が100.03mmになるか99.94mmになるかは分からない。
でも1000個集めれば、どのあたりに、どれくらい集まるかは予測できる。
つまり、
個体は予測できない。
集団には法則が現れる。
僕は、偶然とは秩序の反対だと思っていた。
けれど、1000個の部品を並べてみると、偶然の中から一つの山が浮かび上がった。
世界は揺らいでいる。
それでも、その揺らぎ方には法則がある。
- 構成案、文案、デモ生成、内容チェックなどにChatGPT 5.6 Solを用いております
- ただ文章自体は本記事著者、青木が書いております