
要件定義の会議で、「分かりやすく」「すぐに」「セキュリティはちゃんと」といった言葉を、そのまま受け取ってしまったことはありませんか。
その場では合意できたように見えても、開発が進んでから「そういう意味ではなかった」と分かることがあります。会話を正確に記録できても、そもそも確認しなかったことは、議事録には残りません。
そこで、会議中の発言から確認すべき論点を見つけ、アドバイスとマインドマップで聞き手を支援するアプリ 「Reqlogue」 を開発しました。
Reqlogueが目指すのは、要件定義の代行ではありません。
人が会話に集中できるように、AIが確認と整理を自律的に支援すること。
概要
本作品は、業務効率化AIをテーマとする AI HACK 2026 の応募作品です。LLMの呼び出しやモデルの使い分け、ガードレールには、スポンサーの OrcaRouter を利用しています。
| 項目 | 内容 |
|---|---|
| 対象 | 顧客との要件定義を担当するPM・SE・コンサルタントなど |
| 主な機能 | 会話の分析、確認アドバイス、マインドマップの更新、要件定義書ドラフトの生成 |
| 現在の状態 | ローカルで動作するMVP。業務効果・品質・費用の定量評価は今後実施 |
目次
- きっかけは「正確だけれど、欲しいものではない」AI
- Reqlogueが支援するのは、質問できるタイミング
- 「セキュリティはちゃんと」を確認事項に変える
- なぜAIを使うのか
- 指摘は、多ければよいわけではない
- マインドマップを会話に合わせて更新する
- AIが判断する部分と、アプリが制御する部分
- OrcaRouterで処理ごとの品質・コスト・セキュリティを考える
- 会議データを扱うためのセキュリティ
- AIの出力を、そのまま正解にしない
- 現在できること/今後の展望
- まとめ
1. きっかけは「正確だけれど、欲しいものではない」AI
開発のきっかけは、営業担当者向けのRAGシステムで経験した認識のずれでした。
社内に散らばる情報を検索し、営業担当者の質問へ回答するシステムです。開発側は、できるだけ正確で詳しい回答を返せるよう、検索対象やデータ構造、回答生成を調整していました。
ところが、顧客が求めていたのは、少し違うものでした。
専門知識が少ない営業担当者でも、質問したらすぐに概要を理解できること。
詳しい説明が返ってくることと、利用者が知りたいことを理解できることは、同じではありません。
この違いは回答の言い回しだけでは解消できず、検索やデータの持ち方、UIなどの見直しにもつながりました。修正が積み重なり、開発の余裕がなくなっていきました。
振り返ると、最初に確認すべきことがありました。
- 使う人は、どの程度の専門知識を持っているのか
- 回答を読んだ後、何をしたいのか
- どの程度の情報量なら「分かりやすい」と感じるのか
- 「すぐ分かる」とは、どのような状態なのか
「営業向けのAIを作る」という大枠は共有できていても、利用者の姿や使われ方まで十分に確認できていませんでした。
問題は、記録だけでは解決しない
要件定義では、相手の話を聞きながら、同時にいくつもの作業をしています。
| 会議中の作業 | 難しいところ |
|---|---|
| 相手の意図を理解する | 抽象的な表現から、背景や目的を読み取る必要がある |
| 不足している情報に気づく | 話に出ていない項目は、記録するだけでは見つからない |
| 前後の整合性を確認する | 以前の発言との違いを覚えておく必要がある |
| 次の質問を考える | 会話の流れを止めずに、重要な論点を選ぶ必要がある |
| 要件として整理する | 発言をそのまま並べるだけでは、要件書にならない |
すべてを聞き手の注意力と経験に任せるのではなく、会話のそばで確認と整理を支える仕組みを作れないか。それがReqlogueの出発点です。
2. Reqlogueが支援するのは、質問できるタイミング
Reqlogueは、会議中の確認と整理を支援するアプリです。
トップ画面のメッセージは、 「話すことに、集中しよう。」
相手の話を聞きながら、確認事項を考え、情報を整理する。その負担の一部をAIが支えることを目指しています。
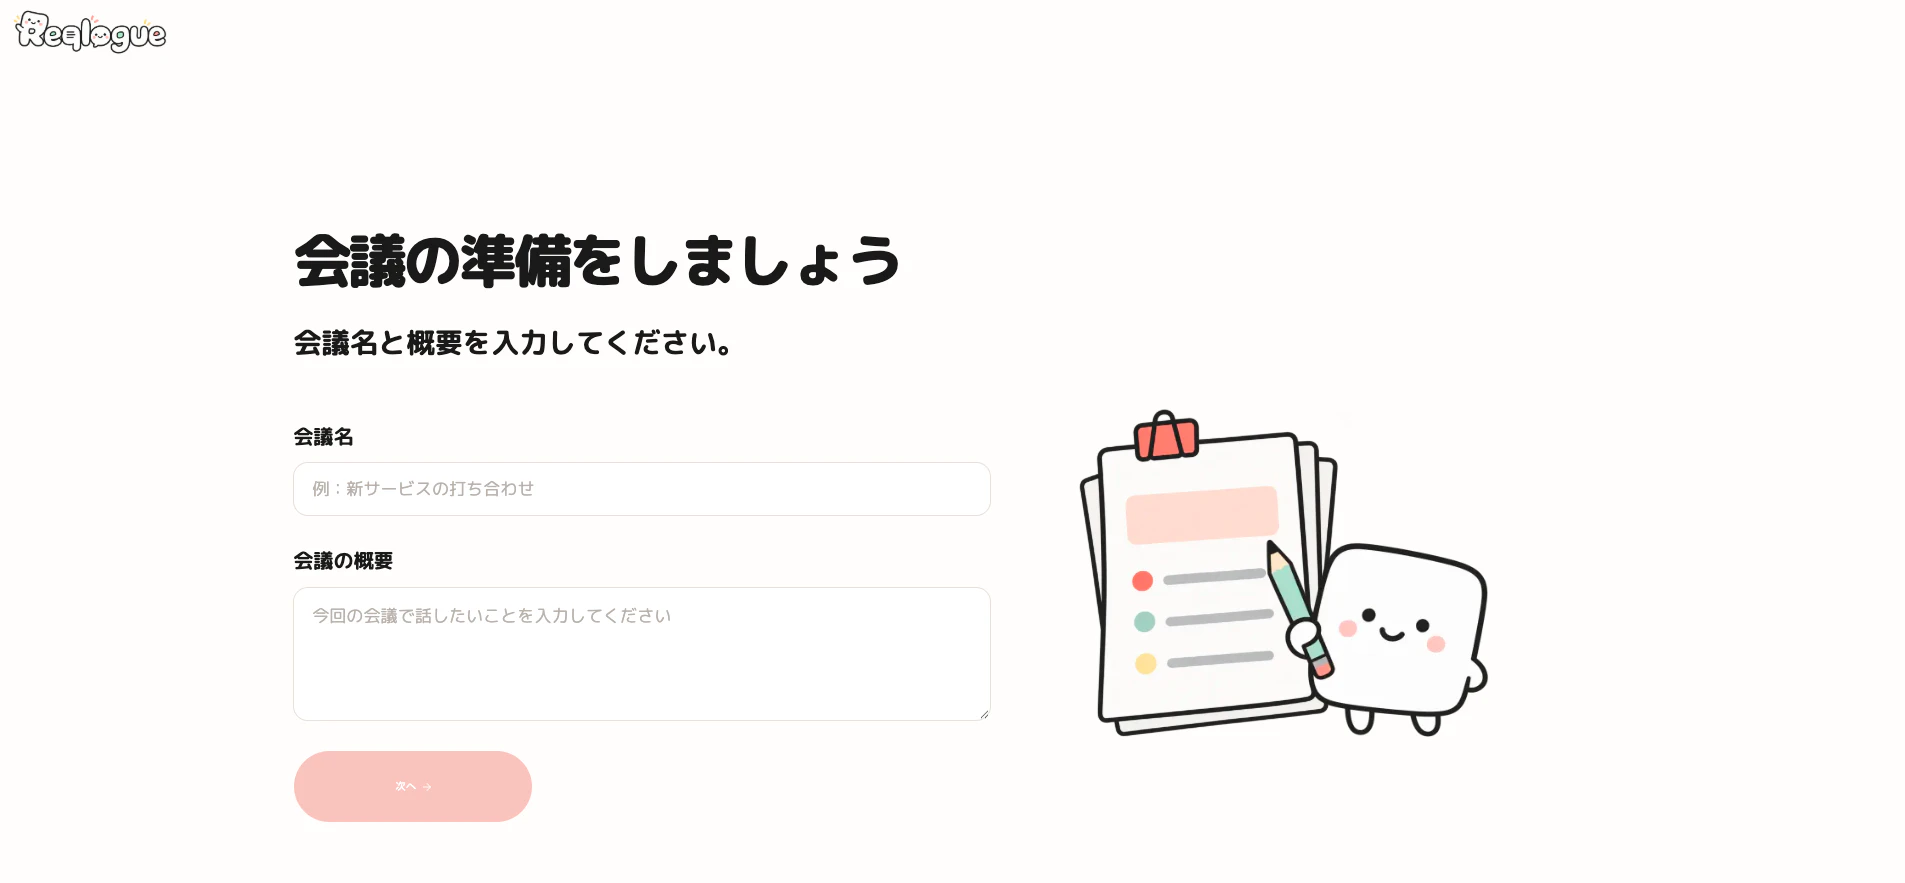
Reqlogueのトップ画面。会議の名前を入力して開始します。
会議中に見るのは、アドバイスとマインドマップ
利用者に見せるのは、文字起こしそのものではなく、主に次の2つです。
- アドバイス:今、その場で確認した方がよいこと
- マインドマップ:会話から整理した内容と、その関係
アドバイスを見た聞き手が、実際に質問するかを判断します。AIが顧客へ直接質問するわけではありません。
アドバイスは「表示して終わり」にしない
会議が長くなると、アドバイスは1件では済みません。表示されたものをただ眺めるだけでは、どれに対応済みで、どれが積み残しなのか分からなくなります。
そこでReqlogueでは、アドバイスを アドバイス/対応中/解決済み の3列からなるカンバンボードで管理できるようにしています。
- 新しく生成されたアドバイスは、まず「アドバイス」列に追加される
- 聞き手が確認や質問に着手したら「対応中」へドラッグする
- 解決した、あるいは対応不要と判断したものは「解決済み」へ移動する、または削除する
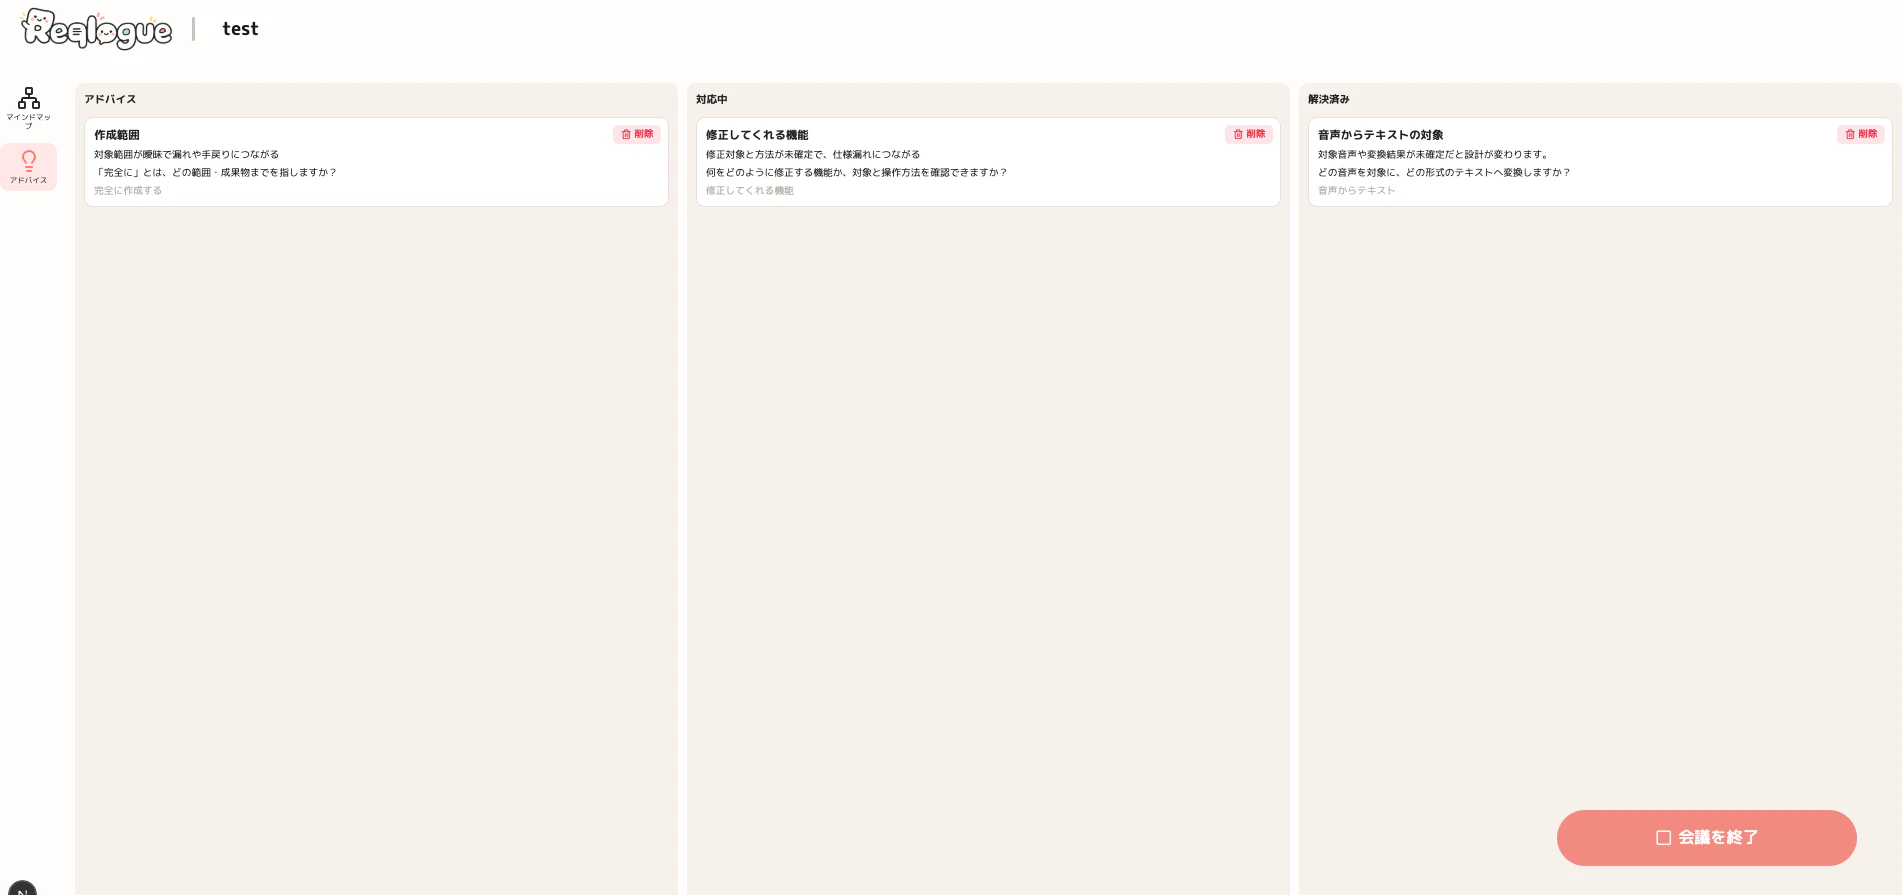
アドバイスボード。「アドバイス」「対応中」「解決済み」の3列でカードを管理し、ドラッグ&ドロップで移動できます。
各カードには、論点(title)・その理由(reason)・実際にクライアントへ聞くための質問候補(suggestedQuestion)・根拠となった発言の引用(quote)が含まれており、なぜそのアドバイスが出たのかをカード単体で確認できます。
この管理は会議中の画面上でリアルタイムに反映され、会議の記録と同じ場所に保存されます。忙しい会議の最中でも、今どこまで確認できていて、何が残っているかを、聞き手自身がひと目で把握できることを目指しています。
会議後には、会話内容をもとに要件定義書のドラフトを生成します。
会議後の文書化だけでなく、会話へ戻す
会議後に議事録を整理する方法でも、曖昧な記述を発見できます。ただし、その時点で回答がなければ、追加の確認が必要です。
Reqlogueでは、相手に質問できるタイミングで、確認候補を聞き手へ返します。
曖昧な発言
↓
確認アドバイス
↓
人が質問
↓
追加の回答
↓
整理内容を更新
この循環を支えることが、文書生成だけにとどまらない価値だと考えています。
3. 「セキュリティはちゃんと」を確認事項に変える
動作例として、社内の在庫管理アプリについて、次のような内容を話しました。
今はExcelで在庫を管理していて、更新漏れや変更履歴が分からないことに困っています。
倉庫の担当者が入出庫を記録でき、できればスマホでも登録したいです。
あと、セキュリティも大事なので、ちゃんと対策はお願いします。
この会話に対して、Reqlogueから得られたアドバイスの一例がこちらです。
曖昧さを確認
「セキュリティ」の具体化
対策の範囲により工数や構成が大きく変動するため、早期に詳細を確認すべき
ここで重要なのは、「セキュリティ対策が必要」と記録して終わっていないことです。
まだ具体化されていない論点として取り上げ、なぜ今確認すべきかを提示しています。
会議後には、会話内容をもとに要件定義書のドラフトを生成します。
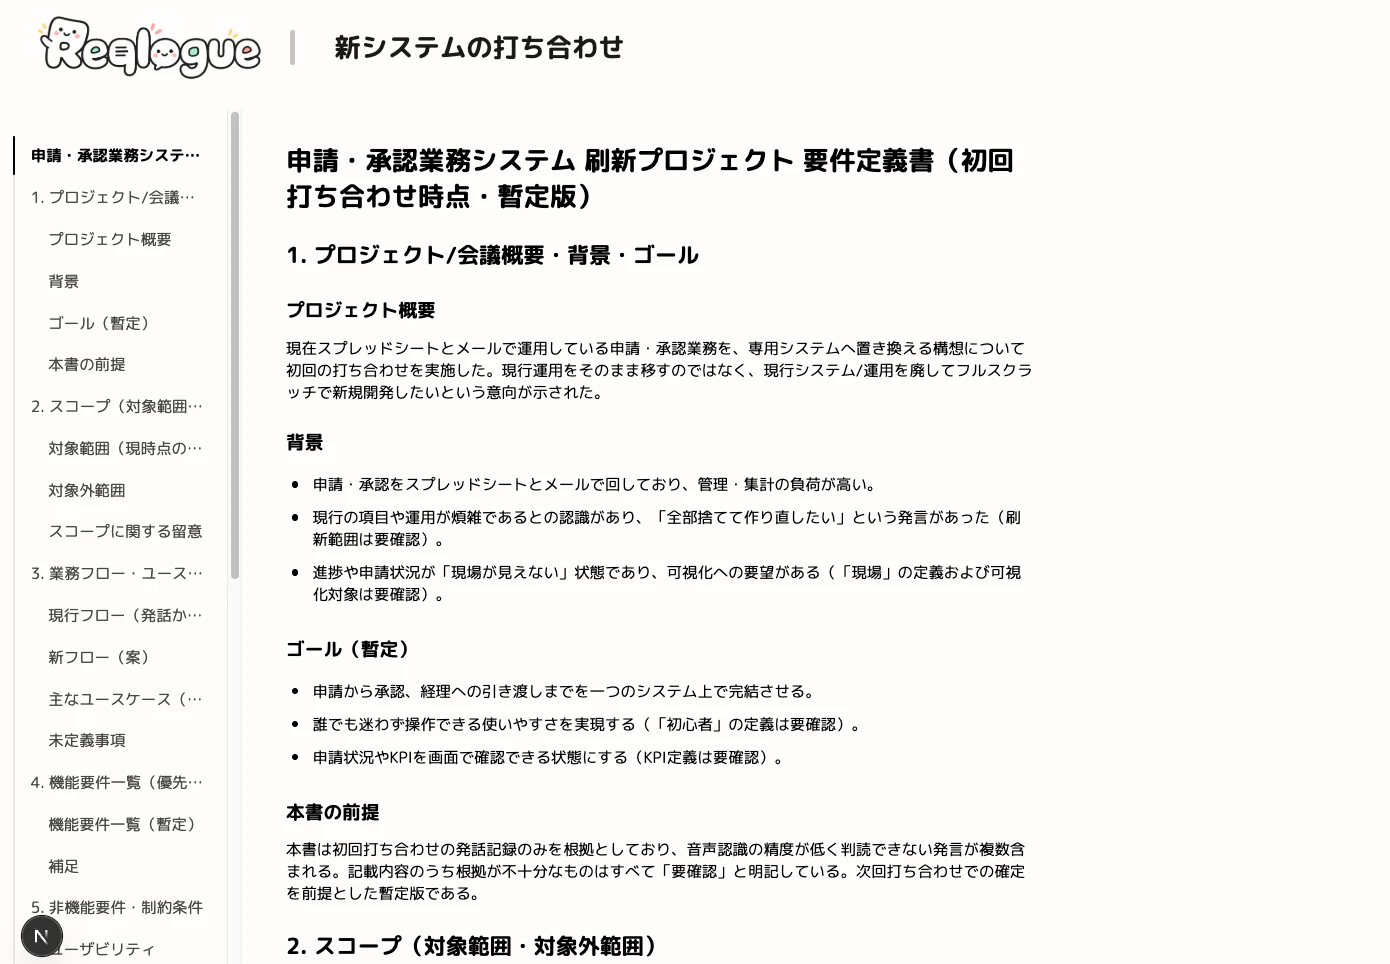
生成された要件定義書ドラフトの抜粋。承認済みの要件書ではなく、人が確認・編集するための出力です。
アドバイスを表示して終わるのではなく、会議で話した内容を文書へつなげるところまでが、Reqlogueの支援範囲です。
ただし、生成された内容が顧客との合意を正しく表しているかは、人が確認する必要があります。
4. なぜAIを使うのか
用語辞書やチェックリストでも、要件定義を支援することはできます。
例えば、特定の専門用語を検出したり、確認項目を一覧表示したりする処理は、必ずしもLLMを必要としません。
一方、会議中に必要なのは、単語の有無だけではない判断です。
- この表現は、現在の会話では何が曖昧なのか
- 既に説明された内容なのか、まだ確認が必要なのか
- 今の話題で、優先して聞くべきことは何か
- 新しい発言は、既存の整理内容への追加なのか、修正なのか
自由な話し言葉を文脈の中で解釈し、確認論点や整理内容へ変換する部分にLLMを使っています。
| 処理 | AIを使う理由 |
|---|---|
| 音声認識(文字起こし) | 発言を、後続の分析・整理が扱えるテキストへ変換するため |
| 曖昧・不足・矛盾などの検出 | 発言の意味と周辺の文脈を合わせて解釈するため |
| 確認アドバイスの生成 | 会話の状況に合った確認内容と理由を提示するため |
| マインドマップの更新案生成 | 新しい発言を既存の情報と関連づけるため |
| 要件定義書ドラフトの生成 | 会話内容を要件の文書形式へ整理するため |
AIを使うこと自体が価値なのではありません。聞き手が会話を続けている間にも、確認候補を考え、整理を更新できることを価値にしたいと考えています。
5. 指摘は、多ければよいわけではない
会議中に支援するなら、指摘の量にも気を配る必要があります。
AIが大量の確認事項を表示すると、利用者は会話ではなく、画面を読むことに追われかねません。そこで、Reqlogueでは分析対象と通知件数に制約を設けています。
直近12発話を中心に分析する
ここでいう「発話」とは、会議中に1人が1回話したひとまとまりのテキストを指します。
アドバイス生成では、直近12発話(直近12回分の発言) をLLMへ渡します。
加えて、過去に通知したテーマを最大10件渡し、同じ論点の繰り返しを抑制します。
毎回無条件に分析するのではなく、アプリ側で以下のような条件を扱います。
- 発話が存在するか
- 直近12発話に一定以上の意味のあるテキストがあるか
- 過去に通知した論点を考慮し、重複した指摘を抑制する
AIが検出する対象は、次のようなものです。
| 検出対象 | 見つけたい問題 |
|---|---|
| 曖昧 | 解釈に幅がある表現 |
| 矛盾 | 発言同士の整合性に疑問がある箇所 |
| 実現困難・高リスク | 実現条件やリスクの確認が必要な内容 |
| 要件漏れ・未確認 | 具体化や追加確認が必要な項目 |
| 専門用語・共通認識の罠 | 同じ言葉でも理解が一致していない可能性 |
さらに、合意済みの事項や、すでに通知した論点は原則として再通知せず、本質的な進展がある場合のみ再度通知するようにしています。この重複判定は、生成AIによる意味的な判断だけでなく、アドバイスボード側でも既存カードのタイトルと突き合わせるチェックを行っており、同じ論点のカードが増殖しないようにしています。
候補が複数ある場合は、要件への影響度・手戻りリスク・緊急性を考慮し、 「今、この場でPMが確認すべきもの」を最大2件 に絞って返します。
なお、ここでの「通知済み」の判定はAI側の抑制であり、アドバイスボード上で聞き手が「解決済み」へ移動したかどうかとは独立しています。会話の中でAIが再度言及を控えるかどうかと、聞き手が対応状況をどう管理するかは、別のレイヤーの話として扱っています。
6. マインドマップを会話に合わせて更新する
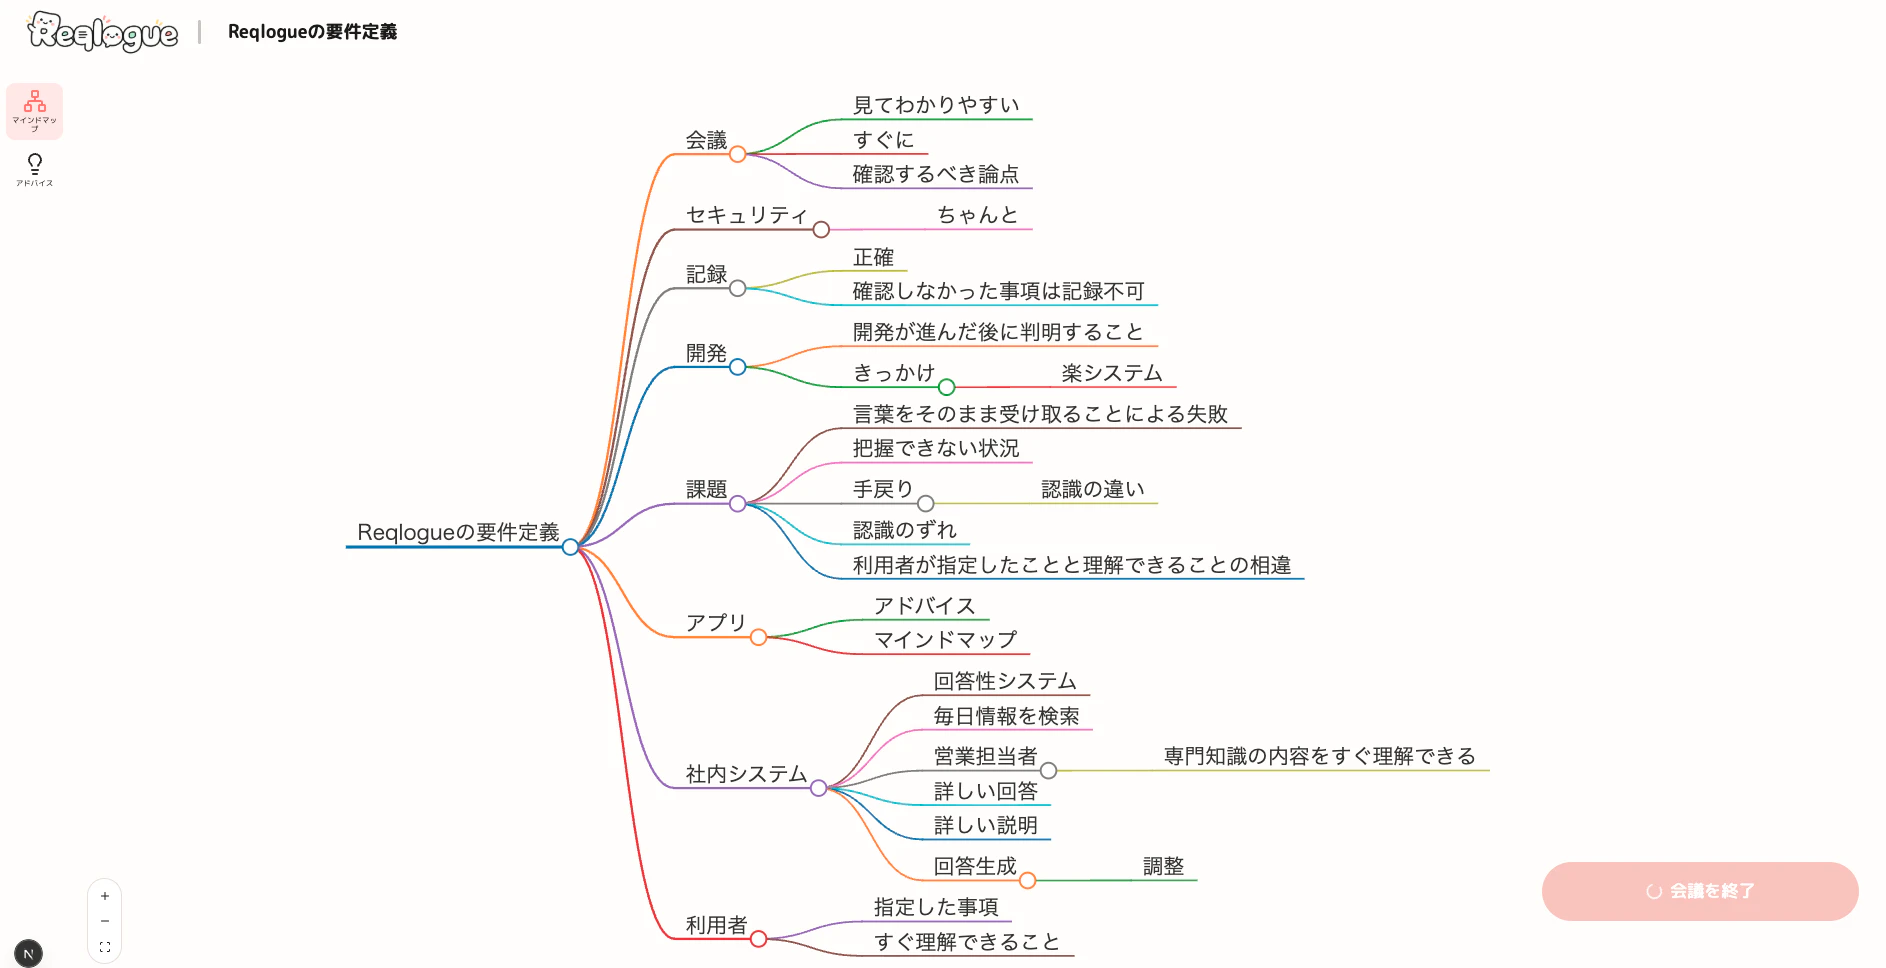
発言を受け取って更新されるマインドマップ。
ここでAIが判断しているのは、単に発言を短く要約することだけではありません。現在の整理内容に対して、どの情報を追加し、どこを修正・関連づけるかを判断しています。
マインドマップは、毎回ゼロから作り直す方式ではありません。
現在のマインドマップに対して、AIが変更案を返す方式にしています。
更新時に渡す情報
- 現在のマインドマップ
- 保留中の断片
- 直前の発話
- 現在の話題に関連する過去の発話
- 今回の発話ウィンドウ
これらをもとに、AIが追加・修正・関連づけなどを判断します。
| 操作 | 内容 |
|---|---|
add |
情報を追加する |
annotate |
注釈を加える |
correct |
既存の情報を修正する |
relate |
情報同士を関連づける |
set_status |
状態を更新する |
返された差分は、アプリケーション側で既存マップへ適用します。
この方式により、AIへ毎回全体の書き直しを任せるのではなく、会話の進展を既存の整理内容へ積み重ねる構成にしています。
各更新には、根拠となった発話IDも紐付けています。これにより、どの発話をもとに、どの情報がマインドマップへ反映されたのかを追跡できる構成にしています。
会話の内容をその場で整理し、前の整理結果を引き継ぎながら更新していくことで、マインドマップ自体を会話の進行に合わせて成長させていくことを目指しています。
7. AIが判断する部分と、アプリが制御する部分
Reqlogueは、LLMが自由にToolを選び、実行する完全自律型Agentではありません。
アドバイス生成とマインドマップ生成では、chat_completion とStructured Outputを使い、構造化された結果をアプリケーションが受け取って処理します。
一方で、利用者が発話のたびに「分析して」と指示する必要はありません。会話の進行に応じて処理が起動し、何を確認すべきか、何をどう整理するかはAIが判断します。
判断と制御の役割分担
| AIが自律的に判断する部分 | アプリケーションが制御する部分 |
|---|---|
| 会話の意味をどう解釈するか | 分析を起動するタイミング |
| 今確認すべき論点は何か | LLMへ渡す発話・履歴の範囲 |
| アドバイスの優先度と確認内容 | 通知件数の上限 |
| どのノードを追加・修正するか | Structured Outputの形式 |
| どの情報を関連づけるか | 出力の検証と差分の適用 |
アドバイスの出力はJSON Schemaで固定し、アプリ側でも以下を実施しています。
- JSONのパース
- カテゴリ・優先度の検証
- ID生成
- 優先度順のソート
- 最大2件への制限
- 既存カードとのタイトル比較による重複除外
AIへ判断を任せる部分と、コードで制御する部分を分けています。
人が判断すること
- アドバイスを受けて、実際に質問するか
- 会話の流れを優先し、確認を後回しにするか
- アドバイスボード上で、対応状況を「対応中」「解決済み」に移す、または不要なカードを削除すること
- 生成された要件の解釈が正しいか
- 最終的に何を要件として確定するか
つまり、Reqlogueの自律性は、
アプリケーションが定めたガードレールの中で、AIが会議中は会話の解釈・確認論点・マップ更新内容を、会議後は要件定義書ドラフトの生成を自律的に判断するHuman-in-the-loop型の構成
にあります。
「AIがすべてを勝手に実行すること」ではなく、人の逐一の指示を待たずに判断を進めながら、業務上の意思決定は人に残すことを重視しています。
AIが確認すべき論点を自律的に見つけても、実際に質問するかどうかは人が判断します。さらに、生成された要件の解釈や最終的な要件の確定も人が行います。
このように、AIが「考えて提示する」、人が「判断して決める」という役割分担によって、AIの自律性と人による意思決定を両立しています。
8. OrcaRouterで処理ごとの品質・コスト・セキュリティを考える
Reqlogueには、会議中に繰り返す処理と、会議後に成果物を作る処理があります。
すべてを同じモデル方針で実行するのではなく、OrcaRouterのNamed Routerを使い、処理ごとに品質・コスト・セキュリティを考慮したルーティングを行っています。
| 対象処理 | 設定 | 方針 |
|---|---|---|
| 音声認識 | 音声認識対応モデルを指定 | 固定でモデルを指定 |
| 確認事項の抽出・整理・マインドマップ | orcarouter/meeting-support-lite |
Balanced、無料モデルを優先 |
| 要件定義書の生成 | orcarouter/requirements-quality |
品質を優先 |
| 要件定義書生成の障害対応 | 専用フォールバック設定 | 別モデルへ切り替え |
会議中の処理と、最終成果物では条件が違う
会議中の分析は繰り返し実行するため、コストと応答性を重視します。
一方、要件定義書は最終成果物となるため、生成品質を優先します。
また、抽出・整理した情報は後続の要件定義の土台となるため、会議中の処理についても一定の品質を確保する必要があります。
モデルだけでなく、呼び出し方も制御する
不要なLLM呼び出しを減らすため、意味のある発話のみを処理し、通知済みテーマの重複を抑え、アドバイス生成に利用する入力範囲も限定しています。
さらに、Named Routerによってモデルを直接固定せず、用途に応じたモデル選択とフォールバックをルーター側で管理しています。
これにより、モデル変更や障害時にもアプリケーション側の変更を最小限にしながら、品質・コスト・可用性・セキュリティを考慮したAI実行基盤として運用できる構成を目指しています。
現時点では、会議1回あたりのコストやモデルごとの品質差などの定量評価は今後の検証項目としています。
9. 会議データを扱うためのセキュリティ
要件定義の会議には、個人情報や顧客の業務情報が含まれる可能性があります。
そこで、現時点では以下の対策を組み込んでいます。
| 対策内容 | 内容 |
|---|---|
| PIIマスキング | 入出力に含まれるメール・電話番号・IPアドレスなどを、OrcaRouterのガードレールで置換する |
| 外部通信制御 | OrcaRouterのファイアウォールで、クラウドメタデータエンドポイントやプライベートIP帯へのアクセスをブロックする設定 |
| APIキー管理 | キーをコードへ直接書かず環境変数から読み込み、フロントエンドへ露出させない |
ただし、これだけで会議データの保護が完了するわけではありません。
Prompt Injection対策は、今後の課題
会話に混じった文章を、AIへの命令として扱ってしまうリスクもあります。
今後は、Prompt Injectionに特化した検知・防御機構なども加え、会話データを扱うAIとして、複数の防御層を組み合わせたセキュリティ設計へ発展させていきます。
10. AIの出力を、そのまま正解にしない
形式の問題はアプリ側でも検証し、最終判断は人間が行う
アドバイス生成では、JSON Schemaに加え、アプリ側でもカテゴリや優先度、件数を検証しています。
さらに、AIが検出・生成したアドバイスをそのまま確定事項とせず、表示されたアドバイスを人間が確認し、必要なものだけを採用するHuman in the Loop設計としています。
AIが会話の監視・問題検出・アドバイス生成を担い、人間が最終的な確認・判断を行うことで、AIの自律性と人間による品質担保を両立しています。
フォールバックと復旧を考慮した設計
要件定義書生成では、品質を優先するPrimaryモデルに加えて、障害時に別モデルへ切り替えるFallbackを設定しています。
また、AIの応答をそのまま後続処理へ渡すのではなく、パース・形式検証を行ったうえで処理を進める構成としています。
AI処理は複数ステップに分かれるため、今後はTimeoutや通信断、長文入力などの異常系についても検証を進め、どの状態まで処理結果を保持し、どこから再実行できるかを整理していきます。
11. 現在できること/今後の展望
現在できること
ローカルで動作するMVPとして、以下を実装しています。
- 会議音声の文字起こし
- 曖昧・不足・矛盾の検出と確認アドバイス生成
- 通知件数の制限・重複抑制
- アドバイスボードによる対応状況の管理(アドバイス/対応中/解決済み、ドラッグ&ドロップ)
- マインドマップの差分更新・根拠発話IDの紐付け
- 会議内容からの要件定義書ドラフト生成
- 処理内容に応じたモデルルーティング
今後の展望
会議前の質問生成や過去の要件定義・社内ナレッジを活用したRAG、Azure等へのデプロイを進め、会議前の準備から要件定義、さらに設計・開発・テストまでAIによる支援範囲を広げていきます。
12. まとめ
Reqlogueの出発点は、開発後半に「そこを先に確認しておけば」と気づいた経験でした。
会話を記録するだけでは、聞いていない情報は埋まりません。だからこそ、相手に質問できる会議中に、確認すべき論点を返す仕組みを作りました。
その際に重視したのは、AIへすべてを任せることではありません。
- AIは、会話の解釈・確認論点・優先度・マップ更新内容を判断する
- アプリケーションは、分析条件・入力範囲・出力形式・件数・差分適用を制御する
- 人は、実際に質問するか、何を最終的な要件とするかを判断する
アドバイスを最大2件に絞り、同じ指摘を繰り返さないようにし、マインドマップを少しずつ更新する。こうした工夫も、人が会話を続けられるようにするためのものです。
要件定義をAIに代行させるのではなく、人が会話に集中できるように、AIが確認と整理を自律的に支援する。
Reqlogueを、そのための「会議のちいさな相棒」として育てていきたいと考えています。
参考・関連リンク
- OrcaRouter:https://www.orcarouter.ai/ja
- AI HACK:https://aihackathon.jp/