
概要
本プログラムでは、無限期間の動学的最適化問題を価値反復法(強化学習アルゴリズムの1つ)によって解きます。価値反復法は初期の価値関数を設定し、ベルマン方程式(例えば以下のような)
\begin{aligned}
V(w)
&=
\max_{c\ge0,\;s\ge0}
\{u(c)+\beta V(w')\}\\
\text{s.t.}\quad
&c=w-s\\
&w'=10+s
\end{aligned}
を繰り返し計算することで価値関数を逐次更新し、その収束先を最適価値関数として求める手法です($c$: 消費、$s$: 貯蓄、$w$: 今期資産、$w'$: 次期資産、$\beta$: 割引因子、$V()$: 価値関数)。本モデルでは効用関数として
$$
u(c)=c^{0.3}
$$
を採用し、各資産水準における最適な消費と貯蓄を探索します。価値関数の更新誤差が十分小さくなった時点で反復を終了し、そのときの消費関数、貯蓄関数、および価値関数を政策関数とします。
- 無限期間の動学的最適化問題
- 個人が無限に生存すると仮定し、その期間中の満足度を最大化するために、毎期どのように経済行動するかを解く問題
- ベルマン方程式
- 現在の消費と将来の消費のどちらをどれだけ重視するか(本モデルでの経済学的解釈)
- 政策関数(ここでは政府の政策ではなく経済主体の意思決定ルールのこと)
- 消費関数: 現在の資産が$w$であるならば、生涯効用を最大化するために現在どれだけ消費すべきか導く
- 貯蓄関数: 現在の資産が$w$であるならば、生涯効用を最大化するために現在どれだけ貯蓄すべきか導く
- 価値関数: 現在の資産が$w$のときに、現在から将来にわたって得られる生涯効用の最大値を導く
コード
  1  # coding: UTF-8
  2
  3  from datetime import datetime
  4  import matplotlib.pyplot as plt
  5
  6  # 効用関数
  7  def u(c):
  8      return c**0.3
  9
 10  ns = 100
 11  step = 30.0 / (ns - 1)
 12  b = 0.99
 13
 14  # 状態変数・価値関数・政策関数の初期化
 15  w = []
 16  v0 = []
 17  v1 = []
 18  c1 = []
 19  s1 = []
 20
 21  i = 0
 22  while i < ns:
 23      w.append(i * step)
 24      v0.append(0)
 25      v1.append(0)
 26      c1.append(0)
 27      s1.append(0)
 28      i += 1
 29
 30  # 収束判定用パラメータ
 31  vbar = u(w[ns - 1]) / (1 - b)
 32  epsilon = vbar / 100000
 33  distance = vbar
 34  count = 0
 35
 36  start = datetime.now()
 37  print("start", start)
 38
 39  # 価値反復
 40  while distance > epsilon:
 41
 42      # 前回の価値関数を保存
 43      i = 0
 44      while i < ns:
 45          v0[i] = v1[i]
 46          i += 1
 47
 48      i = 0
 49      while i < ns:
 50
 51          vstar = 0
 52          cstar = 0
 53          sstar = 0
 54
 55          j = 0
 56          while j < ns:
 57
 58              s = w[j] - 10
 59
 60              c = w[i] - s
 61
 62              if c >= 0 and s >= 0:
 63                  v = u(c) + b * v0[j]
 64
 65                  if v > vstar:
 66                      vstar = v
 67                      cstar = c
 68                      sstar = s
 69
 70              j += 1
 71
 72          v1[i] = vstar
 73          c1[i] = cstar
 74          s1[i] = sstar
 75
 76          i += 1
 77
 78      # 収束誤差
 79      distance = 0
 80      i = 0
 81
 82      while i < ns:
 83          if abs(v1[i] - v0[i]) > distance:
 84              distance = abs(v1[i] - v0[i])
 85          i += 1
 86
 87      count += 1
 88
 89  end = datetime.now()
 90
 91  print("ループエンド")
 92  print("time", end - start)
 93  print("beta =", b)
 94  print("count =", count)
 95  print("epsilon =", epsilon)
 96
 97  print("Value")
 98  i = 0
 99  while i < ns:
100      print(w[i], "\t", v1[i])
101      i += 1
102
103  print("\nConsumption")
104  i = 0
105  while i < ns:
106      print(w[i], "\t", c1[i])
107      i += 1
108
109  print("\nSaving")
110  i = 0
111  while i < ns:
112      print(w[i], "\t", s1[i])
113      i += 1
114
115  plt.subplot(3, 1, 1)
116  plt.plot(w, c1)
117  plt.title("c1")
118
119  plt.subplot(3, 1, 2)
120  plt.plot(w, s1)
121  plt.title("s1")
122
123  plt.subplot(3, 1, 3)
124  plt.plot(w, v1)
125  plt.title("v1")
126
127  plt.tight_layout()
128  plt.show()
解説
必要なライブラリを読み込み、効用関数およびモデルの基本パラメータを設定します。
- datetime:計算時間を測定するために使用
- matplotlib:グラフを描画するために使用
- $u(c)=c^{0.3}$:効用関数
- ns=100:資産の離散化数
- step:資産グリッドの刻み幅
- $\beta$=0.99:割引因子
3  from datetime import datetime
4  import matplotlib.pyplot as plt
5
6  # 効用関数
7  def u(c):
8      return c**0.3
9
10  ns = 100
11  step = 30.0 / (ns - 1)
12  b = 0.99
各種配列を作成します。
- $w$:資産水準
- v0:前回の価値関数
- v1:更新後の価値関数
- c1:最適消費関数
- s1:最適貯蓄関数
その後の while ループで、資産以外は0初期化、資産は 0~30 の範囲で100分割して格納します。
14  # 状態変数・価値関数・政策関数の初期化
15  w = []
16  v0 = []
17  v1 = []
18  c1 = []
19  s1 = []
20
21  i = 0
22  while i < ns:
23      w.append(i * step)
24      v0.append(0)
25      v1.append(0)
26      c1.append(0)
27      s1.append(0)
28      i += 1
価値反復法の収束判定に必要な変数を設定します。
30  # 収束判定用パラメータ
31  vbar = u(w[ns - 1]) / (1 - b)
32  epsilon = vbar / 100000
33  distance = vbar
本プログラムで核となる価値反復法の実装です。
40  while distance > epsilon:
41
42      # 前回の価値関数を保存
43      i = 0
44      while i < ns:
45          v0[i] = v1[i]
46          i += 1
47
48      i = 0
49      while i < ns:
50
51          vstar = 0
52          cstar = 0
53          sstar = 0
54
55          j = 0
56          while j < ns:
57
58              s = w[j] - 10
59
60              c = w[i] - s
61
62              if c >= 0 and s >= 0:
63                  v = u(c) + b * v0[j]
64
65                  if v > vstar:
66                      vstar = v
67                      cstar = c
68                      sstar = s
69
70              j += 1
71
72          v1[i] = vstar
73          c1[i] = cstar
74          s1[i] = sstar
75
76          i += 1
77
78      # 収束誤差
79      distance = 0
80      i = 0
81
82      while i < ns:
83          if abs(v1[i] - v0[i]) > distance:
84              distance = abs(v1[i] - v0[i])
85          i += 1
86
87      count += 1
価値関数が収束するまでベルマン方程式を繰り返し計算します。distanceには前回の価値関数と今回の価値関数の各資産量ごとの差で最も大きな値が入ります。この最大誤差が微小値epsilonよりも小さければ全ての資産量に対する価値関数の誤差は微小値以下であり収束と判断します。
40  while distance > epsilon:

82      while i < ns:
83          if abs(v1[i] - v0[i]) > distance:
84              distance = abs(v1[i] - v0[i])
85          i += 1
前回計算した価値関数を保存します。価値反復法では$V_{n+1}$を求める際に$V_{n}$を利用するため、この処理が必要です。
42      # 前回の価値関数を保存
43      i = 0
44      while i < ns:
45          v0[i] = v1[i]
46          i += 1
各資産水準における最適な消費量と貯蓄量を探索します。まず、各資産水準 $w_i$ に対して、価値関数の最大値を格納する変数 vstar、対応する消費量を格納する変数 cstar、および貯蓄量を格納する変数 sstar を初期化します。続いて、取り得るすべての次期資産水準について総当たりで探索を行います。各候補に対して貯蓄額 $s$ と消費額 $c$ を計算し、消費と貯蓄がともに非負である場合のみ実行可能な選択肢として評価します。実行可能な選択肢については、
$$
v = u(c) + \beta V(w')
$$
を計算し、現在の消費から得られる効用と将来の価値関数の割引現在価値の合計を求めます。さらに、その値が現在までの最大値を上回る場合には、価値関数、消費量、貯蓄量を更新します。すべての候補について評価が終了した後、最大価値 vstar を価値関数 v1[i] に、対応する最適消費量 cstar を消費関数 c1[i] に、最適貯蓄量 sstar を貯蓄関数 s1[i] に保存します。この処理によって、各資産水準における最適な消費・貯蓄行動(政策関数)が求められます。
48      i = 0
49      while i < ns:
50
51          vstar = 0
52          cstar = 0
53          sstar = 0
54
55          j = 0
56          while j < ns:
57
58              s = w[j] - 10
59
60              c = w[i] - s
61
62              if c >= 0 and s >= 0:
63                  v = u(c) + b * v0[j]
64
65                  if v > vstar:
66                      vstar = v
67                      cstar = c
68                      sstar = s
69
70              j += 1
71
72          v1[i] = vstar
73          c1[i] = cstar
74          s1[i] = sstar
75
76          i += 1
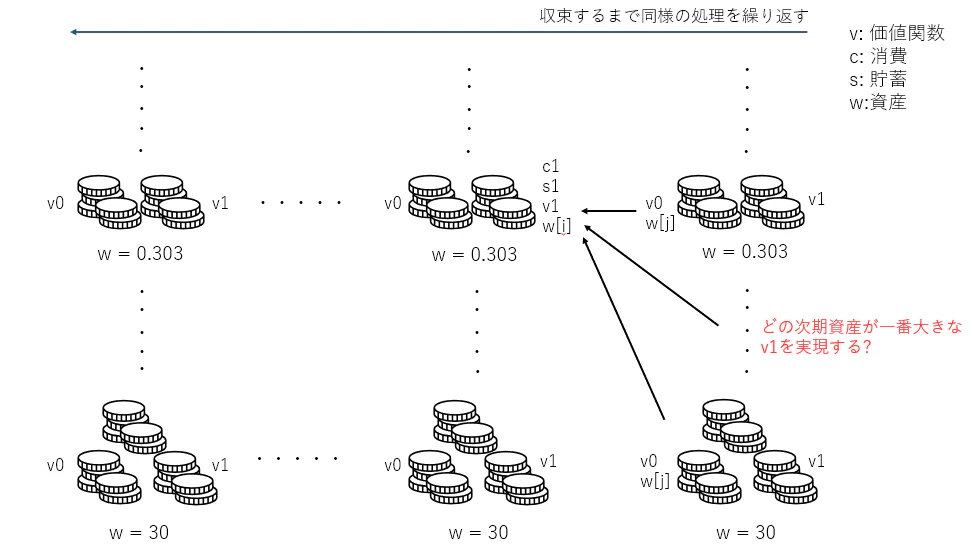
図1: プログラムのイメージ
収束判定に利用する distance には前回の価値関数と今回の価値関数の各資産量ごとの差で最も大きな値が入ります。その後、count を1つ増やしループ先頭へと戻ります。
78      # 収束誤差
79      distance = 0
80      i = 0
81
82      while i < ns:
83          if abs(v1[i] - v0[i]) > distance:
84              distance = abs(v1[i] - v0[i])
85          i += 1
86
87      count += 1
価値関数が収束した後には各種情報・関数を出力します。
- 計算時間
- 反復回数
- 許容誤差
- 価値関数(画面出力、グラフ出力)
- 最適消費(画面出力、グラフ出力)
- 最適貯蓄(画面出力、グラフ出力)
 91  print("ループエンド")
 92  print("time", end - start)
 93  print("beta =", b)
 94  print("count =", count)
 95  print("epsilon =", epsilon)
 96
 97  print("Value")
 98  i = 0
 99  while i < ns:
100      print(w[i], "\t", v1[i])
101      i += 1
102
103  print("\nConsumption")
104  i = 0
105  while i < ns:
106      print(w[i], "\t", c1[i])
107      i += 1
108
109  print("\nSaving")
110  i = 0
111  while i < ns:
112      print(w[i], "\t", s1[i])
113      i += 1
114
115  plt.subplot(3, 1, 1)
116  plt.plot(w, c1)
117  plt.title("c1")
118
119  plt.subplot(3, 1, 2)
120  plt.plot(w, s1)
121  plt.title("s1")
122
123  plt.subplot(3, 1, 3)
124  plt.plot(w, v1)
125  plt.title("v1")
126
127  plt.tight_layout()
128  plt.show()
行番号なし版
# coding: UTF-8

from datetime import datetime
import matplotlib.pyplot as plt

# 効用関数
def u(c):
    return c**0.3

ns = 100
step = 30.0 / (ns - 1)
b = 0.99

# 状態変数・価値関数・政策関数の初期化
w = []
v0 = []
v1 = []
c1 = []
s1 = []

i = 0
while i < ns:
    w.append(i * step)
    v0.append(0)
    v1.append(0)
    c1.append(0)
    s1.append(0)
    i += 1

# 収束判定用パラメータ
vbar = u(w[ns - 1]) / (1 - b)
epsilon = vbar / 100000
distance = vbar
count = 0

start = datetime.now()
print("start", start)

# 価値反復
while distance > epsilon:

    # 前回の価値関数を保存
    i = 0
    while i < ns:
        v0[i] = v1[i]
        i += 1

    i = 0
    while i < ns:

        vstar = 0
        cstar = 0
        sstar = 0

        j = 0
        while j < ns:

            s = w[j] - 10

            c = w[i] - s

            if c >= 0 and s >= 0:
                v = u(c) + b * v0[j]

                if v > vstar:
                    vstar = v
                    cstar = c
                    sstar = s

            j += 1

        v1[i] = vstar
        c1[i] = cstar
        s1[i] = sstar

        i += 1

    # 収束誤差
    distance = 0
    i = 0

    while i < ns:
        if abs(v1[i] - v0[i]) > distance:
            distance = abs(v1[i] - v0[i])
        i += 1

    count += 1

end = datetime.now()

print("ループエンド")
print("time", end - start)
print("beta =", b)
print("count =", count)
print("epsilon =", epsilon)

print("Value")
i = 0
while i < ns:
    print(w[i], "\t", v1[i])
    i += 1

print("\nConsumption")
i = 0
while i < ns:
    print(w[i], "\t", c1[i])
    i += 1

print("\nSaving")
i = 0
while i < ns:
    print(w[i], "\t", s1[i])
    i += 1

plt.subplot(3, 1, 1)
plt.plot(w, c1)
plt.title("c1")

plt.subplot(3, 1, 2)
plt.plot(w, s1)
plt.title("s1")

plt.subplot(3, 1, 3)
plt.plot(w, v1)
plt.title("v1")

plt.tight_layout()
plt.show()
結果
プログラム実行により得られる消費関数、貯蓄関数、価値関数を掲載します。
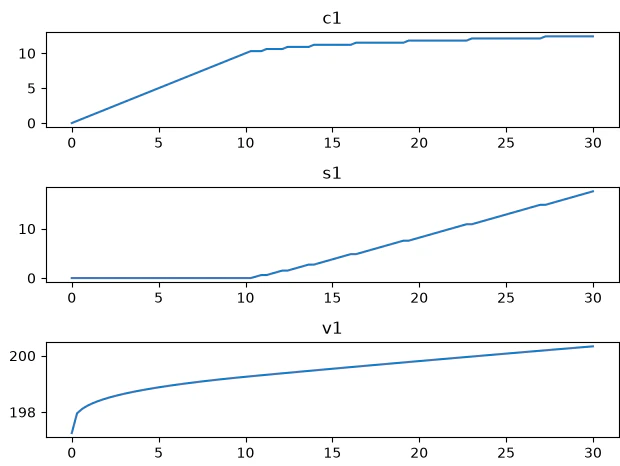
図2: 消費関数、貯蓄関数、価値関数(横軸: 資産量)
考察
図2より、資産が少ないうちは保有資産の大部分を消費に充てる一方、資産が一定水準を超えると消費をほぼ一定に保ちながら追加資産の多くを貯蓄へ回し、限界効用逓減のもとで将来の効用を考慮した最適な資産蓄積行動をとっています。資産が少ない個人は消費を重視し、資産が多い個人は貯蓄にも精を出すとの具合です。さて、現実がうまく描写されているでしょうか。そうなれば、このモデルによる分析は政策判断などで使用可能です。
- 限界効用
- 今いる消費位置から追加で消費を一単位増やした時、効用が何単位増えるか
- 限界効用逓減
- 今いる消費位置が増えるにつれて限界効用が低下(その種の消費に飽きる現象を描画可能)
おまけ1: なぜ価値関数反復法で収束した関数を真の価値関数とみなせるのか
価値関数反復法では、ベルマン作用素(Bellman Operator)$T$ を繰り返し適用することで価値関数を更新します。
まず、ベルマン作用素 $T$ を次のように定義します。
$$ (TV)(w_i)=\max_{w_{j}}{u(c)+\beta V(w_j)} $$
ここで、
- $u(c)$ は現在の消費から得られる効用
- $\beta$ は割引因子
- $V(w_j)$ は次期の資産水準 $w_j$ における価値関数
です。
ベルマン作用素 $T$ は、
「ある価値関数 $V$ を入力として受け取り、その価値関数のもとで最適な行動を考えた新しい価値関数を出力する変換」
と解釈できます。
価値関数反復法では、初期値 $V_0$ を与え、
$$
V_{n+1}=TV_n
$$
によって価値関数を更新していきます。
すなわち、
$$
V_1=TV_0
$$
$$
V_2=TV_1
$$
$$
V_3=TV_2
$$
$$
\cdots
$$
という形で反復計算を行います。
いま、この反復計算によって価値関数列
$$
V_0,V_1,V_2,\cdots
$$
がある関数 $V$ に収束したとします。
$$
V_n \to V
$$
反復法の定義より
$$
V_{n+1}=TV_n
$$
であるため、両辺の極限をとると
$$
V=TV
$$
が得られます。
これは収束した関数 $V$ がベルマン方程式を満たしていることを意味します。
さらに、割引因子が
$$
0<\beta<1
$$
であるとき、ベルマン作用素 $T$ は縮小写像(Contraction Mapping)となります。つまり任意の価値関数 $V$ と $W$ に対して、
$$
|TV-TW|
\le
\beta|V-W|
$$
が成立します。
これは、ベルマン作用素を適用するたびに価値関数同士の距離が $\beta$ 倍以下に縮小することを意味してます。
縮小写像に対してはバナッハの不動点定理が適用できるため、
$$
V=TV
$$
を満たす固定点はただ一つしか存在しません。
したがって、価値関数反復法によって得られた収束先の関数 $V$ は、ベルマン方程式を満たす唯一の固定点であり、真の価値関数
$$
V^*
$$
と一致します。
おまけ2: 毎期の消費はどうなる
価値反復法により最適貯蓄政策関数 $s^*(w)$ を求めた後は、これを用いて状態変数 $w_t$ の推移を前向きにシミュレーションします。初期値 $w_0$ を与えると、各期において
s_t = s^*(w_t)
が決まり、予算制約より最適消費は
c_t = w_t - s_t
となります。また次期の状態変数は
w_{t+1} = 10 + s_t
によって与えられます。したがって,最適政策の下での状態遷移は
w_t
\;\rightarrow\;
s_t = s^*(w_t)
\;\rightarrow\;
c_t = w_t - s_t
\;\rightarrow\;
w_{t+1} = 10 + s_t
となります。この操作を繰り返すことで
\{w_t\}_{t=0}^{T},
\qquad
\{s_t\}_{t=0}^{T},
\qquad
\{c_t\}_{t=0}^{T}
最適経路(シミュレーションパス)が得られます。
※ 本モデルは定常な無限期間問題であり、効用関数、割引因子、および状態遷移式が時間を通じて変化しないため、最適政策関数$s^*(w)$も時間不変です。