
はじめに
機械学習では、こんなコードを何気なく書きます。
import torch
import torch.nn as nn

layer = nn.Linear(784, 256)
たった1行です。
しかしハードウェアの視点から見ると、この1行はかなり面白いものです。
同じ nn.Linear(784, 256) でも、
- CPU
- GPU
- FPGA
- ASIC
では、実際の実装が大きく異なります。
では、
PyTorchで書いた1層のLinearは、最終的にハードウェアの中で何になるのか?
を追ってみます。
1. nn.Linear(784, 256) は何をしているのか
PyTorchのLinear層は、数学的には
$$
\mathbf{y} =
\mathbf{x}W^T+\mathbf{b}
$$
を計算しています。
今回、
nn.Linear(784, 256)
なので、
$$
W\in\mathbb{R}^{256\times784}
$$
です。
つまり重みの数は、
$$
256\times784=200704\text{ 個}
$$
さらにbiasが256個あります。
したがって、このたった1層だけでも
$200704+256=200960$個のパラメータを持っています。
FP32なら1つ4 byteなので、
$$
200960\times4=803840\ {\rm byte}
$$
約785 KiBです。
2. Pythonから見るとただの行列
まずPython側では非常に単純です。
x = torch.randn(1, 784)

layer = nn.Linear(784, 256)

y = layer(x)
入力は、
x.shape = [1, 784]
重みは、
weight.shape = [256, 784]
出力は、
y.shape = [1, 256]
となります。
内部で行っているのは本質的に、
y = x @ weight.T + bias
です。
つまり、$
784
$個の入力と重みを掛けて足す処理を、256個の出力ニューロンについて行います。
1つの出力について、
$$
y_i=\sum_{j=0}^{783}w_{ij}x_j+b_i
$$
です。
したがって必要な乗算回数は、
$$
784\times256=200704
$$
回です。
加算もほぼ同程度必要になります。
この、
$$
\boxed{\text{Multiply + Accumulate}}
$$
すなわちMAC演算こそが、ニューラルネットワーク向けハードウェアの中心です。
3. CPUではどうなるか
まずCPUで実行してみます。
device = "cpu"

layer = nn.Linear(784, 256).to(device)
x = torch.randn(1, 784, device=device)

y = layer(x)
PyTorchから見るとこれだけですが、CPU内部ではもっと複雑です。
ざっくり書くと、
PyTorch
   ↓
Linear
   ↓
Matrix multiplication
   ↓
CPU kernel / BLAS
   ↓
SIMD命令
   ↓
FMA
という流れです。
重みは最初、メインメモリ上に存在します。
DRAM

w00
w01
w02
...
w255,783
計算するときは、
DRAM
 ↓
L3 Cache
 ↓
L2 Cache
 ↓
L1 Cache
 ↓
Register
 ↓
SIMD / FMA
と運ばれます。
例えば概念的には、
x0 × w0
x1 × w1
x2 × w2
x3 × w3
      ↓
   accumulate
です。
CPUではLinear専用回路が存在するわけではない
ここが重要です。
CPUは基本的には、
「これはニューラルネットワークのLinear層だ」
とは考えていません。
単に、
大きな行列積を計算している
だけです。
例えばAVX系SIMDなら、複数の値を一度にレジスタへ読み込み、
Register A

x0 x1 x2 x3 x4 x5 x6 x7

Register B

w0 w1 w2 w3 w4 w5 w6 w7
として、
x0*w0
x1*w1
...
x7*w7
を並列計算します。
さらにFMA、
$$
a\times b+c
$$
を使って、
acc = acc + x * w
を高速に実行します。
つまりCPUでは、
$$
\boxed{
\text{Linear}
\rightarrow
\text{行列積}
\rightarrow
\text{SIMD命令列}
}
$$
となります。
4. GPUに持っていく
次はGPUです。
コード上では、
device = "cuda"

layer = nn.Linear(784, 256).to(device)
x = torch.randn(1, 784, device=device)

y = layer(x)
程度の変更しかありません。
しかし、ハードウェア内部では状況が大きく変わります。
CPUでは少数の高性能コアで演算していました。
GPUでは、
$$
\boxed{\text{大量の演算器を並列に動かす}}
$$
方向になります。
5. GPUの中では重みはHBM/GDDRへ行く
重み行列
$$
W_{256\times784}
$$
はGPUメモリへ転送されます。
CPU DRAM

weight
  │
  │ PCIe / Unified memory etc.
  ↓

GPU HBM / GDDR

weight
そこから、
HBM
 ↓
L2 Cache
 ↓
Shared Memory / Cache
 ↓
Register
 ↓
CUDA Core / Tensor Core
とデータが移動します。
6. GPUではLinearが行列積として処理される
バッチサイズを $(B) $とすると、
$$
X\in\mathbb{R}^{B\times784}
$$
なので、
$$
Y
=XW^T
$$
は、
$$
(B\times784)\times(784\times256)
$$
という行列積です。
例えば、
x.shape
が
[1024, 784]
なら、$
1024\times784
$と$
784\times256
$の行列積になります。
ここまで大きくなるとGPUの得意分野です。
7. Tensor Coreではさらに小さな行列単位で計算する
GPUには通常の演算器に加えて、行列積に特化したTensor Coreがあります。
概念的には、
$$
D=A\times B+C
$$
のような演算を、小さな行列ブロック単位で実行します。
例えば巨大な
$$
1024\times784
$$
と
$$
784\times256
$$
の行列を、
┌───┬───┬───┐
│ A │ A │ A │
├───┼───┼───┤
│ A │ A │ A │
└───┴───┴───┘
のような小さいタイルへ分割します。
重み側も同様です。
┌───┬───┐
│ W │ W │
├───┼───┤
│ W │ W │
├───┼───┤
│ W │ W │
└───┴───┘
そして各タイルについて高速に行列積を実行します。
つまりGPUでは、
$$
\boxed{
\text{Linear}
\rightarrow
\text{GEMM}
\rightarrow
\text{Tile}
\rightarrow
\text{Tensor Core}
}
$$
となります。
8. CPUとGPUの最大の違いは?
ここまでなら、
GPUはCPUをたくさん並べただけでは?
と思うかもしれません。
大きな違いの一つは、
$$
\boxed{\text{並列度}}
$$
です。
CPUは、
少数の高性能コア
GPUは、
大量の比較的小さい演算器
を持っています。
Linearのような演算は、
$$
y_i
=\sum_j w_{ij}x_j
$$
という同じ計算を大量に繰り返すため、GPUとの相性が非常に良いわけです。
9. ではFPGAに持っていくとどうなるか
ここから少し世界が変わります。
CPUやGPUでは、
nn.Linear(...)
を実行するために既存のプロセッサを使いました。
FPGAでは、
Linearを計算する回路そのものを作る
ことができます。
例えば、
Input Buffer
     ↓
Multiplier
     ↓
Adder
     ↓
Accumulator
     ↓
Output
という回路です。
10. FPGAでは重みをBRAMに入れられる
重みは例えばBRAMへ格納できます。
今回なら、200704個のweightがあります。
INT8へ量子化すれば、
$$
200704\times8
=1605632\ {\rm bit}
$$
です。
およそ、$
1.61\ {\rm Mbit}
$になります。
これをFPGA内部のBRAMやURAMへ配置できます。
イメージすると、
              FPGA

┌───────────────────────────┐
│                           │
│   ┌───────────────┐       │
│   │ Weight BRAM   │       │
│   │               │       │
│   │ w0            │       │
│   │ w1            │       │
│   │ w2            │       │
│   │ ...           │       │
│   └───────┬───────┘       │
│           ↓               │
│      ┌────────┐           │
│ x ──→│  DSP   │──→ Acc    │
│      └────────┘           │
│                           │
└───────────────────────────┘
となります。
11. FPGAのDSPブロックがMACになる
FPGAには乗算・加算向けのDSPブロックがあります。
概念的には、
$$
P=A\times B+C
$$
です。
つまり、
activation ─┐
            × ──┐
weight ─────┘   │
                + → output
accumulator ────┘
となります。
ニューラルネットワークの
$$
acc\leftarrow acc+xw
$$
そのものです。
12. 何個MACを並べるかを自分で決められる
FPGAで面白いのはここです。
例えばMACを1個だけ使えば、
MAC0

x0*w0
↓
x1*w1
↓
x2*w2
↓
...
と順番に200704回計算できます。
非常に省回路ですが遅いです。
逆に256個並べれば、
         x0,x1,...x783

           ↓

MAC ─────→ y0
MAC ─────→ y1
MAC ─────→ y2
...
MAC ─────→ y255
と256ニューロンを並列に計算できます。
さらに極端に言えば、200704 個の乗算器を作れば、全weightについて同時並列に計算することも理論上は可能です。
もちろん現実にはリソース不足になります。
したがってFPGA設計では、
$$
\boxed{
\text{速度}
\leftrightarrow
\text{回路面積}
}
$$
のトレードオフを設計者が決めることになります。
13. FPGAではループが「時間」から「空間」になる
ソフトウェアなら、
for i in range(256):
    for j in range(784):
        y[i] += x[j] * w[i][j]
と書きます。
CPUでは、このループを時間方向に高速実行します。
一方FPGAでは、この一部を回路として展開できます。
例えば、
x0 ─×w0──┐
x1 ─×w1──┤
x2 ─×w2──┼→ Adder Tree → y
x3 ─×w3──┤
...      │
のように、
forループをハードウェアの空間へ展開する
ことができます。
これはCPU/GPUとFPGAの大きな違いです。
14. Pipelineも自由に作れる
さらに、
Clock 1
Multiply

Clock 2
Add

Clock 3
Accumulate

Clock 4
Output
のようにパイプライン化できます。
一度パイプラインが満たされれば、
CLK1  data0
CLK2  data1
CLK3  data2
CLK4  data3
...
と毎クロック新しいデータを投入できます。
つまりFPGAでは、
$$
\boxed{
\text{ニューラルネットワークのデータフロー}=\text{回路のデータフロー}
}
$$
にかなり近づきます。
15. 重みそのものを回路へ埋め込むこともできる
さらに、推論専用でweightが変わらない場合を考えます。
例えば、$
w=37
$なら、$
37x
$を毎回乗算器で計算する必要はありません。
$$
37=32+4+1
$$
なので、
$$
37x
=(x<<5)+(x<<2)+x
$$
とできます。
つまり、
        ┌── <<5 ──┐
x ──────┼── <<2 ──┼→ ADD → y
        └─────────┘
です。
この場合、
weight = 37
というデータそのものがなくなっています。
37という情報は、
$$
\boxed{\text{回路構造}}
$$
になっています。
16. ASICではどうなるか
ASICではさらに専用化できます。
FPGAでは、
- LUT
- Programmable Switch
- DSP Block
- BRAM
など既に存在する回路を組み合わせました。
ASICでは、
必要な回路そのものを設計する
ことができます。
例えばLinear専用アクセラレータなら、
              ASIC

┌──────────────────────────────┐
│                              │
│     Weight SRAM              │
│   ┌─────────────┐            │
│   │ w w w w w   │            │
│   │ w w w w w   │            │
│   └──────┬──────┘            │
│          ↓                   │
│   ┌────────────────────┐     │
│   │ MAC MAC MAC MAC    │     │
│   │ MAC MAC MAC MAC    │     │
│   │ MAC MAC MAC MAC    │     │
│   └────────────────────┘     │
│              ↓               │
│        Accumulator           │
│              ↓               │
│         Output SRAM          │
│                              │
└──────────────────────────────┘
のようにできます。
17. ASICではWeight SRAMをMACの真横に置ける
ここはかなり重要です。
AIチップでは計算そのものだけでなく、
$$
\boxed{\text{データを運ぶこと}}
$$
に大きなコストがかかります。
CPUの場合、
DRAM
 ↓
Cache
 ↓
Register
 ↓
ALU
GPUでも、
HBM
 ↓
Cache
 ↓
Register
 ↓
Tensor Core
です。
ASICなら、
SRAM | MAC
という配置を最初から設計できます。
つまりweightを使う場所のすぐ近くに保存できます。
18. なぜ「重みを動かさない」が重要なのか
例えばMACを1000個並べたとします。
各MACが毎クロック8 bitのweightを必要とすると、
$$
1000\times8
=8000\ {\rm bit/cycle}
$$
必要です。
1 GHzなら、
$$
8\times10^{12}\ {\rm bit/s}
$$
つまり8 Tbit/sです。
MACを増やせば増やすほど、
どうやってweightを供給するのか?
が問題になります。
そこでASICでは、
SRAM
 ↓
MAC
 ↓
MAC
 ↓
MAC
のようにデータを再利用したり、
同じweightを複数回使ったりします。
19. Weight Stationaryという考え方
例えば、$
w
$をMAC内部に保持します。
       w
       ↓
    ┌─────┐
x → │ MAC │ → output
    └─────┘
そして入力だけを、
x0
x1
x2
x3
...
と流していきます。
これが、
Weight Stationary
というデータフローです。
weightを動かさないことで、$
\text{memory access}
$を減らします。
20. CPU→GPU→FPGA→ASICを並べてみる
ここまでを同じLinear層について整理すると面白いです。
PyTorchでは全部、
nn.Linear(784, 256)
です。
しかしCPUでは、
Linear
 ↓
Matrix Multiply
 ↓
SIMD Instructions
 ↓
ALU / FMA
GPUでは、
Linear
 ↓
GEMM
 ↓
Matrix Tile
 ↓
Tensor Core
FPGAでは、
Linear
 ↓
RTL / HLS
 ↓
BRAM + DSP
 ↓
Pipeline
ASICでは、
Linear
 ↓
Architecture
 ↓
SRAM + MAC Array
 ↓
Standard Cells / SRAM Macro
 ↓
Transistors
になります。
つまり、
PyTorch

nn.Linear(784,256)

       │
       ├──────── CPU
       │          ↓
       │        SIMD
       │
       ├──────── GPU
       │          ↓
       │      Tensor Core
       │
       ├──────── FPGA
       │          ↓
       │       DSP + BRAM
       │
       └──────── ASIC
                  ↓
              SRAM + MAC
                  ↓
             Transistors
です。
21. 同じ200704個のweightでも「存在の仕方」が違う
ここがこの記事で一番重要なところです。
数学的には、すべて同じ
$$
W\in\mathbb{R}^{256\times784}
$$
です。
しかしCPUでは、
DRAMやCacheに置かれたデータ
です。
GPUでは、
HBMからTensor Coreへ供給される行列データ
です。
FPGAでは、
BRAMのデータ、あるいは論理回路
になります。
ASICでは、
専用SRAMのbit、場合によっては固定された回路構造
になります。
つまり、
$$
\boxed{
\text{同じ数学的パラメータでも、
ハードウェアによって物理的な姿は全く違う}
}
$$
ということです。
22. さらに下へ行くと「weightとは何か?」が変わる
CPUでweightを見れば、
32-bit floating point data
です。
FPGAなら、
8-bit BRAM data
かもしれません。
ASICなら、
SRAM Cell
です。
さらにAnalog Compute-in-Memoryまで行けば、$
w
$をコンダクタンス$
G
$として持たせることさえできます。
つまり、
PyTorch
weight = Tensor

CPU
weight = memory data

GPU
weight = HBM data

FPGA
weight = BRAM / logic

ASIC
weight = SRAM / circuit

Analog CIM
weight = physical quantity
と、抽象度を下げるたびに「重み」の意味が変わっていきます。
まとめ
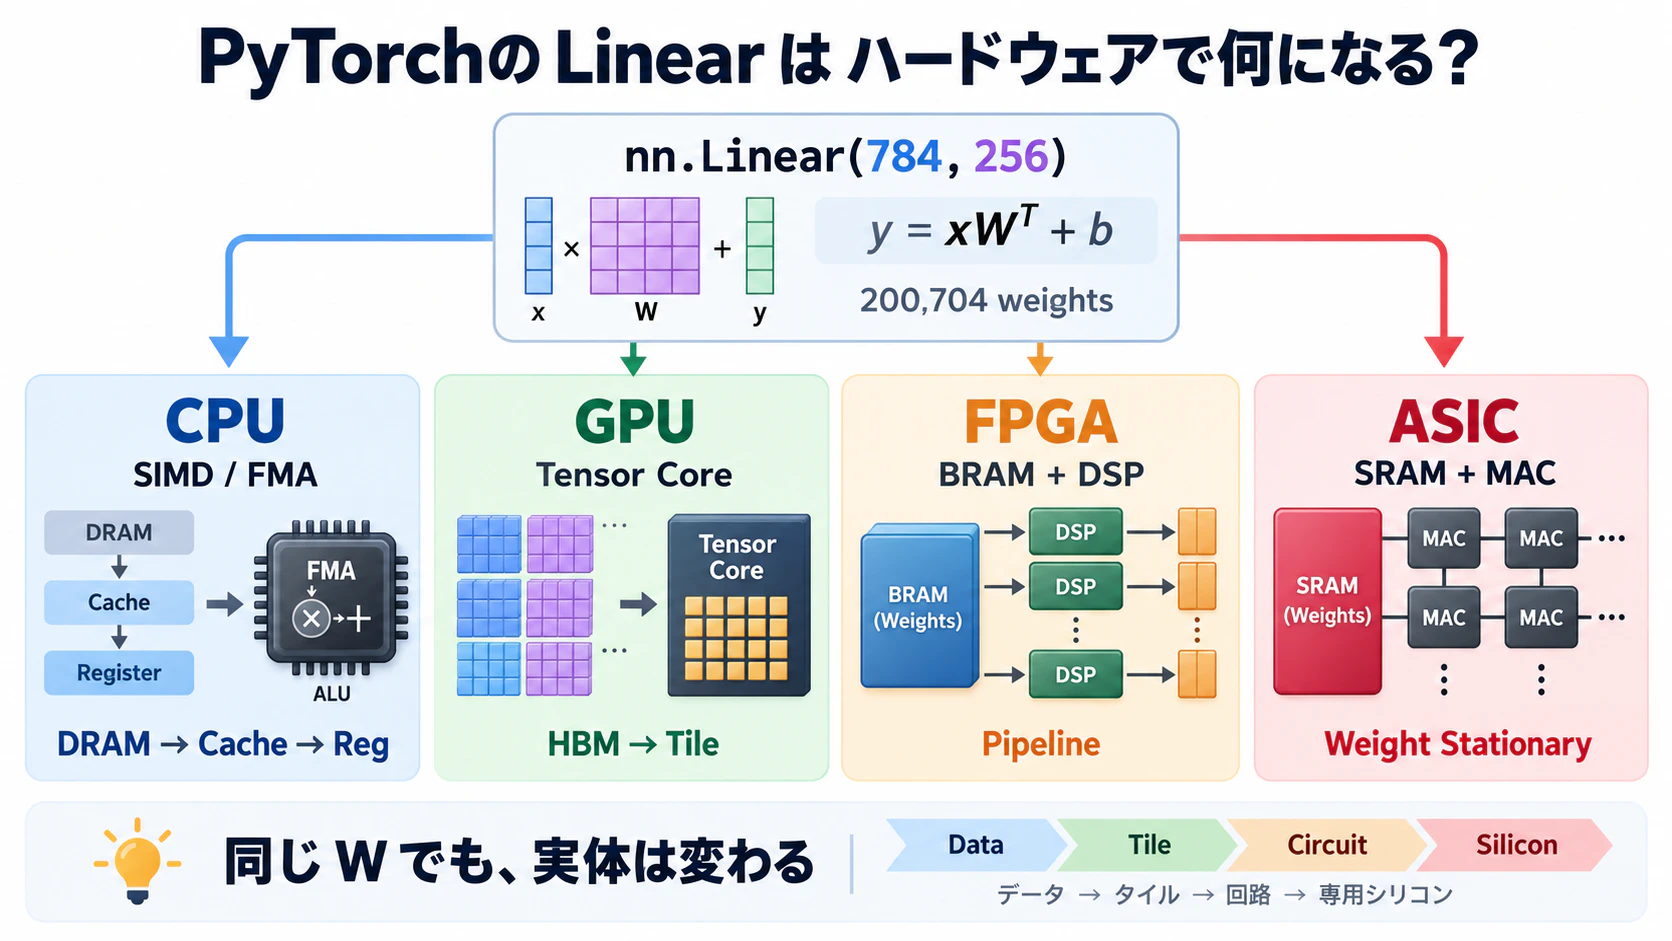
今回見たのは、たった1行です。
nn.Linear(784, 256)
数学的には、
$$
y=xW^T+b
$$
という単純な式です。
しかし、その下では、
CPUなら、
$$
\text{命令として実行}
$$
GPUなら、
$$
\text{大量並列行列演算}
$$
FPGAなら、
$$
\text{演算そのものを回路化}
$$
ASICなら、
$$
\text{専用データパスとしてシリコン化}
$$
されています。
個人的にハードウェアの視点で機械学習を見るとき、一番面白いのはここだと思います。
Pythonでは、
layer(x)
というたった一行だったものが、
ハードウェアを一段ずつ降りていくことで、
Tensor

↓

Matrix

↓

Bit

↓

Register / SRAM

↓

Multiplier

↓

Adder

↓

Logic Gate

↓

Transistor
へと変わっていきます。
そしてAIアクセラレータの設計では、
「掛け算をどう高速化するか」
だけではなく、
200704個のweightを、どこに置き、どうMACへ運び、何回再利用するか
が非常に重要になります。
ソフトウェア上ではただの nn.Linear。
しかしハードウェアから見ると、その1行の裏には巨大な設計空間が広がっています。