
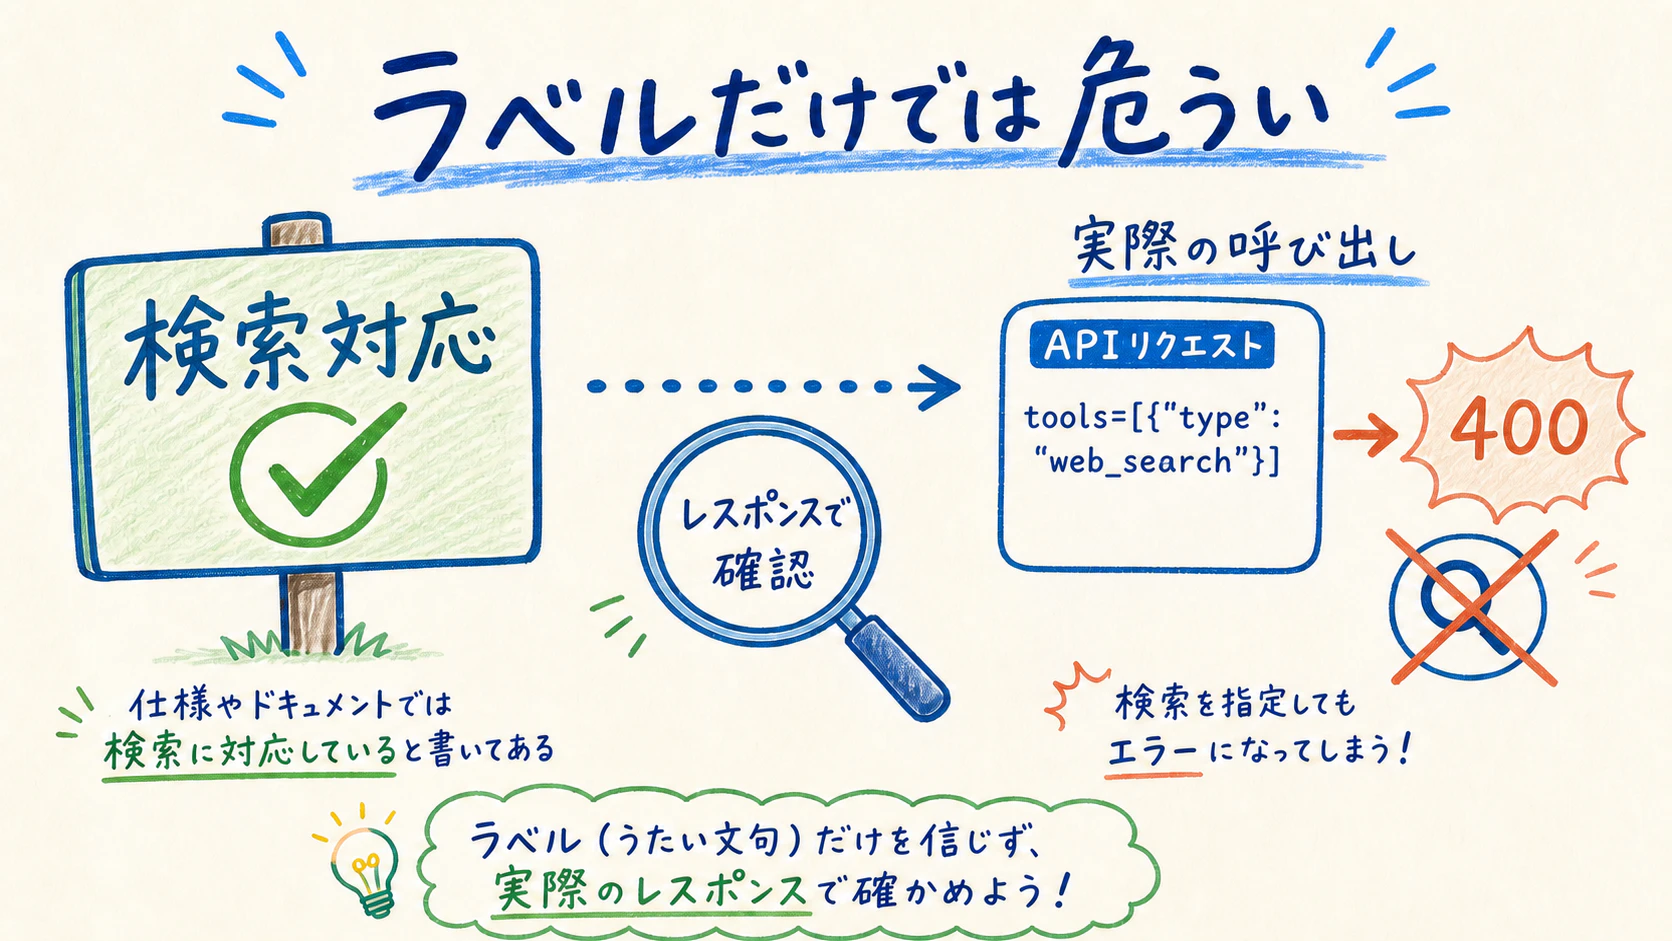
TL;DR: 「このモデルは検索に対応している/していない」という分類は、思っているより当てにならないことがある。新しいAI API「Muse Spark」の公式発表にパートナー企業の「引用付き検索組み込み」というコメントが載っていたのを見て導入検討した際、実際にAPIへweb_search系パラメータを3通りの方法で渡したところ、今回試したエンドポイント・パラメータではいずれも400エラーが返ってきた。同様の検証を既存ベンダーのGLM・DeepSeek(計3モデル)にも行ったところ、少なくとも試した設定では検索が実行された様子を確認できなかった。さらに、過去に「検索不可」と分類していたGeminiについても、その分類の根拠自体が薄かったのではないかという疑問が生まれた(原因は不明、要再検証)。少なくともAPI機能の採否判断においては、「ある機能が使えるか」はベンダー単位で固定できる事実ではなく、モデルの版・エンドポイント・ペイロードの組み合わせごとに確かめ直し、確認した日付とともに記録しておく必要がある——今回の検証を通して行き着いたのは、そういう結論だった。
1. 名前から受ける期待と、最初の肩透かし
新しいモデルの名称に「Muse(ミューズ)」という言葉が含まれているのを見たとき、直感的にマルチメディア対応や高い創造性を期待してしまうのは、開発者の性かもしれない。Meta社の新しいAI API「Muse Spark」の公式発表には、パートナー企業(Replit CEO)のコメントとして「built-in search with citations(引用付きの検索組み込み)」という言及が掲載されていた。Meta自身の仕様説明ではなくパートナー企業の感想ではあるものの、それを見て、画像生成から最新Web情報の検索までスムーズにこなしてくれるのではないか、という予感があった。
しかし、実際に自分の手元からAPIを呼び出してみると、その期待は見事に裏切られることになった——少なくとも、今回試した範囲では。
結論から言えば、このモデルは今回試した設定では画像生成が使えず、ドキュメントから推測したWeb検索機能のパラメータもすべて拒否された。ただし、この記事で本当に書きたいのは、それだけではないのかもしれない。この検証の途中で、以前「検索できない」と分類していた別のモデル(Gemini)の分類についても、再検証が必要だったことに気づいた。ある機能が使えるかどうかは、ベンダー単位の一枚看板として固定できるものではなく、モデルの版・エンドポイント・渡すペイロードの組み合わせごとに確かめ直す必要がある——それが、この一連の検証を通して行き着いた考えなのかもしれない。
では、実際にどのような呼び出しを行い、どのようなレスポンスが返ってきたのだろうか。まずは接続環境のセットアップと、最初に直面した予期せぬエラーの観察から振り返ってみたい。
2. セットアップと最初の壁:402エラーと推論モデルの挙動
検証はPythonの仮想環境(.venv)を作成し、既存のOpenAI互換SDKを利用する形からスタートした。APIキーを発行して環境変数に登録し、準備を整えて最初のテストリクエストを送信した。
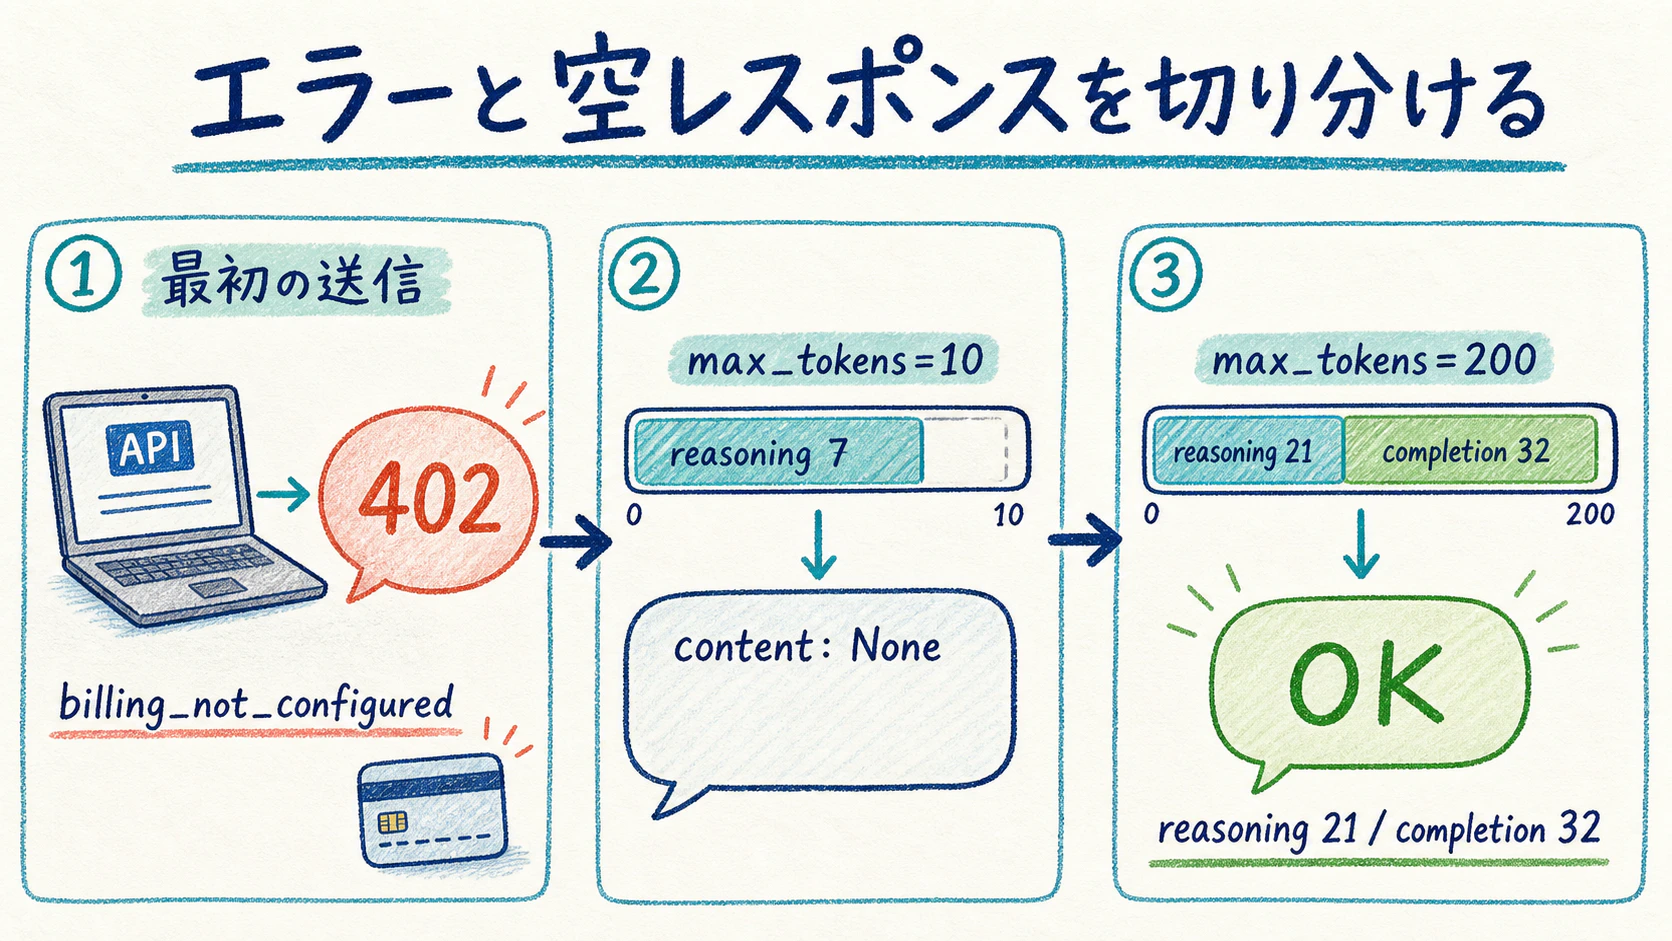
ところが、最初に返ってきたのは正常なテキストではなく、HTTP 402のエラーだった。
402 billing_not_configured
エラーコードはbilling_not_configuredで、認証エラー(401/403)とは別のコードだった。コンソールで支払い方法(クレジットカード)を登録した後、全く同じリクエストを再送すると成功した。この前後比較は、認証自体は最初から通っており支払い方法未登録が原因だった、という見立てと整合する(原因を完全に切り分けたわけではない)。
気を取り直してチャットAPIの導通確認を行った。ここで、もう一つの興味深い挙動に遭遇することになった。
動作確認の短文テストとして max_tokens=10 を指定してリクエストを送信したところ、エラーメッセージは発生しなかったものの、返ってきたレスポンスの content が Noneになっていたのだ。
APIから返された usage オブジェクトの詳細を確認してみると、completion_tokens=10 のうち reasoning_tokens=7 が計上されていることが分かった。reasoning_tokensという使用量項目が存在すること自体は、Muse Sparkが内部で推論トークンを使うモデルであることを示唆しているようだ。ただし、内部で実際に「思考してから出力する」という順序で処理されているかどうかまでは、使用量の数字だけからは確認できない。指定した max_tokens の上限(10トークン)の大部分がreasoning_tokensとして計上されており、これが空レスポンスと関係しているのかもしれない、という程度に留めておく。
そこで max_tokens=200 に引き上げて再実行したところ、以下のようなレスポンスが得られた。
-
completion_tokens: 32 -
reasoning_tokens: 21 -
content:"OK"
reasoning_tokens=21が計上された上で、content: "OK"というテキストが返ってきた。両者の処理順序や因果関係までは使用量情報だけでは分からないが、空レスポンスだったmax_tokens=10のケースとは対照的な結果だった。エラーを出さずに空のレスポンスを返すという挙動は、デバッグ時に原因を見落としやすいため、注意点としてノートに書き留めておく価値があると感じた。
なお、利用可能なモデル一覧をAPI経由で取得したところ、以下の3種類のモデル名が確認できた。
muse-spark-1.2muse-spark-1.2-contributormuse-spark-1.1
ここまでの準備を踏まえ、本題である機能面の検証へと進むことにした。最初の関門を突破したAPIは、果たして期待通りの機能を提供してくれるのだろうか?
3. 機能検証:できること、できないことの境界線
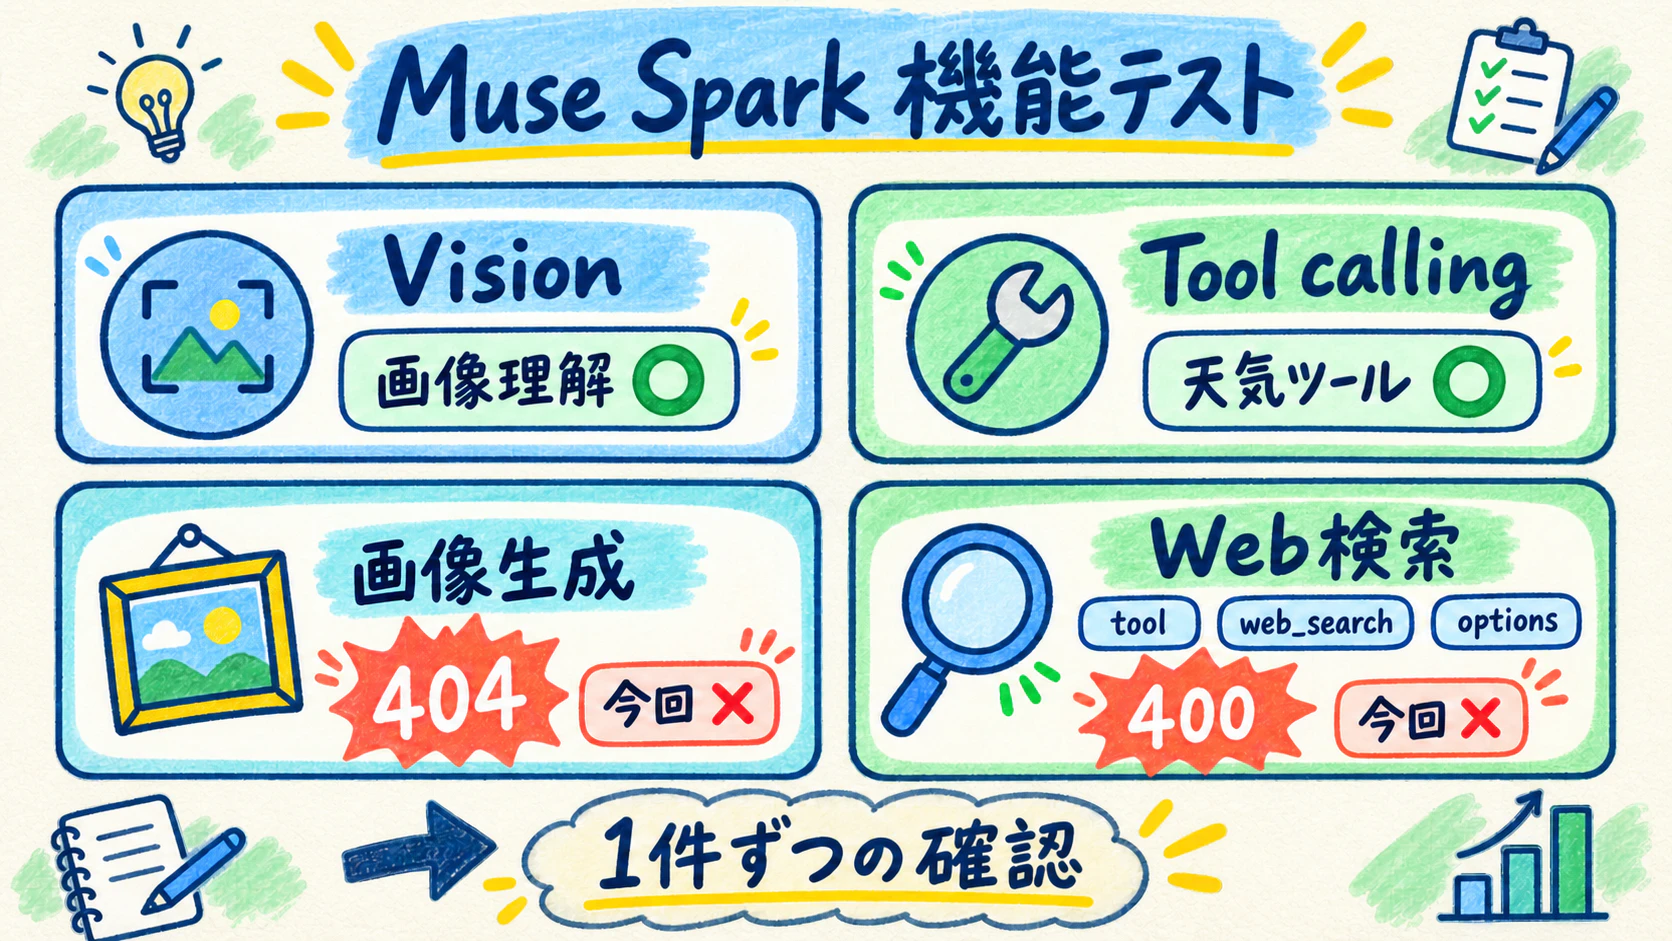
APIの実力を測るため、「Vision(画像理解)」「Tool calling(関数呼び出し)」「画像生成」「Web検索」の4つの機能について、順を追ってテストを行った。
VisionとTool callingの動作確認
まず、赤背景に青い丸を描いた自作の簡単な合成画像を準備し、Vision機能の精度を検証した。
max_tokens=1000 を設定して画像を送信したところ、reasoning_tokens=283が計上された上で、次のように画像を正確に説明した。
"A blue circle is drawn on a solid red background."
背景色とオブジェクトの形状・色を正しく捉えていた。この1件の画像入力に関しては、正しく説明できていた。
続いて、一般的な天気取得関数を定義し、Tool callingの挙動をテストした。「東京の天気は?」と尋ねたところ、モデルは期待通り以下のtool callレスポンスを返してきた。
get_weather({"city": "Tokyo"})
この1件については、期待通りtool callの生成が確認できた(実行結果を返すところまでは試していない)。
画像生成とWeb検索の不発
一方で、メディア生成と外部情報の取得に関しては、全く異なる結果となった。
画像生成エンドポイントである client.images.generate を呼び出すと、APIからは即座に以下のエラーが返ってきた。
404 model_not_found
Muse Sparkは画像を「入力として理解する」機能は持っているものの、このモデル向けの画像生成は404エラーとなり、今回試した範囲では利用できなかった。
最も大きな不整合が発生したのは、Web検索機能の検証だった。ドキュメントや一般的な検索連携の指定方法を参考に、以下の3通りのパラメータ構成でリクエストを試行した。
-
tools=[{"type": "web_search"}]を指定- レスポンス:
HTTP 400(サポートされていないtoolタイプ)
- レスポンス:
-
extra_body={"web_search": True}を指定- レスポンス:
HTTP 400(未知のパラメータ)
- レスポンス:
-
extra_body={"web_search_options": {}}を指定- レスポンス:
HTTP 400(このエンドポイントではサポートされていない)
- レスポンス:
3パターンすべての呼び出しにおいて、APIはリクエスト自体を拒否した。少なくとも今回試したチャットエンドポイント・3通りのパラメータ指定では、Web検索グラウンディングは利用できなかった。
さらに興味深い現象が起きたのは、検索指定を外し、単に「2026年8月時点の日本の内閣総理大臣は?」と質問を投げかけたときだった。
モデル自身の知識カットオフは「2026年1月4日」と回答された。そして実際の回答として「石破茂氏(2024年10月1日就任)」という情報を返しつつ、URLを3件「根拠となる情報源」として回答テキストに添えてきた。このレスポンスには、検索を実行したことを示すメタデータは含まれていなかった。検索toolを使っていないため、これらのURLが実際に存在するかどうかも筆者側では確認しておらず、外部検証を経ていない情報として扱うしかない。検索toolなしでも、根拠らしきURLが回答に含まれてくることがある、という点は記録しておきたい。
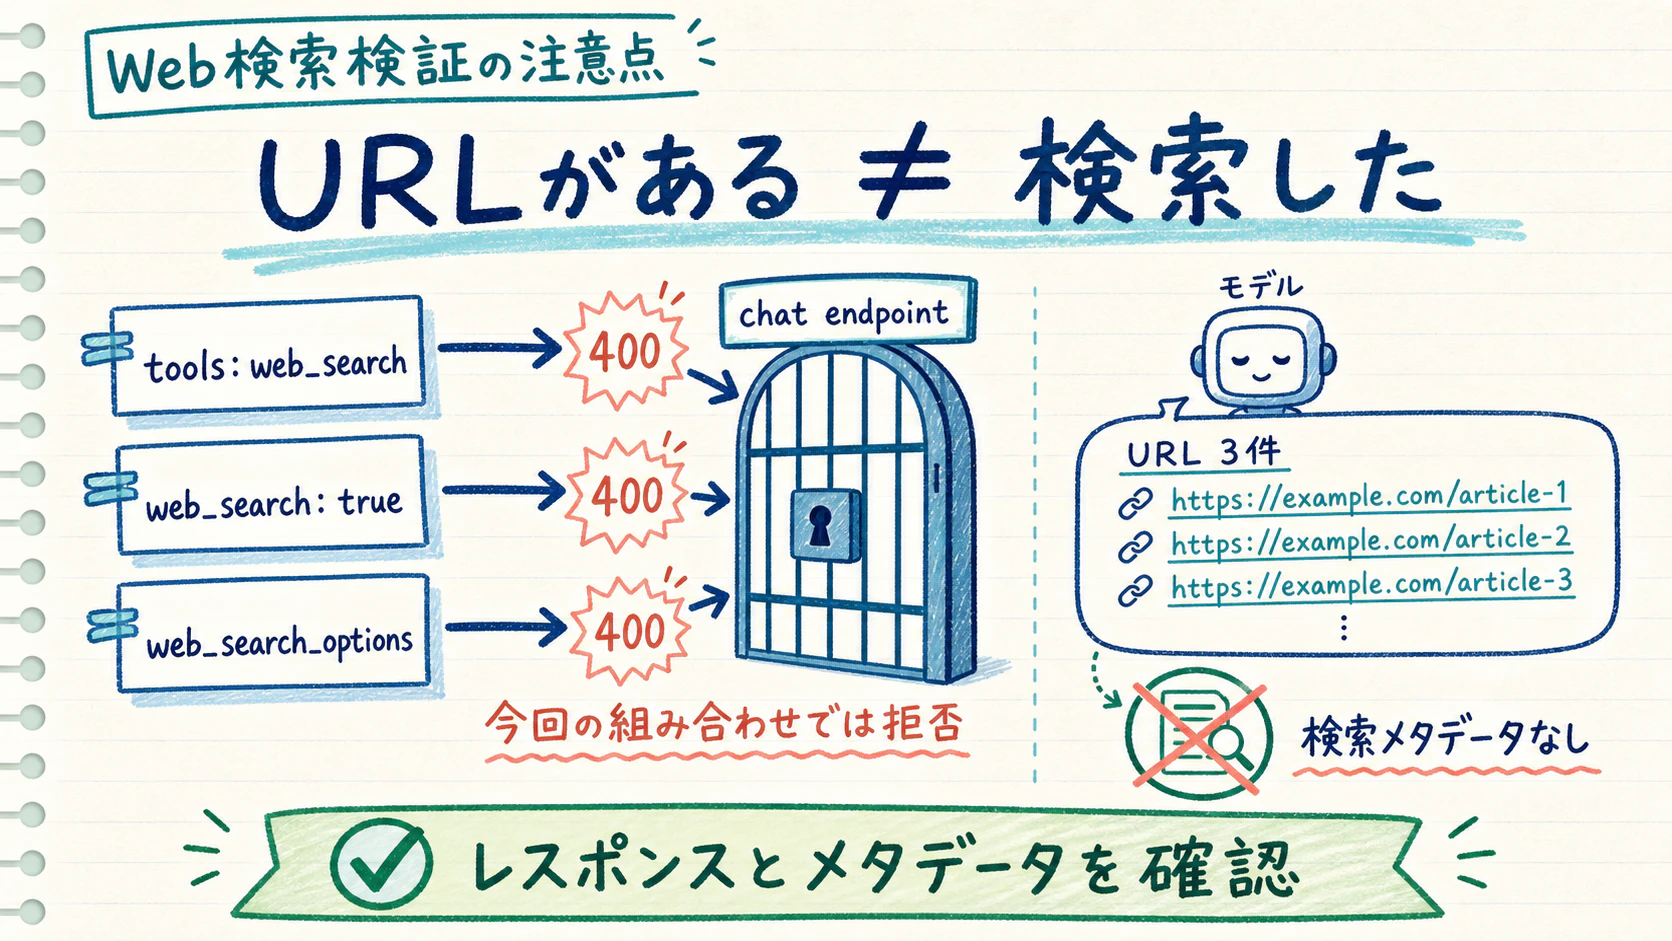
ドキュメントの記述を鵜呑みにせず、実際のレスポンスを監視することの必要性を、強く示された瞬間だったと言えるのではないだろうか。
4. 定量比較:単価スペックと「請求額の計算が合わない」謎
機能面の限界が見えてきたところで、次にコストパフォーマンスの観点から他社モデルとの比較を行った。
コンソール画面に提示されていた Muse Sparkの料金指標(単位は「100万トークンあたり」と推測、未確認)と、社内で別途確認済みの既存モデルの単価を並べたのが以下の表である。
| モデル名 | Input単価 (/1M tokens) | Cached Input単価 (/1M tokens) | Output単価 (/1M tokens) |
|---|---|---|---|
| gpt-5.6-luna | $0.20 | - | $1.20 |
| Muse Spark※ | $1.25 | $0.15 | $4.25 |
| gpt-5.6-terra | $2.00 | - | $12.00 |
| Claude Sonnet 5 (標準) | $3.00 | - | $15.00 |
| gpt-5.6-sol | $5.00 | - | $30.00 |
※コンソール画面に表示された数値。「100万トークンあたり」という単位はこちらの推測で、コンソール上の表記そのものでは確認していない。以下の比較・計算はすべてこの前提が正しい場合の参考値であり、単位が違えば結論も変わる。
この前提が正しいとすれば、Muse Sparkは gpt-5.6-luna と gpt-5.6-terra の間に位置し、ミッドレンジの Claude Sonnet 5(標準)と比べるとInput単価はSonnetの約42%(約58%安い)、Output単価はSonnetの約28%(約72%安い)という計算になる。
しかし、実際のテスト運用において、一つの解明できない問題が発生した。
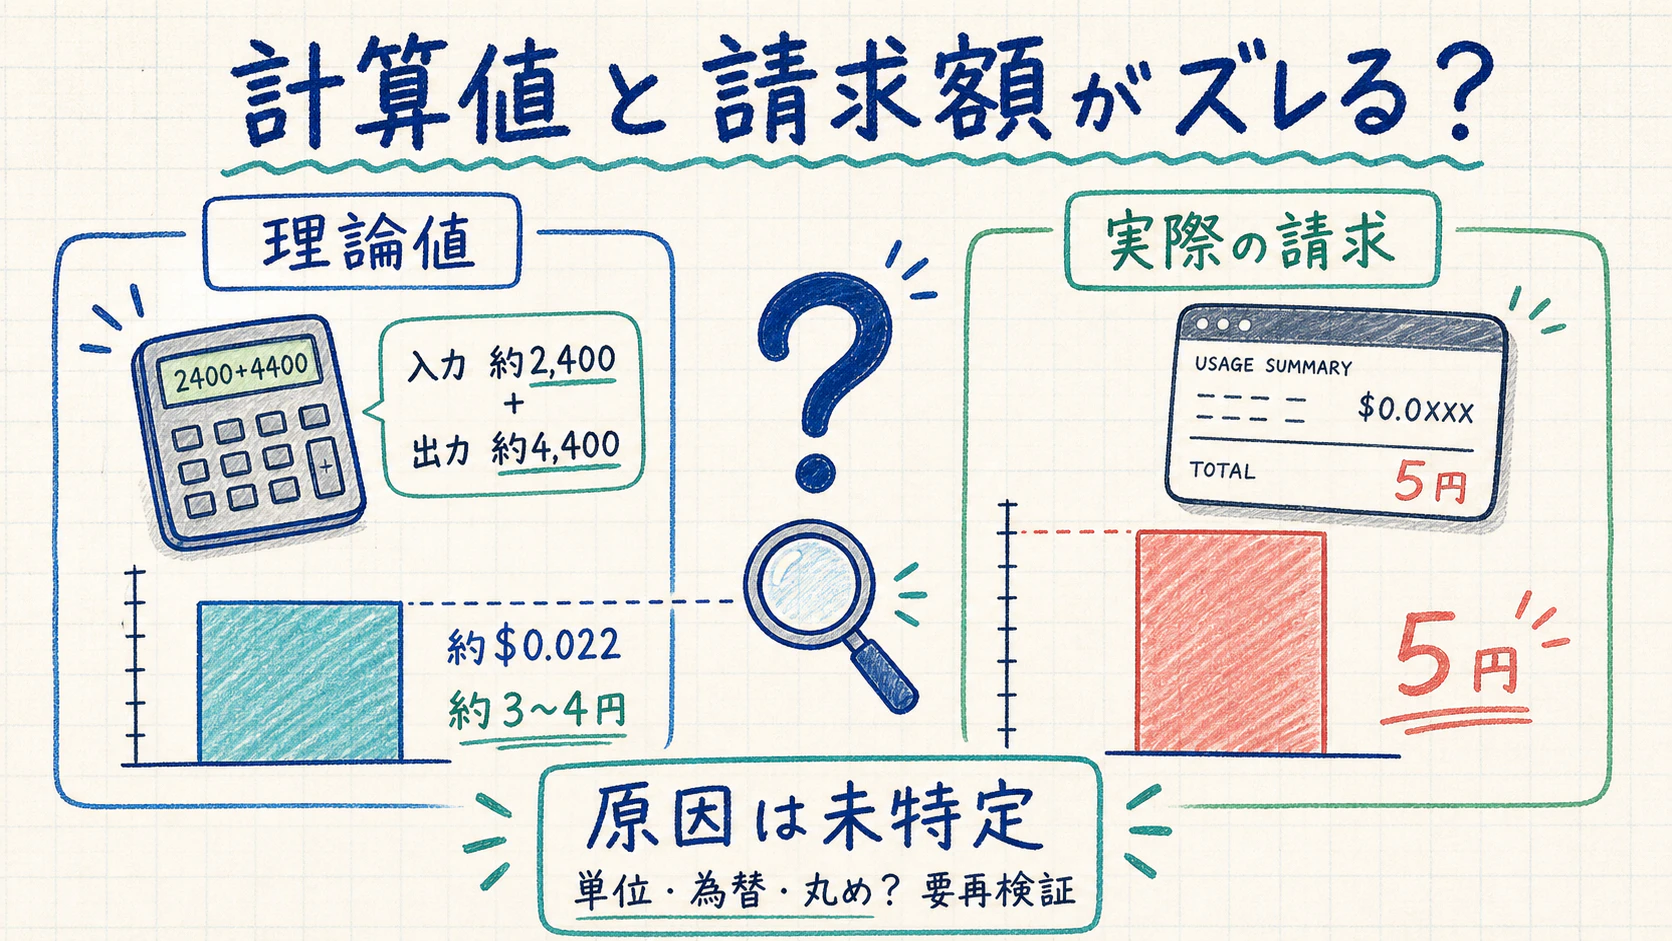
約2,400トークンのプロンプト(Input)を与え、約4,400トークンの出力(Output)を得る実データリライトのテストを行った際のことだ。単価表の「100万トークンあたり」という前提が正しいとすれば、この試行にかかるコストは**約$0.022(日本円で約3〜4円)**になる計算だった。
だが、テスト終了後にコンソール上の実際の請求金額を確認すると、請求額は5円となっていた。
この1件の観測だけでは、原因を特定するには足りない。為替換算の丸めの範囲なのか、単価表の単位そのものの前提が違うのか、それとも別の要因があるのか——結論を急がず、開かれた問いのままにしておきたい。
この計算のずれは、今後の運用コスト計算においてどのような影響を及ぼすのだろうか?
5. 詰まった点と誤算:過去の自分の「思い込み」を解体する
今回の検証作業を通して直面した壁と、そこから得られた大きな気づきは主に以下の2点に集約される。
誤算1:単価表からの計算だけでは、実際の請求額を説明できなかった
前述の通り、コンソール上のトークン単価から弾き出した理論値と、コンソールに表示された実際の請求額との間に、1件の観測ではあるが差が見られた。原因は特定できていない。大規模なバッチ処理や高頻度のマイクロリクエストを投げる運用を想定する場合、この種の「説明のつかない差額」がもしあれば積み重なる可能性がある分、注意深く見ておく価値はあるかもしれない。
誤算2:過去に作った「Geminiは検索できない」という分類を検証し直すことになった
Muse Sparkでの検索tool拒否を受けて、比較のために既存の別ベンダーモデルでも同様のテストを行った。
GLM(zai-org/glm-5.2)および DeepSeek(flashおよびpro)の計3モデルに対し、同じように tools=[{"type":"web_search"}] を渡したところ、3モデルとも 400 エラーを返した。また、extra_body={"web_search_options": {}} を渡した場合はエラーにはならなかったが、検索が実行されたことを示す様子はなく、「自分の知識カットオフ(2024〜2025年)以降の情報は分からない」という回答が返ってくるだけだった(このテストのスクリプトは§8で保存したが、実際のレスポンス本文の生ログはまだ保存できておらず、この記述は筆者自身の実行時メモに基づく)。
この検証を行っていた最中、自社のモデル役割分担メモの中に**「Geminiは検索ができないモデル」**という分類が残されていることに気づいた。
「本当にそうだっただろうか?」と気になり、過去の別プロジェクトのファクトチェック記録(n=7件の検証で7件とも正確な外部情報を引けていた実績、という筆者自身のメモ。こちらも生ログは未保存)をひもといて再検証を行った。この記録が示すのは「正確な外部情報を返した」という結果であって、その時グラウンディング機能自体が有効だったかどうかまでは、当時の記録からは確認できない。Gemini自体にWeb検索グラウンディング機能が存在する可能性はあるが、この記事の材料だけでは確定できない。過去に「検索できない」と判断してしまったのは、当時使った呼び出し経路でその機能が有効になっていなかったことが原因ではないか、というのが現時点での推定だ(確定はしていない)。
新規ベンダーの不調を確かめる過程で、**「自分自身が過去に下した分類について、再検証の根拠が十分に残っていなかった」**という事実が浮き彫りになった瞬間だった。分類を鵜呑みにせず、APIの生の挙動で答え合わせをすることの大切さを教えられたように思う。この裏付け不足自体、次に同じ判断をするときの教訓になるのかもしれない。
過去の知見を定期的に疑い、再テストすることなしに、正しいマルチモデル構成を維持することはできるのだろうか?
6. 考察:ドキュメントではなく「レスポンス」でベンダーを評価する
新しいAIベンダーやモデルが登場した際、私たちはついつい公式ページの華やかな機能一覧や、ベンチマークスコアのグラフ、充実したドキュメントの記述を基準に採用可否を議論してしまいがちなのかもしれない。
しかし、今回のMuse Sparkの導入検証、ならびに過去のGemini分類の見直しから得られた教訓は、非常にシンプルなのだと思う。
「ドキュメントに書かれた対応方法を鵜呑みにせず、実際にその通りのリクエストを送って、返ってきたレスポンス(とgrounding関連のメタデータ)で答え合わせをする」
今回試した特定のエンドポイント・特定のパラメータが、エラー内容として明示的に非対応を示す 400 Bad Request(サポートされていないtoolタイプ/未知のパラメータ/このエンドポイントではサポートされていない、等)を返したのであれば、少なくともその組み合わせは「非対応」として扱うのが実務者としての妥当な態度だろう(単なる形式エラーの400と混同しないよう、エラー詳細まで確認する前提で)。Geminiの一件が示しているのは、逆方向の教訓だ——過去に「検索できない」と判断していた根拠自体が、今振り返ると十分ではなかった。少なくともAPI機能の採否判断では、ある機能が「使えるか」を、モデルやベンダーに貼れる一枚看板のラベルだけで済ませるのは、今回の実感からすると危ういのかもしれない。
モデルの選定や役割分担を決める際は、仕様書だけを信じるのではなく、いつ・どの版・どのエンドポイント・どのペイロードで確認したかを記録として残しておくこと——APIやモデルは今後も更新されうる以上、それが判断材料を増やし、再現・再検証をしやすくするのではないだろうか。
7. シナリオ別判断表と今回の結論
今回の各種検証実験を踏まえ、Muse Sparkの導入に関する判断基準を以下のマトリクスにまとめた。
| 求める要件 / ユースケース | 判断 | 理由・代替案 |
|---|---|---|
| テキスト生成の単価を抑えたい | 検討の余地あり | §4の単位前提が正しければSonnet 5より安価。ただし gpt-5.6-luna の方がさらに低単価。 |
| 画像入力(Vision)やTool calling | 既存ベンダーで十分(自社の運用前提) | それぞれ1件ずつのテストでは期待通りの結果だったが、自社では既にGemini・Codex・Claudeでこの用途を運用しており、置き換える理由に乏しい(この記事ではMuse Spark側の単発テストのみを検証、既存3ベンダー側の比較検証はしていない)。 |
| 画像生成機能 | 今回試した組み合わせでは失敗 | この用途のAPIは404エラーで、今回試した組み合わせでは利用できなかったため。他のエンドポイント/設定は未確認。 |
| Web検索グラウンディング | 今回試した組み合わせでは失敗 | 3通りのパラメータ指定すべてで400エラーとなったため。他の設定は未確認。検索toolなしだと、外部検証を経ていないURLが根拠らしく提示されることがある点にも注意。 |
最終的な意思決定
VisionやTool callingといった動作確認が取れた機能に関しても、自社では既存の運用環境(Gemini・Codex・Claude)でカバーしている領域だった。その上で、期待していた画像生成とWeb検索が今回試した範囲では利用できないとなれば、今回確認した要件の範囲では、Muse Sparkを組み込む理由を見出せなかった。
この結論を受け、コンソールに登録していたクレジットカード情報を削除し、今回の導入は見送る判断を下した。
ただし、将来的に社内で「複数のAIモデル同士に議論・討議を行わせるミーティングシステム」などを構築する機会があれば、§4の単位前提・請求額の食い違いが解消できた場合に限り、レスポンスにreasoning_tokensが計上されるモデルの選択肢として、 Muse Sparkの再検討を行う余地は残しておきたいと考えている。
8. 検証記録という形で残す
「使えるか」を一枚看板のラベルで済ませないためには、判断そのものを記録として残す必要がある。今回の検証を、モデル・版・エンドポイント・ペイロード・結果・確認日の単位で整理すると、以下のようになる。
| モデル/版 | エンドポイント/機能 | 渡したペイロード | 結果 | 確認日 |
|---|---|---|---|---|
| muse-spark-1.2 | chat completions (Vision入力) | 画像1枚(data URI) | この1件は正しく説明 | 2026-08 |
| muse-spark-1.2 | chat completions (tool calling) | 天気取得ツール定義1件 | tool call生成を確認(実行結果の返却は未検証) | 2026-08 |
| muse-spark-1.2 | images.generate | 画像生成プロンプト | 404 model_not_found | 2026-08 |
| muse-spark-1.2 | chat completions | tools=[{"type":"web_search"}] |
400 | 2026-08 |
| muse-spark-1.2 | chat completions | extra_body={"web_search": True} |
400 | 2026-08 |
| muse-spark-1.2 | chat completions | extra_body={"web_search_options": {}} |
400 | 2026-08 |
| GLM/DeepSeek(3モデル) | chat completions | tools=[{"type":"web_search"}] |
400(3モデルとも) | 2026-08 |
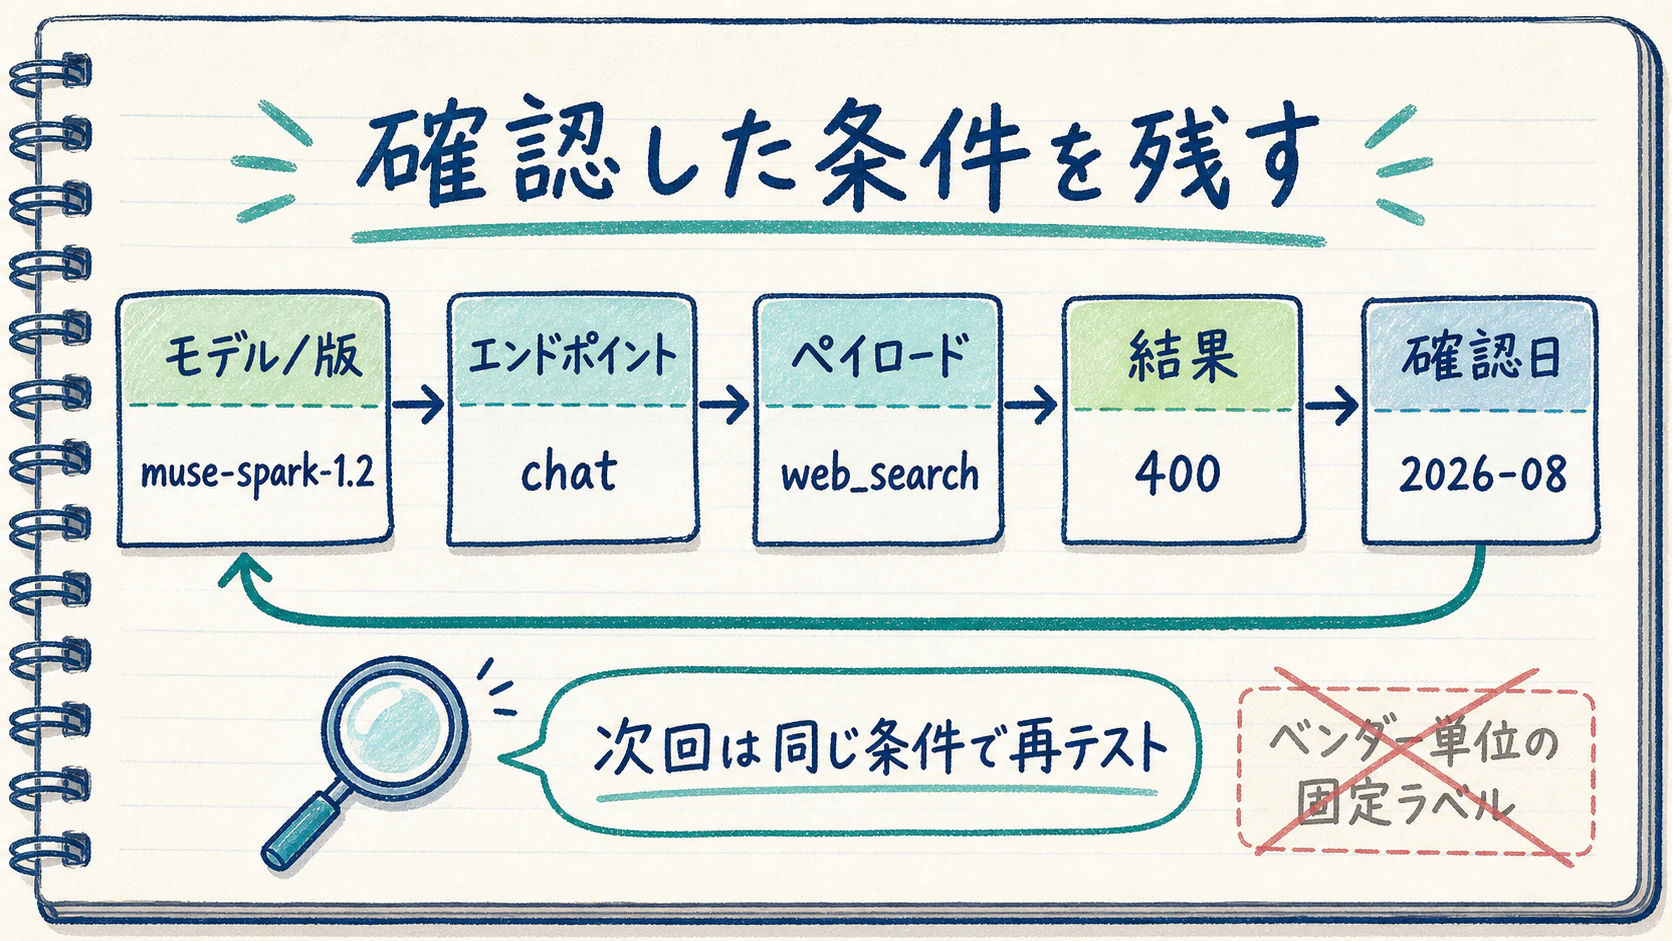
このような記録があれば、次に同じ機能を評価するときに「以前も検証したはず」で済ませず、モデルの版・エンドポイントが変わっていないかを起点に再検証できる。今回の検証に使用したテストスクリプト自体は、この表と合わせて再現可能な形で保存した。ただし、実際のレスポンス本文(生ログ)まではまだ保存できておらず、これは今後の課題として残っている。
ドキュメントの謳い文句を鵜呑みにせず、まずは数回APIを叩いてレスポンスの挙動を見極める——この泥臭いアプローチが、判断材料を増やし、再現・再検証をしやすくすることは、今回の一連の検証からも見えてきた。
次に新しい「魅力的なAPI」が登場したとき、あなたなら公式ページを読み込みますか? それとも、まず数行のコードを書いて叩いてみますか?