

この記事の確認範囲
- 確認日: 2026年9月28日
- 対象: Supersonic Labs「Julia 1」(Hugging Face
SupersonicLabs/Julia-1、リポジトリのコミットa85b127、重みの SHA-256 はdf853bf7fe42…)と、TypeSafe AI「Jev」(jev-1.13.0) - 検証した PC: MacBook Pro(Apple M5 Max・メモリ 128GB)、macOS 26.6.2、Python 3.12.14、PyTorch 2.14.0、Transformers 5.0.0
- Julia 1 はすべて手元で実行しました。Jev は今回実行していません。 Jev の数値は、第三者が公開した測定記録(出典は各節に記載)から引用しています
はじめに
問い合わせを担当チームに振り分ける、文章が「返金の依頼」かどうかを判定する、といった処理を LLM(大規模言語モデル)に任せると、1 件ごとに数秒かかり、料金もかさみます。欲しいのは長い文章ではなく「どれか 1 つの答え」だけなのに、毎回文章を書かせているからです。
この「選ぶだけ」の仕事に特化したのが、2026年9月15日に TypeSafe AI が早期アクセスを始めた Jev です。Jev は文章を生成せず、渡した選択肢それぞれの確率を返します。ただしクラウドの有料 API で、手元では動きません。
そこへ 9月25〜26日、ブラジルの Supersonic Labs が Julia 1 を公開しました。同じ「状況・問い・選択肢を渡すと答えと確率が返る」形のモデルで、重みは Apache-2.0 の無料公開、しかも CPU だけで動きます。公式の比較表には「Jev と同等以上」と読める数字が並んでいます。

左がクラウドで判定する Jev、右が手元の CPU で判定する Julia 1。受け取る結果の形は同じで、違うのは計算する場所です。
この記事では、次の 3 つを確かめます。
- ベンチマーク上、Julia 1 と Jev はどれくらいの差なのか(大差ないのか、Jev が圧倒的なのか)
- Julia 1 を実際に Mac に入れて動かす手順
- 手元で動かしたときの精度と速度(公式の数字は再現できるのか、日本語ではどうか)
想定する読者は、Jev や判定モデルに興味があり、これから Julia 1 を試してみたいエンジニアと、AI で業務の振り分けを自動化したい方です。Python の仮想環境を作れれば、手順どおりに再現できます。
先に結論
検証の結果を先にまとめます。
| 問い | 答え |
|---|---|
| ベンチマークで Jev と大差ないか | 2,000問の typed-decisions ではほぼ互角(Julia 73.15% 対 Jev 72.70%、手元の CPU では 72.55%)。ただし 72 択の細かい分類では Jev が大差で上(87% 対 61〜64%) |
| Julia が Jev を上回った項目は信用できるか | 4択・6択の小テスト(各100問)は Julia が上。ただし、比べた条件が同じとは言い切れない(後述) |
| 手元で公式の数字は出るか | 公式の手順どおりなら、ほぼ同じ数字が出た(2,000問は1問も違わず一致) |
| 日本語で使えるか | 6択の振り分けは 77%。確率 0.8 以上の答えだけ採用すると 48件中31件を全問正解で処理できた。一方、日本語の「はい/いいえ」判定は当てずっぽう並みだった |
| 速さ | M5 Max の CPU で 1件 約19ミリ秒。Jev(ネット経由で約0.25秒)より一桁速い |
判定モデルとは何か
文章を書かず、選択肢に点数を付ける
Julia 1 も Jev も、入力は 3 つです。状況を表す state(問い合わせ文や JSON)、問いを表す question、そして答えの候補である options です。モデルは 3 つをまとめて読み、選択肢ごとに点数を付け、確率に直して返します。
入力の 3 つから、選択肢ごとの確率が返ります。確率が低いときは人に回す、といった使い方ができます。
問いの形式は 3 種類あります。どれも Jev と同じ考え方です。
| 形式 | 使いどころ | 返ってくる値 |
|---|---|---|
choice |
担当チーム、ジャンル、感情など、1つを選ぶ | 選んだ ID と、各 ID の確率 |
score |
緊急度「低・中・高」のように順序のある評価 | 期待値としての段階と、各段階の確率 |
noul |
「返金を求めている」のような、はい/いいえ | 「はい」である確率 |
LLM との一番の違いは、答えが必ず選択肢のどれかになることです。「請求担当です。なお〜」のような余計な文章は出ませんし、存在しない選択肢を作り出すこともありません。プログラムの分岐にそのまま使える、というのが判定モデルの売りです。
Jev と Julia 1 の違い
同じ形の判定モデルでも、提供のされ方は大きく違います。公式の発表とリポジトリの記載から、主な違いを表にしました。
| 項目 | Jev(TypeSafe AI) | Julia 1(Supersonic Labs) |
|---|---|---|
| 公開日 | 2026年9月15日(早期アクセス) | 2026年9月25〜26日(Hugging Face) |
| 提供の形 | クラウドの API | 重みとコードを公開(Apache-2.0) |
| 大きさ | 非公開 | 1億4430万パラメータ(144.3M)、重み 550MB |
| 元になったモデル | 非公開 | mmBERT-small(多言語の文章理解モデル) |
| 料金 | 入力 100万トークンあたり 0.042ドル、出力は無料 | 手元で動かすなら無料(API は入力 100万トークンあたり 0.025ドルで提供予定) |
| 選択肢の数 | 最大 255 | 1回 2〜20(それ以上は予選→決勝で絞る) |
| 応答時間 | 70〜500ミリ秒(公称) | 手元の M5 Max で 1件 約19ミリ秒(実測) |
| 苦手と明言されていること | ― | 知識が要る問題、複数段階の計算、長い選択肢リスト |
Julia 1 は mmBERT-small という公開済みの多言語モデルに「選択肢に点数を付ける部品」を足して学習したものです。公式ブログによると、学習と実験にかかったクラウド GPU 代は約 104ドル(540レアル)だそうです。次の版の Julia 2 では、土台から独自に作る計画だと書かれています。
ベンチマーク上の差: 公式の比較表を読む
公式の数字
まず、Julia 1 のモデルカード(README)に載っている比較表を見てみます。グラフでは、項目ごとに順番に強調しています。

4項目中3項目で Julia 1 が上ですが、72択の Banking77 だけは Jev が大きく上回っています。
| ベンチマーク | 内容 | Julia 1 | Jev(参照値) | 差 |
|---|---|---|---|---|
| Typed decisions | 業務シナリオの合成データ、2,000問(choice・score・noul) | 73.15% | 72.70% | +0.45 |
| AG News | ニュースの4ジャンル分類、100問 | 94% | 91% | +3 |
| DAIR Emotion | 短い投稿の6感情分類、100問 | 86% | 48% | +38 |
| Banking77 | 銀行への問い合わせの72種分類、100問 | 64% | 87% | −23 |
この表だけを見ると「無料の Julia 1 が Jev とほぼ同等、感情分類では圧勝」に見えます。ただし、数字の出どころを確認すると、読み方にいくつか注意が要ることが分かりました。
注意1: Jev の数字は「参照値」で、同じ日に並べて測ったものではない
README には「Jev の数値は提供された比較用の参照値で、新たに Jev を実行したものではない」と明記されています。では、誰がいつ測ったのかをたどってみました。

Jev の値は、別の人が別の日に測った記録を転記したものです。
- AG News・Emotion・Banking77 の Jev の値は、StarkWare の AbdelStark 氏が 9月17日に公開した jev-benchmarks の記録です。比べた相手は GLiNER2.5 という別の小型モデルで、Julia は含まれていません
- **typed-decisions の Jev の値(72.70%)**は、このデータセットの作者 codelion 氏が 9月18日に Jev の API で測った記録です。データセットのカードに「TypeSafe とは無関係で、Jev を再現するものではない」と書かれています
つまり問題は同じでも、Julia 1 と Jev を同じ日・同じ環境で並べて走らせた比較ではありません。
注意2: typed-decisions の 72〜73% は「天井」のすぐ下
typed-decisions の正解は、人が付けたものではありません。約40億パラメータ級の「先生役」のモデルに 3 回答えさせて平均したものです。データセットのカードには、基準となる数字が載っています。

上位のモデルは、先生役自身の一致率 73.5% のすぐ下に固まっています。
先生役のモデル自身がもう一度答えても、一致するのは 73.5% にとどまります。カードには「0.75 を大きく超えたら、問題ではなく先生のクセを覚えたと考えよ」という注意書きまであります。この天井のすぐ下での 0.45 ポイント差は、2,000問中およそ 9 問ぶんです。しかも後で示すとおり、同じ重みを CPU で動かすと 72.55% になり、Jev の 72.70% をわずかに下回ります。この項目は「互角」と読むのが妥当です。
注意3: 同じ種類の問題で「練習済み」かどうかが分からない
jev-benchmarks では、Jev は「初見の問題(ゼロショット)」として記録されています。一方、Julia 1 のリポジトリにある検証記録ファイル(provenance.json)には、AG News・Emotion・Banking77・MASSIVE、さらに typed-decisions と同じ4つの業務名の検証結果が並んでいます。
Julia 1 は、ベンチマークと同じ系統の問題で調整されている可能性があります(学習データは非公開)。
検証記録があるからといって、テスト問題そのものを学習したとは限りません。ただ、同じ系統の問題で鍛えたモデルと、初見で解いたモデルの点数をそのまま比べると、前者に有利になりやすいのは確かです。typed-decisions のカードも「汎用モデル(初見)と専用モデル(同じ業務で学習)の数字は比べられない」と強調しています。Julia 1 がどちらの条件で測られたのかは、README に書かれていません。
同じファイルには、知識を問う MMLU が 26.3%、ARC が 28.5% という記録もあります。4択の当てずっぽうが 25% なので、ほぼ偶然と同じです。README の「知識や多段階の計算は苦手」という説明と一致しています。
ここまでの判定
ベンチマークの数字から言えることを整理します。
| 項目 | 判定 | 理由 |
|---|---|---|
| typed-decisions(2,000問) | 互角 | 差は誤差の範囲。天井の近くに並んでいる |
| AG News・Emotion(4択・6択) | Julia 1 が上。ただし条件の差に注意 | 各100問と小さく、Julia は同じ系統の問題で調整済みの可能性。Emotion は Jev の苦手(正解に確率 0 を付けた問題が16%)が大きく効いている |
| Banking77(72択) | Jev が圧倒的に上 | Julia 1 は1回20択までのため、絞り込みが必要。絞り込みで正解を落とす |
| 知識問題 | Julia 1 は当てずっぽう並み | MMLU 26.3%(Jev の同条件の記録は見つからず) |
「Jev の方が圧倒的に精度が高いのか」への答えは、選択肢が少ない分類ならほぼ互角、選択肢が多い細かい分類なら Jev が圧倒的に上です。ここからは、実際に Mac に入れて確かめていきます。
Julia 1 を Mac に入れる
準備するもの
Julia 1 は GPU なしで動きます。必要なものは次のとおりです。
| 項目 | 条件 | 今回の環境 |
|---|---|---|
| Python | 3.11 以上(Mac 標準の 3.9 は不可) | 3.12.14(Homebrew) |
| 空き容量 | 約 1.5GB(リポジトリ 585MB、仮想環境 885MB) | 十分 |
| メモリ | 読み込み時の最大で約 1.1GB | 128GB |
| GPU | 不要(Apple の GPU は非対応) | 使わない |
全体の流れを図にしました。

重みのファイルだけを取っても動きません。リポジトリごと取ってくるのがポイントです。
手順1: Python 3.11 以上を用意する
Mac に最初から入っている Python は 3.9 のため使えません。Homebrew で新しい Python を入れます。
# Homebrew で Python 3.12 を入れる(入っていれば不要)
brew install python@3.12

# バージョンを確認する(3.11 以上ならOK)
python3.12 --version
手順2: 仮想環境を作る
作業用のフォルダーを作り、その中に仮想環境(このフォルダー専用の Python の部屋)を作ります。PyTorch などの大きなライブラリが入るので、ほかのプロジェクトと混ざらないようにしておきます。
# 作業フォルダーを作って移動する
mkdir julia1-test && cd julia1-test

# 仮想環境を作って有効にする
python3.12 -m venv .venv
source .venv/bin/activate
手順3: リポジトリごとダウンロードする
Hugging Face からリポジトリ全体を取得します。重み(model.safetensors、550MB)のほかに、判定の計算を担う julia/ パッケージや評価スクリプトが含まれています。
# ダウンロード用のライブラリを入れる
pip install huggingface_hub

# リポジトリ全体を Julia-1 フォルダーに取得する(約585MB)
python -c "from huggingface_hub import snapshot_download; snapshot_download('SupersonicLabs/Julia-1', local_dir='Julia-1')"
手順4: 付属のパッケージを入れる
取得したフォルダーを「編集可能モード(-e)」でインストールします。このとき PyTorch や Transformers も自動で入ります。
# Julia-1 フォルダーの julia パッケージと依存ライブラリを入れる
pip install -e ./Julia-1
手順2〜4を実際に実行した様子です。今回の回線では、ダウンロードに約1分17秒かかりました(録画では待ち時間を短く詰めています)。

最後の du で、重みが 550MB あることを確認しています。数百バイトしかない場合は、ダウンロードに失敗しています。
手順5: 日本語で最初の判定をしてみる
問い合わせ文を 3 つ用意し、担当チームを選ばせてみます。選択肢は ID(billing など)と説明文の組で渡します。答えは ID で返ってくるので、そのままプログラムの分岐に使えます。
# hello_julia.py — Julia 1 で日本語の問い合わせを振り分ける
import time
from julia import load_model

# モデルを読み込む(最初の1回だけ数秒かかる。以降は使い回す)
engine = load_model("Julia-1", device="cpu", strict_encoding=True,
                    max_length=8192, head_length=512)

questions = {
    "team": {
        "type": "choice",
        "instructions": "この問い合わせを担当するのはどのチームですか。",
        "criteria": {
            "billing": "請求・支払い(二重請求、決済、領収書)",
            "shipping": "配送(届かない、配達日時、届け先)",
            "account": "アカウント(ログイン、パスワード、登録情報)",
        },
    },
}

for text in ["同じ注文でクレジットカードに2回請求されています。",
             "注文から10日たっても商品が届きません。",
             "パスワードを何度入れてもログインできません。"]:
    t0 = time.perf_counter()
    answer = engine.predict(state=text, questions=questions)["answers"]["team"]
    ms = (time.perf_counter() - t0) * 1000
    print(text, "→", answer["choice"], answer["probabilities"], f"{ms:.0f} ms")
strict_encoding=True は、入力が長すぎて切り詰められそうなときに、黙って切らずにエラーにする設定です。精度を測るときは必ず付けておきます。

3件とも正しいチームが選ばれました。読み込みは4.0秒(インストール直後の初回)、判定は1件あたり12〜32ミリ秒でした。1件目だけ遅いのは、初回の準備が含まれるためです。
ここで気になるのは、確率がどれも 1.00 と表示されている点です。これは「自信満々」という意味で、正しさの保証ではありません。後の検証で、この自信の強さが精度とずれる場面を見ていきます。
実測1: 公式の 2,000 問を CPU で再現する
最初に、公式の数字が手元でも出るかを確かめます。リポジトリには、typed-decisions の 400 ケース(2,000問)を解き直すスクリプトが付属しています。テストデータを自動でダウンロードし、ファイルのハッシュ値(内容の指紋)まで照合してくれます。
# Julia-1 フォルダーで実行する(評価用の追加ライブラリを入れる)
cd Julia-1
pip install -e '.[benchmark]'

# 2,000問を CPU で解き直す(新しい出力フォルダーを指定する)
python scripts/reproduce_typed.py --output ../bench/typed-cpu
結果を見やすく表示する小さなスクリプト(show_typed.py、付録に掲載)も合わせて実行しました。

2,000問を約80秒で解き終えました。合計は 1,451問正解で 72.55% です。
| 形式 | 公式(GPU・H200) | 公式の CPU 再測定 | 今回(M5 Max の CPU) |
|---|---|---|---|
| choice | 428/600 | 426/600 | 426/600 |
| noul | 484/600 | 483/600 | 483/600 |
| score | 551/800 | 542/800 | 542/800 |
| 合計 | 73.15% | 72.55% | 72.55% |
公式の CPU 再測定と、1問も違わず一致しました。 GPU で測った 73.15% との差は、計算の精度(GPU は BF16、CPU は FP32)の違いによるもので、公式も原因は特定できていないとしています。いずれにせよ、Jev の 72.70% とは誤差の範囲です。
このスクリプトには、はい/いいえ(noul)の選択肢から説明文を外して解き直すオプション(--literal-noul-ablation)もあります。試すと noul の正解が 483問から 391問(80.5% → 65.2%)に落ちました。「はい/いいえ」の問いでは、選択肢の説明文が精度を大きく左右します。これは後の日本語テストでも、もっとはっきり表れます。
実測2: Jev と同じ 300 問を解かせる
同じ問題を用意する
次に、Jev が 91%・48%・87% を記録した 300問(AG News・Emotion・Banking77 各100問)を、Julia 1 に解かせます。jev-benchmarks のリポジトリを同じコミットで取得し、付属のコマンドで問題セットを作りました。
# Jev の測定と同じコミットの jev-benchmarks を取得する
git clone https://github.com/AbdelStark/jev-benchmarks.git
cd jev-benchmarks
git checkout 0d610cc53e79bcbec691312b0c4adb4a0e371642
pip install -e '.[data]'

# 問題セット(manifest.jsonl)を作る。出力先は設定ファイルの output_dir
python -c "import sys; sys.argv=['jev-bench','prepare','--config','configs/pilot-v1.yaml']; from jev_benchmarks.cli import main; main()"

# ハッシュ値が Jev の測定記録と一致するか確認する
shasum -a 256 results/runs/btzsc-pilot-v1/manifest.jsonl
# → ec064c52b149de458344cd4b4a44c158460f30b3bbb7fe8b2e7ec72d0abf3ba5 なら同じ300問
作った問題セットのハッシュ値は、Jev の報告書に書かれている値 ec064c52… と一致しました。Jev が解いたのとまったく同じ 300問です。質問文も Jev の測定と同じ「Which single label best describes the input text?」を使いました。
72 択は予選と決勝に分ける
Julia 1 は 1 回に 20 択までしか扱えません。Banking77 は 72 択なので、そのままでは解けません。そこで、18択×4組の予選で各組の上位4件を残し、残った16件で決勝をする、という絞り込みを自作しました。
絞り込みでは、正解を途中で捨ててしまう危険があります。今回は 100問中 9問で、正解が予選で落ちました。
公式も「top-16 の候補リストで絞り込んだ」と書いていますが、具体的な方法は公開されていません。そのため、今回の数字は公式と完全に同じ条件ではありません。
結果
300問の実行は約21秒で終わりました(スクリプトは付録に掲載)。

AG News と Emotion は公式と同じ 94%・86%。Banking77 は自作の絞り込みで 61% でした。
jev-benchmarks と同じ指標で、Jev の記録と並べます。「自動化できる割合」は、確率が高い順に答えを採用していったとき、間違いを 5% 以内に抑えながら何割を任せられるかを示す指標です(しきい値を同じデータで選んでいるので、参考値です)。
| データセット | 指標 | Julia 1(今回) | Jev(記録) |
|---|---|---|---|
| AG News(4択) | 正解率 | 94% | 91% |
| 間違い5%以内で自動化できる割合 | 97% | 83% | |
| 処理時間の中央値 | 18ミリ秒(手元の CPU) | 256ミリ秒(ネット経由) | |
| DAIR Emotion(6択) | 正解率 | 86% | 48% |
| 間違い5%以内で自動化できる割合 | 72% | 0% | |
| 平均の自信(確率の最大値) | 98.4% | 81.9% | |
| Banking77(72択) | 正解率 | 61% | 87% |
| 間違い5%以内で自動化できる割合 | 1% | 86% | |
| 処理時間の中央値 | 143ミリ秒(5回呼び出し) | 246ミリ秒 |
4択・6択では、Julia 1 は正解率だけでなく、確率の信頼性でも Jev の記録を上回りました。一方で気になるのは、Emotion で正解率 86% なのに平均の自信が 98.4% もある点です。当たる割合より自信の方が高い、つまり自信過剰の傾向があります。72択ではその傾向がさらに強く、確率の高さを頼りに自動化できる範囲がほとんどありませんでした。
処理時間は、手元の CPU とネット経由の API という違いがあるので単純には比べられません。それでも、1件 18ミリ秒で判定が終わるのは、画面の操作に合わせて判定を差し込むような用途では大きな利点です。
実測3: 日本語で使えるか
多言語テスト MASSIVE: 公式の数字が再現できない
公式の README には、スマートスピーカーへの話しかけ(「明日7時に起こして」など)を 18 のジャンルに分ける MASSIVE というテストで、英語 86.75%、日本語 82.25% という数字があります。日本語でも使えそうに見えるので、手元で確かめました。
ところが、このテストで使った質問文と選択肢の書き方は公開されていません。そこで、自然な書き方を 5 通り用意して試しました(18 ジャンル名そのもの、説明文、BTZSC 風の文など)。結果が次のグラフの右側です。

公式の手順があるテストは再現できました。書き方を自分で決めた MASSIVE だけ、大きく下がっています。
| MASSIVE の条件 | 英語 | 日本語 |
|---|---|---|
| 公式の数字(書き方は非公開) | 86.75% | 82.25% |
| 自作の説明文つき選択肢(全2,974問) | 41.1% | 35.9% |
| 5通りのうち最も良い書き方(300問の抽出) | 55.0% | 52.7% |
最も良い書き方でも、公式の数字から 30 ポイント前後低くなりました。間違いを見ると「ニュース」と「アラーム」に答えが大きく偏っていました。公式は検証記録に MASSIVE の各言語の項目を持っているので、決まった書き方で練習している可能性があります(推測)。公式の数字は、公式と同じ書き方をした場合の上限に近い値と考えておくのが安全です。
自作の日本語問い合わせ 48 件
より実務に近い形で試すため、通販サイトへの問い合わせを想定した日本語の文を 48 件作りました。1件ごとに次の 3 つの正解を付けています(文と正解は付録のスクリプトに全件載せています)。
- 担当チーム(請求・配送・返品・アカウント・商品の質問・キャンセルの6択)
- 返金を求めているか(はい/いいえ)
- 今日中の対応が必要か(はい/いいえ)
同じ問題を、質問文と選択肢を日本語で書いた場合と、英語で書いた場合の 2 通りで解かせました。
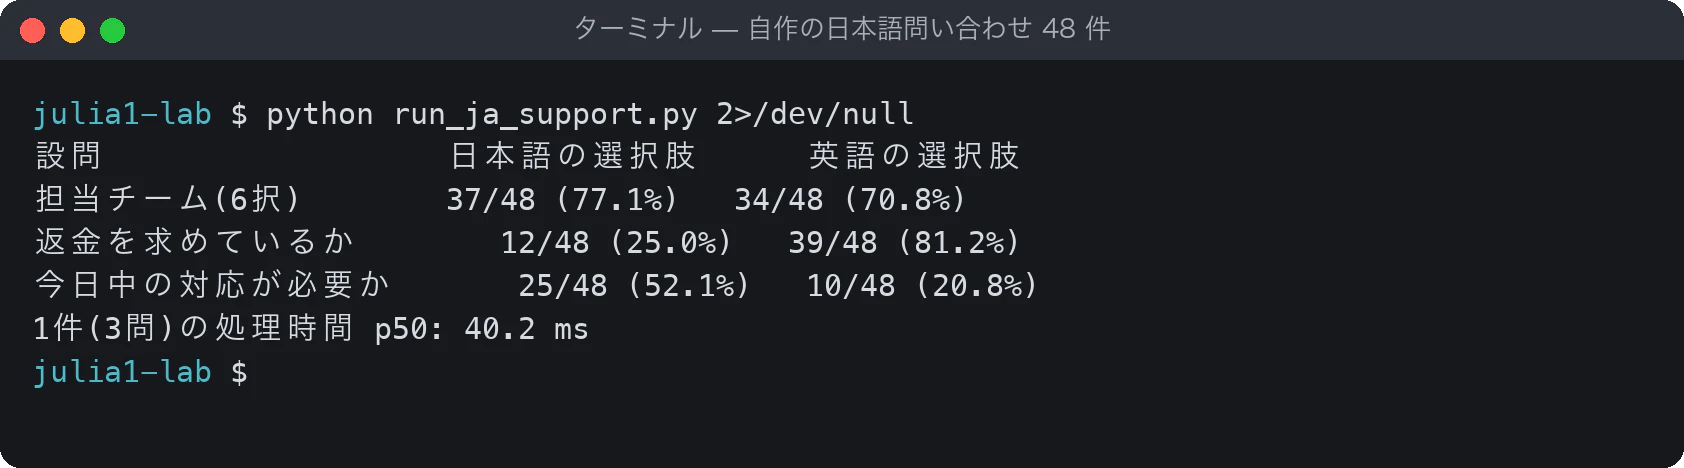
6択の振り分けは 7〜8 割。はい/いいえ の判定は、言語によって結果が極端に変わりました。
**担当チームの振り分け(6択)**は、日本語の選択肢で 77.1%(48件中37件)でした。間違えたのは「この電気ケトルは海外の電圧でも使えますか」を配送に、「黒のMサイズの再入荷予定はありますか」を返品に、といった、キーワードに引きずられたものが中心です。
実用面で注目したいのは、間違えた 11 件がすべて確率 0.8 未満だったことです。確率のしきい値を決めて、それ未満は人に回すと、次のようになりました。
| しきい値 | 自動で処理した件数 | そのうち正解 |
|---|---|---|
| なし | 48件 | 37件(77.1%) |
| 0.7 以上 | 34件 | 33件(97.1%) |
| 0.8 以上 | 31件 | 31件(100%) |
| 0.9 以上 | 27件 | 27件(100%) |
48件という小さなテストで、しきい値も同じデータで選んでいるため、楽観的な数字です。それでも「自信があるときだけ任せ、残りは人が見る」という使い方なら、日本語でも十分に役立つ手応えがありました。
はい/いいえ の判定は要注意
一方、はい/いいえ(noul)の判定は不安定でした。日本語で「返金を求めている」と聞くと、48件中36件の「求めていない」文にまで「はい」と答え、正解率は 25% でした。英語で聞くと 81.2% に上がりますが、今度は「今日中の対応が必要か」を英語で聞くと、48件すべてに「はい」と答えて 20.8% に下がります。
しきい値 0.5 の良し悪しを切り離すため、「当てはまる文に、当てはまらない文より高い確率を付けられているか」を表す AUC という指標でも調べました。0.5 が当てずっぽう、1.0 が完璧です。
説明文がないと、どの設問も当てずっぽう以下になりました。日本語の「返金」は説明文があっても当てずっぽう並みです。
分かったことは 2 つです。
-
選択肢に説明文を付けないと使えない:
true/falseだけで聞くと、AUC は 0.31〜0.45 と当てずっぽうを下回りました。公式の 2,000問テストで説明文を外すと noul が 80.5% から 65.2% に落ちたのと同じ傾向です - 日本語の「返金」は説明文があっても判別できなかった: AUC 0.47 で、確率の順位自体が当てになりません。一方、英語の説明文なら 0.78 あり、しきい値を調整すれば使える余地があります
はい/いいえ を日本語で判定したい場合は、「返金を求めている / 求めていない」という 2 択の choice として聞き直す、英語の説明文にする、といった工夫を自分のデータで試してから使うのがおすすめです。
速度とメモリ
公式ブログの Apple M4 と同じ条件(100語の文、4択)で、1件ずつ処理した場合と16件まとめた場合を測りました。
| 条件 | 公式(Apple M4) | 今回(M5 Max) |
|---|---|---|
| 1件ずつ(中央値) | 33.15ミリ秒 | 18.6ミリ秒 |
| 1件ずつ(95%の件が収まる時間) | 44.23ミリ秒 | 23.8ミリ秒 |
| 16件まとめて処理 | 51.2件/秒 | 94.3件/秒 |
| モデルの読み込み | ― | 2.2〜2.4秒(インストール直後の初回は4.0秒) |
| メモリ(最大) | 370.6MB(処理後の値) | 約1.07GB(読み込み時を含む最大値) |
CPU のスレッド数を 4・8・12 と変えても、速さはほとんど変わりませんでした。1件ずつなら 1 秒に約 50 件、まとめて渡せば約 94 件を判定できます。なお、Apple の GPU(device="mps")を指定するとエラーになりました。この点はトラブルシューティングで扱います。
Jev の応答時間は、jev-benchmarks の記録(フランスからの呼び出し)で中央値 236〜256ミリ秒、typed-decisions の記録では 1ケース(5問)あたり 710ミリ秒です。ネットワークの往復を含むので、手元で動く Julia 1 の方が一桁速いのは当然とも言えます。速さが必要な場面では、これが Julia 1 を選ぶ一番の理由になります。
どちらを選ぶか
ここまでの結果から、どちらを試すかの目安をまとめました。上から順に当てはめてください。

どちらを選ぶ場合も、自分の業務の問題で測り直すことが前提です。
- データを社外に出せない、ネットなしで動かしたい: Julia 1 の一択です。CPU だけで完結し、料金もかかりません
- 選択肢が 20 を超える、細かいラベルが多い: Jev を優先します。72択で 87% 対 61〜64% という差は、絞り込みの工夫では埋まりませんでした
- 日本語の「はい/いいえ」が中心: 今回の設問では Julia 1 は当てずっぽう並みでした。2択の choice に言い換えるなど、確認してから使います
- 20択以内の分類・振り分けが中心: 両方を同じ問題で比べる価値があります。Julia 1 は無料で何度でも試せるので、まず Julia 1 で自分のデータの正解率を出し、足りなければ Jev と比べる、という順番が効率的です
応用: 自分のデータで正解率を測る
判定モデルの精度は、質問文と選択肢の書き方で大きく変わることが分かりました。公式の数字より、自分の業務の数字の方がずっと参考になります。そこで、CSV を用意するだけで正解率を測れるスクリプトを作りました。
用意するのは 2 つのファイルです。
my_cases.csv(1行目は見出し。text が問い合わせ文、label が正解のID)
text,label
同じ注文でクレジットカードに2回請求されています。確認してください。,billing
注文から10日たっても商品が届きません。今どこにありますか。,shipping
{
  "billing": "請求・支払い(二重請求、決済、領収書、クーポンの割引)",
  "shipping": "配送(届かない、配達日時、届け先、誤配送)",
  "account": "アカウント(ログイン、パスワード、登録情報、不正ログイン)"
}
スクリプト本体です。正解率に加えて、「確率 0.9 以上なのに外した件数」と、よくある取り違えを表示します。
# eval_my_csv.py — 自分の CSV で Julia 1 の正解率を測る
import argparse
import csv
import json
from collections import Counter

from julia import load_model


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("csv_path")        # text,label の2列
    ap.add_argument("labels_json")     # {"ID": "説明文", ...} 2〜20個
    ap.add_argument("--question", required=True)
    ap.add_argument("--model", default="Julia-1")
    args = ap.parse_args()

    labels = json.load(open(args.labels_json, encoding="utf-8"))
    rows = list(csv.DictReader(open(args.csv_path, encoding="utf-8")))
    engine = load_model(args.model, device="cpu", strict_encoding=True,
                        max_length=8192, head_length=512)
    question = {"q": {"type": "choice", "instructions": args.question,
                      "criteria": labels}}

    hits, confident_miss, mistakes = 0, 0, Counter()
    for r in rows:
        ans = engine.predict(state=r["text"], questions=question)["answers"]["q"]
        ok = ans["choice"] == r["label"]
        hits += ok
        if not ok:
            mistakes[(r["label"], ans["choice"])] += 1
            confident_miss += ans["max_probability"] >= 0.9  # 自信満々で外した
    n = len(rows)
    print(f"正解率: {hits}/{n} ({hits / n:.1%})")
    print(f"確率 0.9 以上で外した件数: {confident_miss}")
    print("よくある取り違え(正解 → 予測):")
    for (gold, pred), c in mistakes.most_common(5):
        print(f"  {gold} → {pred}: {c} 件")


if __name__ == "__main__":
    main()
# Julia-1 フォルダーがある場所で実行する
python eval_my_csv.py my_cases.csv labels.json --question "この問い合わせを担当するのはどのチームですか。"
今回の 48 件で実行すると、次のように表示されました。
正解率: 37/48 (77.1%)
確率 0.9 以上で外した件数: 0
よくある取り違え(正解 → 予測):
  product → shipping: 3 件
  shipping → returns: 2 件
  product → returns: 2 件
  shipping → billing: 1 件
  account → shipping: 1 件
取り違えが多い組み合わせが分かったら、その選択肢の説明文を書き足して、もう一度測ります。たとえば「商品の質問」の説明に「電圧・対応機器・食洗機対応などの仕様」と具体例を足す、という具合です。説明文を変えるたびに測り直せるのが、無料で手元で動くモデルの強みです。
トラブルシューティング
今回の検証で実際に出たエラーと、つまずきやすい点をまとめます。確認する順番は図のとおりです。

上から順に、表示されたエラー文で当てはまる行を探してください。
| 症状・エラー文 | 原因 | 対処 |
|---|---|---|
editable mode currently requires a setuptools-based build |
Mac 標準の Python 3.9 と古い pip を使っている |
python3.12 -m venv .venv で仮想環境を作り直す |
Checkpoint contains Git LFS pointers; fetch the real model weights first |
重みが本体ではなく、Git LFS の目印ファイルになっている |
snapshot_download で取り直す。du -sh Julia-1/model.safetensors が 550M 前後か確認 |
RuntimeError: Passed CPU tensor to MPS op |
Apple の GPU(device="mps")は非対応 |
device="cpu" に戻す |
options must contain 2–20 nonempty rendered descriptions |
選択肢が21個以上、または空の説明がある | 予選→決勝に分ける、大分類→小分類の2段にする |
| はい/いいえ がほぼ全部「はい」になる | 説明文がない、しきい値 0.5 が合っていない |
false/true に説明文を付ける。しきい値を自分のデータで決める。2択の choice に言い換える |
| 公式よりずっと低い正解率 | 質問文・選択肢の書き方の違い | まず reproduce_typed.py で 72.55% が出るか確認。出るなら環境は正常で、書き方を見直す |
Apple の GPU を指定したときの実際の表示です。
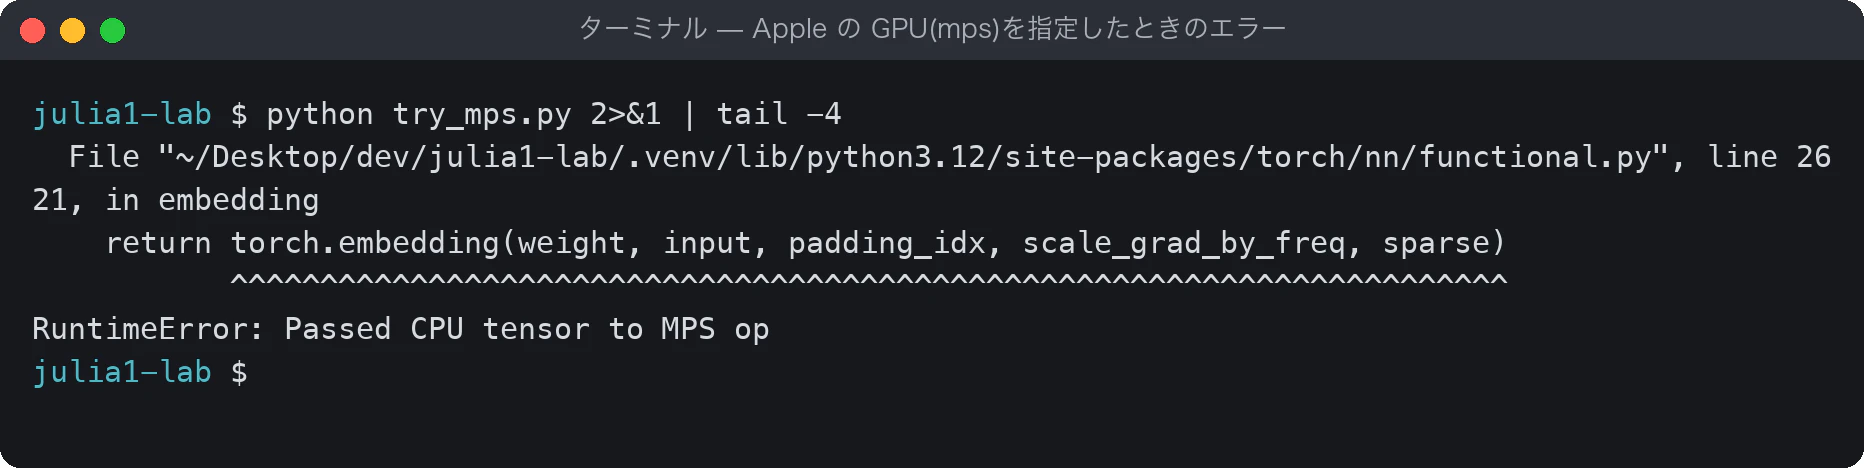
README に書かれている対応先は CPU と CUDA(NVIDIA の GPU)だけです。Mac では CPU で動かします。
まとめ
Julia 1 と Jev を、公式の数字と手元の実測の両方から比べました。
- ベンチマークの差: 2,000問の typed-decisions では互角(73.15%・72.55% 対 72.70%)。4択・6択の小テストは Julia 1 が上だが、同じ日・同じ条件の比較ではない。72択の細かい分類は Jev が圧倒的に上(87% 対 61〜64%)
- 再現性: 公式の手順があるテストは、手元の Mac でもほぼ同じ数字が出た。2,000問は公式の CPU 再測定と完全に一致した
- 日本語: 6択の振り分けは 77%。確率 0.8 以上だけ採用すれば 31/48 件を全問正解で処理できた。はい/いいえ の判定は、日本語では当てずっぽう並みだった
- 速さ: M5 Max の CPU で1件 約19ミリ秒、まとめれば毎秒94件。ネットも GPU も要らない
Julia 1 は「Jev の完全な代わり」ではありませんが、選択肢が少ない振り分けを、手元で・無料で・速く試せる判定モデルとしては十分に使えます。次の一歩としては、自分の業務の問い合わせを 50〜100 件集めて、この記事の eval_my_csv.py で正解率と取り違えの傾向を測ってみてください。Jev の早期アクセスが使えるなら、同じ問題を Jev にも解かせて並べると、どちらを使うべきかがはっきりします。
付録: 今回使ったスクリプト
本文で使ったスクリプトのうち、再現に必要なものを載せます。どれも Julia-1 と同じ仮想環境で実行しました。
show_typed.py(2,000問の結果を表にする)
"""reproduce_typed.py の results.json を表にする(Jev の 72.70% と並べる)。"""
import json, sys
r = json.load(open(sys.argv[1]))
bt = r["original_criteria"]["by_type"]
tot_c = sum(v["correct"] for v in bt.values()); tot_n = sum(v["count"] for v in bt.values())
print(f"device={r['device']}  threads={r['threads']}  torch={r['torch']}  weights={r['weights_sha256'][:12]}")
for k in ("choice", "noul", "score"):
    v = bt[k]; print(f"  {k:<7} {v['correct']:>4} / {v['count']:<4}  {v['correct']/v['count']:.2%}")
print(f"  {'合計':<6} {tot_c:>4} / {tot_n:<4}  {tot_c/tot_n:.2%}   (Jev 参照値 72.70%)")
72択の予選→決勝(run_btzsc_pilot.py の中心部分)
import math

QUESTION = "Which single label best describes the input text?"


def softmax(xs):
    m = max(xs)
    w = [math.exp(x - m) for x in xs]
    s = sum(w)
    return [x / s for x in w]


def classify(engine, text, labels, group=18, keep=4):
    """20択以下なら1回で、それを超えたら 18択の予選 → 上位4件ずつで決勝。"""
    row = {"state": {"text": text}, "question": QUESTION, "type": "choice"}
    if len(labels) <= 20:
        return softmax(engine.logits([dict(row, options=list(labels))])[0])
    groups = [list(range(i, min(i + group, len(labels)))) for i in range(0, len(labels), group)]
    scores = engine.logits([dict(row, options=[labels[k] for k in g]) for g in groups])
    finalists = []
    for g, s in zip(groups, scores):
        top = sorted(range(len(g)), key=lambda j: s[j], reverse=True)[:keep]
        finalists.extend(sorted(g[j] for j in top))
    final = softmax(engine.logits([dict(row, options=[labels[k] for k in finalists])])[0])
    probs = [0.0] * len(labels)  # 予選で落ちた選択肢の確率は 0
    for k, p in zip(finalists, final):
        probs[k] = p
    return probs
engine は load_model("Julia-1", device="cpu", strict_encoding=True, max_length=1024, head_length=512, marker_only_head=False) で作りました。公式の再現スクリプトと同じ設定です。
ja_support_cases.py(日本語の問い合わせ48件と正解。実測3で使用)
各行は「問い合わせ文、担当チーム、返金を求めているか、今日中の対応が必要か」です。正解は筆者が付けたもので、特に「今日中の対応」は判断が分かれうる点に注意してください。
"""日本語の問い合わせ振り分けテスト(自作 48 件)。

各文に正解を 3 つ付けた:
  team   : 6 択(billing / shipping / returns / account / product / cancel)
  refund : 返金を求めているか(True / False)
  urgent : 今日中の対応が必要か(True / False)… 不正利用・二重請求・ログイン不可・誤配送の食品など
"""

CASES = [
    # billing
    ("同じ注文でクレジットカードに2回請求されています。確認してください。", "billing", True, True),
    ("先月の利用明細に身に覚えのない3,980円の引き落としがあります。", "billing", True, True),
    ("コンビニ払いを選んだのですが、払込票の番号が届きません。", "billing", False, False),
    ("領収書の宛名を会社名に変更して再発行できますか。", "billing", False, False),
    ("ポイントが使われず、全額カードで決済されていました。差額を戻してほしいです。", "billing", True, False),
    ("支払い方法を銀行振込から後払いに変えたいです。", "billing", False, False),
    ("クーポンコードを入れたのに割引が反映されていない金額で請求されました。", "billing", True, False),
    ("請求書払いの締め日と支払期限を教えてください。", "billing", False, False),
    # shipping
    ("注文から10日たっても商品が届きません。今どこにありますか。", "shipping", False, False),
    ("追跡番号を入れても「該当なし」と表示されます。", "shipping", False, False),
    ("配達日時を土曜の午前に変更したいです。", "shipping", False, False),
    ("届いた箱に入っていたのは他人宛ての冷凍食品でした。すぐ回収してください。", "shipping", False, True),
    ("引っ越したので、発送前の注文の届け先住所を変えられますか。", "shipping", False, False),
    ("置き配にしたのに不在票が入っていました。", "shipping", False, False),
    ("離島への送料はいくらかかりますか。", "shipping", False, False),
    ("明日のイベントで使うので、今日中に発送してもらうことはできますか。", "shipping", False, True),
    # returns
    ("サイズが合わなかったので、Lサイズと交換したいです。", "returns", False, False),
    ("届いたマグカップが割れていました。返品して代金を返してください。", "returns", True, False),
    ("イメージと色が違ったので返品したいのですが、送料はかかりますか。", "returns", False, False),
    ("返品した商品の返金がまだ口座に入っていません。", "returns", True, False),
    ("開封済みのイヤホンでも初期不良なら交換できますか。", "returns", False, False),
    ("返品用の着払い伝票を送ってください。", "returns", False, False),
    ("セット商品のうち1点だけ返品することはできますか。", "returns", False, False),
    ("不良品だったので新品と交換ではなく全額返金を希望します。", "returns", True, False),
    # account
    ("パスワードを何度入れてもログインできません。", "account", False, True),
    ("登録したメールアドレスを変更したいです。", "account", False, False),
    ("知らない端末からログインされたという通知が来ました。乗っ取りでしょうか。", "account", False, True),
    ("二段階認証の確認コードがSMSで届きません。", "account", False, True),
    ("会員ランクがいつ更新されるのか知りたいです。", "account", False, False),
    ("アカウントを家族と共有しても規約上問題ないですか。", "account", False, False),
    ("ログインすると毎回エラー画面になり、注文履歴が見られません。", "account", False, True),
    ("ニックネームの変更方法を教えてください。", "account", False, False),
    # product
    ("このスニーカーは幅広の足でも履けますか。", "product", False, False),
    ("黒のMサイズの再入荷予定はありますか。", "product", False, False),
    ("この電気ケトルは海外の電圧でも使えますか。", "product", False, False),
    ("商品ページの素材表記は綿100%ですが、洗濯機で洗えますか。", "product", False, False),
    ("このバッテリーは飛行機に持ち込めますか。", "product", False, False),
    ("子ども用の食器は食洗機に対応していますか。", "product", False, False),
    ("型番AB-200と AB-300 の違いを教えてください。", "product", False, False),
    ("この化粧水はアレルギーテスト済みですか。", "product", False, False),
    # cancel
    ("さっき注文した商品をキャンセルしたいです。まだ発送前ですよね。", "cancel", False, True),
    ("定期便を来月から止めたいです。", "cancel", False, False),
    ("有料会員を退会したいです。今月分の会費は日割りで戻りますか。", "cancel", True, False),
    ("間違えて同じ商品を2個注文したので、1個取り消してください。", "cancel", False, True),
    ("サブスクの自動更新をオフにする方法を教えてください。", "cancel", False, False),
    ("予約注文を取り消したら、支払ったお金は返ってきますか。", "cancel", True, False),
    ("退会するとポイントはどうなりますか。", "cancel", False, False),
    ("注文を取り消して、代わりに別の色で注文し直したいです。", "cancel", False, False),
]

TEAMS_JA = {
    "billing": "請求・支払い(二重請求、決済、領収書、クーポンの割引)",
    "shipping": "配送(届かない、配達日時、届け先、誤配送)",
    "returns": "返品・交換(不良品、サイズ交換、返品の返金)",
    "account": "アカウント(ログイン、パスワード、登録情報、不正ログイン)",
    "product": "商品の質問(仕様、在庫、使い方、素材)",
    "cancel": "キャンセル・解約(注文の取り消し、定期便の停止、退会)",
}
TEAMS_EN = {
    "billing": "Billing and payments (double charges, payment methods, receipts, coupons)",
    "shipping": "Shipping and delivery (late parcels, delivery time, address, wrong delivery)",
    "returns": "Returns and exchanges (defects, size exchange, refunds for returned items)",
    "account": "Account access (login, password, profile, suspicious login)",
    "product": "Product questions (specs, stock, usage, materials)",
    "cancel": "Cancellation (cancel orders, stop subscriptions, close membership)",
}
この48件を engine.predict(state=文, questions={...}) に渡し、担当チームは choice、返金と今日中の対応は noul(確率 0.5 以上を「はい」)として正解と比べました。質問文と選択肢の説明文は、日本語版なら TEAMS_JA と「お客様は返金を求めている。」「今日中に対応する必要がある。」、英語版なら TEAMS_EN と同じ意味の英文です。
参考リソース
- SupersonicLabs/Julia-1(Hugging Face) — 重み・コード・評価結果・検証記録
- Julia 1 の公式ブログ(Supersonic Labs) — CPU 再測定、端末ごとの速度、開発の経緯
- SupersonicLabs/Julia-1-ONNX(Hugging Face) — ブラウザ(WebGPU)で動かす版
- Introducing System One Models & Jev(TypeSafe AI) — Jev の料金・応答時間・選択肢の上限
- AbdelStark/jev-benchmarks — Jev の 300問の測定記録と手順
- LocalLLaMA/typed-decisions(Hugging Face) — 2,000問のデータと、Jev の測定記録・基準値
- btzsc/btzsc(Hugging Face) — AG News・Emotion・Banking77 の問題の元データ
- mteb/amazon_massive_scenario(Hugging Face) — MASSIVE の日本語・英語テストに使ったデータ
- jhu-clsp/mmBERT-small(Hugging Face) — Julia 1 の元になった多言語モデル