
この記事の確認範囲
- 確認日: 2026年10月1日。CoreWeave Forge の公式発表(2026年9月30日)、製品ページ、料金ページ、開発者ドキュメントを読み、Free プランのアカウントで実際に動かしました
- 検証環境: macOS の MacBook Pro、Python 3.12、
weave0.53.11、claude-agent-sdk0.2.163、wandb0.30.0、Claude Code 2.1.280(Max プランのログイン) - 試したこと: 問い合わせ振り分けエージェントを 20 件動かして Trace を送り、失敗を見つけ、評価データセットを作り、採点し、プロンプトを直して同じデータで再評価するまで。すべて Free プランの範囲です
- 試していないこと: Serverless RL / SFT / 蒸留、CoreWeave 上の推論、Sandboxes、Notebooks。Free でも従量課金になる部分なので、今回は手を付けていません
- 料金や画面は変わる可能性があります。数字は本文中に出典を書いています
はじめに:「Trace は貯めている」の先に何があるか
AI エージェントを本番で動かしていると、ログや Trace(1回の処理で何を考え、どのツールを呼び、何を返したかの記録)は自然と溜まっていきます。ところが、その失敗をどう次に活かすかは、意外と仕組み化されていません。失敗を目で探し、別の道具に貼り付けて評価データを作り、プロンプトを直し、また本番で様子を見る。多くの現場では、この往復がコピー&ペーストでつながっています。
2026年9月30日、GPU クラウドの CoreWeave が「CoreWeave Forge」を公開しました。Run(動かす)→ Observe(観る)→ Curate(選ぶ)→ Improve(直す)→ Evaluate(評価する)を一つの環境でつなぐ、というのが売り文句です。買収した Weights & Biases(実験管理・LLM 評価ツール)、OpenPipe(ファインチューニング・強化学習)、marimo(OSS のノートブック)を、自社の GPU 基盤の上でまとめ直した製品群と言えます。
ただ、「ループを一つにする」という話は、実際に手を動かすまでピンときません。この記事では、Free プランのアカウントを作り、小さなエージェントで「本番の失敗 → 評価データ → 修正 → 再評価」を一周してみました。何が無料で、どこから有料で、どこでつまずくかを、実際の画面と数字で書いていきます。
想定読者は、LLM を使ったアプリやエージェントを作っていて、評価や観測の道具を一つ決めたい人です。Weights & Biases を使ったことがなくても読めるように、用語には短い説明を添えています。
まず、「これまで」と「Forge の考え方」の違いを図で押さえておきます。左が多くの現場の現状、右が Forge が目指す形です。
図1:右側のうち、今回 Free プランで実際に回したのは Trace・Dataset・Evaluation・プロンプト修正の部分です(静止画は 静止画)。
CoreWeave と Forge の位置づけ
CoreWeave はどんな会社か
CoreWeave は AI 向けに特化したクラウド事業者です。NVIDIA の GPU を大量に確保してデータセンターを運営し、学習や推論の計算資源を企業に貸しています。AWS や Azure のような汎用クラウドに対して、GPU 計算に絞った「ネオクラウド」と呼ばれる分野の代表格で、2025年3月に NASDAQ へ上場しました(ティッカー CRWV)。
創業は2017年。Michael Intrator 氏(現 CEO)、Brian Venturo 氏、Brannin McBee 氏の3人で、いずれも元はコモディティのトレーダーです。創業時の社名は Atlantic Crypto で、GPU によるイーサリアムのマイニングが事業でした。暗号資産市場の下落を機に、手元の GPU をクラウドとして貸す事業へ転換し、生成 AI ブームで急成長したという経緯があります。
一般消費者向けのサービスはないため世間での知名度は高くありませんが、OpenAI や Microsoft、Meta などと大型の計算資源契約を結んでおり、AI 業界ではよく知られた会社です。一方で、GPU 調達のための多額の負債や、少数の大口顧客への依存がリスクとして指摘されることも多い会社です。
Forge は何をまとめたものか
公式発表によると、Forge は Weights & Biases Models、OpenPipe のポストトレーニング技術、marimo を、CoreWeave の推論・学習・サンドボックス基盤と一つにしたものです。発表ページの冒頭を撮影したものがこちらです。
図2:公式発表(coreweave.com/news、2026年9月30日公開)。
製品ページには「The AI Loop」として、Run・Observe・Curate・Improve・Evaluate の5段階が示されています。
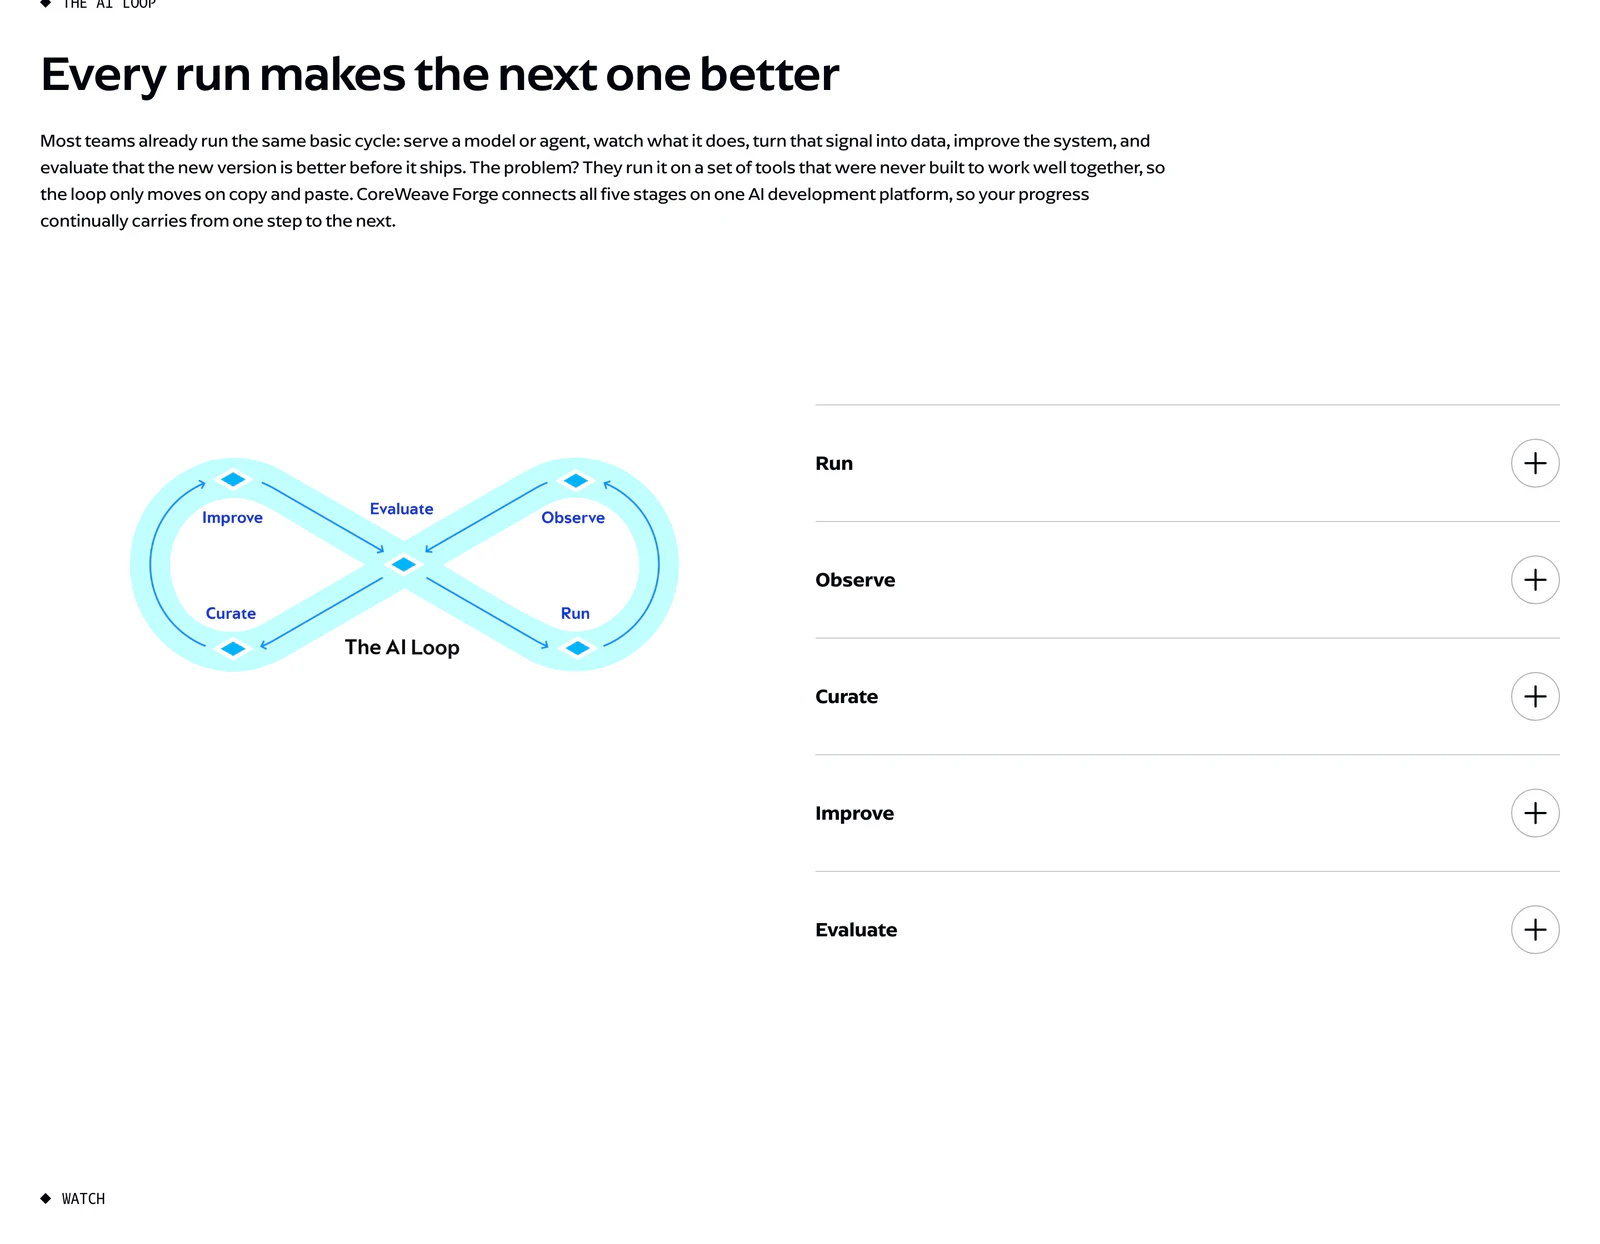
図3:製品ページ(coreweave.com/forge)のループ図。
製品の一覧は4グループに分かれています。学習(W&B Models、Serverless SFT、Serverless RL、Model Distillation)、道具(ARIA、Registry、Notebooks)、推論(Serverless Inference、Dedicated Inference)、エージェント開発(Agent Lens、Sandboxes)です。
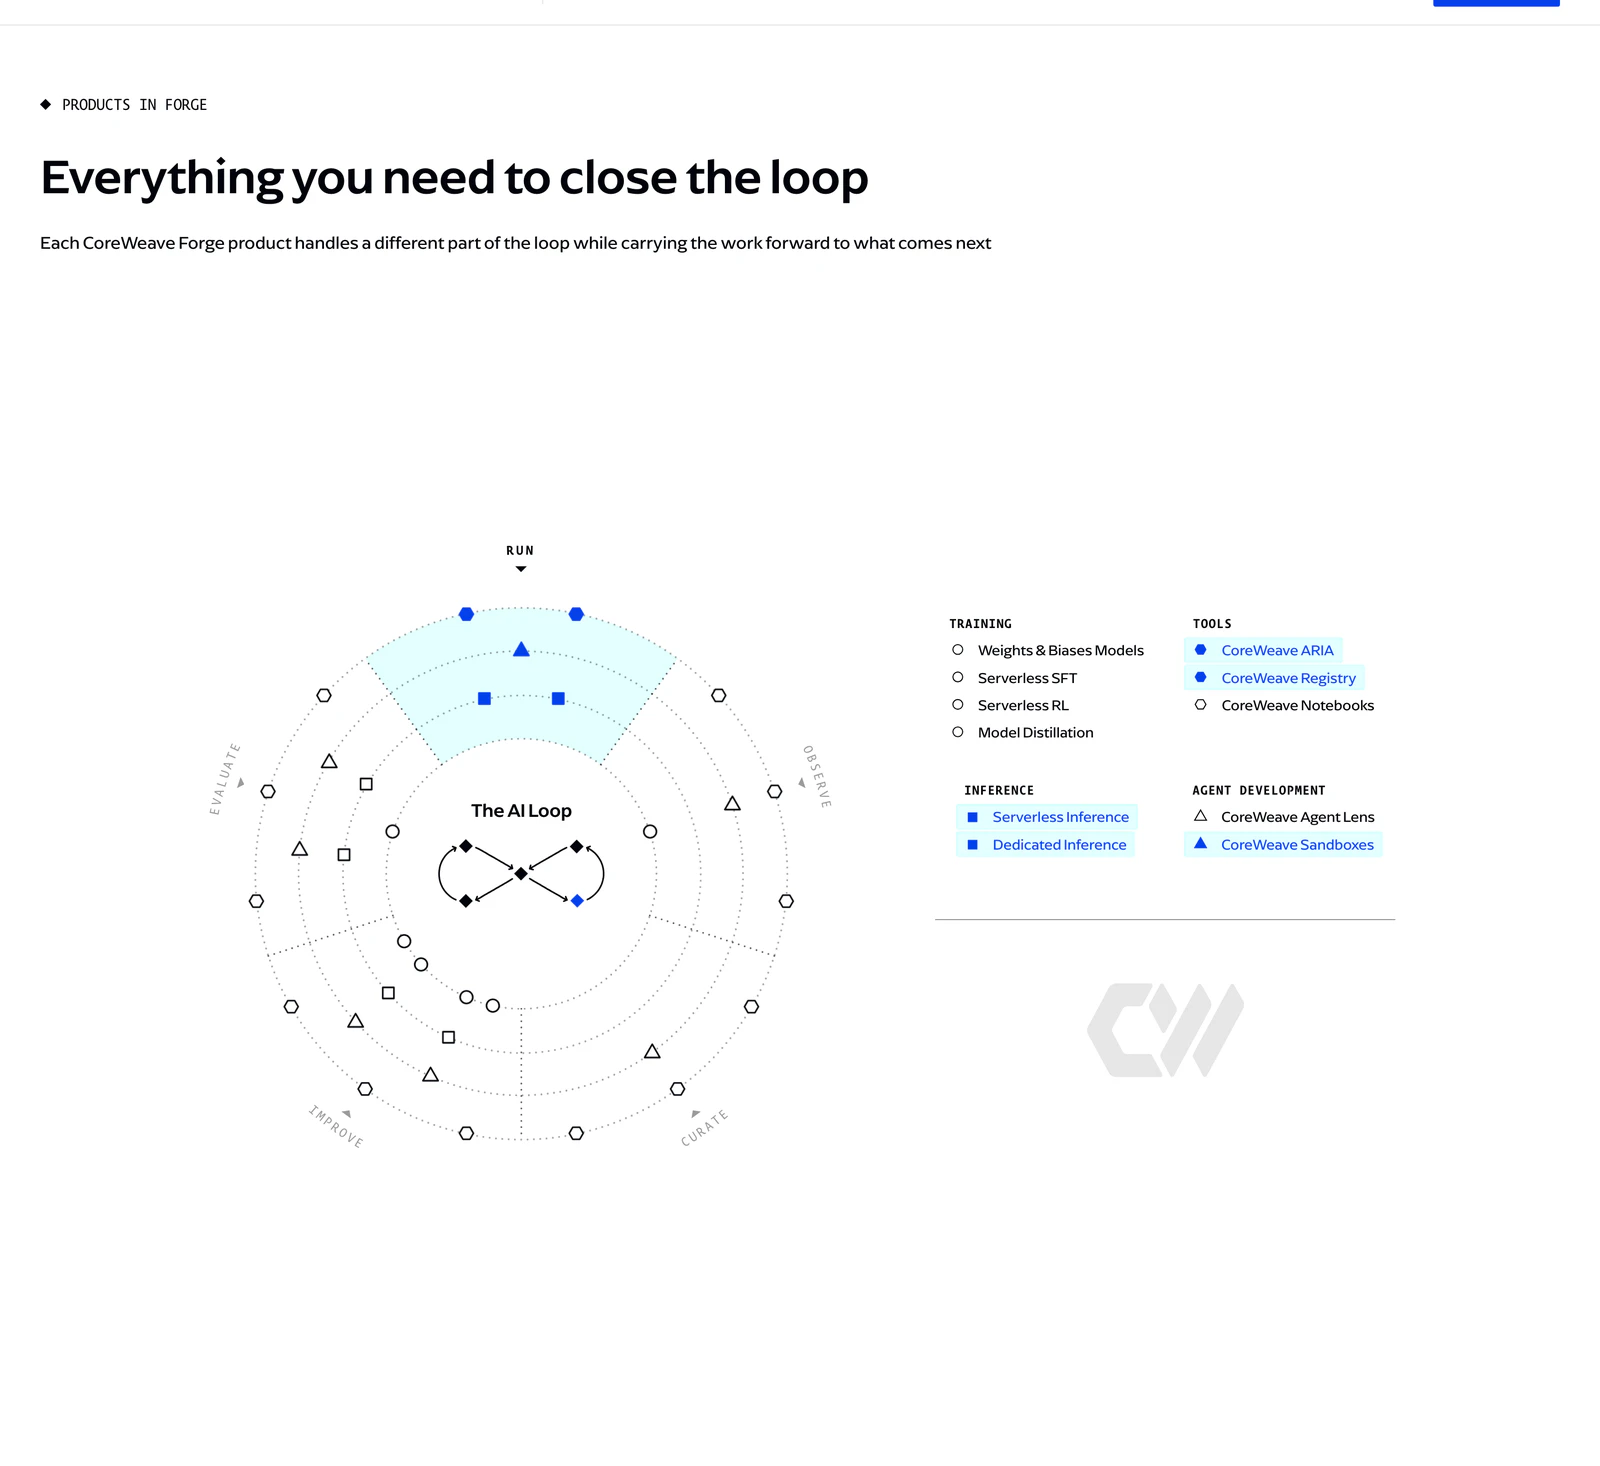
図4:製品一覧(coreweave.com/forge)。発表時点で「一般提供」と明記されているのは ARIA と Sandboxes です。
公式発表には、Agent Lens が一般的なフロンティア LLM による解析と比べて「重大な失敗を 20% 多く検知し、修正コストは10分の1」、Serverless RL は自前構築比で「1.4 倍高速、40% 低コスト」という数字があります。どちらも CoreWeave 自身のベンチマークで、方法は公開されていません。この記事では、その検証はしていません。
各製品が Free でどこまで使えるか
公式の料金ページと、ログイン後に表示されたプラン選択画面をもとに、製品ごとに「Free 内で無料」「Free でも従量課金」「今回は未確認」に分けたのが次の図です。
図5:Free プランで触れる範囲の整理(静止画は 静止画)。
要点は3つです。観測と評価(Weave、Agent Lens、Scorer、Dataset、Registry)は Free に含まれます。学習(SFT、RL、蒸留)と CoreWeave 上の推論、Sandboxes は Free でも従量課金です。ARIA は「期間限定で無料」です。
料金プランと、ログイン直後に出た「トライアル終了」画面
公式の料金ページ
料金ページ(coreweave.com/forge-pricing)の内容を表にまとめます。
| 項目 | Free | Pro | Enterprise |
|---|---|---|---|
| 基本料金 | $0/月 | $60/月から(月払い) | 個別見積もり |
| 位置づけ | 個人の AI アプリ・モデル開発 | 従業員 50 人未満の初期チーム | セキュリティ・コンプライアンス重視の企業 |
| Model seats | 5 まで | 10 まで | カスタム |
| ストレージ | 5 GB/月 | 100 GB/月(超過 $0.03/GB) | カスタム |
| Weave の取り込み量 | 1 GB/月 | 1.5 GB/月(超過 $0.10/MB) | 超過 $0.20/MB |
| Serverless Inference | 従量課金 | $5/月のクレジット(期間限定) | 込み |
| Sandboxes | 従量課金 | 従量課金 | カスタム |
| ARIA | 期間限定で無料 | 期間限定で無料 | 込み |
| 無料トライアル | なし(常に無料) | 30 日 | なし |
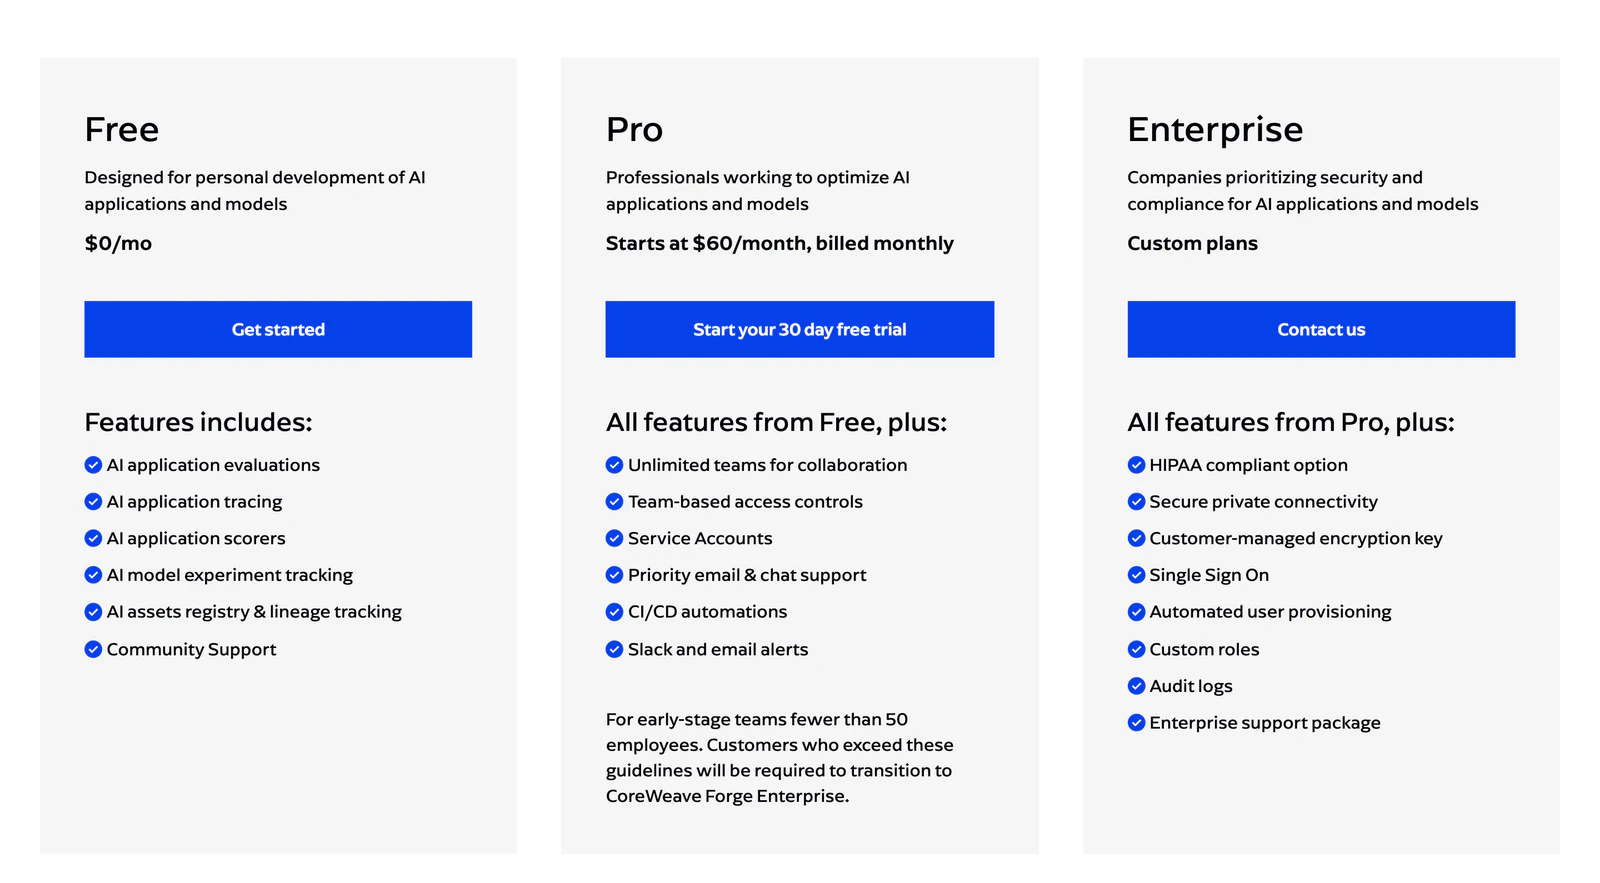
図6:公式料金ページ(2026年10月1日撮影)。
Pro との差は、チーム機能(アクセス制御、Service Account、CI/CD 自動化、Slack 通知)と優先サポートが中心です。個人の検証なら Free で足ります。
ログインしたら「Choose a plan」で止まった
ところが、サインアップしてログインした直後の画面は、製品のホームではなく「Your free trial has expired.」という黄色い帯と「Choose a plan」のプラン選択でした。
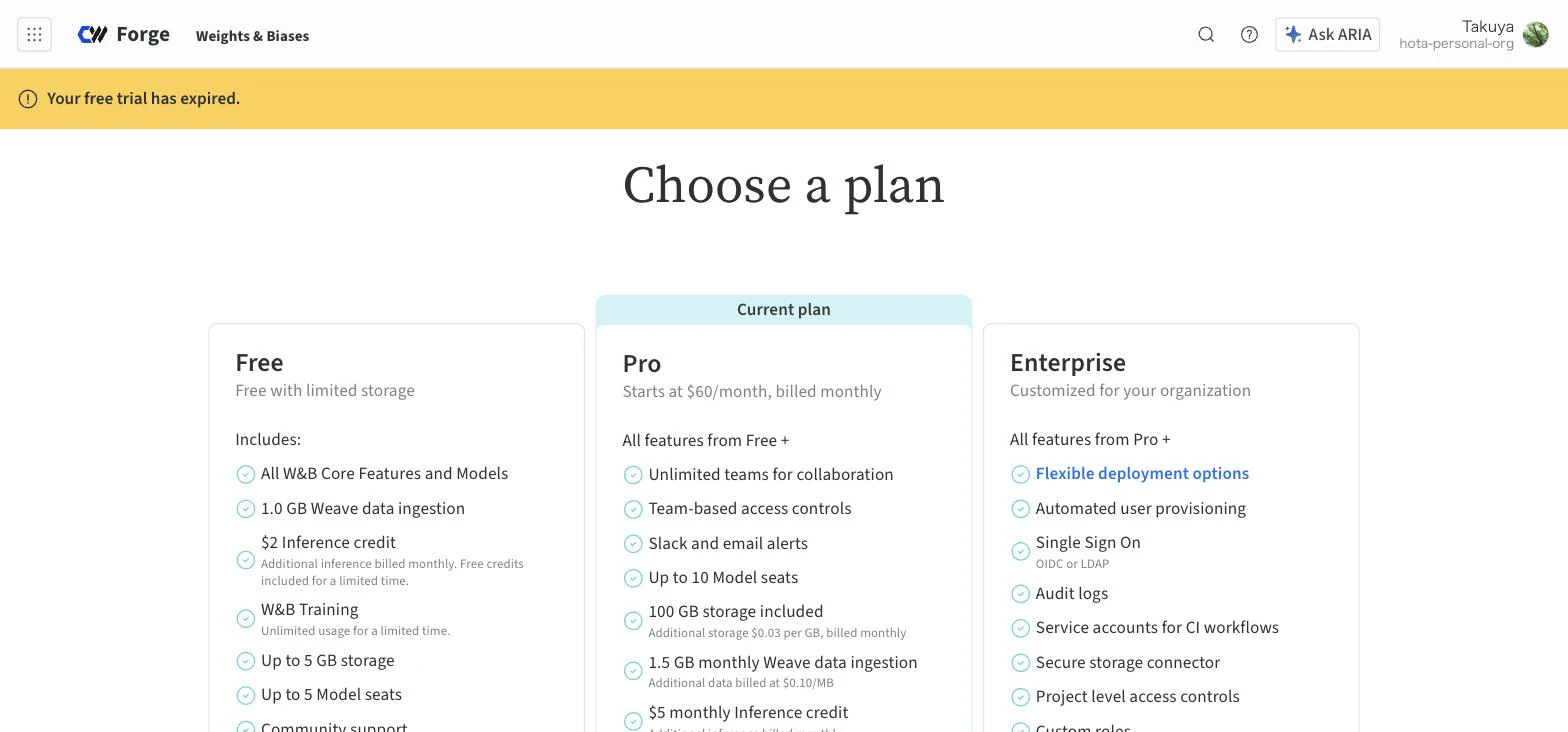
図7:ログイン直後の画面。Pro が「Current plan」になっていて、Free 列の下には「Downgrade」ボタンがあります。
今回のアカウントは Weights & Biases 時代に作られていたものだったようで、「既存の W&B の認証情報がそのまま使える」というサインアップ画面の案内どおりログインできた代わりに、過去の Pro トライアルが終わった状態として扱われました。Free 列の「Downgrade」を押すまで Weave や Agent Lens の画面は開けません。
この画面には、公式料金ページに書かれていない数字が2つ載っていました。Free プランにも「$2 Inference credit」(期間限定)が付くこと、そして「W&B Training Unlimited usage for a limited time」です。Free でどこまで推論が無料かは料金ページから読み取れなかったので、ここで初めて分かりました。
環境構築:手元の Mac から Trace だけを送る構成
構成の考え方
今回は、推論を CoreWeave 上のモデルではなく、手元の Claude Agent SDK で行いました。Claude Agent SDK は Claude Code の CLI を内部で使うため、Claude Max のログインがあれば API キーなしで動き、推論費もかかりません。Forge には Trace だけを送ります。
図8:検証構成(静止画は 静止画)。学習と CoreWeave 上の推論は使っていません。
Trace の送信先は Weave と Agent Lens の2つに見えますが、ドキュメントによれば両者は同じ Trace データを受け取るため、送る側は1か所です。Agent Lens は「Weave の後継」と位置づけられ、移行作業は不要とされています。
手順1:サインアップとログイン
サインアップは id.coreweave.com/signup です。メール、Google、GitHub、Apple、Microsoft のいずれかで登録できます。営業への問い合わせは不要です。
図9:サインアップ画面。既存の Weights & Biases アカウントもそのまま使えます。
ログイン後、forge.coreweave.com/settings#apikeys で API キーを表示し、手元で wandb login を実行して貼り付けます。キーは ~/.netrc に保存されます。
# 検証用フォルダと仮想環境を作る(Python 3.10 以上が必要)
mkdir -p ~/coreweave-forge-lab && cd ~/coreweave-forge-lab
python3.12 -m venv .venv && source .venv/bin/activate

# Weave 本体、Claude Agent SDK、wandb(login コマンドのため)を入れる
pip install "weave[claude-agent-sdk]" claude-agent-sdk wandb

# API キーを登録する(プロンプトにキーを貼り付ける)
wandb login
weave パッケージ単体には wandb コマンドが含まれないため、wandb login を使うなら wandb も入れておきます。環境変数 WANDB_API_KEY を設定する方法でも構いません。
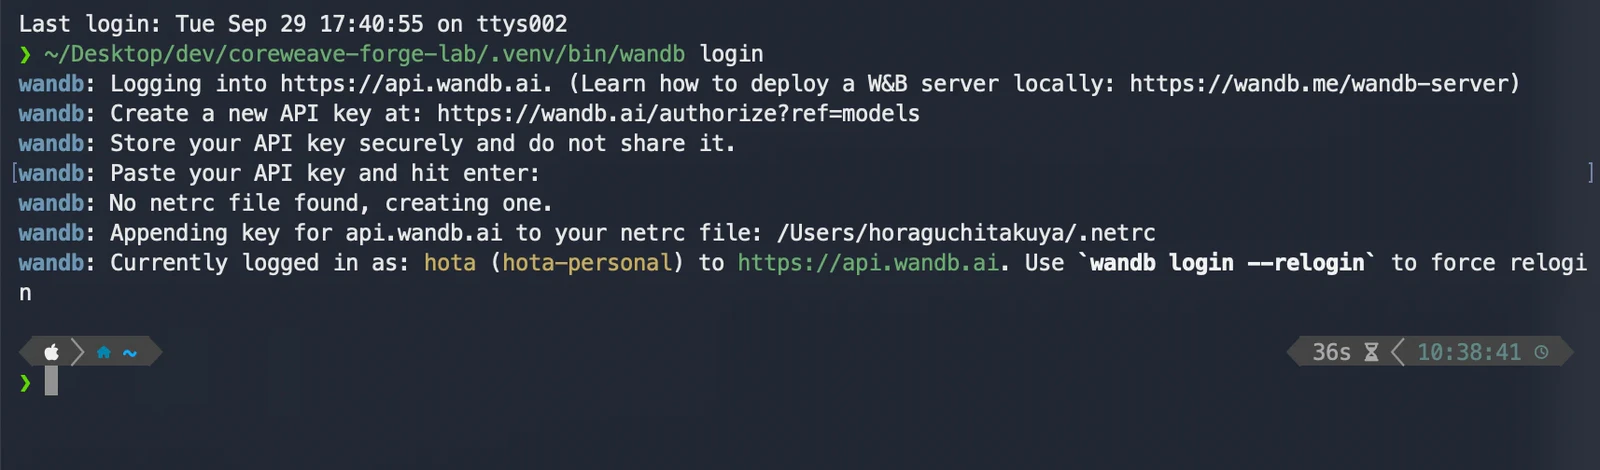
図10:ログインの実行結果。接続先は api.wandb.ai のままで、Forge 移行後もバックエンドは Weights & Biases のものです。
手順の全体像
ここから先の流れを先に図にしておきます。番号は以降の見出しに対応します。
図11:検証の流れ(静止画は 静止画)。
手順2:Trace を送る(本番シミュレーション)
検証用エージェントの中身
題材は、架空のネットショップに届く問い合わせを「カテゴリ」「優先度」「返信文」に振り分けるエージェントです。カテゴリは配送・返品返金・請求・アカウント・不具合・その他の6種類、優先度は高・中・低の3段階にしました。注文番号が本文にあれば、注文照会ツールで状況を調べてから返信する、という設計です。
問い合わせは20件を用意し、それぞれに期待するカテゴリ・優先度と、「注文照会ツールを呼ぶべきか」を付けました。これが後で評価データセットになります。
# data.py(抜粋): 20 件の問い合わせと期待値。全文は記事フォルダの raw/data.py
CASES = [
    {"id": "c01", "inquiry": "注文番号 A-1001 の商品がまだ届きません。配送状況を教えてください。",
     "category": "配送", "priority": "中", "needs_order_lookup": True},
    {"id": "c06", "inquiry": "ギフト包装はできますか?",
     "category": "その他", "priority": "低", "needs_order_lookup": False},
    {"id": "c16", "inquiry": "身に覚えのないログイン通知が届きました。不正アクセスされていませんか?",
     "category": "アカウント", "priority": "高", "needs_order_lookup": False},
    # ... 残り 17 件
]

# 架空の注文データベース(ツールが返す内容)
ORDERS = {
    "A-1001": {"status": "輸送中", "carrier": "ヤマト運輸", "eta": "2026-10-03", "item": "ステンレスボトル"},
    # ...
}
エージェント本体は Claude Agent SDK で書きます。ツールはプロセス内の MCP サーバーとして定義し、weave.Model を継承したクラスの predict に @weave.op を付けます。こうしておくと、プロンプトの版やモデル名が Weave 側で「モデルのバージョン」として記録され、評価の比較に使えます。
# triage_agent.py(要点のみ。全文は raw/triage_agent.py)
import json, re, time
import weave
from claude_agent_sdk import (AssistantMessage, ClaudeAgentOptions, ResultMessage,
                              TextBlock, ToolUseBlock, create_sdk_mcp_server, query, tool)
from data import ORDERS

# 注文照会ツール(プロセス内 MCP サーバー)
@tool("lookup_order", "注文番号から配送状況・配送業者・到着予定・商品名・請求の状況を取得する", {"order_id": str})
async def lookup_order(args: dict) -> dict:
    order = ORDERS.get(args["order_id"].strip())
    text = json.dumps({"order_id": args["order_id"], **order} if order else {"error": "注文が見つかりません"}, ensure_ascii=False)
    return {"content": [{"type": "text", "text": text}]}

shop_server = create_sdk_mcp_server(name="shop", version="1.0.0", tools=[lookup_order])

PROMPTS = {"v1": "...最初のプロンプト...", "v2": "...失敗分析のあとで直した版..."}

class TriageAgent(weave.Model):
    prompt_version: str = "v1"
    model: str = "claude-haiku-4-5"

    @weave.op
    async def predict(self, inquiry: str) -> dict:
        options = ClaudeAgentOptions(
            system_prompt=PROMPTS[self.prompt_version],
            model=self.model,
            mcp_servers={"shop": shop_server},
            allowed_tools=["mcp__shop__lookup_order"],
            tools=[],          # Read や Bash などの組み込みツールは使わせない
            max_turns=6,
        )
        texts, tools_used, cost = [], [], None
        async for msg in query(prompt=inquiry, options=options):
            if isinstance(msg, AssistantMessage):
                for block in msg.content:
                    if isinstance(block, TextBlock):
                        texts.append(block.text)
                    elif isinstance(block, ToolUseBlock):
                        tools_used.append(block.name)
            elif isinstance(msg, ResultMessage):
                cost = msg.total_cost_usd
        parsed = _parse_json(texts[-1] if texts else "") or {}
        return {"category": parsed.get("category"), "priority": parsed.get("priority"),
                "reply": parsed.get("reply"), "json_ok": bool(parsed),
                "tools_used": tools_used, "cost_usd": cost}
最初のプロンプト v1 は、わざと素朴にしました。カテゴリと優先度の候補と JSON の形式を示すだけで、優先度の基準もツールの使い方も書いていません。
あなたはネットショップのカスタマーサポート担当です。
届いた問い合わせを読み、次の JSON 形式で振り分け結果を返してください。

{"category": "<配送|返品返金|請求|アカウント|不具合|その他>", "priority": "<高|中|低>", "reply": "<お客様への返信文>"}
1 件 1 会話として 20 件を流す
本番運用の代わりに、20件を1件ずつ別の会話として処理するスクリプトを用意しました。Weave に送るために必要なのは weave.init("プロジェクト名") の1行だけです。プロジェクトは無ければ自動で作られます。weave.thread() で会話 ID を分けると、Agent Lens では1件が1会話として並びます。
# run_prod.py(要点)
import asyncio, os, weave
from data import CASES
from triage_agent import TriageAgent

async def main(version: str):
    weave.init("forge-free-hands-on")          # これだけで Claude Agent SDK の呼び出しが記録される
    agent = TriageAgent(prompt_version=version)
    for case in CASES:
        with weave.thread(f"inquiry-{case['id']}"):      # 1 件 = 1 会話
            with weave.attributes({"env": "production-sim", "prompt_version": version}):
                out = await agent.predict(inquiry=case["inquiry"])
        ok = out["category"] == case["category"] and out["priority"] == case["priority"]
        print(case["id"], "OK" if ok else "NG", out["category"], out["priority"], out["tools_used"])
    weave.finish()                               # 送信待ちのデータを flush してから終了

asyncio.run(main("v1"))
cd ~/coreweave-forge-lab && source .venv/bin/activate
python run_prod.py v1 20
結果はこうなりました。20件中6件が期待と違い、内訳は優先度のずれが4件、JSON を返さず文章で答えたものが1件、カテゴリ違いが1件(1回目の実行)です。
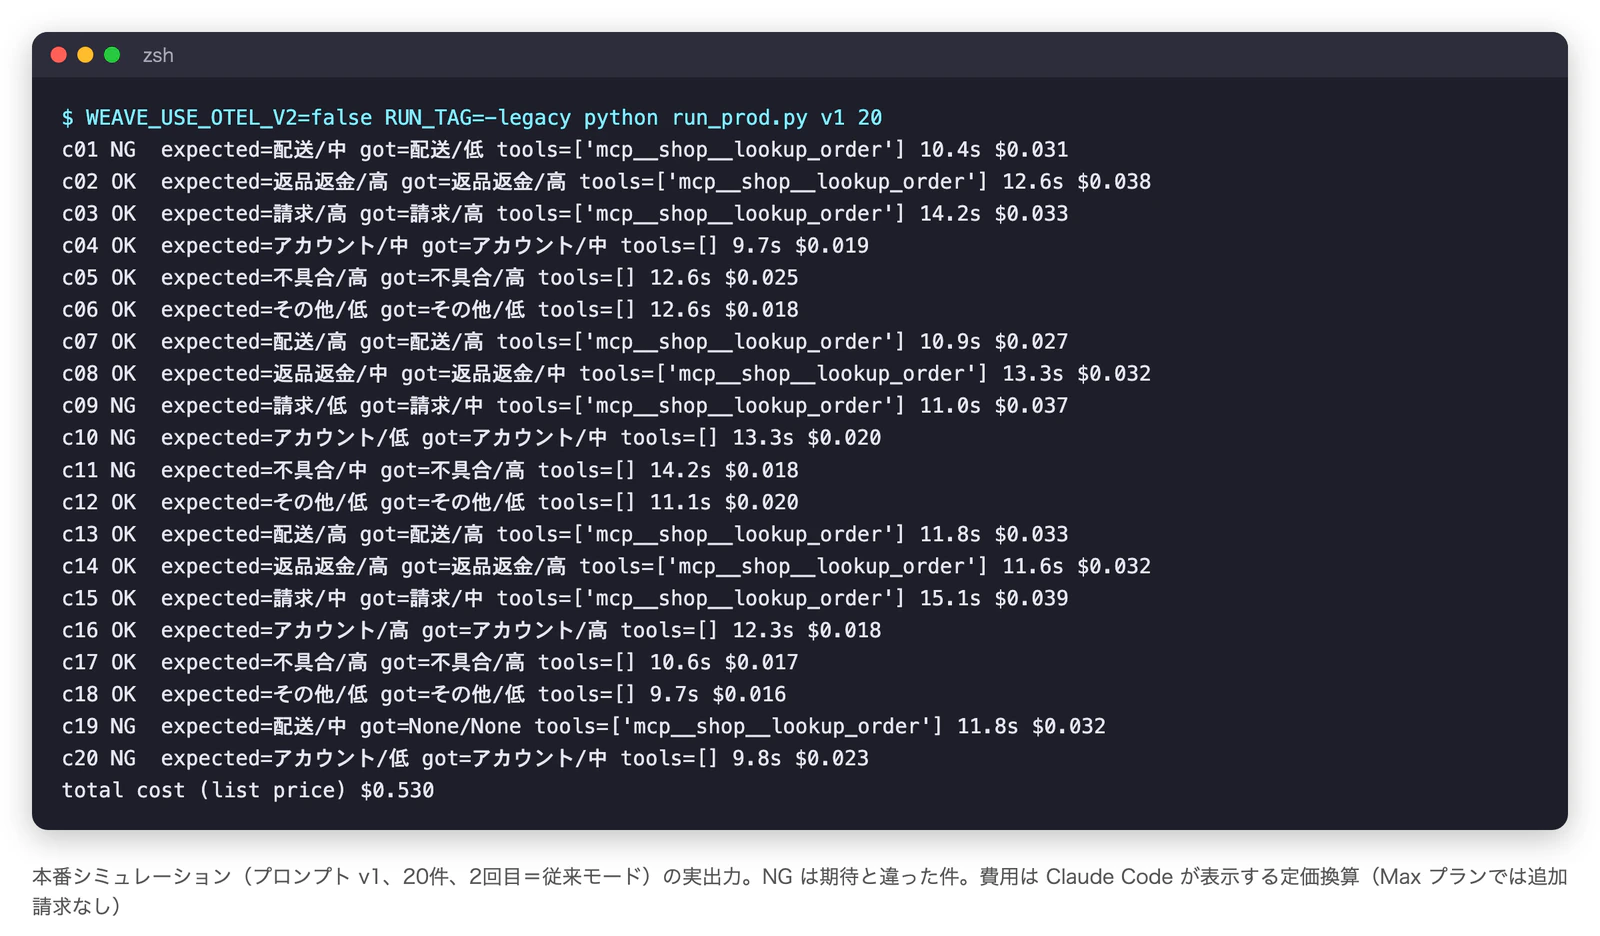
図12:2回目(従来モード)の実出力。1回目は c06・c09・c10・c11・c12・c20 が NG で、やはり6件でした。
この20件で、手元の Claude Code が報告した定価換算の費用は約0.5〜1.0ドル、1件あたり10〜16秒でした。Max プランのログインで動かしているので、実際の追加請求はありません。
Weave の画面で Trace を見る
Forge にログインし、プロジェクトの Traces を開くと、20件が1行ずつ並びます。表示名は問い合わせ文そのもので、右の列には最後の応答、モデル名、プロンプト版などが出ます。
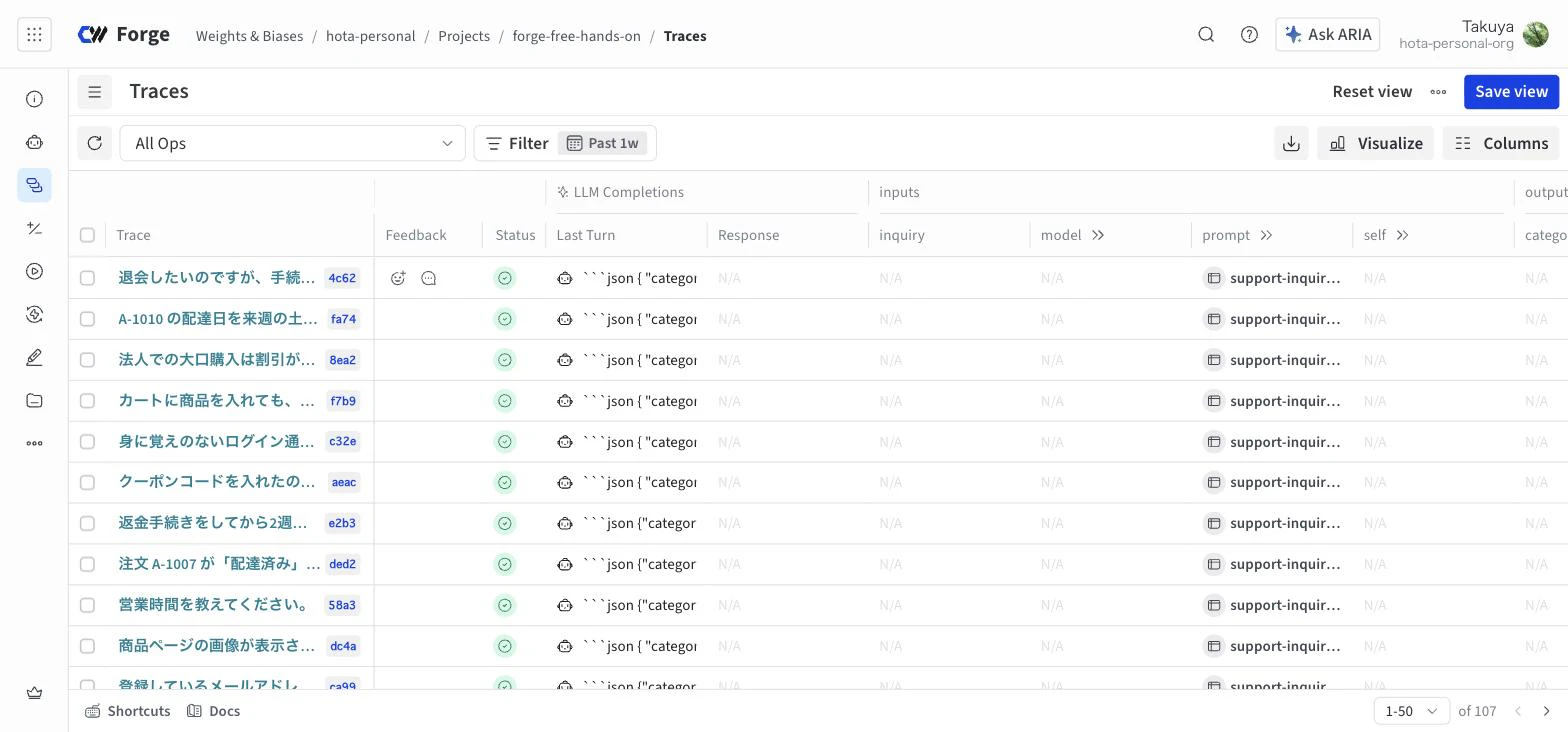
図13:Traces 一覧。この時点で 107 件(本番シミュレーション 2 回と評価 4 回の分)。
1行を開くと、1回の実行がどう進んだかが木構造で見えます。「考えた内容(Thinking)→ 注文照会ツールの呼び出し → また考える → 最終の JSON」という流れと、各段階の所要時間、定価換算の費用が並びます。ツールのノードを選ぶと、どの注文番号で呼び、何が返ったかが残っています。
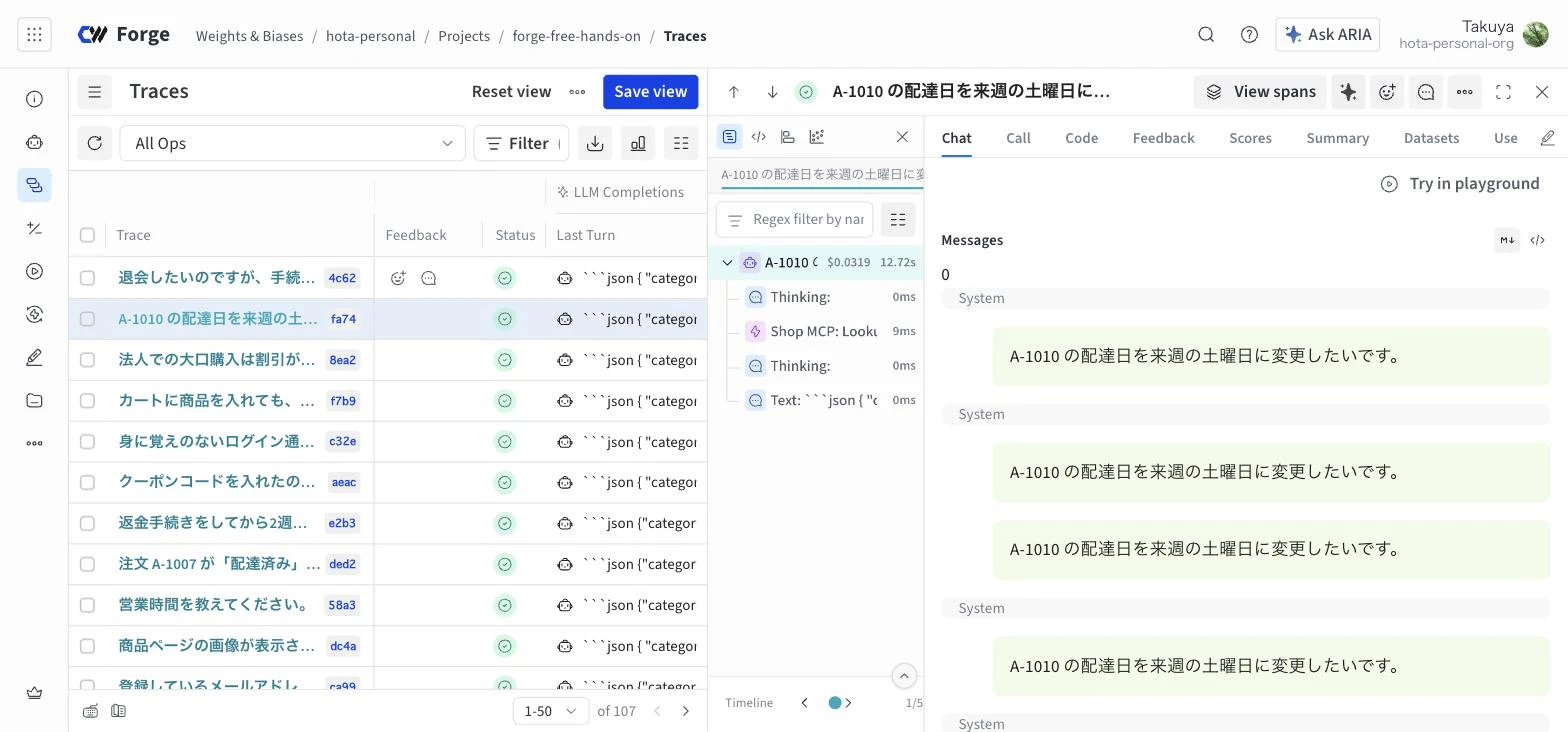
図14:1 件の Trace。ツールの入出力まで残っているので、「呼ぶべきなのに呼ばなかった」もここで分かります。
つまずき:既定ではこの木構造が出なかった
実は最初に流したとき、Traces には自分で @weave.op を付けた関数しか出ず、ツール呼び出しの子が見当たりませんでした。weave のソースを追うと、0.53 では Claude Agent SDK の自動追跡が既定で OpenTelemetry(OTel)形式になっており、送り先が Weave の「Agents」タブと Agent Lens になっていました。設定 WEAVE_USE_OTEL_V2 が true のときこちらが選ばれます。
従来の「呼び出し記録」として Traces に残したい場合は、環境変数で切り替えます。
# 従来形式(Traces タブに thinking / tool_use / text の子が残る)
WEAVE_USE_OTEL_V2=false python run_prod.py v1 20
2通りの形を図にまとめました。どちらも今回の実測で確認した階層です。
図15:既定(左)は Agents タブと Agent Lens、環境変数で切り替えた従来形式(右)は Traces タブに出ます(静止画は 静止画)。
既定の OTel 形式は、Weave の Agents タブで会話として見られます。1会話を開くと、invoke_agent の下に MCP サーバーの初期化、ツール一覧の取得、ツール実行、モデル呼び出しが並びます。
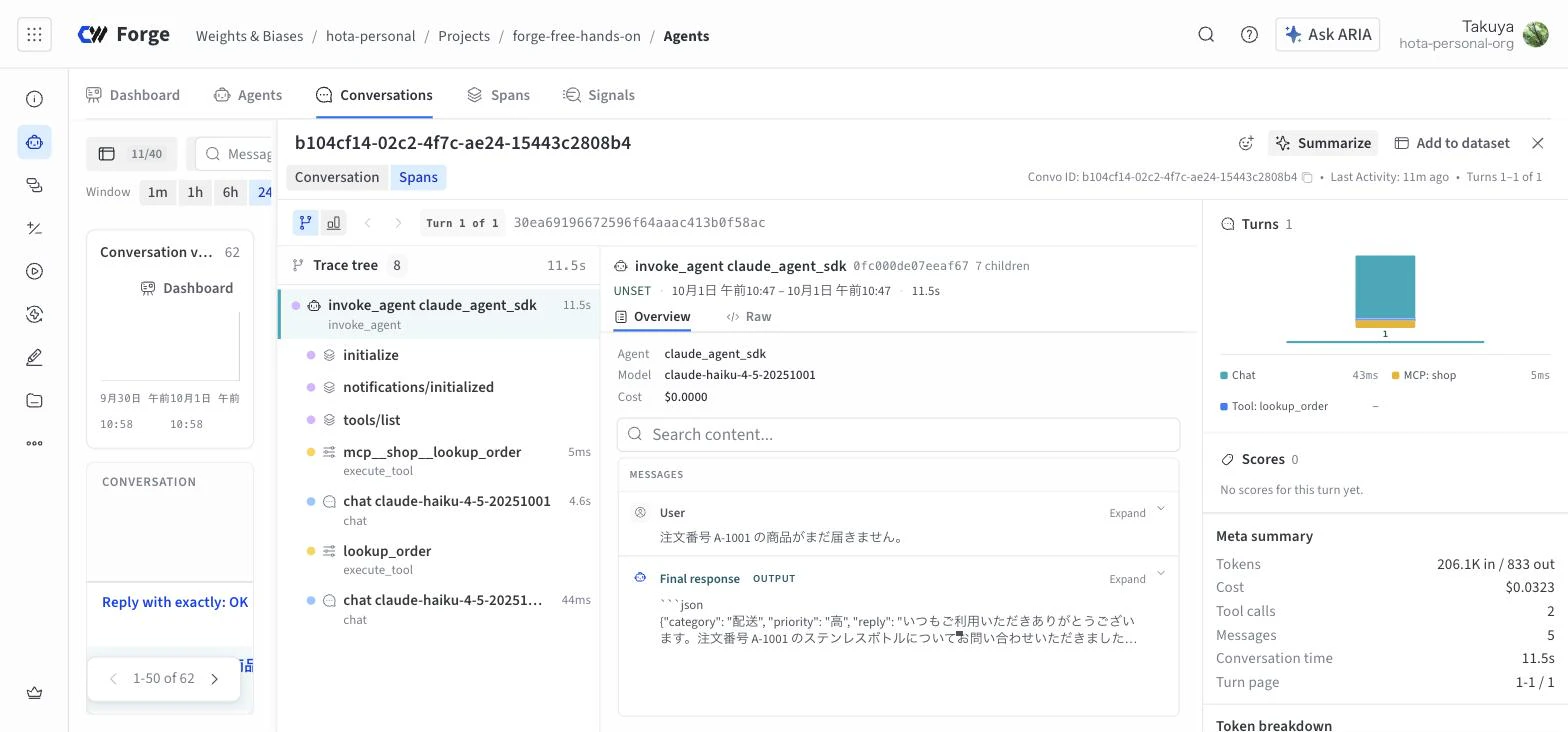
図16:OTel 形式の 1 会話。トークン数(206.1K in / 833 out)と費用(0.0323 ドル)も付いています。
どちらを使うかは目的次第です。Agent Lens で会話単位の傾向を見たいなら既定のまま、Evaluation の行から個別の Trace をたどりたいなら従来形式が扱いやすいです。両方欲しい場合は、2回流すか、片方を OTel で別途送る構成になります。
手順3:失敗を見つける(Agent Lens の自動検出と、自分の目)
Agent Lens の Insights
Agent Lens は Forge のアプリ一覧から開きます。プロジェクトを選ぶと、Overview(会話数・エラー・コスト・ツール別の失敗率)、Insights(失敗の分類と利用者の意図の分類)、Conversations、Tags の4画面があります。Free プランでそのまま使えました。
Insights の「Agent failures」には、LLM の判定で付いた失敗カテゴリが出ます。今回は「Tool misuse(ツールの誤用)」が 9 会話、全体の 40.9% と表示されました。判定理由を開くと、こう書いてあります。
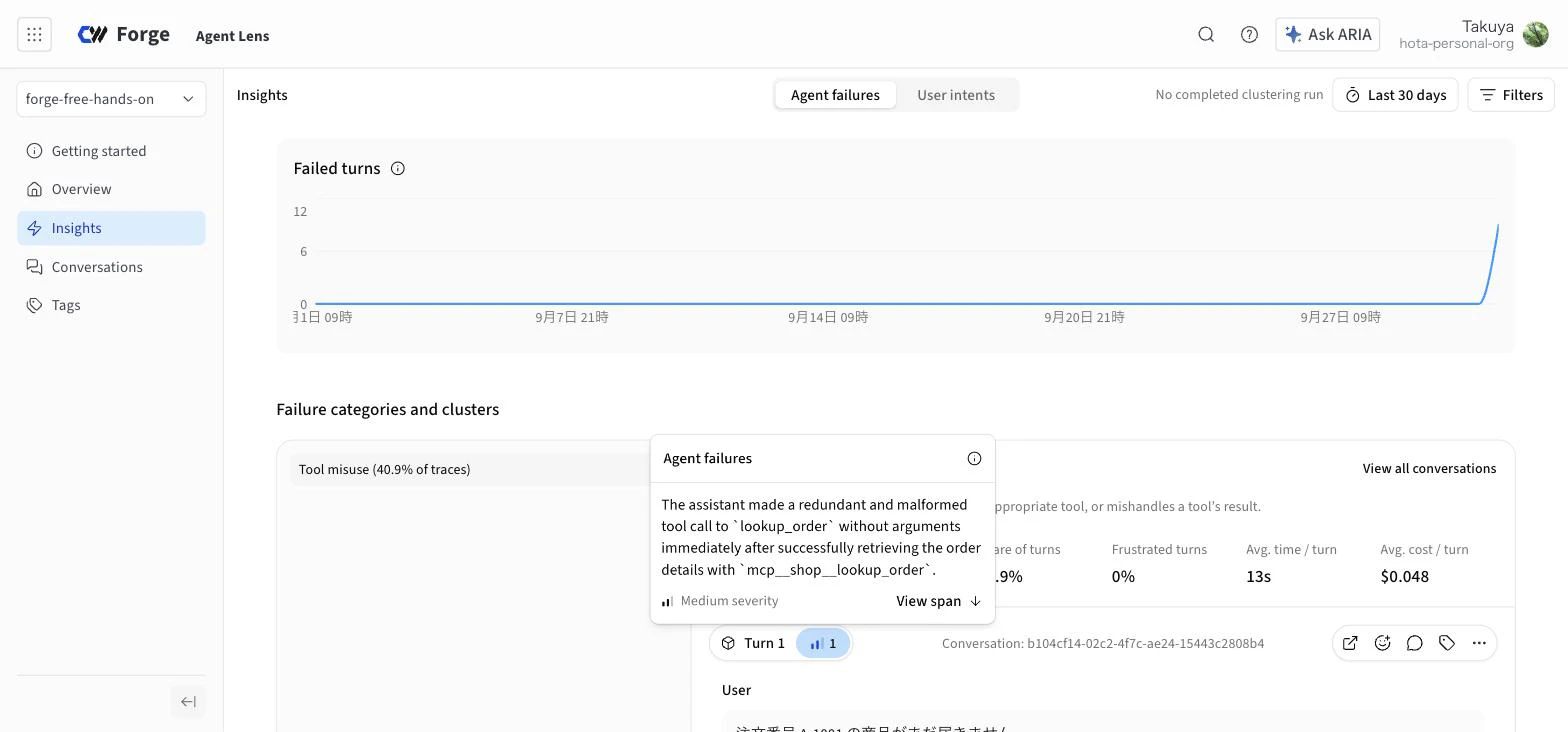
図17:Agent Lens が「失敗」と判定した理由。重複したツール呼び出しを指摘しています。
これは注意深く読む必要がありました。指摘された「引数なしの lookup_order の重複呼び出し」は、エージェントの振る舞いではなく、weave の Claude Agent SDK 連携が MCP 経由のツール実行を2つのスパン(mcp__shop__lookup_order と内側の lookup_order)として記録しているために起きた見え方です。つまり、Agent Lens は記録の形をそのまま読んで「冗長な呼び出し」と判定しました。本当の失敗(優先度のずれや JSON を返さなかった件)は、期待値を知らない Agent Lens には見つけられません。
ここから言えることは2つです。自動の失敗検出は「人が見るべき場所を絞る」道具として有効で、9件を一覧で確認できました。一方で、判定の根拠は必ず自分の目で確かめる必要があり、連携の都合で生じる見え方は誤検出になります。「User intents」の方は、質問 40.9%、問題の報告 31.8%、作業の依頼 27.3% と、問い合わせの性質を妥当に分類していました。
期待値と突き合わせる
評価データの期待値と突き合わせた本当の失敗は、図12の NG 行です。優先度のずれは「領収書の発行」「メールアドレス変更」「退会」を中と判定したもの(期待は低)、「画像が表示されない」を高と判定したもの(期待は中)でした。JSON を返さなかったのは「営業時間を教えてください」(1回目)と「配達日を変更したい」(2回目)です。どれも Trace を開けば入力と出力が残っているので、原因の分類は数分で終わりました。
手順4:評価データにする
20件を Weave の Dataset として公開します。Dataset はバージョン管理されるので、後で失敗例を足しても、どの版で評価したかが残ります。
# build_dataset.py
import weave
from data import CASES

weave.init("forge-free-hands-on")
ds = weave.Dataset(name="support-inquiries-v1", rows=CASES)
ref = weave.publish(ds)
print("published:", ref.uri())
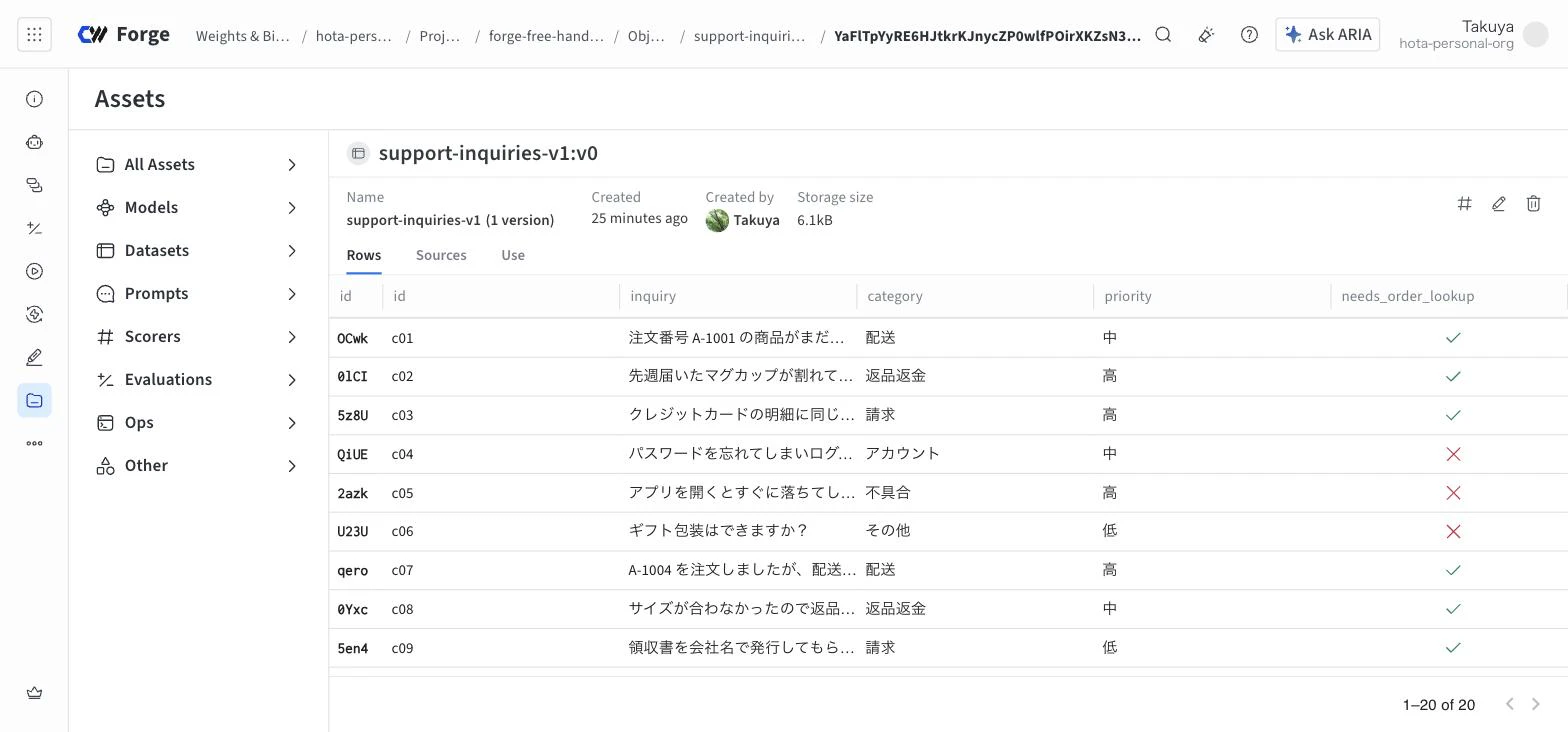
図18:公開した評価データセット。ストレージは 6.1kB。
Trace から直接データセットに入れる方法もあります。Agents タブや Agent Lens の会話画面には「Add to dataset」ボタンがあり、本番で見つけた失敗例をその場で評価データに追加できます。SDK でも weave.Dataset.from_calls([...]) で呼び出し記録からデータセットを作れます。今回は20件を最初から用意したので使いませんでしたが、「本番の失敗を評価に戻す」の最短経路はここです。
手順5:採点して現状を数字にする
採点関数(Scorer)は、output(モデルの出力)と、データセットの列名と同じ名前の引数を受け取る普通の関数です。今回は4つ用意しました。
# run_eval.py(要点)
import asyncio, os, weave
from triage_agent import TriageAgent
os.environ.setdefault("WEAVE_PARALLELISM", "4")   # Claude CLI を同時に起動する数

@weave.op
def category_match(category: str, output: dict) -> dict:
    return {"correct": output.get("category") == category}

@weave.op
def priority_match(priority: str, output: dict) -> dict:
    return {"correct": output.get("priority") == priority}

@weave.op
def tool_policy(needs_order_lookup: bool, output: dict) -> dict:
    called = "mcp__shop__lookup_order" in (output.get("tools_used") or [])
    return {"followed": called == needs_order_lookup}

@weave.op
def json_valid(output: dict) -> dict:
    return {"ok": bool(output.get("json_ok"))}

async def main(version: str):
    weave.init("forge-free-hands-on")
    dataset = weave.ref("support-inquiries-v1").get()
    evaluation = weave.Evaluation(name="triage-eval", dataset=dataset,
                                  scorers=[category_match, priority_match, tool_policy, json_valid])
    result = await evaluation.evaluate(TriageAgent(prompt_version=version),
                                       __weave={"display_name": f"triage prompt {version}"})
    print(result)
    weave.finish()

asyncio.run(main("v1"))
python run_eval.py v1
20件の評価は、並列4で約65〜75秒で終わりました。v1 の結果は、カテゴリ 18〜20/20、優先度 13/20、ツール使用の規則 20/20、JSON 20/20 です。本番で見た「優先度の基準が無い」問題が、そのまま数字になっています。
手順6:直す(プロンプト v2)
失敗の分類に対応して、プロンプトに3つの要素を足しました。6カテゴリの定義、優先度の3段階の基準、ツールの使い方と「JSON だけで返す」という出力の規則です。
## 優先度の決め方
- 高: 金銭的な被害(二重請求・返金の遅れ)、商品の未着や破損、不正アクセスの疑い、
      購入が完了できない不具合、出荷前に対応しないと間に合わない依頼
- 中: 進捗確認、通常の返品、日時変更、表示の不具合、パスワード再設定
- 低: 一般的な質問、領収書の発行、登録情報の変更、退会

## ツールの使い方
- 本文に注文番号(A-1234 の形式)があれば、必ず lookup_order ツールで注文の状況を調べてから返信文を書く。

## 出力形式
JSON だけで返す(前後に説明文を付けない)。
図19:失敗の分類と修正の対応(静止画は 静止画)。
TriageAgent(prompt_version="v2") にすると、Weave 側では TriageAgent の新しいバージョンとして記録されます。コードを変えるたびに版が上がるので、今回の検証では v7 まで増えました。
手順7:同じデータで再評価して比べる
v2 で同じ評価を回し、Evaluations 画面で2つの実行を選んで「Compare」を押すと、採点項目ごとの差分が出ます。
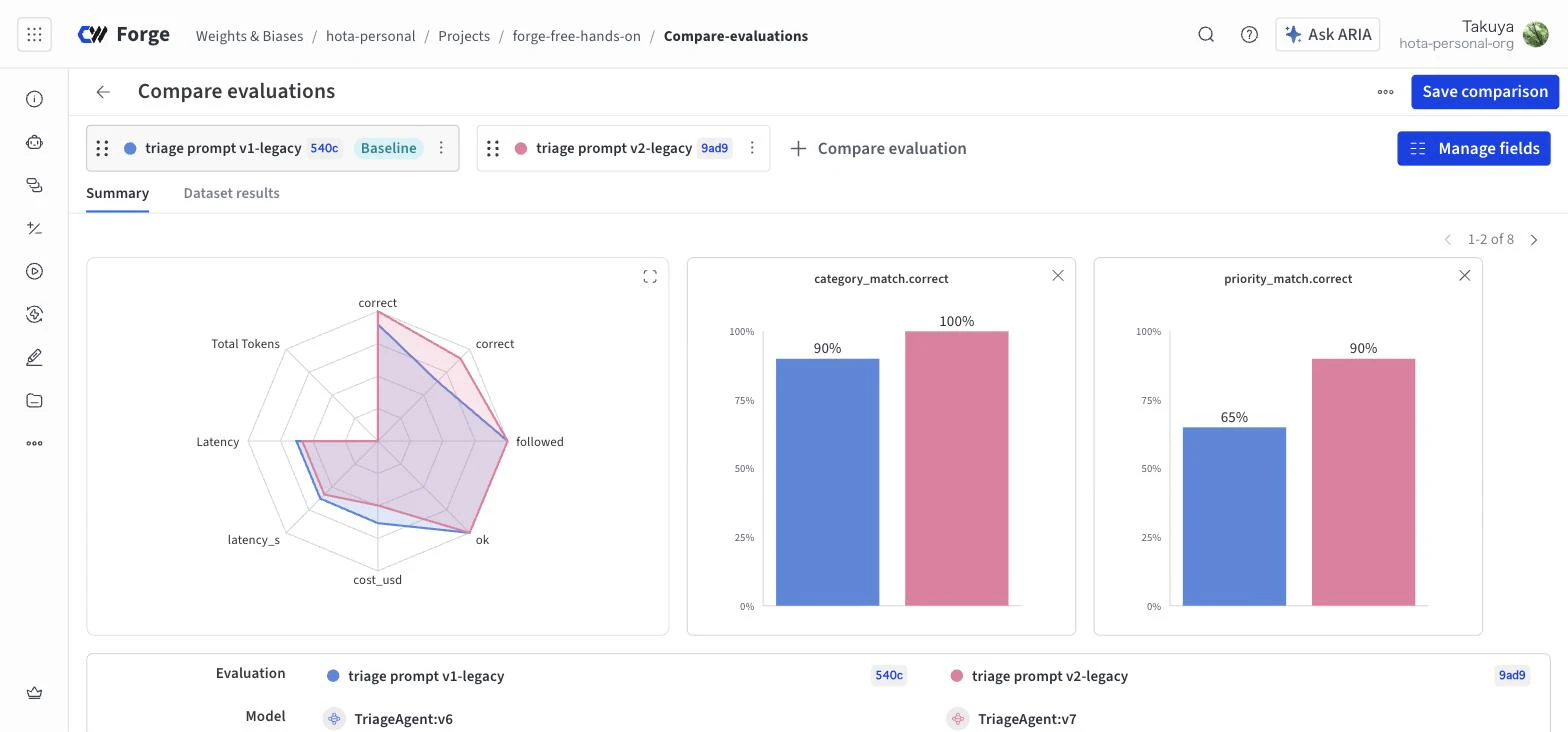
図20:2 回目の評価の比較。優先度の正解率が 65% から 90% に上がりました。
評価は1回目(既定の OTel モード)と2回目(従来モード)の2回ずつ回しました。数字をまとめると次のとおりです。
図21:2 回分の要約値(静止画は 静止画)。
| 観点 | v1(1回目 / 2回目) | v2(1回目 / 2回目) |
|---|---|---|
| カテゴリの一致(/20) | 20 / 18 | 20 / 20 |
| 優先度の一致(/20) | 13 / 13 | 19 / 18 |
| ツール使用の規則(/20) | 20 / 20 | 20 / 20 |
| JSON で返したか(/20) | 20 / 20 | 20 / 20 |
| 1件あたりの費用(定価換算) | $0.043 / $0.032 | $0.029 / $0.025 |
| 1件あたりの所要時間 | 13.4 / 12.5 秒 | 12.3 / 11.7 秒 |
優先度の正解は2回とも5〜6件増え、カテゴリは落ちなくなり、出力が短くなった分だけ費用と時間も減りました。v2 で残った失敗は、1回目が「アプリがすぐ落ちる」を中と判定した1件(期待は高)、2回目が「返金から2週間たっても入金がない」を中(期待は高)、「クーポンが反映されていない」を高(期待は中)と判定した2件です。どれも「金銭に関わる問い合わせをどこまで高にするか」という基準の境界にあり、次はこの例をデータセットに足して基準を書き足す、という繰り返しになります。
ここまでが、Free プランの範囲で回した一周です。学習(SFT や RL)に進まなくても、「失敗を評価データに戻して、直して、同じデータで比べる」はこの範囲で完結しました。
応用:Claude Code のセッションをそのまま流す、学習へ進む
Claude Code プラグイン
今回はコードを書いて Trace を送りましたが、Claude Code や Codex のセッションをそのまま Agent Lens に流すプラグインも公式に用意されています。Claude Code 向けは npm のインストーラで入れます。
npm install -g weave-claude-code
WEAVE_PROJECT=<チーム>/<プロジェクト> WANDB_API_KEY=<APIキー> weave-claude-code install --non-interactive
公式ドキュメントには、プロンプト、応答、ツールの入出力、読んだファイルの内容、シェルのコマンドと出力がすべて送られ、個人情報のマスクは実装されていない、という注意があります。業務のリポジトリで使うなら、送られる内容を先に確認した方がよいです。今回はこのプラグインは試していません。
ARIA に聞く
Forge には ARIA という分析用のコーディングエージェントが付いていて、画面右上の「Ask ARIA」から、プロジェクトのデータについて質問できます。Free では期間限定で無料です。2回目の評価2つを比べて「改善した例、まだ失敗する例、次に直すべき点」を聞いたところ、評価レコードを21ステップかけて読み、改善した6件(c06・c07・c09・c10・c18・c20)と残った2件(c14・c15)を正しく挙げました。提案は「優先度の規則に境界例を明記する。返金の2週間以上の遅延は高、クーポン未反映のみは中、金銭問題を一律で高にしない判定順序を足す」というもので、Trace を見て人が考える内容とほぼ同じでした。1〜2分で返ってきます。
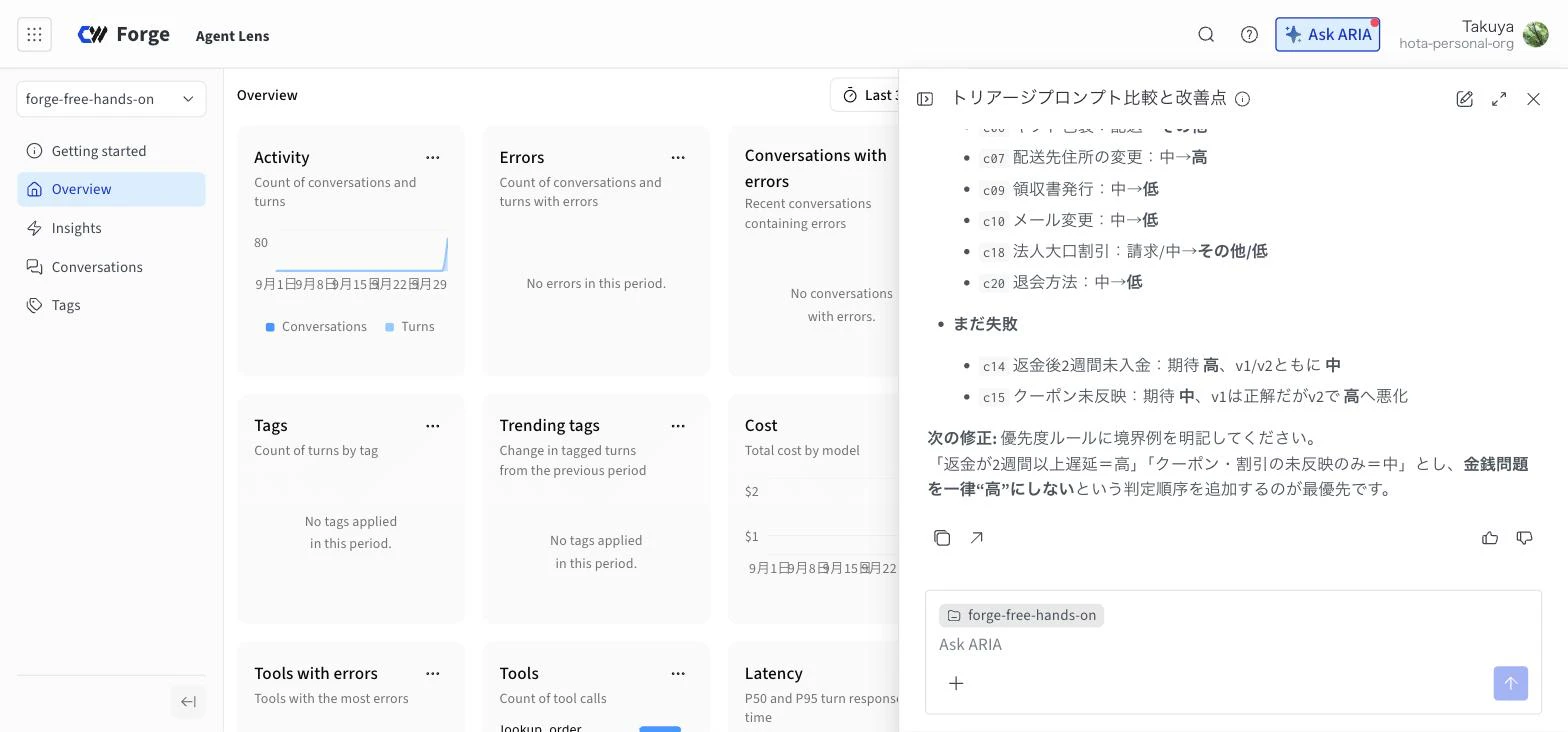
図22:ARIA の回答画面。
学習(SFT / RL)に進む場合
Forge の売りである Serverless RL や SFT は、CoreWeave 上のオープンウェイトモデルに対してクラウド側で学習を回し、できたモデルを同じ基盤で動かす仕組みです。手元の Claude のような外部モデルの重みを鍛えるものではないので、ループの後半まで回すなら、エージェントのモデルを最初から Forge の推論基盤上のモデルに置き換える設計になります。料金は Free でも従量課金で、Serverless SFT は 1 GPU 時間あたり 2.70 ドル、推論はモデルごとのトークン単価です。今回のような小さなデータなら1回数ドル規模で済むはずですが、無料ではありません。
使った量と料金の実際
検証を終えた時点の Billing 画面です。Free プランで、Models seats は 1/5、ストレージは 0.0B/5GB、推論は $0.00/$2.00 でした。従量課金(Pay-as-you-go)は「Not active」で、自分で有効化しない限り、クレジットを使い切った時点で止まります。
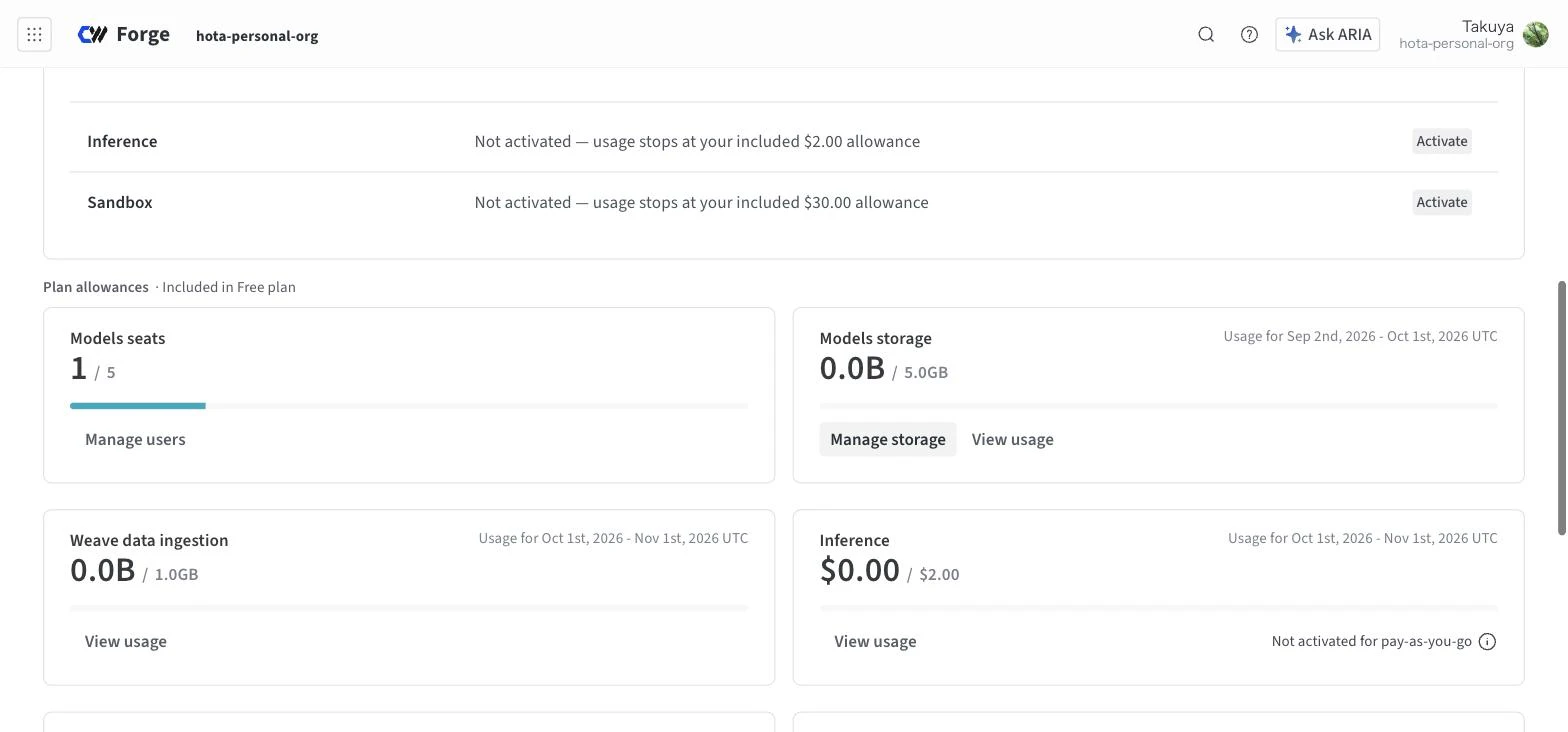
図23:検証後の使用量。Sandbox にも 30 ドル分の枠が表示されていました。
気になったのは、Weave の取り込み量が 107 件の Trace と 625 スパンを送った後も「0.0B / 1.0GB」と表示されていたことです。送信の約1時間後に見直しても同じ表示でした。集計が日次などで遅れている可能性が高く、翌日以降に見直す必要があります。公式の説明では、取り込み量は Trace のデータ量で計算され、Free の上限は月 1GB です。今回の規模(1件あたり数 KB〜数十 KB)なら、数千件を流しても上限には遠いと見積もれます。
| 項目 | 今回の実績 | Free の枠 |
|---|---|---|
| Forge の料金 | $0 | $0/月 |
| Weave の取り込み | 107 Trace・625 スパン(画面の表示は 0.0B) | 1 GB/月 |
| CoreWeave 上の推論 | 使わず $0.00 | $2 分のクレジット(期間限定) |
| Sandboxes | 使わず | $30 分の枠(画面表示) |
| 手元の推論 | Haiku 4.5 で約 100 回、定価換算 約 3.5 ドル | Claude Max に含まれる |
トラブルシューティング
実際につまずいた順に、確認する順番をまとめました。
図24:診断の流れ(静止画は 静止画)。
| 症状 | 原因 | 対処 |
|---|---|---|
| ログイン直後に「Your free trial has expired」で止まる | 旧 W&B アカウントの Pro トライアル終了扱い | Free 列の「Downgrade」を押す(確認ダイアログあり、料金は発生しない) |
wandb login が command not found |
weave だけでは wandb コマンドが入らない |
pip install wandb、または WANDB_API_KEY を環境変数に設定 |
| Traces に自分の関数しか出ない | weave 0.53 の既定は OTel 形式で Agents タブ行き |
WEAVE_USE_OTEL_V2=false で従来形式。終了前に weave.finish()
|
| Agent Lens の「Tool misuse」が多すぎる | 連携が MCP のツール実行を 2 スパンで記録し、重複と判定される | 判定理由を開いて確認。期待値がある失敗は Evaluation で測る |
| forge.coreweave.com の URL が 404 | Weave の画面は /wandb/<チーム>/<プロジェクト>/weave/... 配下、請求は /account-settings/<組織>/billing
|
SDK が表示する wandb.ai の URL を開けば転送される。請求は右上のアカウントメニューの Billing から |
まとめ
CoreWeave Forge の Free プランで、「本番の失敗 → Trace で確認 → 評価データ → 採点 → プロンプト修正 → 同じデータで再評価」を一周できました。かかった費用は 0 ドル、準備を含めて半日ほどです。
- Trace の送信は
weave.init()の1行で済み、Claude Agent SDK のツール呼び出しまで自動で記録されます。ただし weave 0.53 の既定は OTel 形式で Agents タブと Agent Lens 行きです。Traces の木構造で見たいならWEAVE_USE_OTEL_V2=falseに切り替えます - Dataset・Evaluation・Scorer・比較画面は Free に含まれ、20 件の評価は 1 回 1 分強でした。優先度の正解は 13/20 から 18〜19/20 に上がり、その差分が画面で確認できます
- Agent Lens の自動の失敗検出は、人が見る場所を絞るのには使えますが、根拠は確認が必要でした。今回は連携の記録形式による誤検出が 9 件でした
- Free でも ARIA と Agent Lens は使え、CoreWeave 上の推論には $2 分、Sandboxes には $30 分の枠がありました。従量課金は自分で有効化しない限り動きません
- ループの後半(SFT / RL / 蒸留)は Free でも別料金で、CoreWeave 上のモデルで組む前提です。手元の Claude で回す構成なら、観測と評価の部分だけを Forge に任せる形になります
Agent を本番で動かしているなら、「Trace を保存している」の先に、失敗を評価データへ自動で戻せているか、同じデータで前後を比べられているか、を見直す価値があります。Free プランは、その設計を試すには十分な範囲でした。
参考リソース
- CoreWeave Forge 公式発表(2026年9月30日): https://www.coreweave.com/news/coreweave-forge-launches-turning-the-ai-loop-production-run-into-a-better-model-and-agent
- 製品ページ: https://www.coreweave.com/forge
- 料金ページ: https://www.coreweave.com/forge-pricing
- サインアップ: https://id.coreweave.com/signup
- Weave クイックスタート: https://docs.coreweave.com/weave/quickstart
- Weave の Evaluation: https://docs.coreweave.com/weave/guides/core-types/evaluations
- Agent Lens の概要と連携一覧: https://docs.coreweave.com/products/agent-lens 、https://docs.coreweave.com/products/agent-lens/get-started/integrations
- Claude Agent SDK 連携: https://docs.coreweave.com/products/agent-lens/integrations/claude-agents-sdk
- Claude Code プラグイン: https://docs.coreweave.com/products/agent-lens/integrations/claude-code
- weave(PyPI): https://pypi.org/project/weave/