
はじめに
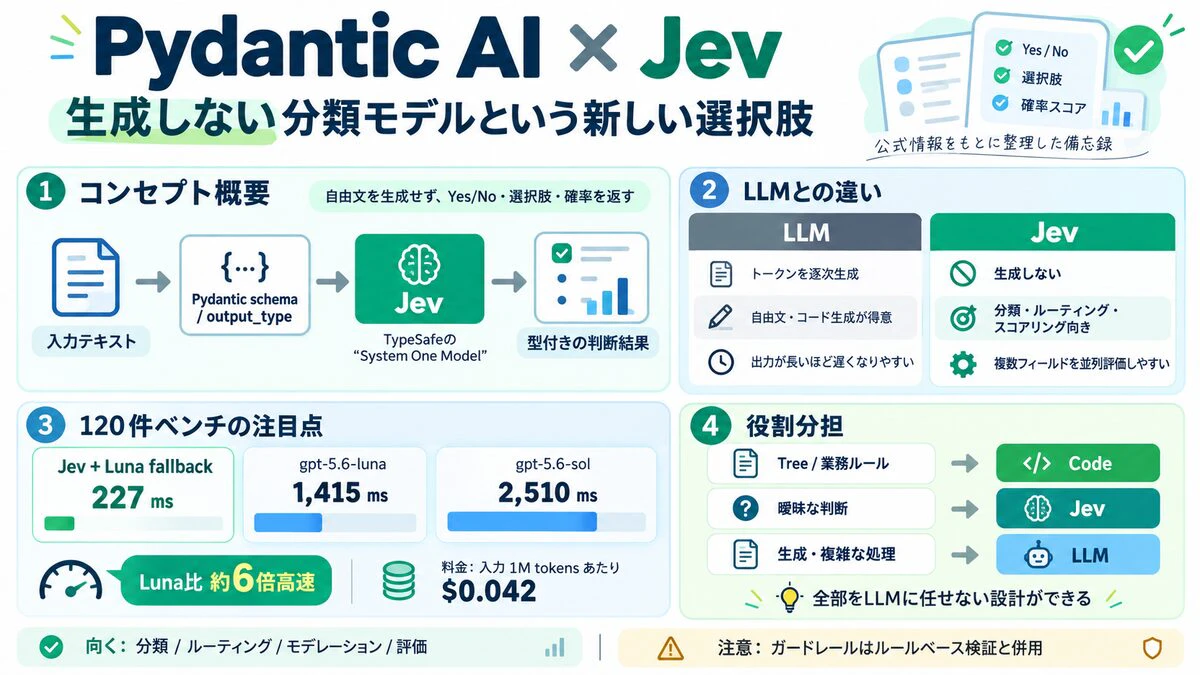
Pydantic AI のリリース情報を見ていたところ、TypeSafe 社の 「Jev」 が統合されたことを知りました。
Jev は、自由文を生成する LLM とは少し違います。
テキストと型付きの質問を受け取り、事前に定義された選択肢や Yes/No、確率などを返す、TypeSafe が「System One Model」と呼ぶモデルです。
Pydantic AI v2.45.0(2026-09-17)で TypeSafeModel が追加され、翌日の v2.46.0 では、Jev が表現できる型であれば ツール引数まで Jev 自身で埋められるようになりました。
「LLM の代わりになるモデル」というより、LLM に任せていた処理のうち、分類やルーティングのような判断だけを切り出せる選択肢として面白そうです。
そこで今回は、Pydantic AI / TypeSafe の公式情報を中心に、
- Jev は LLM と何が違うのか
- Pydantic AI ではどう扱うのか
-
confidenceやprobabilitiesはどう読むのか - LLM とどのように役割分担できるのか
を、備忘録として整理してみます。
本記事について
本記事は、Pydantic AI / TypeSafe の公式ドキュメント、リリース情報、および公開されているベンチマーク情報をもとに、興味を持った点を筆者なりに整理した備忘録です。Pydantic / TypeSafe の公式見解ではありません。
また、Jev / Pydantic AI は更新が続いているため、実際に利用する際は最新の公式ドキュメントもあわせて確認してください。
確認日: 2026-09-24
TL;DR
- Jev は トークンを逐次生成しない、型付きの判定向けモデル
- Pydantic AI では
typesafe:jev-latestとして利用できる - TypeSafe 公称のエンドツーエンド応答時間は 70〜500 ms
- 120 件のサポートチケットベンチでは、Jev + Luna フォールバックが中央値 227 ms。Luna 単独の 1,415 ms に対して約 6 倍高速だった
- 料金は 入力 100 万トークンあたり $0.042、出力トークンは無料
-
bool/Literal/Enum/ boundedfloat/ rubric など、Jev が扱える型に向く -
confidenceは 「正解確率」ではなく判断の余裕度に近い値。boundedfloatにはconfidence自体が付かない - Pydantic AI v2.46.0 では、Jev が表現できる型のツール引数なら Jev 自身が埋められる
- 自由文生成や Jev が扱えないツール引数は、
FallbackModelで LLM に委譲できる
1. Jev は LLM と何が違うのか
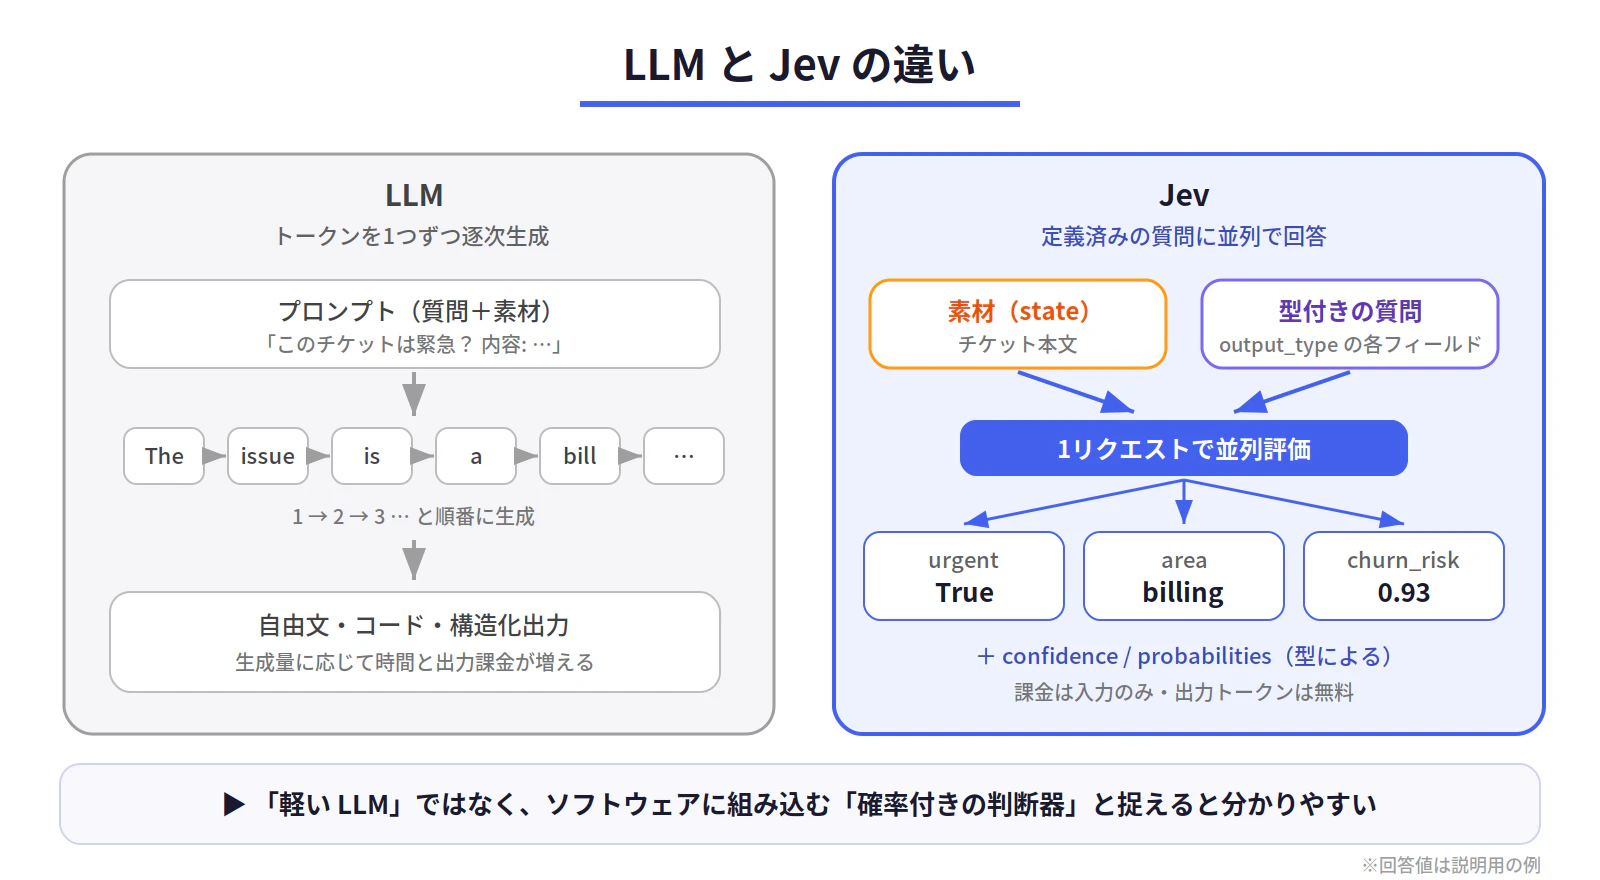
同じ「モデル」と呼ばれていても、Jev は LLM とはかなり性格が違います。
| LLM(GPT-5.x / Claude 等) | Jev | |
|---|---|---|
| 出力の作り方 | トークンを逐次生成 | 定義済みの質問に並列で回答 |
| 出力 | 自由文・コード・構造化出力など | 型付きの判定結果 |
| レイテンシ | 生成量などの影響を受ける | 複数フィールドを並列評価するため、質問数が増えても応答時間への影響を抑えやすい |
| コスト | 入力+出力 | 入力のみ |
| 得意領域 | 生成・記述・推論・コード | 分類・ルーティング・スコアリング |
| 不確実性 | モデルや実装による |
confidence / probabilities などを返す(型による) |
TypeSafe は Jev を、テキストを生成するモデルではなく、
unstructured state
        ↓
typed probabilistic decisions
を返すモデルとして位置づけています。
つまり「軽い LLM」というより、
"ソフトウェアの中に組み込むための確率付き判断器"
と考えるほうが分かりやすいです。
2. インストールと最初の1本
インストールは次のように行えます。
pip install "pydantic-ai[typesafe]"
export TYPESAFE_API_KEY='your-api-key'
サポートチケットのトリアージを例にします。
from typing import Literal

from pydantic import BaseModel, Field
from pydantic_ai import Agent


class Ticket(BaseModel):
    """Triage a support ticket."""

    urgent: bool = Field(
        description="Does this need a reply within the hour?"
    )

    area: Literal["billing", "bug", "account", "other"] = Field(
        description="Which team owns it?"
    )

    churn_risk: float = Field(
        ge=0,
        le=1,
        description="How likely is the customer to churn?"
    )


agent = Agent(
    "typesafe:jev-latest",
    output_type=Ticket,
)

result = agent.run_sync(
    "Second time this month my card was charged twice. Fix it or I cancel."
)

print(result.output)

details = result.response.provider_details or {}

print(details.get("confidence", {}))
print(details.get("probabilities", {}))
ここで重要なのは、Jev が扱える output_type であれば、
Agent("typesafe:jev-latest", output_type=Ticket)
という形で、Pydantic AI の通常の Agent と同じインターフェースから使えることです。
ただし、
どんな output_type でも
モデル名だけ差し替えれば動く
わけではありません。
Jev が扱える型で構成されている必要があります。
3. 型 → 質問形式の対応
Pydantic AI では、output_type の各フィールドが Jev への質問になります。
| Python 型 | Jev が扱う質問 | 返る値 |
|---|---|---|
bool |
Yes / No | 閾値以上か |
Literal[...] / str Enum
|
単一選択 | 選ばれた選択肢 |
float (ge=0, le=1) |
Yes の確率 | 確率そのもの |
UseEnumMemberDocstrings + IntEnum |
ルーブリック採点 | 最も近いレベル |
list[Literal] / list[Enum]
|
各選択肢を Yes / No | Yes の選択肢 |
dict[Literal, bool] 等 |
各選択肢を Yes / No | 全選択肢+判定 |
Literal / Enum | None |
単一選択+該当なし | 選択肢または None
|
| ネストしたモデル | 各フィールドを個別評価 | 復元されたモデル |
たとえば rubric を使う場合は、通常の IntEnum ではなく、各値の意味を schema に載せる必要があります。
from enum import IntEnum

from pydantic_ai import UseEnumMemberDocstrings


class Clarity(UseEnumMemberDocstrings, IntEnum):
    unclear = 0
    """Meaning is difficult to understand."""

    partial = 1
    """Some points are clear, but important context is missing."""

    clear = 2
    """The reader can understand what changed and what to do."""
一方、次のような型は Jev 単独では扱えません。
str
制約のない int / float
datetime
任意の dict
フィールドとしてのモデル Union
単独の output_type として Jev が埋められない型を渡すと、基本的にはリクエスト送信前に UserError になります。
なお v2.46.0 では、複数の output_type を候補として渡し、
どの出力型を使うか
        ↓
選んだ型のフィールドを埋める
というルーティングもサポートされています。
4. LLM から乗り換えるときに一番はまるポイント
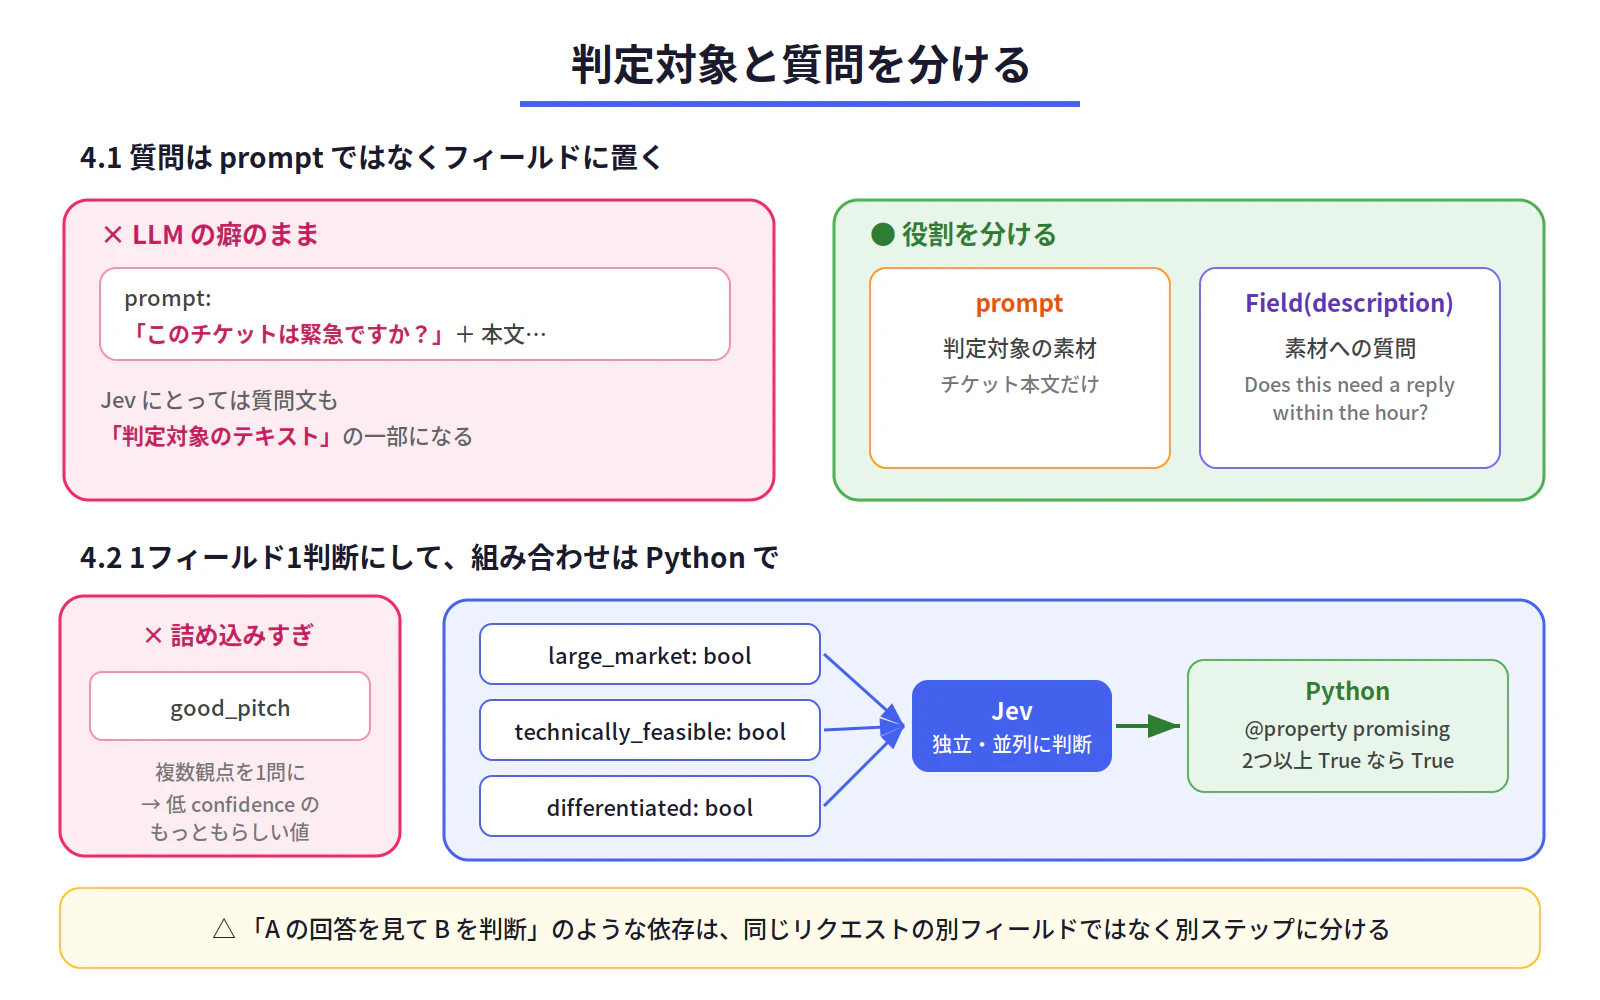
Jev を使ううえでは、まず、
判定対象と質問を分ける
という考え方が重要です。
基本形は、
prompt
  ↓
判定対象の素材

output_type / Field(description=...)
  ↓
その素材について聞きたい質問
です。
4.1 質問を prompt に入れない
LLM の癖で、次のように書きたくなります。
# ❌ Jev では避けたい
result = agent.run_sync(
    "このチケットは緊急ですか? 内容: 二重請求で困っています..."
)
Jev にとっては、
このチケットは緊急ですか?
という部分も「判定対象のテキスト」です。
質問はフィールド側に置きます。
class Ticket(BaseModel):
    urgent: bool = Field(
        description="Does this need a reply within the hour?"
    )

    area: Literal["billing", "bug", "account", "other"] = Field(
        description="Which team owns it?"
    )


agent = Agent(
    "typesafe:jev-latest",
    output_type=Ticket,
)

result = agent.run_sync(
    "You have charged me twice and my account is now overdrawn. "
    "I need this reversed today."
)
4.2 「1フィールド1判断」にする
TypeSafe のガイドでは、「1つのフィールドでは1つのことだけを聞く」ことを “probably the most important concept” としています(Pydantic AI 公式ドキュメントより)。
つまり、複合判断を1フィールドに詰め込まないことがポイントです。
# ❌ 複数観点をまとめすぎている
class Pitch(BaseModel):
    good_pitch: bool = Field(
        description="Is this a good pitch?"
    )
これより、
class Pitch(BaseModel):
    """Assess a startup pitch."""

    large_market: bool = Field(
        description="Does this address a market worth more than $1B a year?"
    )

    technically_feasible: bool = Field(
        description="Could a small team build this with current technology?"
    )

    differentiated: bool = Field(
        description="Does it offer meaningful differentiation from competitors?"
    )

    @property
    def promising(self) -> bool:
        return (
            sum(
                [
                    self.large_market,
                    self.technically_feasible,
                    self.differentiated,
                ]
            )
            >= 2
        )
のように分解し、
判断
↓
Jev

判断をどう組み合わせるか
↓
Python
と分けるほうが Jev の性格に合っています。
Jev は同一リクエスト内の質問を独立・並列に評価します。
そのためフィールド数を増やしても、1問ずつ LLM に問い合わせるような構成にはなりません。
一方で、
A の回答を見てから B を判断する
という依存関係は、同じリクエストの別フィールドとして表現するのではなく、処理を別ステップに分けたほうがよいです。
5. confidence は「正解確率」ではない
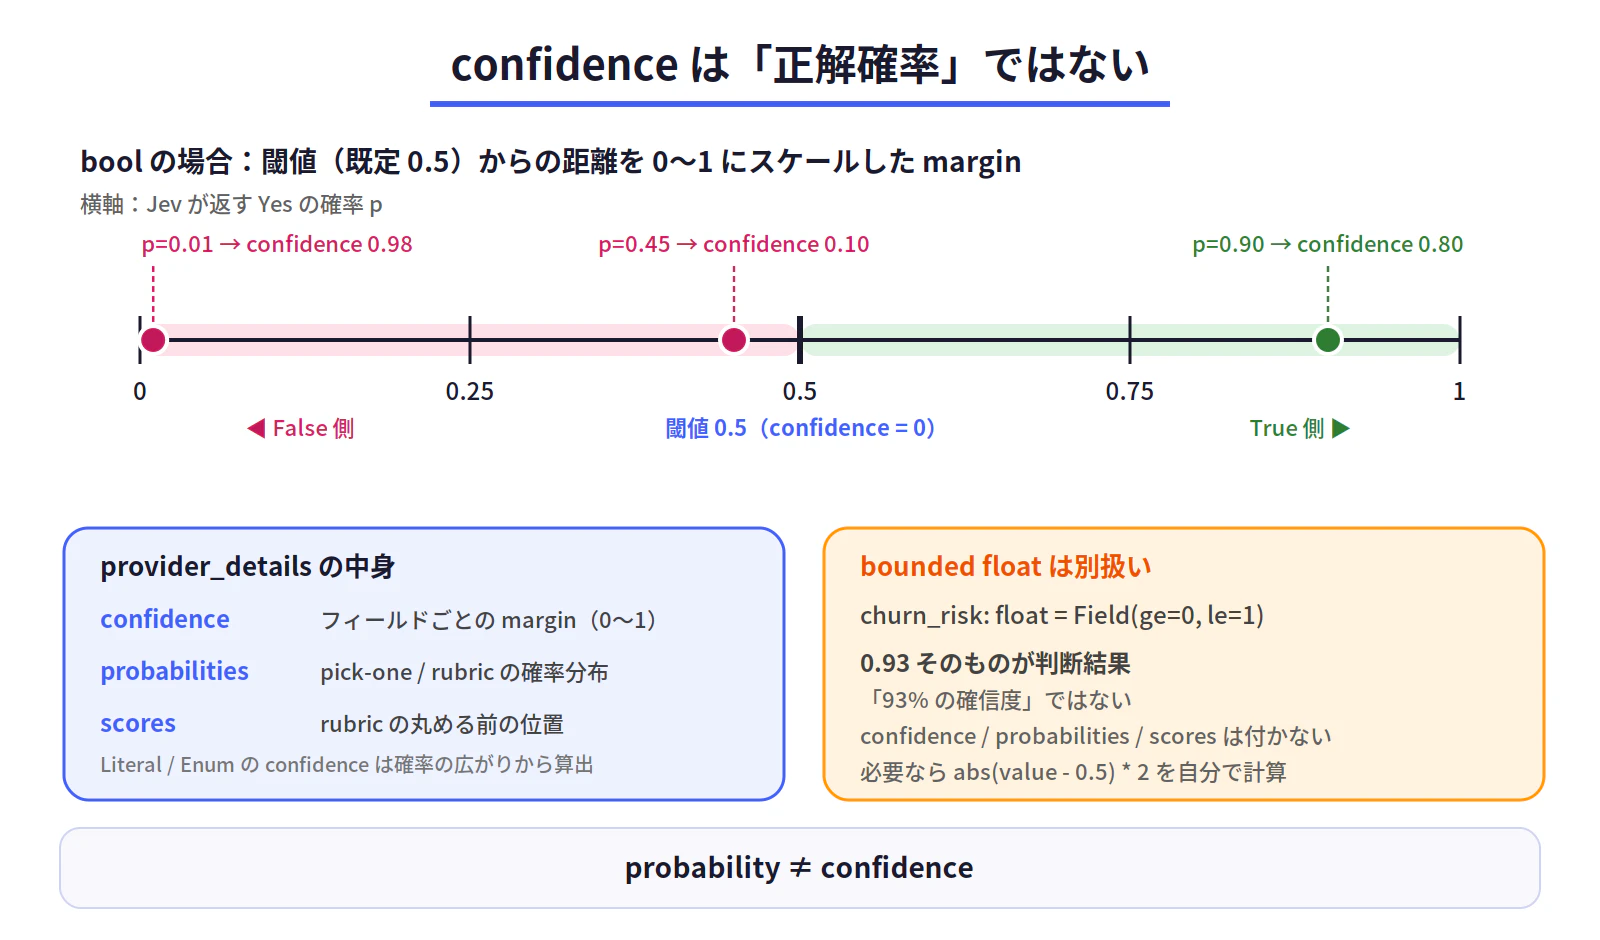
ここは、LLM の confidence 表現と混同しやすいところです。
Pydantic AI では、Jev の結果について
result.response.provider_details["confidence"]
からフィールド単位の confidence を取得できます。
ただし、これは単純な
この回答が正しい確率
ではありません。
Pydantic AI のドキュメントでは margin と説明されています。
たとえば bool では、既定の判定閾値 0.5 からどれだけ離れているかを、0〜1 にスケールした値です。
Yes probability = 0.50
→ confidence ≒ 0

Yes probability = 0.90
→ confidence は高い
という感覚です。
Literal や Enum などでは、候補間の確率分布から confidence が返ります。
また、
provider_details["probabilities"]
には、単一選択や rubric などで候補ごとの確率分布が入ります。
5.1 bounded float は別扱い
特に注意したいのが、
churn_risk: float = Field(ge=0, le=1)
のようなフィールドです。
この場合、
churn_risk = 0.93
という 0.93 自体が Jev の判断結果です。
これは、
「93% の確信度で churn_risk を判定した」
という意味ではありません。
bounded float には、
confidence
probabilities
scores
の別エントリは付きません。
たとえば同じような「閾値からの余裕」を見たいのであれば、既定閾値 0.5 の場合は Python 側で、
margin = abs(churn_risk - 0.5) * 2
のように計算できます。
この区別はかなり重要です。
probability
≠
confidence
です。
6. ベンチマークを見る
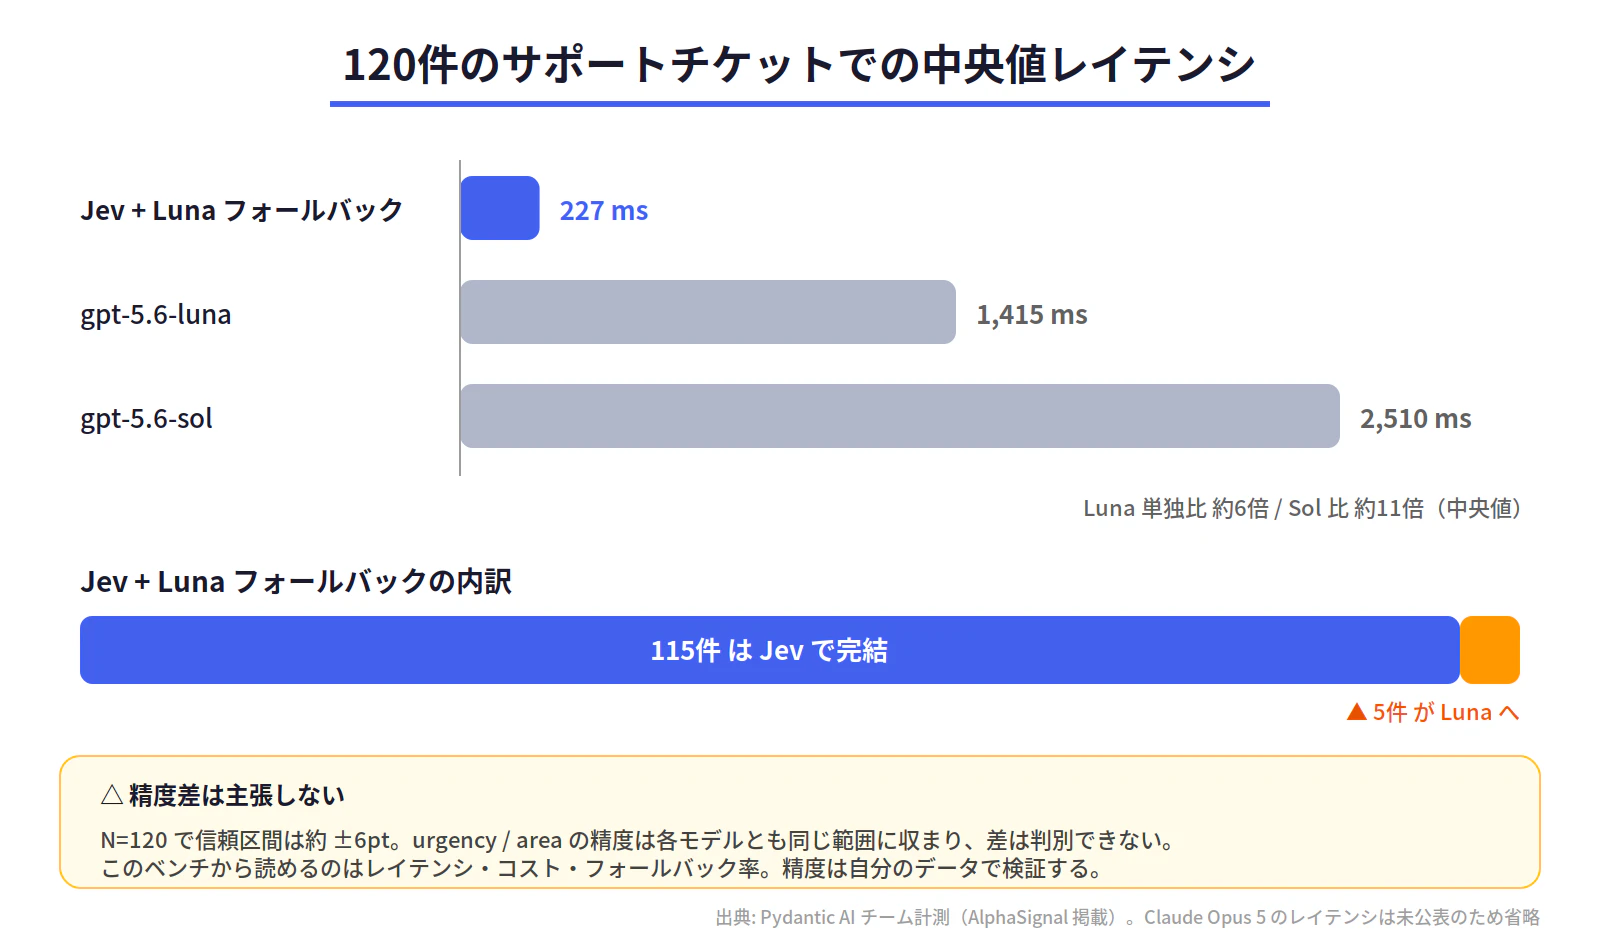
Pydantic 公式投稿で報告され、AlphaSignal が詳細な数値を整理している Pydantic AI チーム計測のベンチマークでは、120 件のサポートチケットと 3 個のツールを使って比較しています。なお、これは Pydantic 側による計測であり、第三者による独立検証ではありません。
| 構成 | 中央値レイテンシ | 報告されたバッチコスト |
|---|---|---|
| Jev + Luna フォールバック | 227 ms | Jev $0.004 + Luna フォールバック 5件 |
| gpt-5.6-luna | 1,415 ms | 未公表 |
| gpt-5.6-sol | 2,510 ms | $0.258 |
| Claude Opus 5 | 未公表 | $0.545 |
120 件中、
115件 → Jev
5件   → Luna へフォールバック
という結果です。
中央値レイテンシだけを見ると、
1,415 / 227 ≒ 6.2
なので、Luna 単独に対して約 6 倍高速です。
Sol と比べると約 11 倍になります。
6.1 精度差は強く主張しない
ここは重要です。
このベンチマークは N=120 と小さく、報告では信頼区間が約 ±6 ポイントあります。
また、ここでの精度比較は、サポートチケットの urgency と area の2項目を対象にしたものです。
そのため、比較したモデル間の精度差については、
Jev のほうが高精度
と断定できる結果ではありません。
このベンチから読み取りやすいのは、
レイテンシ
コスト
フォールバック率
です。
精度や閾値は、自分のデータで別途検証する必要があります。
6.2 Jev 自体の公称値
TypeSafe は Jev のエンドツーエンド応答時間を、
70 ms 〜 500 ms
としています。
料金は、
$0.042 / 1M input tokens
で、出力トークンは無料です。
Jev は文字列を逐次生成しないため、
出力が長いほど生成時間・出力課金が増える
という LLM の構造とは異なります。
この記事では、比較として再現条件が分かりやすい 120 件ベンチの中央値 227 ms を主に見ています。
7. ツール呼び出しは v2.46.0 で一段進んだ
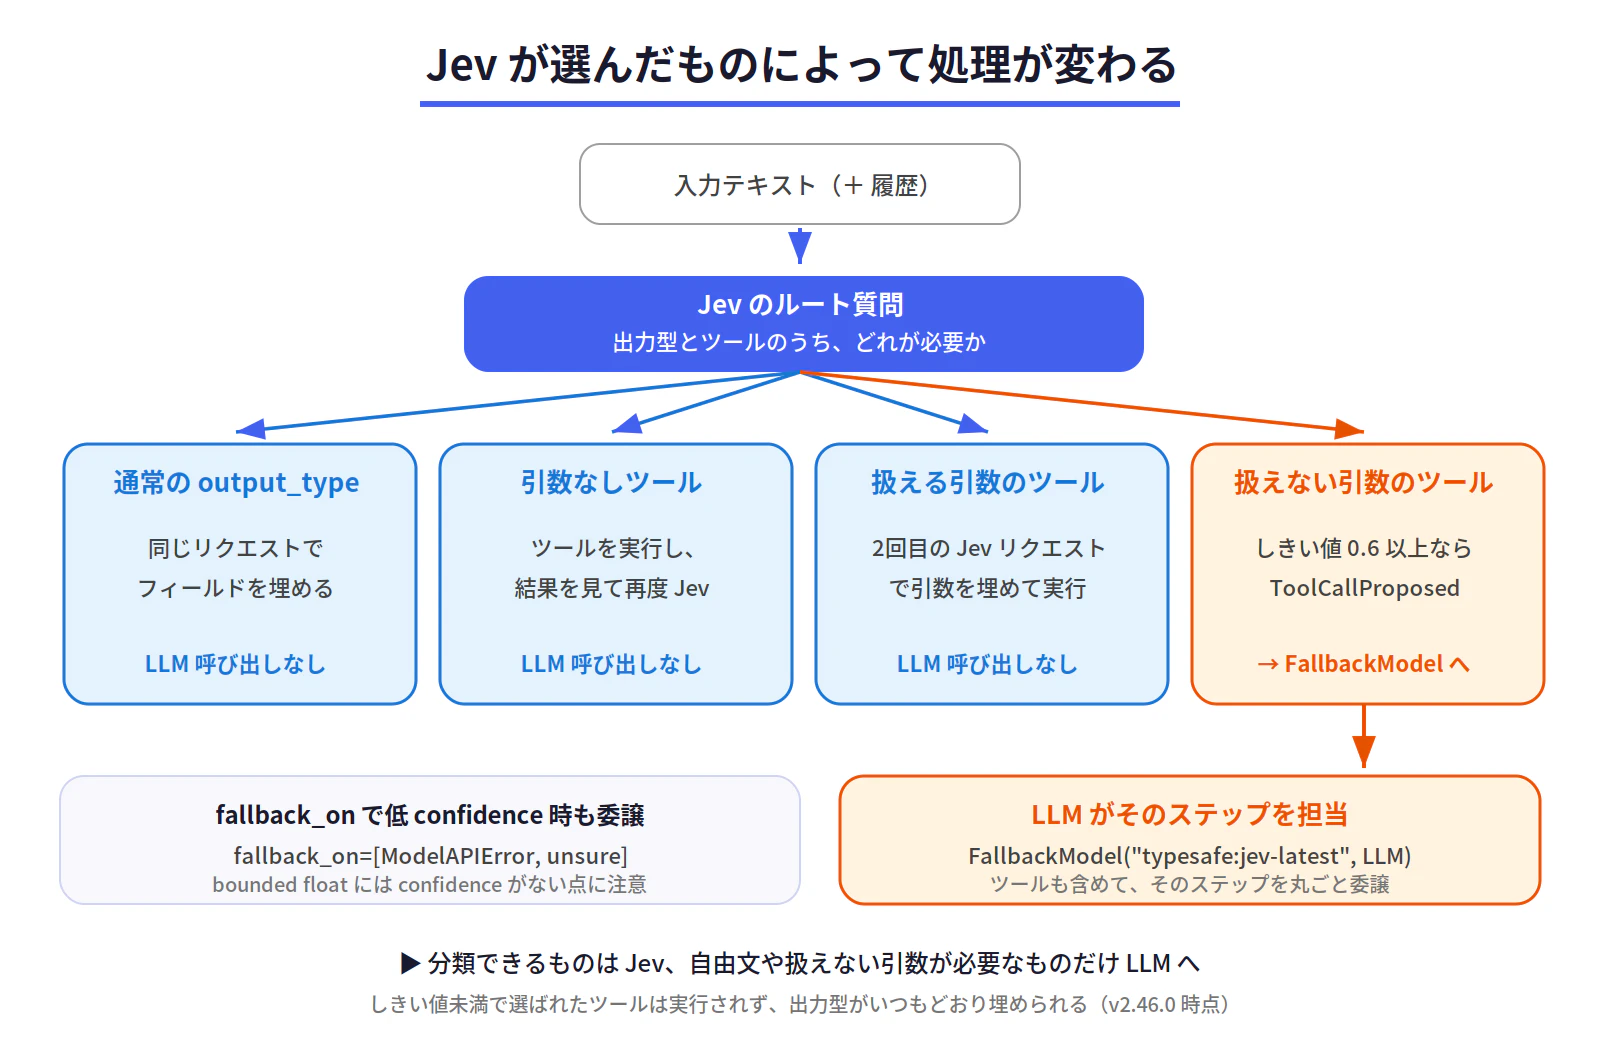
初期の TypeSafeModel 統合では、
ツールを選ぶ
ところが中心でした。
Pydantic AI v2.46.0 では、
Jev が表現できる型であれば、選んだツールの引数まで Jev が埋められる
ようになっています。
概念的には次のようになります。
| Jev が選んだもの | 処理 |
|---|---|
通常の output_type
|
同じリクエストでフィールドを埋める |
| 引数なしツール | そのままツールを実行 |
| Jev が扱える引数のツール | 2回目の Jev リクエストで引数を埋めて実行 |
| Jev が扱えない引数のツール | ツール選択の確率が typesafe_tool_call_threshold(既定 0.6)以上なら ToolCallProposed。Fallback があれば LLM に委譲 |
たとえば、
from typing import Literal


def change_direction(direction: Literal["left", "right"]) -> str:
    """Move the workflow in a direction.

    Args:
        direction: Which direction should the workflow take?
    """
    return f"Moved {direction}"
のような Literal 引数であれば Jev が扱えます。
一方、
def write_reply(message: str) -> str:
    ...
のような自由文字列 str を生成する必要があるツールは、Jev 単独では引数を埋められません。
そのツールが typesafe_tool_call_threshold(既定 0.6)以上で選ばれた場合は ToolCallProposed となり、Fallback が設定されていれば LLM 側へ委譲されます。
7.1 FallbackModel で LLM に渡す
Jev で扱えない処理は、FallbackModel を使って LLM に渡せます。
from pydantic_ai import Agent
from pydantic_ai.models.fallback import FallbackModel


model = FallbackModel(
    "typesafe:jev-latest",
    "openai:gpt-5.6-sol",
)

agent = Agent(
    model,
    output_type=Ticket,
)
たとえば、
分類できる
→ Jev

自由文を書く必要がある
→ LLM

Jev が扱えないツール引数が必要
→ LLM
という分担が可能です。
7.2 低 confidence のときだけ LLM に渡す
FallbackModel.fallback_on には、レスポンスを見て切り替えるハンドラも指定できます。
from pydantic_ai import ModelAPIError, ModelResponse
from pydantic_ai.models.fallback import FallbackModel


def unsure(response: ModelResponse) -> bool:
    details = response.provider_details or {}
    confidence = details.get("confidence", {})

    return any(value < 0.8 for value in confidence.values())


model = FallbackModel(
    "typesafe:jev-latest",
    "openai:gpt-5.6-sol",
    fallback_on=[
        ModelAPIError,
        unsure,
    ],
)
ここで ModelAPIError も明示しているのは、独自ハンドラだけを指定すると既定の API エラー時フォールバックを置き換えるためです。
なお前述の通り、bounded float には confidence がありません。
そのため、
float の値だけを output にした場合
は、この confidence ハンドラでは不確実性を拾えません。
必要なら float 値から独自の margin を計算して判断します。
8. どこに使うとよさそうか
向く
- サポートキューのルーティング
- PR や Issue のラベリング
- インシデントのカテゴリ・重大度判定
- モデレーション
- エージェント出力の評価
- ガードレールの一部
- モデルルーティング
- confidence を使った LLM へのフォールバック
- 定義済み候補から選ぶツールルーティング
共通しているのは、
答えの形が先に決まっている
ことです。
注意: Jev のようなモデルベースの判定は、入力文の影響を受ける可能性があります。
セキュリティや安全性に関わるガードレールでは、Jev の判定だけを決定的なチェックとして使うのではなく、ルールベースの検証などと組み合わせる前提で考えるのが安全です。データ送信について: Jev による判定では、プロンプトや、用途によっては会話履歴・ツール情報・ツール引数などが TypeSafe API へ送信されます。資格情報や顧客データなどを含みうる場合は、判定に必要な情報だけを渡す設計が重要です。
向かない / Jev 単独ではできない
- 自由文生成
- コード生成
- 自由な
strの生成 - ネイティブなファイル入力
- Jev が扱えない型のツール引数生成
また、エラーにはならなくても精度が落ちやすいものとして、公式ドキュメントでは次のような例が挙げられています。
- 算術
- カウント
- 日付の比較
- 1つの質問に複数判断を詰め込む
- 複数段の推論が必要な判断
- 判断に不要な長いコンテキスト
そのため、
計算できること
→ Python

明確な業務ルール
→ Code

曖昧だが型で表せる判断
→ Jev

生成・複雑な推論
→ LLM
と分けるのが分かりやすそうです。
9. 実運用前に見ておきたい3点
9.1 自分のデータで閾値を決める
Pydantic AI の公式ドキュメントでも、既定の threshold をそのまま本番判断に使うのではなく、
自分のラベル付きデータ
で調整することが推奨されています。
特に、
False Positive
False Negative
のコストが異なる判断では、0.5 をそのまま使う理由はありません。
9.2 jev-latest のまま本番運用しない
jev-latest は TypeSafe のリリースに合わせて移動します。
つまりモデル更新によって、
probability
confidence
の分布が変わる可能性があります。
閾値を本番データで調整した後は、
typesafe:jev-1.13.0
のようにバージョンを固定し、更新時に再評価するほうが安全です。
9.3 フォールバック率を見る
ハイブリッド構成では、精度だけでなく、
何%が LLM に渡ったか
を見る必要があります。
仮に精度が高くても、
ほぼ全部 LLM にフォールバック
しているのであれば、Jev を前段に置くメリットは小さくなります。
見る指標としては、
accuracy
latency
cost
fallback rate
の4つをセットにするとよさそうです。
10. まとめ ― 型システムを「推論の骨格」にする
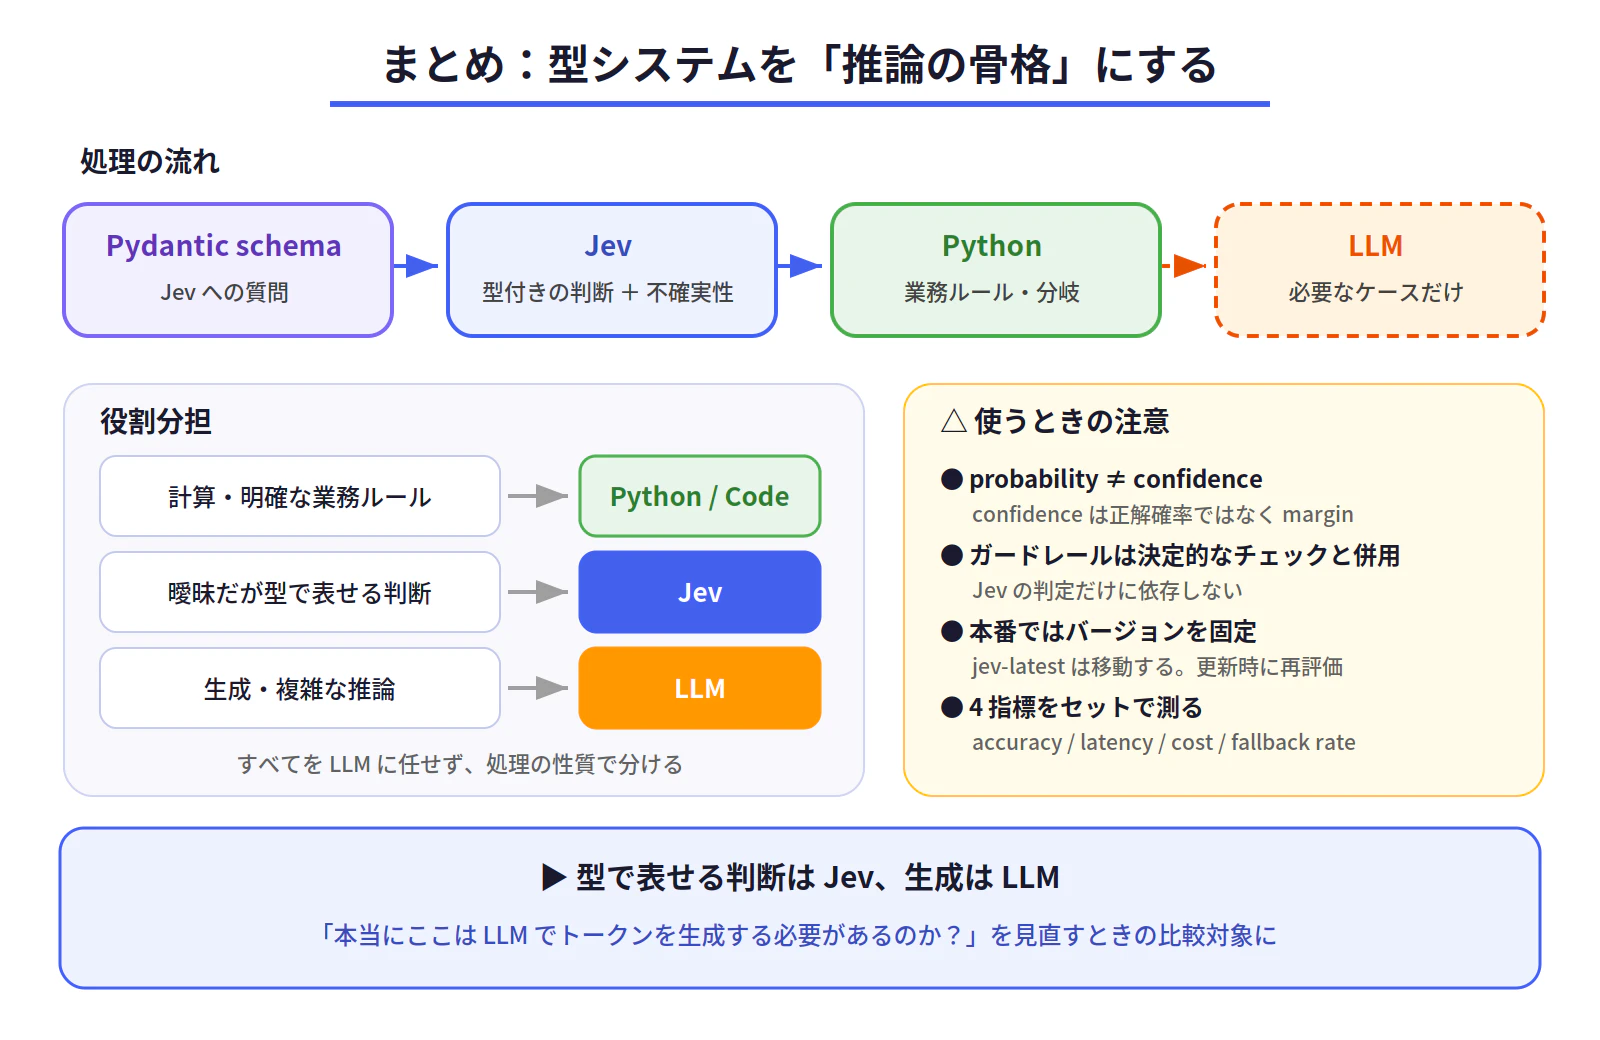
Jev の面白さは、
速い LLM
が出てきたことではありません。
むしろ、
LLM とは別レイヤーの分類・判断モデルを、Pydantic AI の型システムの中にそのまま組み込める
ところにあると思います。
整理すると、
Pydantic schema
      ↓
Jev への質問

Jev
      ↓
型付きの判断 + 不確実性

Python
      ↓
業務ルール・分岐

必要なケースだけ
      ↓
LLM
という構造になります。
特に面白いのは、
- Pydantic の schema がそのまま分類 API になる
- 複数の判断を1リクエストで並列評価できる
confidenceやprobabilitiesをコード側の分岐に使える- Jev が扱えるツール引数なら、ツール実行まで Jev 側で進められる
- 扱えない処理だけ
FallbackModelで LLM に渡せる
という点です。
一方で、
probability ≠ confidence
であり、
Jev に全部任せればよい
わけでもありません。
今回、公式情報を追っていて特に面白いと感じたのは、
Tree / 業務ルール → Code
曖昧な判断         → Jev
生成・複雑な処理   → LLM
のように、すべてを LLM に任せるのではなく、処理の性質によって役割を分けられる点です。
特にセキュリティや安全性に関わるガードレールでは、Jev の判定だけに依存せず、決定的なルールや検証処理と組み合わせる前提で考える必要があります。
Pydantic AI の中で、
「本当にここは LLM でトークンを生成する必要があるのか?」
という処理を見直すとき、Jev は比較対象のひとつになりそうです。
今回は公式情報を中心に整理しましたが、次に試すなら小さな分類タスクを用意して、
精度
レイテンシ
コスト
fallback rate
を実測してみると、より具体的に特徴が見えてきそうです。
参考リンク
- Pydantic AI 公式ドキュメント:TypeSafe (Jev)
- Pydantic AI Releases
- Pydantic 公式 LinkedIn ― Jev integration announcement
- Pydantic Blog ― High-volume AI scoring with Jev and Pydantic Evals
- PR #8450 ― Add TypeSafeModel for TypeSafe's Jev
- PR #8501 ― Let TypeSafeModel fill a tool's arguments when Jev can express them
- TypeSafe AI ― Introducing System One Models & Jev
- AlphaSignal ― Pydantic AI Adds Jev to Cut Classification Latency 6x Without Generating Tokens(二次情報)
- TypeSafe AI
- awesome-jev