
はじめに
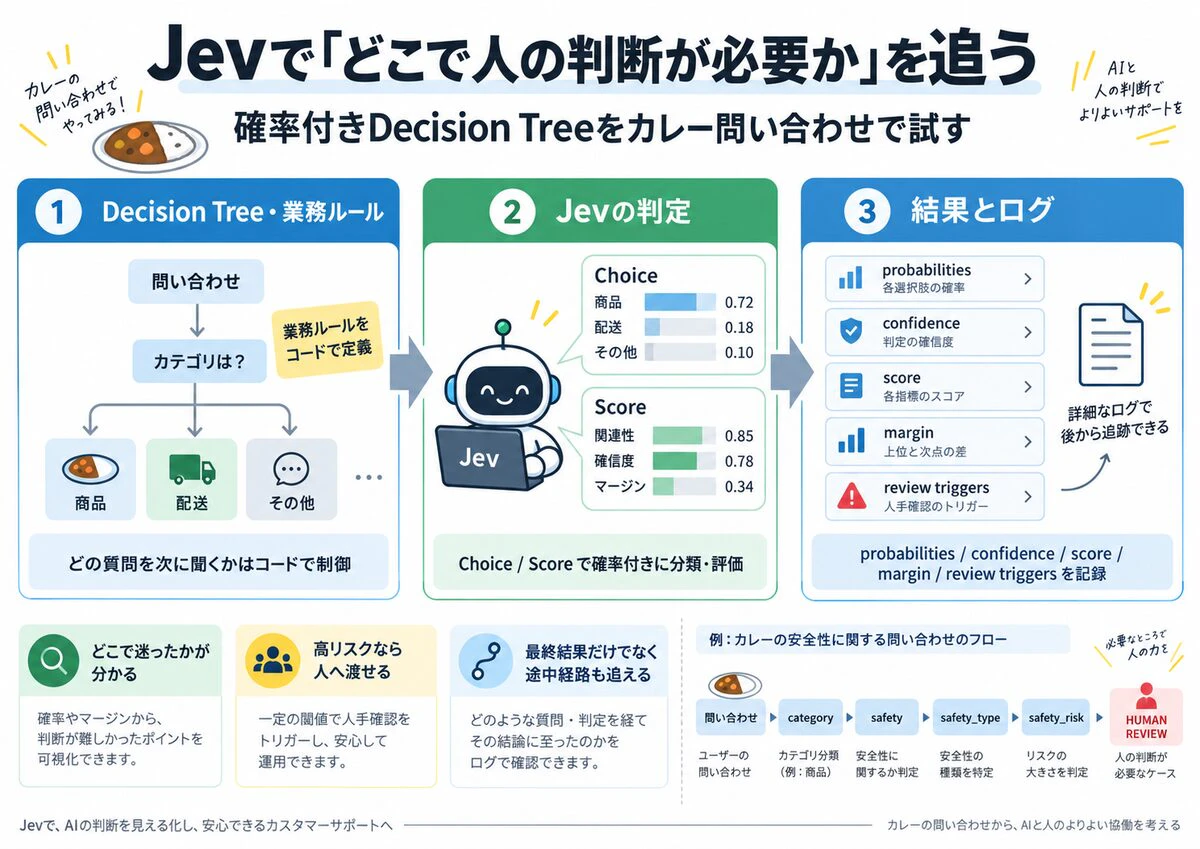
AIを業務フローに組み込むとき、最終結果だけでなく、
- どの判断を通って、その結果になったのか
- どこで判断が曖昧だったのか
- どの時点で人に渡したのか
まで追えると、運用しやすくなります。
今回はTypeSafe AIの判定特化型モデル Jev を使い、カレー店への問い合わせを題材に、確率付きDecision Treeを試しました。
ポイントは、Jevに処理全体を自由に決めてもらうのではなく、
Decision Tree・業務ルール
        ↓
       Code

曖昧な分類・評価
        ↓
       Jev
と役割を分けることです。
各ノードの probabilities、confidence、score をログに残し、最終的にHuman Reviewになった場合も、どのノードが原因だったのかまで追えるようにしました。
※本記事は仕組みを見るためのスモークテストです。
カレー店の問い合わせを単純化した題材であり、食品安全や実運用の判断基準を示すものではありません。
Jevとは
Jevは、TypeSafe AIが2026年9月15日に公開した最初のSystem One Modelです。
文章を生成することより、ソフトウェアから利用する型付きの判定に重点を置いています。
TypeSafeのWorkflow evalsでは、主に次の判定が紹介されています。
| 種類 | 用途 |
|---|---|
Noul |
Yes / No のような二値判断 |
Choice |
定義した候補から選択 |
Score |
段階評価をもとにスコアリング |
Choice では候補ごとの確率分布とconfidence、Score ではscore、レベルごとの確率分布、confidenceを取得できます。
今回は ロリポップ!AIゲートウェイ 経由で typesafe/jev-latest を利用しました。
参考:
- TypeSafe AI: https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe AI Models: https://docs.typesafe.ai/models
- Workflow evals: https://evals.typesafe.ai/
- ロリポップ!AIゲートウェイ: https://lolipop.jp/ai/gateway/info/product/2026-09-18/
なお、TypeSafeのModelsドキュメントでは、英語が主要な学習言語で現状もっとも精度が高く、CJKを含む他言語も扱えるものの同等ではないとされています。非英語のワークロードでは、自分のデータで評価し、confidenceにも注意することが推奨されています。
本記事は日本語の問い合わせだけで試しているため、この点は結果を見る際の前提とします。
確認日: 2026-09-22
今回検証すること
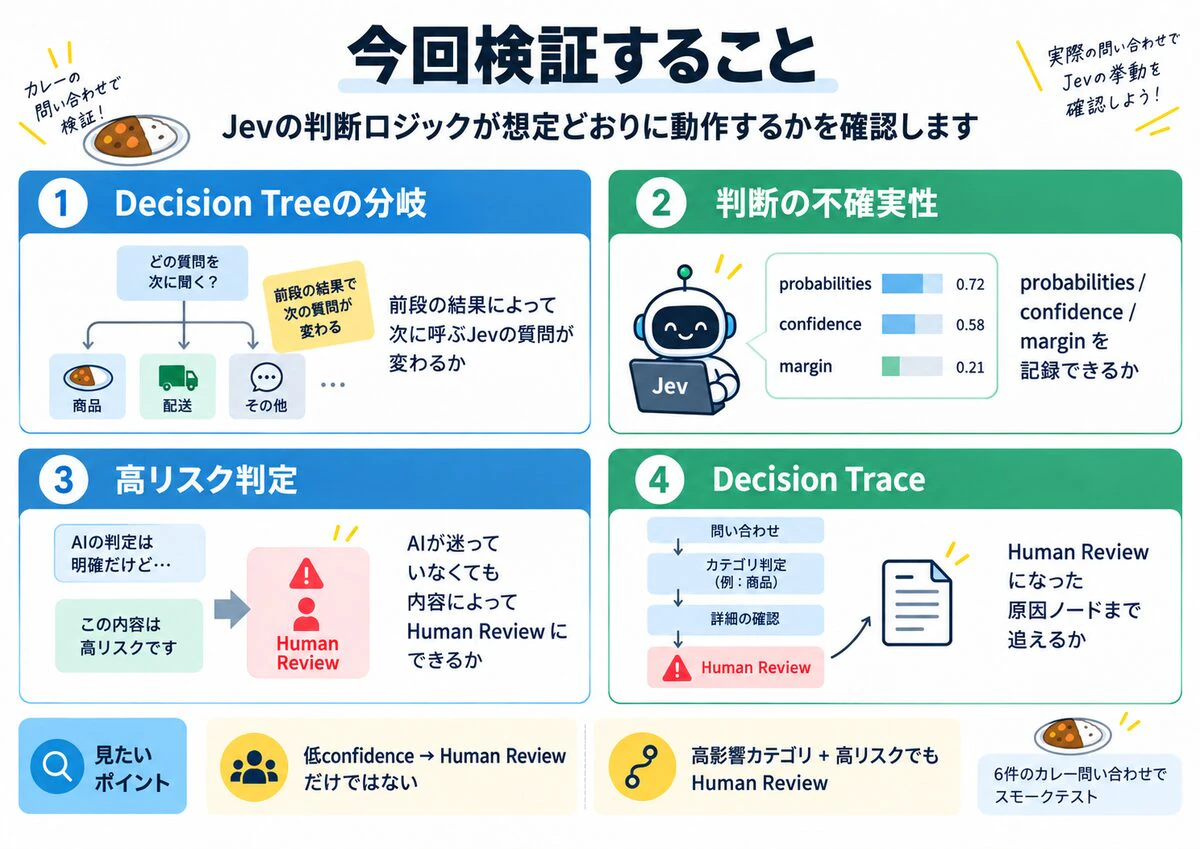
今回は、次の4点を確認しました。
| # | 検証項目 | 見たいこと |
|---|---|---|
| 1 | Decision Treeの分岐 | 前段の結果によって次に呼ぶJevの質問が変わるか |
| 2 | 判断の不確実性 |
probabilities / confidence / margin を記録できるか |
| 3 | 高リスク判定 | AIが迷っていなくても内容によってHuman Reviewにできるか |
| 4 | Decision Trace | Human Reviewになった原因ノードまで追えるか |
特に見たかったのは、単純に
confidenceが低い
    ↓
Human Review
だけではなく、
confidenceは高い
    +
内容の影響が大きい
    ↓
Human Review
という経路も扱えるかです。
Decision Tree
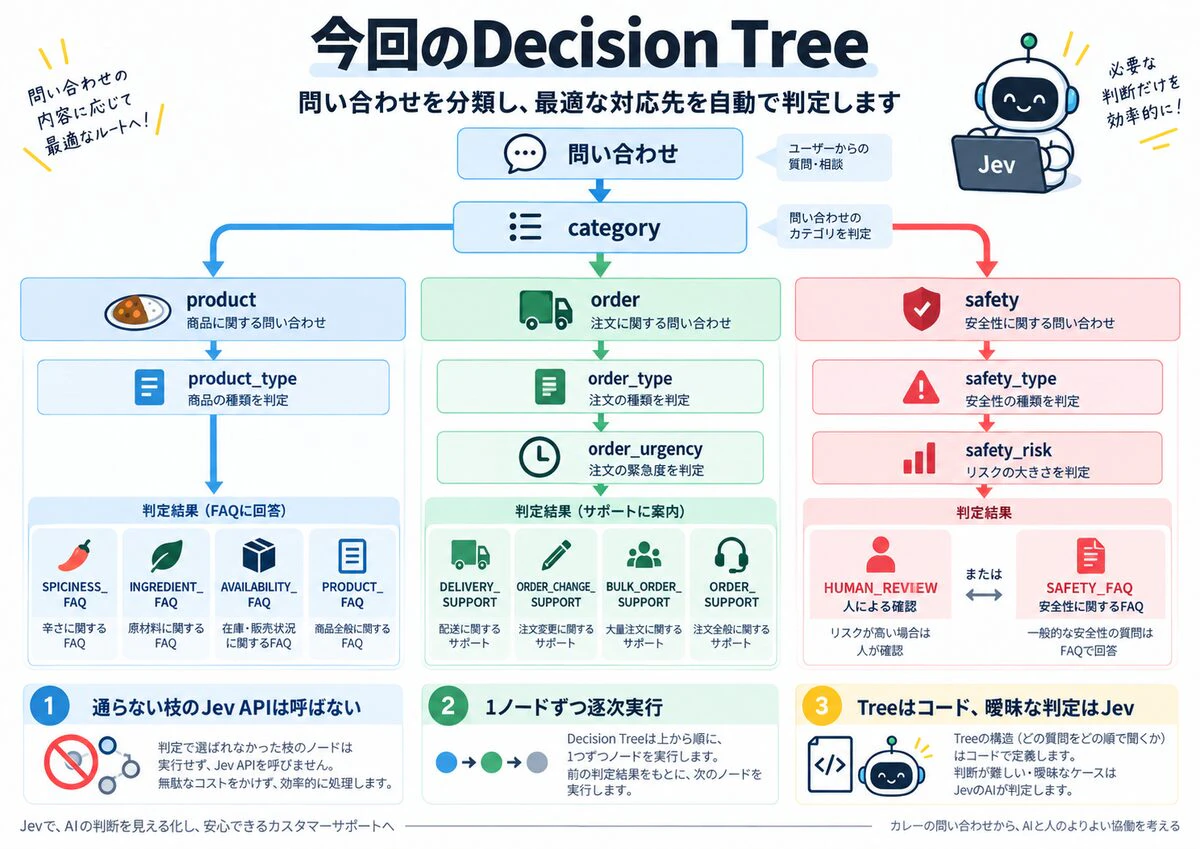
今回のTreeは次のようにしました。
問い合わせ
    |
    v
 category
    |
    +-- product
    |      |
    |      +--> product_type
    |
    +-- order
    |      |
    |      +--> order_type
    |              |
    |              +--> order_urgency
    |
    +-- safety
           |
           +--> safety_type
                    |
                    +--> safety_risk
例えば、配送問い合わせなら、
category
   ↓
order
   ↓
order_type
   ↓
delivery
   ↓
order_urgency
   ↓
DELIVERY_SUPPORT
となります。
アレルギー問い合わせなら、
category
   ↓
safety
   ↓
safety_type
   ↓
allergy
   ↓
safety_risk
   ↓
HUMAN_REVIEW
となります。
通らない枝のJev APIは呼びません。
記録する値
各ノードでは次の値を記録しました。
| 項目 | 内容 |
|---|---|
decision |
Choiceで選ばれた候補 |
probabilities |
各候補・レベルの確率分布 |
confidence |
Jevが返すconfidence |
score |
Scoreで返る値 |
top_p |
最大確率。検証コード側で算出 |
margin |
1位と2位の確率差。検証コード側で算出 |
latency_ms |
API呼び出し時間 |
Human Reviewの理由は各ノードのTraceそのものに埋め込むのではなく、ケース単位の review_triggers として別途保持しています。後述する results.json に保存し、summary.csv では review_reason 列に集約しています。
margin はJevが直接返す値ではなく、今回の検証コードで、
margin = top1_probability - top2_probability
として算出しています。
Human Reviewの仮ルール
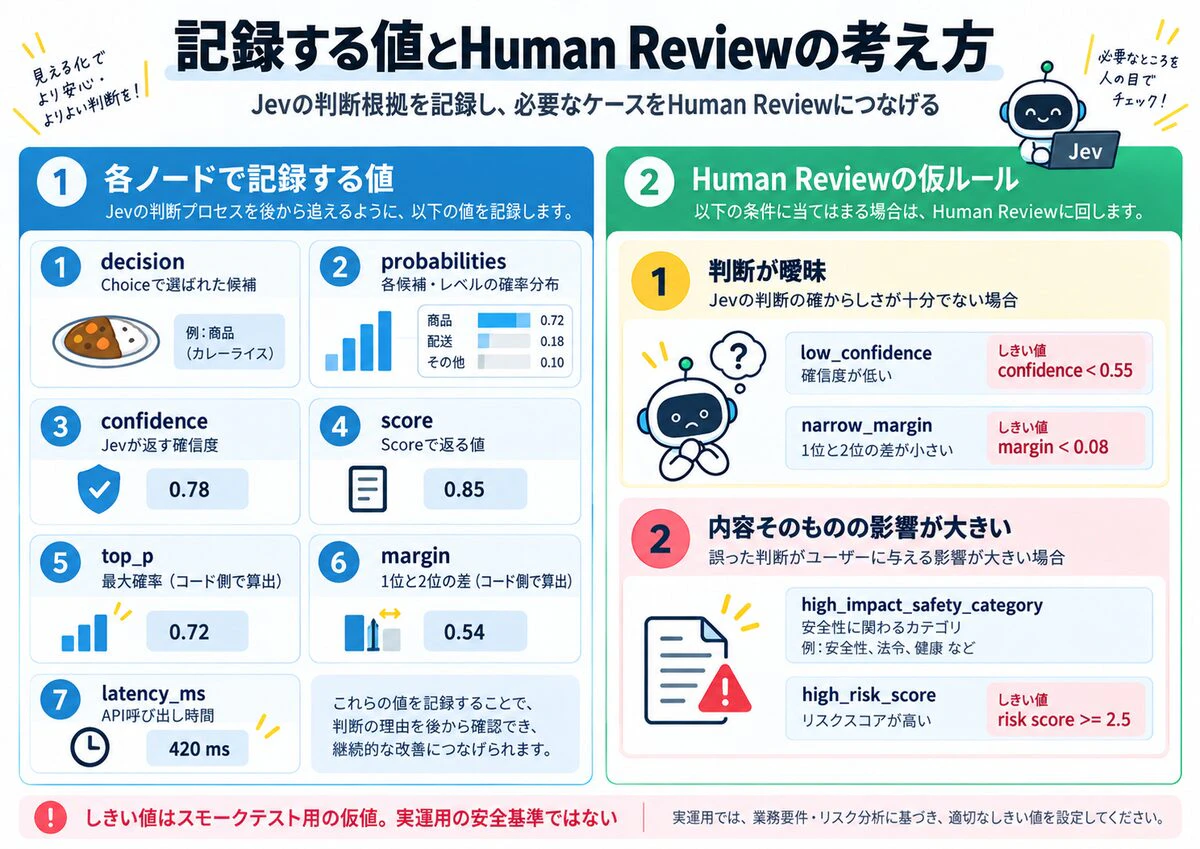
今回はスモークテスト用に次の値を設定しました。
REVIEW_CONFIDENCE_THRESHOLD = 0.55
REVIEW_MARGIN_THRESHOLD = 0.08
REVIEW_RISK_SCORE_THRESHOLD = 2.50
また、
HIGH_IMPACT_SAFETY = {
    "allergy",
    "illness",
    "foreign_object",
}
を高影響カテゴリとして扱いました。
つまりHuman Reviewになる理由は、大きく分けて次の2種類です。
判断が曖昧
  - low_confidence
  - narrow_margin

内容そのものの影響が大きい
  - high_impact_safety_category
  - high_risk_score
これらの値は、今回のスモークテスト用に仮置きしたものです。
Jevの推奨しきい値や、実運用上の安全基準ではありません。
テストケース
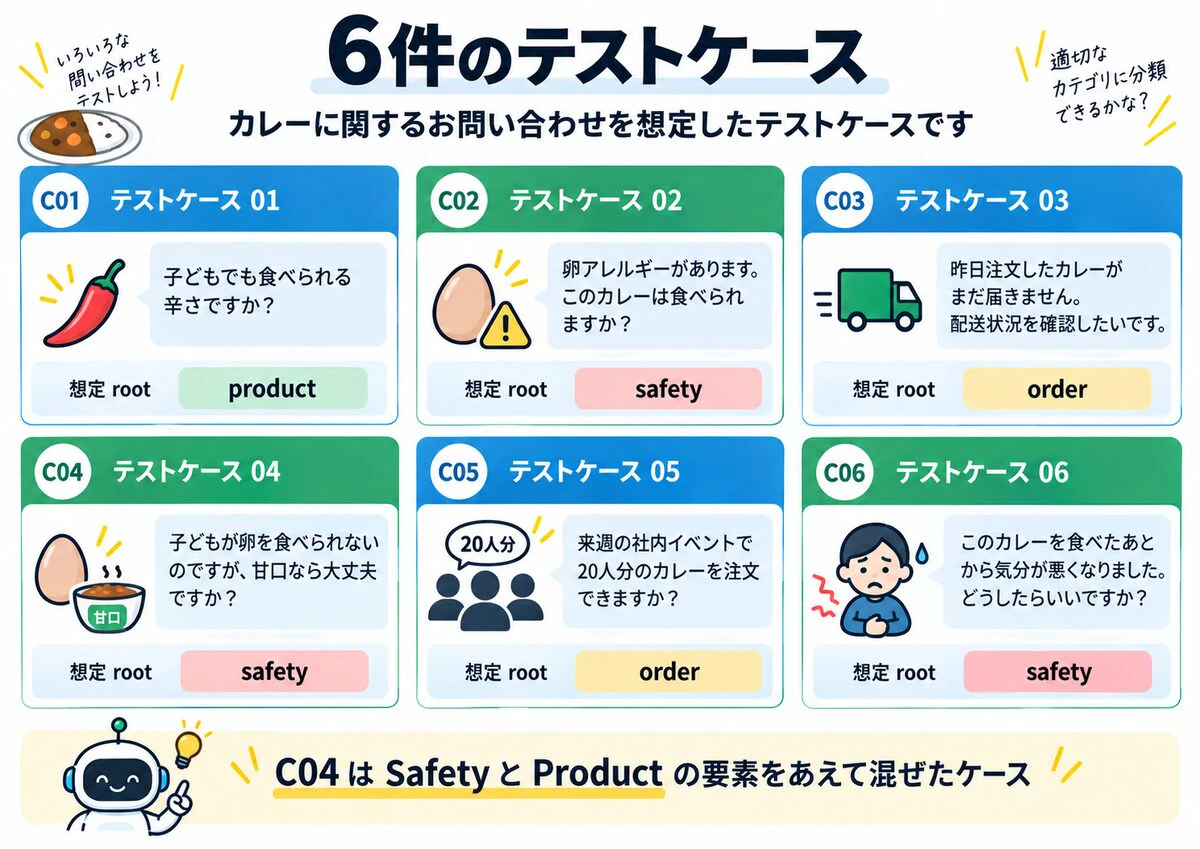
6件を用意しました。
| ID | 問い合わせ | 想定root |
|---|---|---|
| C01 | 子どもでも食べられる辛さですか? | product |
| C02 | 卵アレルギーがあります。このカレーは食べられますか? | safety |
| C03 | 昨日注文したカレーがまだ届きません。配送状況を確認したいです。 | order |
| C04 | 子どもが卵を食べられないのですが、甘口なら大丈夫ですか? | safety |
| C05 | 来週の社内イベントで20人分のカレーを注文できますか? | order |
| C06 | このカレーを食べたあとから気分が悪くなりました。どうしたらいいですか? | safety |
C04は、あえて
- 「卵を食べられない」→ Safety
- 「甘口なら?」→ Product
という2つの要素を混ぜています。
ここでどんな確率になるかも確認します。
実装の要点
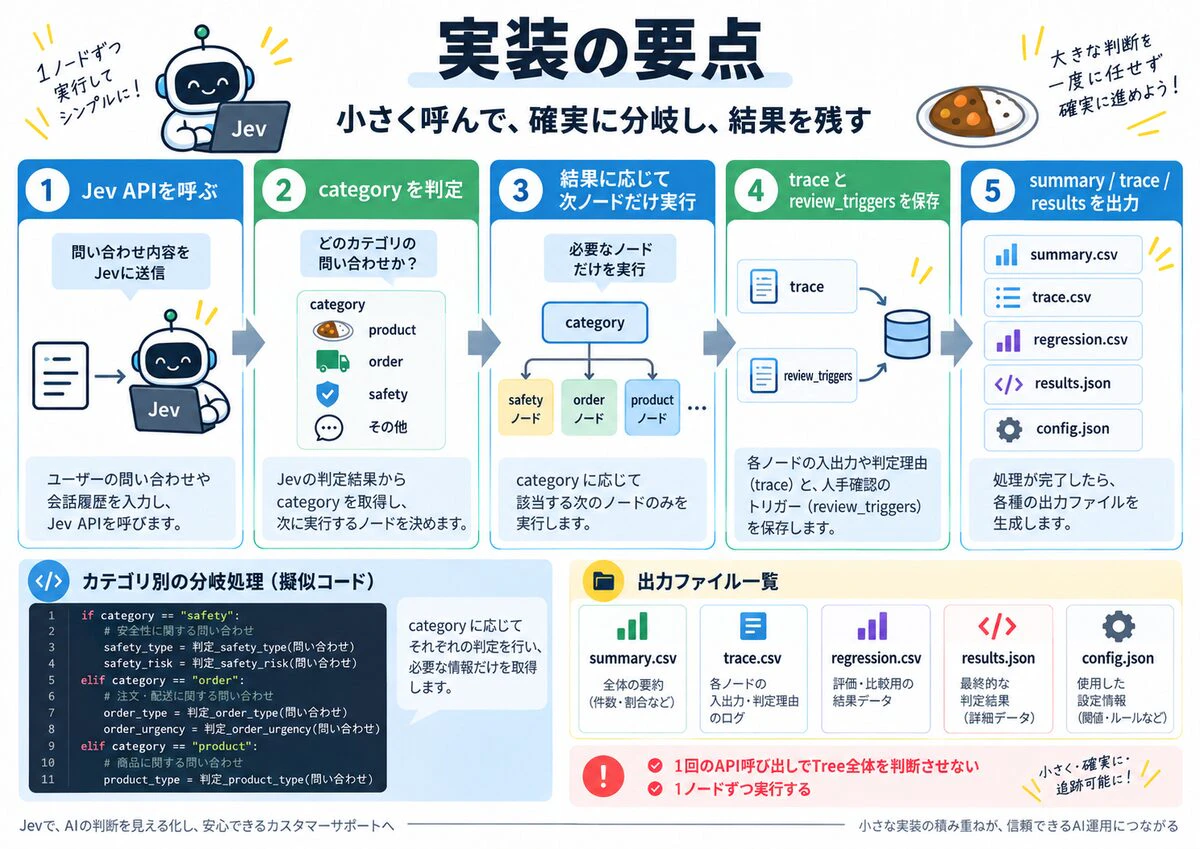
検証用の実装のため、汎化性については十分に考慮できていません。
1. 1ノードずつJevを呼ぶ
Decision Treeを逐次実行するため、1回のAPI呼び出しでTree全体を判断させるのではなく、1ノードずつ呼び出します。
※以下は処理の要点だけを抜粋しています。APIキーの読み込み、timeout、エラー処理などを含む実行コード全文は記事後半に載せています。
def call_jev(state, question_id, question):
    r = requests.post(
        "https://ai-gateway.lolipop.jp/v1/systemone",
        headers={
            "Authorization": f"Bearer {API_KEY}",
            "Content-Type": "application/json",
        },
        json={
            "model": "typesafe/jev-latest",
            "state": state,
            "questions": {
                question_id: question
            },
        },
    )

    return r.json()["answers"][question_id]
2. rootはChoiceで判定
以下は実際に検証で使った Q_CATEGORY です。
Q_CATEGORY = {
    "type": "choice",
    "instructions": (
        "カレー店への問い合わせを、最初に処理すべき観点で1つに分類してください。"
        "明示的なアレルギー、体調不良、異物、衛生上の問題など、"
        "健康・安全上の懸念が示されている場合は safety を最優先してください。"
        "一方、単なる辛さ、甘口・中辛・辛口、子ども向けかどうかの質問は product としてください。"
        "「子ども」という語だけを理由に safety を選ばないでください。"
    ),
    "criteria": {
        "safety": (
            "明示的なアレルギー、体調不良、異物、衛生問題など、"
            "誤った回答が健康・安全に影響し得る問い合わせ"
        ),
        "order": "注文済み商品の配送、注文変更、キャンセル、返金、大口注文",
        "product": (
            "辛さ、甘口・中辛・辛口、味、子ども向けかどうか、"
            "通常の原材料、商品内容、在庫などの商品質問。"
            "明示的なアレルギー・健康懸念は含めない"
        ),
        "other": "上記のどれにも明確に当てはまらない問い合わせ",
    },
}
事前の試行では、C01の「子どもでも食べられる辛さですか?」という問い合わせがProductとSafetyの間で曖昧になる結果が見られました。そのため、ProductとSafetyの境界条件を明示した版を最終検証に使っています。
3. 前の判断結果で次のノードを変える
category = run_node("category", Q_CATEGORY)

if category.decision == "safety":
    safety_type = run_node("safety_type", Q_SAFETY_TYPE)
    risk = run_node("safety_risk", Q_SAFETY_RISK)

elif category.decision == "order":
    order_type = run_node("order_type", Q_ORDER_TYPE)
    urgency = run_node("order_urgency", Q_ORDER_URGENCY)

elif category.decision == "product":
    product_type = run_node("product_type", Q_PRODUCT_TYPE)
ここが今回のDecision Tree部分です。
実行結果
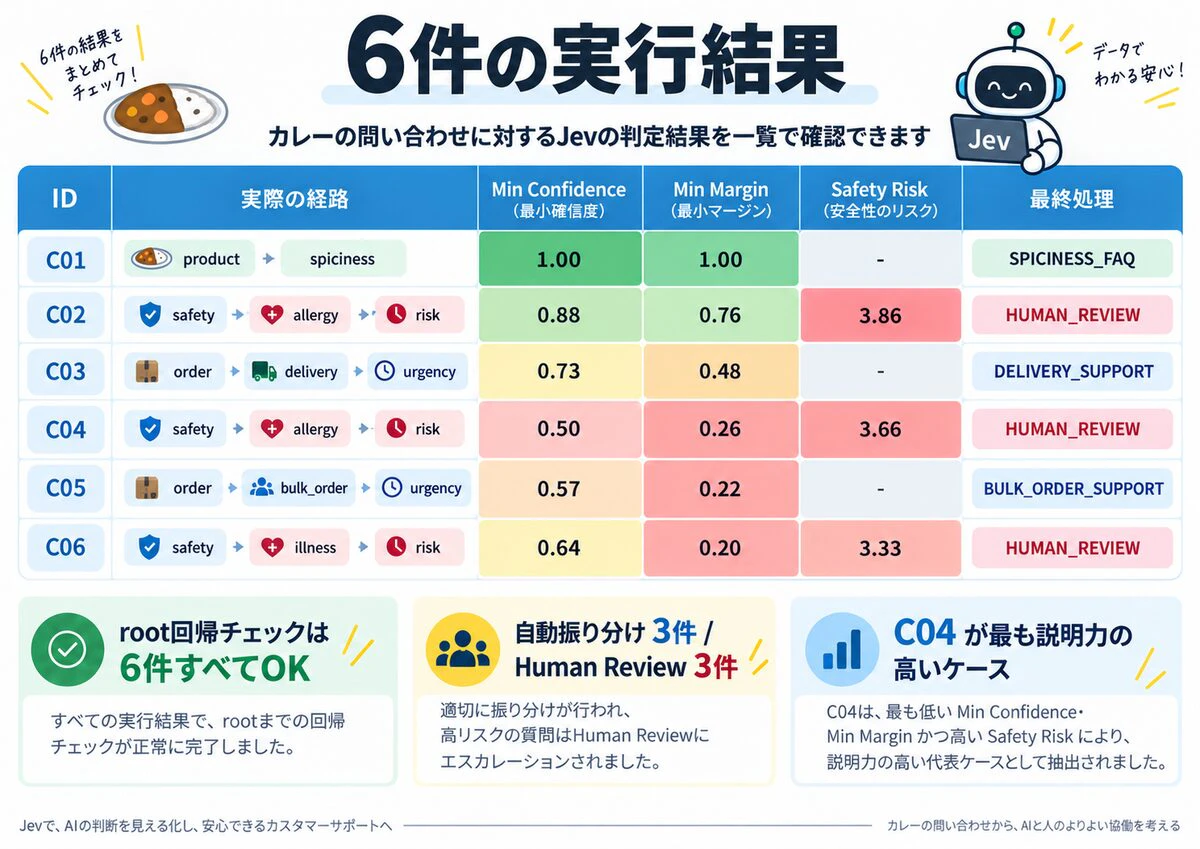
2026-09-22に実行した結果です。
| ID | 実際の経路 | Min Confidence | Min Margin | Safety Risk | 最終処理 |
|---|---|---|---|---|---|
| C01 | product → spiciness | 1.00 | 1.00 | - | SPICINESS_FAQ |
| C02 | safety → allergy → risk | 0.88 | 0.76 | 3.86 | HUMAN_REVIEW |
| C03 | order → delivery → urgency | 0.73 | 0.48 | - | DELIVERY_SUPPORT |
| C04 | safety → allergy → risk | 0.50 | 0.26 | 3.66 | HUMAN_REVIEW |
| C05 | order → bulk_order → urgency | 0.57 | 0.22 | - | BULK_ORDER_SUPPORT |
| C06 | safety → illness → risk | 0.64 | 0.20 | 3.33 | HUMAN_REVIEW |
rootの回帰チェックは6件すべて想定どおりでした。
C01 product → product  OK
C02 safety  → safety   OK
C03 order   → order    OK
C04 safety  → safety   OK
C05 order   → order    OK
C06 safety  → safety   OK
今回の6件では、
- 自動振り分け: 3件
- Human Review: 3件
となりました。
Jevは確率的なモデルなので、同じ入力でも確率やconfidence、scoreが毎回完全に同じ値になるとは限りません。
ここに載せている数値は、2026-09-21の今回の実行結果です。
C01: 商品問い合わせはそのままFAQへ
子どもでも食べられる辛さですか?
結果は、
category
  product = 1.00
  confidence = 1.00

        ↓

product_type
  spiciness = 1.00
  confidence = 1.00

        ↓

SPICINESS_FAQ
となりました。
単に「子ども」という語が含まれるだけではSafetyにせず、辛さに関する商品質問として処理できています。
C02: 判断は明確でもHuman Review
卵アレルギーがあります。
このカレーは食べられますか?
結果は、
category
  safety = 1.00
  confidence = 1.00

        ↓

safety_type
  allergy = 1.00
  confidence = 1.00

        ↓

safety_risk
  score = 3.86 / 4
  confidence = 0.88

        ↓

HUMAN_REVIEW
ここではJevはほとんど迷っていません。
それでもHuman Reviewにしています。
理由は、
high_impact_safety_category = allergy
high_risk_score = 3.86
だからです。
「AIが確信している」と「自動処理してよい」は別問題として扱っています。
C04: どこで迷ったかが見える
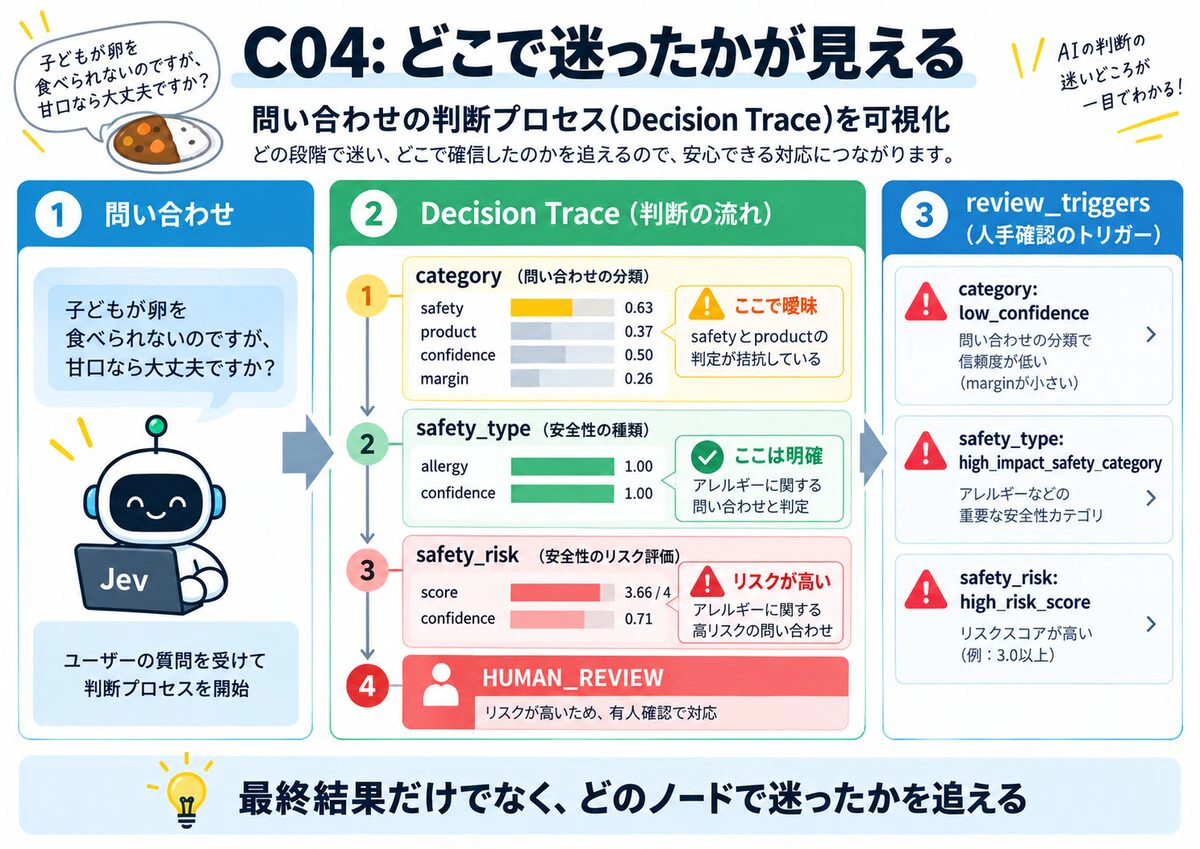
今回、特に面白かったのがC04です。
子どもが卵を食べられないのですが、
甘口なら大丈夫ですか?
rootでは、
safety  = 0.63
product = 0.37

confidence = 0.50
margin     = 0.26
となりました。
Safetyが選ばれていますが、Productにも37%残っています。
一方、その次のノードでは、
safety_type
  allergy = 1.00
  confidence = 1.00
でした。
さらに、
safety_risk
  score = 3.66 / 4
  confidence = 0.71
となっています。
全体を並べると、
問い合わせ
    |
    v

category
safety  0.63
product 0.37
confidence 0.50
    |
    |  ← ここで曖昧
    v

safety_type
allergy 1.00
confidence 1.00
    |
    |  ← Safetyに入った後は明確
    v

safety_risk
score 3.66 / 4
    |
    v

HUMAN_REVIEW
Human Reviewの原因ログは、
category:
  low_confidence

safety_type:
  high_impact_safety_category

safety_risk:
  high_risk_score
でした。
ここが今回一番見たかったところです。
最終結果だけなら、
HUMAN_REVIEW
で終わります。
Decision Traceを残すことで、
最初のSafety / Productでは迷った
しかしSafetyに入った後のAllergy判定は明確だった
最後にRiskが高かった
ところまで追えます。
C03・C05: Urgency Scoreは振り分けに使い、Human Reviewの条件にはしない
C03の配送遅延では、
order_urgency
score      = 2.11
confidence = 0.73
となりましたが、DELIVERY_SUPPORT に流れました。
C05の大口注文では、
order_urgency
score      = 1.39
confidence = 0.57
でした。
ここで重要なのは、今回のTreeではUrgency ScoreそのものをHuman Reviewの条件に使っていないことです。高urgencyの問い合わせが来た場合は、優先キューへの振り分けなどに利用する想定です。
一方、C05のconfidence 0.57 は、今回のHuman Reviewしきい値 0.55 との差が 0.02 しかありません。
Jevの出力値は実行ごとに多少変動し得るため、再実行ではしきい値を下回る可能性もあります。しきい値付近のケースをどう扱うかは、実運用では別途設計が必要です。
ここからも、
Scoreが存在することと、そのScoreをどの業務ルールに使うかは別
ということが分かります。
Decision Traceを残す意味
今回の trace.csv には、ノード単位で次の値を保存しました。
case_id
node
decision
probabilities
top_p
confidence
margin
score
latency_ms
final_action
human_review
一方、Human Reviewになった理由はケース単位の review_triggers として保持しています。
-
results.json:review_triggersを詳細なリストとして保存 -
summary.csv:review_reason列に原因を集約 -
trace.csv: ノード単位の判定値を保存し、review_trigger自体は含めない
これにより、Human Reviewが増えたときに、
- root分類が曖昧なのか
- 特定カテゴリだけ人に流れているのか
- Risk Scoreのルールが厳しすぎるのか
- Decision Treeの設計自体を見直すべきなのか
を後から追いやすくなります。
個人的には、Jevのような確率付き判定モデルを使う面白さは、最終ラベルだけではなく途中の判断も観測できることにあると感じました。
色付きMatrixで見る
今回のプログラムでは、結果をPandas Stylerでも表示しています。
考え方としては、
Confidence
  高い   → 緑
  中間   → 黄
  低い   → 赤

Margin
  大きい → 緑
  中間   → 黄
  小さい → 赤

Safety Risk
  低い   → 緑
  中間   → 黄
  高い   → 赤
としています。
なお、この可視化用の色分けしきい値とHuman Reviewのしきい値は別です。
色は状況を眺めやすくするための補助であり、その色だけで自動処理可否を決めているわけではありません。
検証用プログラム全文
本文ではポイントだけ抜き出しました。
実際にColabで実行した検証コードは以下です。
検証用Pythonを開く
# Jev × カレー問い合わせ:Qiita記事用 最終検証
#
# 目的:
# - 前段の判断結果によって次のノードが変わるDecision Treeを実行する
# - 各ノードの probabilities / confidence / score を記録する
# - top_p / margin を検証コード側で算出する
# - Human Reviewになった原因ノードを保存する
# - 6ケースのroot routingを回帰チェックする
#
# 注意:
# - しきい値は本記事のスモークテスト用の仮値
# - 安全性や実運用の推奨値を意味しない
# - marginはJevの出力値ではなく、top1 - top2 をコード側で算出
#
from __future__ import annotations
import getpass
import json
import os
import time
from dataclasses import dataclass, asdict
from pathlib import Path
from typing import Any, Dict, List, Optional, Tuple
import pandas as pd
import requests
from IPython.display import display
BASE_URL = "https://ai-gateway.lolipop.jp"
ENDPOINT = f"{BASE_URL}/v1/systemone"
MODEL = "typesafe/jev-latest"
# -----------------------------
# スモークテスト用の仮しきい値
# -----------------------------
# Human Review 判定用
REVIEW_CONFIDENCE_THRESHOLD = 0.55
REVIEW_MARGIN_THRESHOLD = 0.08
REVIEW_RISK_SCORE_THRESHOLD = 2.50 # Score 0〜4想定
# 可視化用(routingとは別)
VIS_CONF_YELLOW = 0.60
VIS_CONF_GREEN = 0.80
VIS_MARGIN_YELLOW = 0.15
VIS_MARGIN_GREEN = 0.30
VIS_RISK_YELLOW = 1.50
VIS_RISK_RED = 2.50
# APIキーを直接コードへ書かない
if not os.getenv("AI_GATEWAY_API_KEY"):
try:
from google.colab import userdata
key = userdata.get("AI_GATEWAY_API_KEY")
if key:
os.environ["AI_GATEWAY_API_KEY"] = key
except Exception:
pass
if not os.getenv("AI_GATEWAY_API_KEY"):
os.environ["AI_GATEWAY_API_KEY"] = getpass.getpass(
"ロリポップ!AIゲートウェイ API Key: "
)
# ============================================================
# API Client
# ============================================================
def call_jev(
state: Any,
question_id: str,
question: Dict[str, Any],
timeout: int = 30,
) -> Tuple[Dict[str, Any], Dict[str, Any]]:
"""
1ノード = 1 question で Jev を呼ぶ。
Decision Tree を逐次実行するため、前段の結果に応じて必要なノードだけ呼び出す。
"""
started = time.perf_counter()
r = requests.post(
ENDPOINT,
headers={
"Authorization": f"Bearer {os.environ['AI_GATEWAY_API_KEY']}",
"Content-Type": "application/json",
},
json={
"model": MODEL,
"state": state,
"questions": {
question_id: question
},
},
timeout=timeout,
)
latency_ms = (time.perf_counter() - started) * 1000
if not r.ok:
raise RuntimeError(
f"Jev API error: HTTP {r.status_code}\n{r.text[:2000]}"
)
data = r.json()
answers = data.get("answers", {})
if question_id not in answers:
raise RuntimeError(
f"response.answers に {question_id!r} がありません。\n"
+ json.dumps(data, ensure_ascii=False, indent=2)[:4000]
)
meta = {
"model": data.get("model", MODEL),
"latency_ms": round(latency_ms, 1),
"usage": data.get("usage", {}),
}
return answers[question_id], meta
# ============================================================
# Metrics
# ============================================================
def _probabilities(answer: Dict[str, Any]) -> Dict[str, float]:
probs = answer.get("probabilities") or {}
if not isinstance(probs, dict):
return {}
out = {}
for k, v in probs.items():
try:
out[str(k)] = float(v)
except (TypeError, ValueError):
pass
return out
def top_metrics(answer: Dict[str, Any]) -> Tuple[Optional[float], Optional[float], Optional[str]]:
"""
probabilities から top_p / margin(top1-top2) / top_label を算出。
"""
probs = _probabilities(answer)
if not probs:
return None, None, None
ranked = sorted(probs.items(), key=lambda kv: kv[1], reverse=True)
top_label, top_p = ranked[0]
second_p = ranked[1][1] if len(ranked) > 1 else 0.0
return float(top_p), float(top_p - second_p), top_label
@dataclass
class Trace:
case_id: str
node: str
qtype: str
decision: Optional[str]
probabilities: Dict[str, float]
top_p: Optional[float]
confidence: Optional[float]
margin: Optional[float]
score: Optional[float]
latency_ms: float
input_tokens: Optional[int]
output_tokens: Optional[int]
model: str
raw_answer: Dict[str, Any]
def make_trace(
case_id: str,
node: str,
answer: Dict[str, Any],
meta: Dict[str, Any],
) -> Trace:
qtype = str(answer.get("type", ""))
top_p, margin, top_label = top_metrics(answer)
decision = None
score = None
if qtype == "choice":
decision = answer.get("choice") or top_label
elif qtype == "score":
score_raw = answer.get("score")
try:
score = float(score_raw)
except (TypeError, ValueError):
score = None
# Scoreには離散ラベルを無理に置かず、最大確率levelを参考として保持
decision = top_label
elif qtype == "noul":
noul = answer.get("noul")
try:
p = float(noul)
top_p = max(p, 1.0 - p)
margin = abs(2.0 * p - 1.0)
decision = "yes" if p > 0.5 else ("no" if p < 0.5 else "tie")
except (TypeError, ValueError):
pass
confidence = answer.get("confidence")
try:
confidence = float(confidence) if confidence is not None else None
except (TypeError, ValueError):
confidence = None
usage = meta.get("usage") or {}
return Trace(
case_id=case_id,
node=node,
qtype=qtype,
decision=decision,
probabilities=_probabilities(answer),
top_p=top_p,
confidence=confidence,
margin=margin,
score=score,
latency_ms=float(meta.get("latency_ms", 0.0)),
input_tokens=usage.get("input_tokens"),
output_tokens=usage.get("output_tokens"),
model=str(meta.get("model", MODEL)),
raw_answer=answer,
)
# ============================================================
# Jev Questions
# ============================================================
Q_CATEGORY = {
"type": "choice",
"instructions": (
"カレー店への問い合わせを、最初に処理すべき観点で1つに分類してください。"
"明示的なアレルギー、体調不良、異物、衛生上の問題など、"
"健康・安全上の懸念が示されている場合は safety を最優先してください。"
"一方、単なる辛さ、甘口・中辛・辛口、子ども向けかどうかの質問は product としてください。"
"「子ども」という語だけを理由に safety を選ばないでください。"
),
"criteria": {
"safety": (
"明示的なアレルギー、体調不良、異物、衛生問題など、"
"誤った回答が健康・安全に影響し得る問い合わせ"
),
"order": "注文済み商品の配送、注文変更、キャンセル、返金、大口注文",
"product": (
"辛さ、甘口・中辛・辛口、味、子ども向けかどうか、"
"通常の原材料、商品内容、在庫などの商品質問。"
"明示的なアレルギー・健康懸念は含めない"
),
"other": "上記のどれにも明確に当てはまらない問い合わせ",
},
}
Q_SAFETY_TYPE = {
"type": "choice",
"instructions": "この安全・健康関連の問い合わせで、中心となる問題を1つ選んでください。",
"criteria": {
"allergy": "食物アレルギー、アレルゲン、食べられるかどうかの安全確認",
"illness": "食後の体調不良、吐き気、腹痛など健康被害の申告",
"foreign_object": "異物混入、衛生上の異常、商品に危険物が含まれる懸念",
"other_safety": "上記以外の食の安全・健康に関する懸念",
},
}
Q_SAFETY_RISK = {
"type": "score",
"instructions": (
"この問い合わせについて、誤った自動判断をした場合の安全上の影響の大きさを評価してください。"
"問い合わせ内容だけを根拠に評価し、実際の医学的診断はしないでください。"
),
"criteria": [
"0: 安全上の影響がほぼない",
"1: 軽微な影響にとどまる可能性が高い",
"2: 注意が必要で、人が確認した方がよい",
"3: 高いリスクがあり、人による確認が重要",
"4: 重大な安全リスクにつながり得るため、自動処理すべきでない",
],
}
Q_ORDER_TYPE = {
"type": "choice",
"instructions": "注文関連の問い合わせを、次に行う処理の種類で1つに分類してください。",
"criteria": {
"delivery": "発送、配送遅延、未着、配送状況の確認",
"change_cancel_refund": "注文変更、キャンセル、返金",
"bulk_order": "多数分の注文、イベント、法人・団体向け注文",
"other_order": "その他の注文関連問い合わせ",
},
}
Q_ORDER_URGENCY = {
"type": "score",
"instructions": "この注文問い合わせをどの程度急いで対応すべきか評価してください。",
"criteria": [
"0: 急ぐ必要はなく通常対応でよい",
"1: やや早めに対応した方がよい",
"2: 当日中など比較的早い対応が望ましい",
"3: 強い期限・影響があり優先対応が必要",
"4: 即時対応に近い緊急性がある",
],
}
Q_PRODUCT_TYPE = {
"type": "choice",
"instructions": "商品についての問い合わせを、中心となる内容で1つに分類してください。",
"criteria": {
"spiciness": "辛さ、甘口・中辛・辛口、子ども向けの辛さ",
"ingredient": "通常の原材料や食材についての質問。アレルギー安全確認は含めない",
"availability": "在庫、販売状況、提供期間、購入可否",
"other_product": "その他の商品内容に関する質問",
},
}
# ============================================================
# Human Review Policy
# ============================================================
HIGH_IMPACT_SAFETY = {"allergy", "illness", "foreign_object"}
def uncertainty_triggers(t: Trace) -> List[Dict[str, Any]]:
"""
判断の曖昧さによるレビュー理由。
Score / Choice の confidence と、probabilities の margin を別々に見る。
"""
triggers = []
if t.confidence is not None and t.confidence < REVIEW_CONFIDENCE_THRESHOLD:
triggers.append({
"node": t.node,
"reason": "low_confidence",
"value": round(t.confidence, 4),
"threshold": REVIEW_CONFIDENCE_THRESHOLD,
})
if t.margin is not None and t.margin < REVIEW_MARGIN_THRESHOLD:
triggers.append({
"node": t.node,
"reason": "narrow_margin",
"value": round(t.margin, 4),
"threshold": REVIEW_MARGIN_THRESHOLD,
})
return triggers
# ============================================================
# Decision Tree
# ============================================================
def state_for(case_id: str, text: str, path: List[str]) -> Dict[str, Any]:
return {
"case_id": case_id,
"customer_message": text,
# 経路は記録目的。Jevに前回答そのものを「正解」として与えず、
# 現在どの処理段階かを伝えるための補助情報として使う。
"workflow_path": path,
}
def run_case(case_id: str, text: str, verbose: bool = True) -> Dict[str, Any]:
traces: List[Trace] = []
review_triggers: List[Dict[str, Any]] = []
path: List[str] = ["root"]
def run_node(node: str, question: Dict[str, Any]) -> Trace:
answer, meta = call_jev(
state_for(case_id, text, path),
node,
question,
)
trace = make_trace(case_id, node, answer, meta)
traces.append(trace)
review_triggers.extend(uncertainty_triggers(trace))
path.append(f"{node}:{trace.decision}")
return trace
# ----- Root -----
category = run_node("category", Q_CATEGORY)
final_action = "HUMAN_REVIEW"
# ----- Safety branch -----
if category.decision == "safety":
safety_type = run_node("safety_type", Q_SAFETY_TYPE)
risk = run_node("safety_risk", Q_SAFETY_RISK)
# 内容そのものの高影響性。Jevの確信度とは別軸。
if safety_type.decision in HIGH_IMPACT_SAFETY:
review_triggers.append({
"node": "safety_type",
"reason": "high_impact_safety_category",
"value": safety_type.decision,
"threshold": None,
})
if risk.score is not None and risk.score >= REVIEW_RISK_SCORE_THRESHOLD:
review_triggers.append({
"node": "safety_risk",
"reason": "high_risk_score",
"value": round(risk.score, 4),
"threshold": REVIEW_RISK_SCORE_THRESHOLD,
})
final_action = "HUMAN_REVIEW" if review_triggers else "SAFETY_FAQ"
# ----- Order branch -----
elif category.decision == "order":
order_type = run_node("order_type", Q_ORDER_TYPE)
urgency = run_node("order_urgency", Q_ORDER_URGENCY)
# ここでは高urgencyだけでは必ずしも人へ送らない。
# まずは優先キューへ振る、という業務ルールの例。
if review_triggers:
final_action = "HUMAN_REVIEW"
elif order_type.decision == "delivery":
final_action = "DELIVERY_SUPPORT"
elif order_type.decision == "change_cancel_refund":
final_action = "ORDER_CHANGE_SUPPORT"
elif order_type.decision == "bulk_order":
final_action = "BULK_ORDER_SUPPORT"
else:
final_action = "ORDER_SUPPORT"
# ----- Product branch -----
elif category.decision == "product":
product_type = run_node("product_type", Q_PRODUCT_TYPE)
if review_triggers:
final_action = "HUMAN_REVIEW"
elif product_type.decision == "spiciness":
final_action = "SPICINESS_FAQ"
elif product_type.decision == "ingredient":
final_action = "INGREDIENT_FAQ"
elif product_type.decision == "availability":
final_action = "AVAILABILITY_FAQ"
else:
final_action = "PRODUCT_FAQ"
# ----- Other -----
else:
review_triggers.append({
"node": "category",
"reason": "unhandled_category",
"value": category.decision,
"threshold": None,
})
final_action = "HUMAN_REVIEW"
result = {
"case_id": case_id,
"text": text,
"root_category": category.decision,
"path": path,
"final_action": final_action,
"human_review": final_action == "HUMAN_REVIEW",
"review_triggers": review_triggers,
"traces": [asdict(t) for t in traces],
}
if verbose:
print_case_result(result)
return result
# ============================================================
# Display / Export
# ============================================================
def print_case_result(result: Dict[str, Any]) -> None:
print("=" * 80)
print(f"[{result['case_id']}] {result['text']}")
print("-" * 80)
for t in result["traces"]:
metrics = []
if t["top_p"] is not None:
metrics.append(f"top_p={t['top_p']:.3f}")
if t["confidence"] is not None:
metrics.append(f"confidence={t['confidence']:.3f}")
if t["margin"] is not None:
metrics.append(f"margin={t['margin']:.3f}")
if t["score"] is not None:
metrics.append(f"score={t['score']:.3f}")
print(
f"{t['node']:14s} -> {str(t['decision']):20s} "
+ " | ".join(metrics)
)
if t["probabilities"]:
probs = ", ".join(
f"{k}={v:.3f}"
for k, v in sorted(
t["probabilities"].items(),
key=lambda kv: kv[1],
reverse=True
)
)
print(f"{'':17s} probabilities: {probs}")
print("-" * 80)
print("Final Action :", result["final_action"])
if result["review_triggers"]:
print("Review Trigger:")
for x in result["review_triggers"]:
if x.get("threshold") is None:
print(f" - {x['node']}: {x['reason']} ({x['value']})")
else:
print(
f" - {x['node']}: {x['reason']} "
f"value={x['value']} / threshold={x['threshold']}"
)
else:
print("Review Trigger: none")
def build_trace_df(results: List[Dict[str, Any]]) -> pd.DataFrame:
rows = []
for r in results:
for t in r["traces"]:
rows.append({
"case_id": r["case_id"],
"text": r["text"],
"node": t["node"],
"decision": t["decision"],
"top_p": t["top_p"],
"confidence": t["confidence"],
"margin": t["margin"],
"score": t["score"],
"latency_ms": t["latency_ms"],
"input_tokens": t["input_tokens"],
"model": t["model"],
"final_action": r["final_action"],
"human_review": r["human_review"],
"probabilities": json.dumps(
t["probabilities"], ensure_ascii=False, sort_keys=True
),
})
return pd.DataFrame(rows)
def build_summary_df(results: List[Dict[str, Any]]) -> pd.DataFrame:
rows = []
for r in results:
traces = r["traces"]
confs = [
t["confidence"] for t in traces
if t["confidence"] is not None
]
margins = [
t["margin"] for t in traces
if t["margin"] is not None
]
risks = [
t["score"] for t in traces
if t["node"] == "safety_risk" and t["score"] is not None
]
rows.append({
"case_id": r["case_id"],
"text": r["text"],
"root": r["root_category"],
"path": " → ".join(r["path"][1:]),
"final_action": r["final_action"],
"human_review": r["human_review"],
"review_reason": " | ".join(
f"{x['node']}:{x['reason']}"
for x in r["review_triggers"]
),
"min_confidence": min(confs) if confs else None,
"min_margin": min(margins) if margins else None,
"max_safety_risk": max(risks) if risks else None,
"total_latency_ms": round(
sum(float(t["latency_ms"]) for t in traces), 1
),
"input_tokens": sum(
int(t["input_tokens"] or 0) for t in traces
),
})
return pd.DataFrame(rows)
def style_metric_matrix(summary_df: pd.DataFrame):
"""
pandas Styler で赤・黄・緑に可視化。
※色の境界はスモークテスト用の可視化ルール。
"""
def confidence_css(v):
if pd.isna(v):
return ""
if v >= VIS_CONF_GREEN:
return "background-color:#d9ead3"
if v >= VIS_CONF_YELLOW:
return "background-color:#fff2cc"
return "background-color:#f4cccc"
def margin_css(v):
if pd.isna(v):
return ""
if v >= VIS_MARGIN_GREEN:
return "background-color:#d9ead3"
if v >= VIS_MARGIN_YELLOW:
return "background-color:#fff2cc"
return "background-color:#f4cccc"
def risk_css(v):
if pd.isna(v):
return ""
if v >= VIS_RISK_RED:
return "background-color:#f4cccc"
if v >= VIS_RISK_YELLOW:
return "background-color:#fff2cc"
return "background-color:#d9ead3"
def human_css(v):
return (
"background-color:#f4cccc;font-weight:bold"
if bool(v)
else "background-color:#d9ead3"
)
cols = [
"case_id", "root", "final_action", "human_review",
"min_confidence", "min_margin", "max_safety_risk",
"review_reason"
]
x = summary_df[cols].copy()
return (
x.style
.map(confidence_css, subset=["min_confidence"])
.map(margin_css, subset=["min_margin"])
.map(risk_css, subset=["max_safety_risk"])
.map(human_css, subset=["human_review"])
.format({
"min_confidence": lambda v: "" if pd.isna(v) else f"{v:.3f}",
"min_margin": lambda v: "" if pd.isna(v) else f"{v:.3f}",
"max_safety_risk": lambda v: "" if pd.isna(v) else f"{v:.3f}",
})
)
# ============================================================
# Smoke Test Cases
# ============================================================
SMOKE_CASES = [
{
"case_id": "C01",
"text": "子どもでも食べられる辛さですか?",
},
{
"case_id": "C02",
"text": "卵アレルギーがあります。このカレーは食べられますか?",
},
{
"case_id": "C03",
"text": "昨日注文したカレーがまだ届きません。配送状況を確認したいです。",
},
{
"case_id": "C04",
"text": "子どもが卵を食べられないのですが、甘口なら大丈夫ですか?",
},
{
"case_id": "C05",
"text": "来週の社内イベントで20人分のカレーを注文できますか?",
},
{
"case_id": "C06",
"text": "このカレーを食べたあとから気分が悪くなりました。どうしたらいいですか?",
},
]
def run_smoke_tests(
cases: List[Dict[str, str]] = SMOKE_CASES,
) -> Tuple[List[Dict[str, Any]], pd.DataFrame, pd.DataFrame]:
results = []
for case in cases:
try:
result = run_case(
case_id=case["case_id"],
text=case["text"],
verbose=True,
)
results.append(result)
except Exception as e:
print("=" * 80)
print(f"[{case['case_id']}] ERROR")
print(type(e).__name__, str(e))
raise
summary_df = build_summary_df(results)
trace_df = build_trace_df(results)
print("\n\n=== SUMMARY ===")
display(summary_df)
print("\n=== COLOR MATRIX ===")
display(style_metric_matrix(summary_df))
print("\n=== DECISION TRACE ===")
display(trace_df)
return results, summary_df, trace_df
# ============================================================
# Smoke Test Regression Check
# ============================================================
# root分類の意図を固定しておくための最小回帰チェック。
# Jevは確率的モデルなので「必ずこの値になる」という意味ではなく、
# prompt/criteria変更後に想定外のroutingが起きていないかを見るための確認用。
EXPECTED_ROOTS = {
"C01": "product", # 子ども向けの辛さ → safetyではなく商品質問
"C02": "safety", # 明示的な卵アレルギー
"C03": "order", # 配送状況
"C04": "safety", # 卵を食べられない + 甘口 → safety優先
"C05": "order", # 大口注文
"C06": "safety", # 食後の体調不良
}
def regression_check(results: List[Dict[str, Any]]) -> pd.DataFrame:
rows = []
for r in results:
expected = EXPECTED_ROOTS.get(r["case_id"])
actual = r["root_category"]
rows.append({
"case_id": r["case_id"],
"expected_root": expected,
"actual_root": actual,
"match": expected == actual if expected is not None else None,
"min_confidence": min(
[
t["confidence"]
for t in r["traces"]
if t["confidence"] is not None
],
default=None,
),
"final_action": r["final_action"],
})
df = pd.DataFrame(rows)
print("\n=== ROOT ROUTING REGRESSION CHECK ===")
display(df)
mismatches = df[df["match"] == False] # noqa: E712
if len(mismatches):
print(
"WARNING: 想定と異なるroot分類があります。"
"Decision Traceのprobabilities / confidence / marginを確認してください。"
)
else:
print("OK: 6件すべて想定したroot branchに入りました。")
return df
# ============================================================
# 実行
# ============================================================
# ============================================================
# Article Validation Run
# ============================================================
OUTPUT_PREFIX = "jev_curry_qiita_validation"
def save_validation_outputs(
results: List[Dict[str, Any]],
summary_df: pd.DataFrame,
trace_df: pd.DataFrame,
regression_df: pd.DataFrame,
prefix: str = OUTPUT_PREFIX,
) -> None:
"""
Qiita記事で根拠として使う検証結果を固定ファイルとして保存する。
"""
summary_path = f"{prefix}_summary.csv"
trace_path = f"{prefix}_trace.csv"
regression_path = f"{prefix}_regression.csv"
results_path = f"{prefix}_results.json"
config_path = f"{prefix}_config.json"
summary_df.to_csv(summary_path, index=False, encoding="utf-8-sig")
trace_df.to_csv(trace_path, index=False, encoding="utf-8-sig")
regression_df.to_csv(regression_path, index=False, encoding="utf-8-sig")
with open(results_path, "w", encoding="utf-8") as f:
json.dump(results, f, ensure_ascii=False, indent=2)
config = {
"endpoint": ENDPOINT,
"model": MODEL,
"thresholds": {
"review_confidence_threshold": REVIEW_CONFIDENCE_THRESHOLD,
"review_margin_threshold": REVIEW_MARGIN_THRESHOLD,
"review_risk_score_threshold": REVIEW_RISK_SCORE_THRESHOLD,
},
"visual_thresholds": {
"confidence_yellow": VIS_CONF_YELLOW,
"confidence_green": VIS_CONF_GREEN,
"margin_yellow": VIS_MARGIN_YELLOW,
"margin_green": VIS_MARGIN_GREEN,
"risk_yellow": VIS_RISK_YELLOW,
"risk_red": VIS_RISK_RED,
},
"expected_roots": EXPECTED_ROOTS,
"smoke_cases": SMOKE_CASES,
}
with open(config_path, "w", encoding="utf-8") as f:
json.dump(config, f, ensure_ascii=False, indent=2)
print("\n=== SAVED FILES ===")
for p in [
summary_path,
trace_path,
regression_path,
results_path,
config_path,
]:
print(" -", p)
def run_article_validation():
"""
記事用の最終検証。
1) 6ケースを実行
2) Summary / Decision Traceを表示
3) root routingの回帰チェック
4) CSV / JSONへ保存
"""
results, summary_df, trace_df = run_smoke_tests()
regression_df = regression_check(results)
save_validation_outputs(
results=results,
summary_df=summary_df,
trace_df=trace_df,
regression_df=regression_df,
)
return results, summary_df, trace_df, regression_df
if __name__ == "__main__":
results, summary_df, trace_df, regression_df = run_article_validation()
出力ファイル
検証プログラムでは、実行結果を次の5ファイルに保存します。
jev_curry_qiita_validation_summary.csv
jev_curry_qiita_validation_trace.csv
jev_curry_qiita_validation_regression.csv
jev_curry_qiita_validation_results.json
jev_curry_qiita_validation_config.json
summary.csv はケース単位の結果、trace.csv はノード単位の結果です。
config.json には、今回利用したモデル名、しきい値、テストケースを残しています。
今回の主な検証条件を開く
{
  "model": "typesafe/jev-latest",
  "thresholds": {
    "review_confidence_threshold": 0.55,
    "review_margin_threshold": 0.08,
    "review_risk_score_threshold": 2.5
  }
}
今回の検証で分かったこと
今回のスモークテストでは、大きく3つ気づきがありました。
1. Decision TreeとAI判定を分けると追いやすい
Treeそのものはコードに置き、曖昧な判断だけJevに任せることで、
どの業務ルールで
どのAI判断を使ったか
が分かりやすくなりました。
2. confidenceだけでHuman Reviewを決める必要はない
C02のように、分類自体はほぼ明確でも、内容の影響が大きいためHuman Reviewにするケースがあります。
AIが迷う
    ↓
Human Review
だけではなく、
AIは迷っていない
    +
高影響
    ↓
Human Review
も必要そうです。
3. 「どこで迷ったか」を残せる
C04ではrootだけconfidenceが低く、その後のAllergy判定は明確でした。
最終ラベルだけを見るより、
どのノードで不確実性が増えたか
を見る方が、Treeや判定条件を改善しやすそうです。
注意点
今回の結果を見るうえで、次の点には注意が必要です。
- テストケースは6件だけ
- カレー店を題材にした簡易的なDecision Tree
- Human Reviewのしきい値は筆者が検証用に仮置きしたもの
-
marginはJevの出力値ではなく、コード側で算出 - Jevの確率・confidence・scoreは実行ごとに多少変動する可能性がある
- TypeSafe公式ドキュメントでは英語が現状もっとも精度が高く、CJKを含む他言語は同等ではないとされている。本記事は日本語入力のみで検証している
- APIのlatencyにはネットワーク等も含まれるため、本記事では性能ベンチマークとして扱わない
- 食品安全や健康に関する実運用判断を、この検証結果だけで自動化すべきではない
日本語を含む言語サポートについては、TypeSafe公式のModelsドキュメントも参照してください。
実運用するなら、実データによる評価、誤分類コスト、レビュー基準、ログ監視などを別途設計する必要があります。
まとめ
今回は、Jevを使ってカレー店への問い合わせを確率付きDecision Treeとして処理してみました。
ポイントは、
Jevに全部任せる
のではなく、
Tree・業務ルール → Code
曖昧な判断       → Jev
と役割を分けたことです。
各ノードでは、
probabilities
confidence
score
top_p
margin
を記録し、Human Reviewになった理由は review_triggers として残しました。
これにより、「Human Reviewになった」だけでなく、「どの判断で迷い、なぜ人の確認が必要になったのか」まで追えるようになりました。
今回のC04では、
rootでは迷う
↓
次の分類は明確
↓
高リスクなので人へ
という経路が確認できました。
最終結果だけを見るのではなく、途中のDecision Traceまで残すことで、AIの判断過程を観測し、後からTreeや判定条件を見直しやすくなります。
もちろん、こうした仕組みはJevでなければ実現できないものではなく、ルールベースや一般的なLLMなど、他の方法でも構成できます。
一方で、文章生成ではなく、分類・評価・分岐のような小さな判断に用途を絞るのであれば、確率やconfidenceを扱いながら、比較的低コストかつ高速に、シンプルなコードへ組み込みやすいJevは選択肢の一つになりそうです。
業務ルールやTreeの構造はコードで定義し、曖昧な判断をJevに任せ、その過程をログとして残す。
今回試したような役割分担は、AIを業務フローへ組み込む一つの形として面白いと感じました。