
この記事は Synthorai ブログの記事 LLM のトークン消費:4トークンの回答が217トークン課金される理由 の転載です。原文(多言語対応)はリンク先をご覧ください。

GPT-5.6 に一行の数学問題を投げると、出力課金の 88% は目に見えない reasoning で占められる。見えるトークンは 10 個、課金は 81 個だ。しかも GPT-5.6 はまだ軽いほうだ。同じ問題を GLM 5.2 に投げると、4トークンの回答に対して completion トークンが 217 課金され、Qwen3.7-max では全く同じ回答に 1,104 も課金された。これは異常値ではなく、reasoning モデルが仕様どおりに課金した結果だ。そして、ほとんどのコストダッシュボードが分解して見せないトークンクラスの一つにすぎない。この記事では、実際の usage オブジェクトをクラスごとに、計測値を添えて解剖する。
TL;DR
- GPT-5.6 のデフォルトは 10トークンの回答に 81トークン課金し、うち 88% が reasoning。GLM 5.2 は 98%、Qwen3.7-max は 99.3% だった。
- Claude Sonnet 5 は thinking パラメータを一切送っていないのに、5トークンの回答に 114 の thinking トークンを課金した。
- 5つのファミリーは thinking なしで誤答した(399、400、427、466、467)。thinking なしで正解したのは GPT-5.6 だけで、reasoning ありの実行はすべて 401 と答えた。
- 1,181トークンの Claude キャッシュ書き込みとその後の読み込みは、それぞれ $0.01246 と $0.00566 かかり、定価と完全に一致した。
テスト内容
この記事の計測はすべて、同一のシングルターンプロンプトを各モデルにデフォルト設定で投げたものだ(行に別途記載がある場合を除く):
How many positive integers n <= 1000 are divisible by 3 or 5
but not by 15? Reply with just the number, nothing else.
正解は 401 だ(3の倍数が 333 個、5の倍数が 200 個で、二重にカウントした 66 個を引くと 467。ここから 15 の倍数 66 個を落とすと 401 が残る)。この問題は意図的に選んだ。見える回答は小さく、どのトークナイザでも 3〜4トークンに固定される。正解はただ一つなので「thinking は元が取れたか」を検証できる。そしてモデルが思考したくなる程度には難しく、まさにこの挙動を監査したいのだ。
請求書に載る 5 種類のトークン
いまどきの補完リクエストは、最大で 5 種類のトークンを、4 種類のレートで課金する。「使用トークン数」という 1 つの数字だけ見ていると、この内訳はすべて見えなくなる。
| 種類 | どこに現れるか | 課金レート |
|---|---|---|
| プロンプト(未キャッシュ) | prompt_tokens |
input レート |
| 表示される出力 |
completion_tokens から reasoning を引いた分 |
output レート |
| Reasoning | completion_tokens_details.reasoning_tokens |
output レート(回答とは別枠) |
| キャッシュ書き込み | cache_creation_input_tokens |
input レート × 1.25(Anthropic 5m TTL)または × 2(1h TTL) |
| キャッシュ読み込み | cache_read_input_tokens |
input レート × 0.1(Anthropic) |
上のフィールド名は OpenAI 互換の形式だ。Claude も同じ 5 種類を独自の名前で持っている。input_tokens と output_tokens があり、thinking は output_tokens_details.thinking_tokens に載って output として課金される。キャッシュ書き込みは TTL ごとにさらに分かれ、cache_creation オブジェクトの中に入る(ephemeral_5m_input_tokens が 1.25 倍、ephemeral_1h_input_tokens が 2 倍)。構造は同じで、ラベルだけが違う。このパースの問題は後の節でまた出てくる。
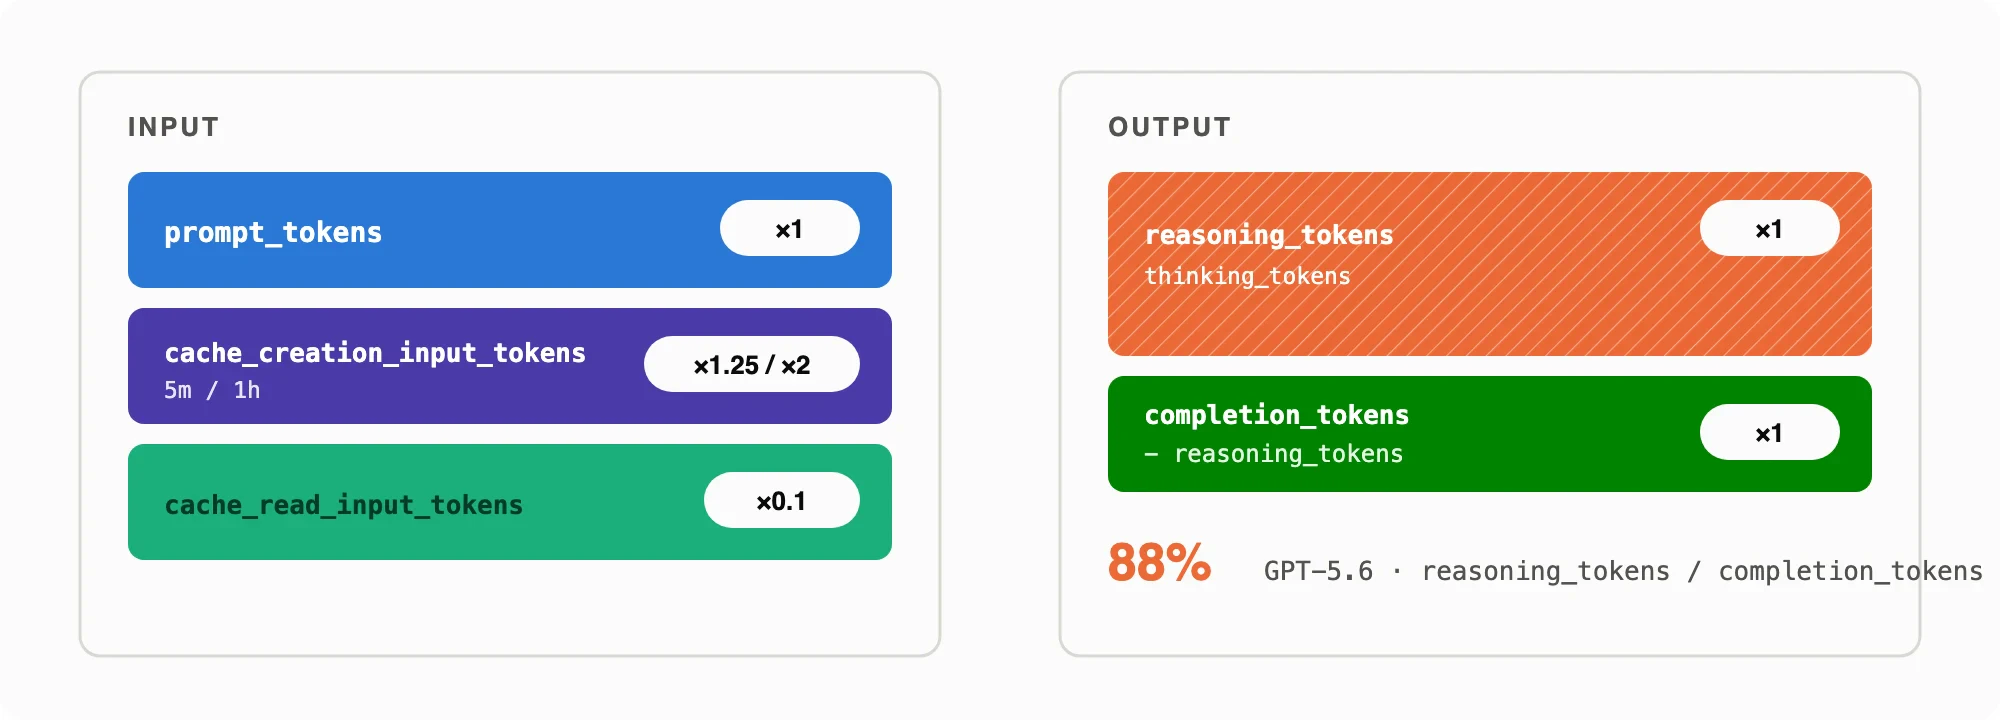
5 種類のトークンと、それぞれの価格倍率。OpenAI 互換と Anthropic のフィールド名を併記している。88% という数字は、下の例で実測した GPT-5.6 の reasoning の割合だ。
この見出しの数字の裏にある実際のオブジェクトを見てみよう。GPT-5.6 をデフォルト設定のままテスト質問に答えさせたものだ。
{
  "prompt_tokens": 38,
  "completion_tokens": 81,
  "total_tokens": 119,
  "prompt_tokens_details": { "cached_tokens": 0, "cache_write_tokens": 0 },
  "completion_tokens_details": { "reasoning_tokens": 71 },
  "cost": 0.000524
}
課金の計算はここに詰まっている。一度きちんと計算しておく価値がある。受け取った回答は completion_tokens から reasoning_tokens を引いた分、つまり 81 − 71 = 10 トークンで、「401」という単語とその整形分だ。残りの 71 トークンは chain-of-thought で、フル output レートで課金され、output 課金額の 88% を占める。しかも GPT-5.6 では、その 1 トークンも読むことはできない。この記事に出てくる「表示される回答」の数字は、すべて同じやり方で計算している。他のモデルではこの比率がさらに極端になる。GLM 5.2 は同じ質問に completion トークン 217 個で答えたが、回答そのものは 4 トークンだった。だから completion_tokens を「モデルが言ったこと」として読むコストモデルは、ここでは 8 倍、あちらでは 54 倍ずれることになる。
Reasoning は予算であり,制御できる
同じ 1 行の質問を,steerable な 3 系統が受け付けるすべての thinking 設定に投げた結果。ゲートウェイは 1 つ,計測は 2026-07-13/14(各系統内で reasoning が少ない順に行を並べた。残りの系統のフラッグシップ default は次のセクションに記載):
| 設定 | 回答 | Reasoning トークン | コスト |
|---|---|---|---|
GPT-5.6 mini (luna), none / low / medium / high
|
401(すべて正解) | 0 / 52 / 85 / 74 | $0.000062 / 0.000410 / 0.000608 / 0.000542 |
| GPT-5.6 mini, default | 401(正解) | 71 | $0.000524 |
| GLM 5.2, thinking off | 399(不正解) | 0 | $0.000062 |
| GLM 5.2, default (thinking on) | 401(正解) | 213 | $0.001016 |
GLM 5.2, reasoning_effort: high
|
401(正解) | 359 | $0.001659 |
| Claude Sonnet 5, thinking disabled | 467(不正解) | 0 | $0.000130 |
Claude Sonnet 5, effort: low
|
401(正解) | 84 | $0.000970 |
| Claude Sonnet 5, no thinking param | 401(正解) | 114 | $0.001290 |
| Claude Sonnet 5, adaptive thinking | 401(正解) | 168 | $0.001830 |
Claude Sonnet 5, effort: high
|
401(正解) | 249 | $0.004830 |
この表から正直に読み取るべきことが 4 つある。
-
効くところではレバーの効きが大きい。
reasoning_effort: noneは $0.000062 で正解し,luna の default より 8.5 倍安い。より難しいタスクでは GLM 5.2 で 20 倍を計測している。ティアの選択も同じレバーの一部だ。GPT-5.6 のフラッグシップは default で reasoning ゼロのままこの質問に答えた(次のセクション参照)。つまり,考える必要のない大きいモデルは,考えなければならない小さいモデルより安く済むことがある。 -
効かないところではほとんど動かない。 ダイヤルがどれだけ回るかは系統ごとの性質だ。Sonnet 5 では単調に効いてコストが 5 倍振れる(84 から 249)。GPT-5.6 では効きが弱く順序も乱れる。Qwen3.7-max ではほぼ効かず(
lowでも 974 reasoning トークンを使い,default の 1,096 とほぼ変わらない)。DeepSeek V4 Pro では死んでいる(267 に対して 269)。 -
ラベルは単調ではなく,default は決定的でもない。 ここでは GPT-5.6 の
highがmediumより少ないトークンで済んだ。以前の記事では GLM のlowがhighを上回るトークンを使った。Sonnet 5 は thinking パラメータをまったく送っていないリクエストで 114 トークン考えた。そして同じ GLM の default リクエストが,あるランでは 213 reasoning トークン,別のランでは 1,312 トークンと,6 倍も開いた。ダイヤルの実際の効果は自分のワークロードで計測すること。ラベルから読み取ってはいけない。 - 安くて不正解が繰り返し起きる失敗パターンだ。 ここで thinking なしで答えた 2 系統はどちらも不正解だった(GLM が 399,Sonnet 5 が 467)。5 系統すべての点呼は次のセクションにある。Reasoning は正解のための予算であり,それを削って得になるかどうかはタスク次第であって,モデル次第ではない。
実務上のルール。reasoning_tokens を一級の明細項目として扱うこと。output レートで課金され,見える回答の量を平気で上回り,効果を実際に計測しなければならないパラメータで動く。GPT-5.6 では pricing のルールも変わっている点に注意。GPT-5.6 コストガイドで write プレミアムと cache-key 要件を解説している。
支払ったものを、実際に読めるのか?
「回答とは別枠」だからといって、必ずしも隠されているわけではない。この違いはきちんと区別しておく価値がある。今回は usage だけでなく、レスポンスボディそのものを確認した。
-
GLM 5.2、DeepSeek、Qwen3.7-max、MiniMax は reasoning の全文を返す。回答の隣に
reasoning_contentフィールドがあり、ここでは 3,987、1,604、2,509、581 文字だった。開発者は課金対象のトークンをすべて読める。エンドユーザーが目にするのはこちらがレンダリングした場合だけで、多くのアプリケーションはそうしていない。 -
GPT-5.6 は生の思考過程を渡さない。手に入るのはせいぜい要約だ。レスポンスにはモデルが書いた
reasoning.summaryが含まれることがある(ここでは 359 文字)が、課金された 91 トークンは要約ではなく隠された生テキストだ。そのテキストに最も近いのがreasoning.encrypted_contentで、マルチターンの継続のために送り返せる暗号化されたブロブだが、復号はできない。支払ったトークンは自分のレスポンスボディの中にありながら、読めない。 -
Claude は聞き方次第だ。adaptive-thinking で呼び出した Sonnet 5 は
thinkingブロックを返したが、テキストは空でthinking_tokensは 114 課金された。思考したという証拠はあるが、読めるものはない。Fable 5 も常時オンのデフォルトで同じ挙動だった(59 課金、空のブロック)。ところが、同じ Sonnet 5 を明示的な reasoning budget 付きで呼ぶと、実際の思考テキストが返ってきた(73 トークン課金、テキストあり)。何を見られるかは聞き方で決まる。
つまり、課金は共通だが可視性はそうではない。どのファミリーも reasoning に output レートで課金するが、支払ったテキストを監査できるかどうかは「全文」から「要約のみ」、さらには「署名付きの空ブロック」まで幅がある。
テキストが返ってくる場合は、機械的に採点できる。今回の質問には固定の中間結果が 5 つある(333、200、66、467、401)。返ってきた reasoning テキストにはそのすべてが含まれていた。GLM 5.2、DeepSeek V4 Pro、Qwen3.7-max、Kimi K2.7 Code、MiniMax M3 はいずれも完全な導出を返し、low-effort の変種はそれぞれ 1 ステップを落とした。答えだけでなく過程が必要な人にとって、ここが分かれ目になる。reasoning_content があれば支払ったものを検証できるが、要約や空ブロックの場合は信じるしかない。Invisible Tokens, Visible Bills はこのアカウンタビリティの隙間を定式化し、PALACE は隠された reasoning を外部から推定する。
各ファミリーの最新フラッグシップに同じ質問を投げる
先ほどのステアリング表では、特定のティアを使ってつまみの効き方を示した。ここでは各ファミリーの最新フラッグシップに同じ質問をデフォルト設定で投げてみる。
| モデル | 回答 | 完了トークン | 報告された reasoning | コスト |
|---|---|---|---|---|
| Qwen3.7-max | 401(正解) | 1,104 | 1,096(99.3%) | $0.008393 |
| DeepSeek V4 Pro | 401(正解) | 272 | 269(98.9%) | $0.000933 |
| Kimi K2.7 Code | 401(正解) | 261 | 258(99%) | $0.001082 |
| MiniMax M3 | 401(正解) | 260 | テキストは返るが内訳なし | $0.000349 |
| GLM 5.2 | 401(正解) | 217 | 213(98%) | $0.001016 |
| Claude Fable 5 | 401(正解) | 62 | 59(95%) | $0.003600 |
| GPT-5.6 sol | 401(正解) | 4 | 0 | $0.000310 |
| Gemini 3.5 Flash | 466(不正解) | 3 | 0 | $0.000080 |

同じ質問に対する各フラッグシップごとの課金対象出力トークン(斜線入りオレンジ = 推論の割合、緑 = 可視の回答)。MiniMax のアスタリスク:その使用量には推論のカウントが含まれていないため、割合は減算によって再構築され、返される推論テキストと照合して検証されている。GPT-5.6 sol のチェックマークは、唯一の正しいゼロ推論実行を示す。Gemini 3.5 Flash のバツ印は、唯一の誤ったフラッグシップの回答(466)を示す。
すべての報告スタイルを 1 枚のグラフに収めた。
- 8 機中 7 機のフラッグシップが正解したが、同じ 401 を出すコストは大きくばらついた。 Qwen3.7-max は reasoning トークンを 1,096 使い、22 秒、$0.0084 かかった。GPT-5.6 のフラッグシップは reasoning トークンゼロで $0.00031。同じ正解を出すのにコストで 27 倍、レイテンシで 7 倍の差が出た。これが reasoning バジェットの可視化だ。
-
MiniMax は reasoning テキストを返すが、そのカウントは返さない。 表示回答 3 トークンに対して完了トークンは 260。レスポンスには
reasoning_contentに導出の全文が入っているのに、completion_tokens_detailsには reasoning の行がない。カウントが欠けているときは引き算で復元する。完了トークンから表示トークンを引けば、隠れた出力のトークン数が求まる。 - Gemini 3.5 Flash は異常値だ。フラッグシップで唯一誤答(466)し、完了トークンは 3、reasoning のカウントはどこにもない。兄弟モデルの 2.5 Flash は、あるとき 12.5 秒かけて 3 トークンの 401 を出したが、請求にはその理由を示すものが何もなく、再実行では 427 と答えた。
- 誤答は下位ティアと thinking を無効にしたケースに集中する。 thinking をオフにした GLM は 399、Sonnet 5 を無効にすると 467、旧 qwen3-max はまったく思考せず(3 トークン)400 と答えた。reasoning チャネルを持たない Kimi K2.5 は、表示・請求される 144 トークンで声に出して推論し、自分の文章の中で 401 を導出したのに、結論は 400 だった。5 ファミリーで 5 通りの誤答が出た。399、400、427、466、467。reasoning なしで正解したのは GPT-5.6 だけだった。
キャッシュトークン:2 つの方向、12 倍の差
prompt caching では入力トークンがさらに 2 種類に分かれる。この分類が存在する理由は、両者の価格差そのものにある。Claude では書き込みが入力レートの 1.25 倍(1 時間 TTL なら 2 倍)、読み込みは 0.1 倍で課金される。実測では、1,181 トークンのキャッシュ済み system prompt を使った Opus 4.8 の 2 回の呼び出しは、書き込みが $0.01246、読み込みが $0.00566 だった。どちらも小数第 6 位までリスト価格と一致し、入力側の課金は呼び出しをまたいで約 11 倍下がっている。この記事で重要なのは会計処理だ。cache_creation_input_tokens と cache_read_input_tokens をまとめて「入力トークン」として扱うと、割引が効いているか検証できず、割引が黙って止まったときにも気づけない。しかも、それはドキュメントが示唆するよりも頻繁に起きる。我々の caching measurements では、実効しきい値がドキュメント上の最小値の 1.4〜2.4 倍だった。プロバイダごとの仕組みは prompt caching guide で詳しく扱っている。
ローカルの見積もりが請求と一致しない理由
よくあるやり方は、tokenizer ライブラリでクライアント側でコストを見積もり、あとで突き合わせるというものだ。数字が合わない理由は 3 つある。
- tokenizer はベンダーごとに違う。 Claude 向けのテキストを OpenAI の tokenizer で数えるのは、間違ったものさしで測っているのと同じだ。同じ文字列でもファミリーごとにトークン数が変わる。
- 課金対象はメッセージ本文だけではない。 system prompt や tool schema は、それを含むリクエストごとに入力トークンとして数えられる。ローカルの見積もりでは抜け落ちやすい。
-
reasoning はレスポンスが返るまで予測できない。 モデルが何個の thinking token を使うかは、どんなクライアント側のカウントでも予測できない。返ってきた
usageを見て初めて分かる。
返ってくる usage オブジェクトは upstream 自身の課金記録だ。だから最も安く正確に数える方法は、見積もりをやめてこれを読むことだ。ただし厄介なのは、プロバイダごとに形が違う点だ。キャッシュトークンだけを取っても、ファミリー次第で cached_tokens、prompt_cache_hit_tokens、total_cached_tokens、cache_read_input_tokens と現れ方が異なる。
detail オブジェクトも固定スキーマではない。OpenAI のリファレンス には completion 側のフィールドが 4 つ記載されている。reasoning_tokens、audio_tokens、そして Predicted Outputs のペアである accepted_prediction_tokens / rejected_prediction_tokens だ。rejected prediction token は出力に現れないが、それでも completion token として課金される。prompt 側では 同じ形 が cached_tokens に加えて text_tokens、audio_tokens、image_tokens を持つ。GPT-5.6 は cache_write_tokens を追加し、実運用では video_tokens も確認している。ベンダーは自由に拡張する。Kimi K2.7 はドキュメントにない completion_tokens_details.text_tokens を返し、Gemini は thinking token と tool-use token を独自の名前で別々にカウントしている。パースは防御的に行うこと。未知の detail フィールドは想定内として扱い、フィールドが無いことをゼロだと決めつけないこと。
ここでゲートウェイの価値が出る。Synthorai はこれらすべてを 1 つのオブジェクトに正規化する。reasoning_tokens と 2 つのキャッシュ方向は OpenAI、Anthropic、Gemini、そして open-weight 系ファミリーにわたって埋められるので、1 つのパーサーでルーティング先のすべてのモデルをカバーできる。
「見える」から「止める」へ
台帳を読むのは仕事の半分でしかない。残りの半分は、超過を「見えるだけ」にせず、そもそも起こらないようにすることだ。月末のダッシュボードは金が消えた後になって驚きを告げるし、リトライループにハマったエージェントはダッシュボードなど読まない。ゲートウェイ側では、すべてのキーが quota を持ち、used_quota として消費量を追跡し、RPM の上限をリクエスト時に強制する。予算を使い切ったキーは、3 週間後により大きな請求書が届くのではなく、次のリクエストで明示的なエラーを受け取る。リクエスト単位の帰属情報(どのキーか、どのモデルか、BYOK かプラットフォーム課金か)は同じレスポンスのエンベロープで返ってくるので、機能ごとのコストは group-by で出せる。後から再構築するプロジェクトにはならない。
計測から導かれる作業の順序はこうだ。何かを最適化する前にまず reasoning_tokens とキャッシュ関連のフィールドを読む。タスクごとに reasoning のダイヤルを設定する。そして、失敗するとループに陥るキーにはすべて厳格な quota をかける。特定のモデルと token クラスの組み合わせが自分の利用量でいくらになるかを見たいなら、cost optimizer が上と同じ token 単価から価格を算出する。