
はじめに
前回、OCI Generative AI を大阪リージョンで叩いて7つのモデルを比べる記事 を書きました。今回はその続きで、生成AIをデータベースに繋ぎます。
やりたかったのは、ADWのAWRデータを日本語で聞けるようにすることです。「直近24時間でCPU時間を食ってるSQLは?」と聞いたら答えが返ってくる、みたいな状態ですね。
結論から言うと、動きました。動いたのですが、返ってきた答えが間違っていました。しかもエラーは出ません。それらしい結果が普通に返ってきます。
なぜそうなったのか、どう直したのかを書いていきます。ちなみにモデルは最初から最後までずっと同じです。一度も変えてないのに、精度だけが段階的に変わりました。
目次
先に3行でまとめ
-
DBMS_CLOUD_AIのregion属性ひとつで、東京のADWから大阪のOCI Generative AIを呼べる - 生成SQLの精度はスキーマに何を見せるかで決まる。空のスキーマだと話にならない
- 精度が足りないときエラーは出ない。動くけれど答えが違うSQLが返ってくる
前提環境
- Autonomous Database(Oracle AI Database 26ai / 23.26.3.3.0 / Always Free / 東京リージョン)
- Oracle APEX 26.1.4(ORDS 26.2.2)
- 呼び先は大阪リージョンの OCI Generative AI、モデルは
cohere.command-a-03-2025 - クライアントは python-oracledb 4.0.2(Thinモード)
東京のADWから大阪の生成AIを呼ぶ
前回書いたとおり、OCI Generative AI は東京リージョンにありません。で、私のADWは東京にあります。
普通に考えると詰んでるんですが、Select AI(DBMS_CLOUD_AI)には region 属性というのがあって、これで越境できます。
ADWに接続する
まずDBに繋ぎます。python-oracledb の Thin モードなら Oracle Instant Client を入れなくていいので、pip install oracledb だけで済みます。楽でいいですね。
region属性で越境する
ここが今回の肝です。
やることは2つだけ。大阪テナンシのAPIキーをDBに登録して、AIプロファイルを作る。それだけです。
begin
  dbms_cloud.create_credential(
    credential_name => 'GENAI_OSAKA_CRED',
    user_ocid       => 'ocid1.user.oc1..xxxxx',
    tenancy_ocid    => 'ocid1.tenancy.oc1..xxxxx',
    private_key     => 'MIIEvQIBADANBgkqhkiG9w0BAQEFAASC...',
    fingerprint     => 'xx:xx:xx:xx:xx:xx:xx:xx');
end;
/
秘密鍵はPKCS#8形式(BEGIN PRIVATE KEY)で、ヘッダ・フッタ・改行を除いた本体だけを渡します。
そしてプロファイルです。
begin
  dbms_cloud_ai.create_profile(
    profile_name => 'GENAI_OSAKA',
    attributes   => '{
      "provider": "oci",
      "credential_name": "GENAI_OSAKA_CRED",
      "region": "ap-osaka-1",
      "model": "cohere.command-a-03-2025",
      "oci_compartment_id": "ocid1.compartment.oc1..xxxxx",
      "oci_apiformat": "COHERE"
    }',
    status => 'enabled');
end;
/
"region": "ap-osaka-1" の一行だけです。これで東京のDBが大阪のモデルを呼びます。
疎通を確認します。
select dbms_cloud_ai.generate(
         prompt       => 'あなたは誰ですか。1文で答えてください。',
         profile_name => 'GENAI_OSAKA',
         action       => 'chat') from dual;

私は、Cohereが開発した、テキスト生成に特化したAIアシスタントです。
あっさり返ってきました。簡単です。
なお oci_apiformat はモデルの系統で変わります。Cohere系は COHERE、Google / OpenAI / Meta 系は GENERIC です。
最初のNL2SQLは上出来だった
チャットが通ったので、本題のNL2SQLを試します。
object_list で対象の表を教えます。ここでは ADMIN スキーマから、SYS所有の DBA_HIST_* を直接指定しました。
begin
  dbms_cloud_ai.set_attribute(
    profile_name    => 'GENAI_OSAKA',
    attribute_name  => 'object_list',
    attribute_value => '[{"owner":"SYS","name":"DBA_HIST_SQLSTAT"},
                         {"owner":"SYS","name":"DBA_HIST_SQLTEXT"},
                         {"owner":"SYS","name":"DBA_HIST_SNAPSHOT"}]');
end;
/
そして日本語で聞きます。
直近24時間で最もCPU時間を消費したSQLの上位5件を、SQL_IDと合計CPU時間と実行回数で表示して

返ってきたSQLがこれです。
SELECT dhss."SQL_ID" AS sql_id,
       SUM(dhss."CPU_TIME_DELTA")   AS total_cpu_time,
       SUM(dhss."EXECUTIONS_DELTA") AS execution_count
FROM "SYS"."DBA_HIST_SQLSTAT" dhss
INNER JOIN "SYS"."DBA_HIST_SNAPSHOT" dhs
  ON  dhss."SNAP_ID"         = dhs."SNAP_ID"
  AND dhss."INSTANCE_NUMBER" = dhs."INSTANCE_NUMBER"
  AND dhss."DBID"            = dhs."DBID"
WHERE dhs."END_INTERVAL_TIME" > SYSTIMESTAMP - INTERVAL '24' HOUR
GROUP BY dhss."SQL_ID"
ORDER BY total_cpu_time DESC
FETCH FIRST 5 ROWS ONLY
よさげに見える。
APEXから使えるようにする
SQLで動いたので、次はAPEXから使えるようにします。
ワークスペースにログインできない
ワークスペースをAPEX_INSTANCE_ADMIN.ADD_WORKSPACE で作ります。なお ADMIN は予約スキーマなので割り当てできません。専用スキーマを別に作る必要があります。
ログイン画面にワークスペースを入力する欄がなかった。これはインスタンス設定が原因で、APEX_BUILDER_AUTHENTICATION が ADB になっていると、APEX BuilderへのログインがADBのデータベースユーザー認証に切り替わります。APEX に変えると、見慣れたワークスペース・ユーザー名・パスワードの3欄に戻ります。

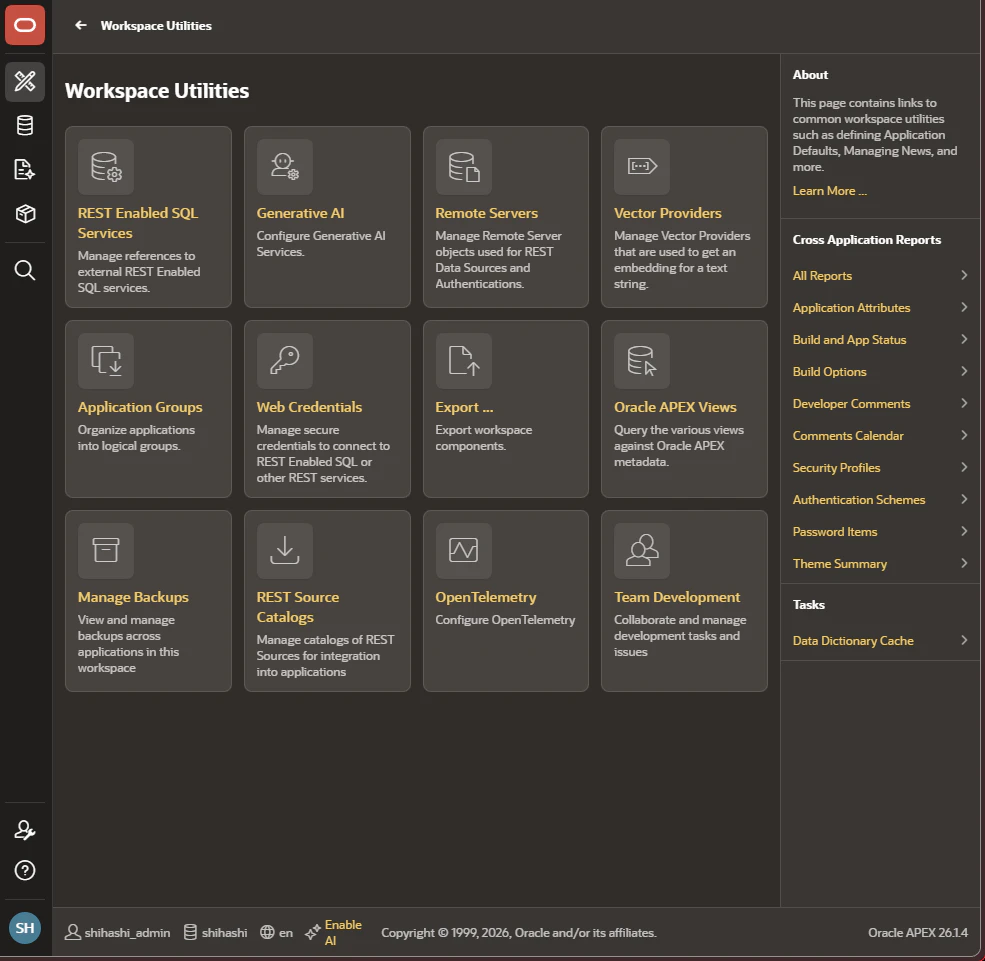
ワークスペースに入れたので、生成AIサービスを登録します。App Builder から「ワークスペース・ユーティリティ」→「生成AI」→「作成」と進み、プロバイダに OCI Generative AI Service を選びます。



ここでも1つ引っかかりました。
接続テストで Compartment ID is not valid
The HTTP request to Generative AI Service at
https://inference.generativeai.ap-osaka-1.oci.oraclecloud.com/20231130/actions/chat
failed with HTTP-400: 400: Compartment ID is not valid
エンドポイントは大阪を向いているので、リージョンは合っています。コンパートメントIDだけの問題でした。
テナンシのルートOCID(ocid1.tenancy...)を入れていたのが原因です。CLIからはルートでも普通に通るのに、APEX経由だと弾かれます。ocid1.compartment... のサブコンパートメントを指定したら通りました。
「接続のテスト」で Connection Succeeded! が出れば設定完了です。

まともなSQLが返ってこない
さて本題です。
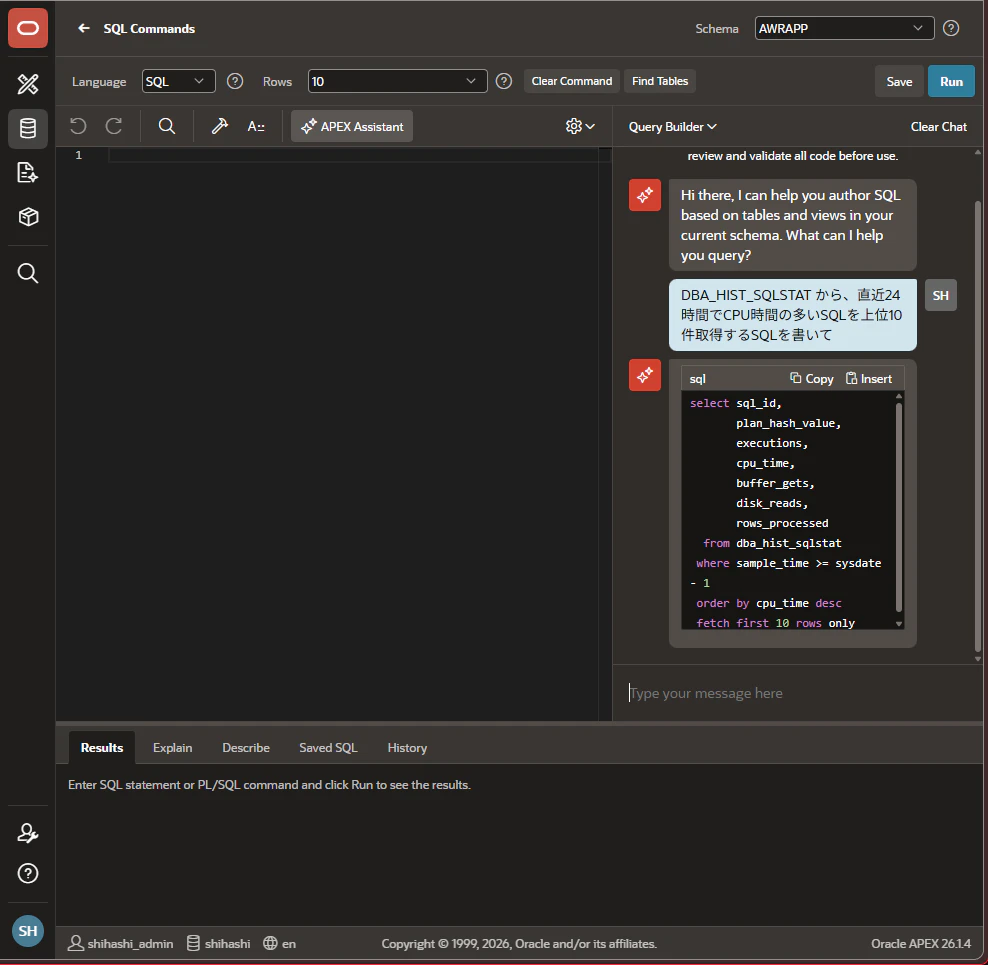
APEXアシスタントを使ってみます。SQLワークショップのSQLコマンド画面で、メニューバーの「APEXアシスタント」を開くと右ペインに出てきます。ここに日本語で指示すればSQLを書いてくれる、という機能ですね。
開くと、こう挨拶してきます。
Hi there, I can help you author SQL based on tables and views in your current schema. What can I help you query?

「現在のスキーマにあるテーブルとビューに基づいて」と言っています。この一文が後で効いてきます。
さっそく聞いてみました。
DBA_HIST_SQLSTAT から、直近24時間でCPU時間の多いSQLを上位10件取得するSQLを書いて
返ってきたのがこれです。
select sql_id,
       plan_hash_value,
       executions,
       cpu_time,
       buffer_gets,
       disk_reads,
       rows_processed
  from dba_hist_sqlstat
 where sample_time >= sysdate - 1
 order by cpu_time desc
 fetch first 10 rows only
実行すると当然こうなりました。
ORA-00904: "SAMPLE_TIME": invalid identifier

SAMPLE_TIME なんて列は DBA_HIST_SQLSTAT にありません。EXECUTIONS も CPU_TIME も無くて、正しくは EXECUTIONS_DELTA や CPU_TIME_DELTA です。
スナップショットとの結合もしていません。
たぶん推測で書いてますね。
このエラーをそのままアシスタントに投げたら
このエラーは、
SAMPLE_TIME列がDBA_HIST_SQLSTATビューに存在しないために発生しています。DBA_HIST_SQLSTATビューにはSNAPSHOT_TIME列が存在します。
と返してきました。

SNAPSHOT_TIME も存在しません。
間違いを指摘されて、別の間違いで答えています。
さっきSQLで試したときは、3キー結合まで正確に書けてたモデルです。
同じDB、同じ大阪のGen AI、同じ cohere.command-a-03-2025。
なのに別物みたいな結果になりました。
モデルの性能が悪い?
原因はスキーマが空だったこと
調べたら、そういう話ではありませんでした。
さっきの挨拶文に答えがありました。「based on tables and views in your current schema」です。
APEXアシスタントは、ワークスペースのパーススキーマにあるオブジェクト定義を手がかりにSQLを書きます。私が作ったワークスペースのスキーマは AWRAPP で、中身を見たらこうなっていました。
=== AWRAPP スキーマが持つオブジェクト ===
  SQL TRANSLATION PROFILE: 1
  CREDENTIAL: 1
テーブルもビューも1つもありません。
DBA_HIST_* はSYS所有なので、AWRAPP からはオブジェクトとして見えません。つまりAPEXアシスタントは、列が何なのかも知らないまま推測でSQLを書かされていたことになります。
一方でSQLから試したときは、object_list で DBA_HIST_SQLSTAT を明示していました。Select AIはそこから列定義を読んでプロンプトに含めます。だから正確に書けた。
モデルの性能ではなく、渡している情報の差でした。
ビューを作ったら構造は正確になった
AWRAPP から DBA_HIST_* が見えるようにします。
-- ADMIN で直接付与する。ロール経由の権限ではビューを作れない
grant select on sys.dba_hist_sqlstat  to AWRAPP;
grant select on sys.dba_hist_sqltext  to AWRAPP;
grant select on sys.dba_hist_snapshot to AWRAPP;
SELECT_CATALOG_ROLE は付けてあったのですが、ロール経由の権限ではビューが作れないので、直接付与し直しました。
その上で AWRAPP にビューを3つ作り、コメントで結合キーを教えておきます。
create or replace view awr_snapshot as
  select snap_id, dbid, instance_number, begin_interval_time, end_interval_time
  from sys.dba_hist_snapshot;

comment on table awr_snapshot is
  'AWRスナップショットの採取時刻。SQL統計とは snap_id/dbid/instance_number の3つで結合する';
この状態でもう一度書かせました。
select sql_id, command_type, sql_text, cpu_time_delta, executions_delta, ...
  from (select s.sql_id, t.command_type, t.sql_text, s.cpu_time_delta, ...,
               row_number() over (order by s.cpu_time_delta desc) as rn
          from awr_sqlstat s
          join awr_sqltext  t on s.sql_id = t.sql_id
          join awr_snapshot sn
            on s.snap_id = sn.snap_id
           and s.instance_number = sn.instance_number
           and s.dbid = sn.dbid
         where sn.begin_interval_time >= sysdate - 1
           and sn.end_interval_time <= sysdate)
 where rn <= 10
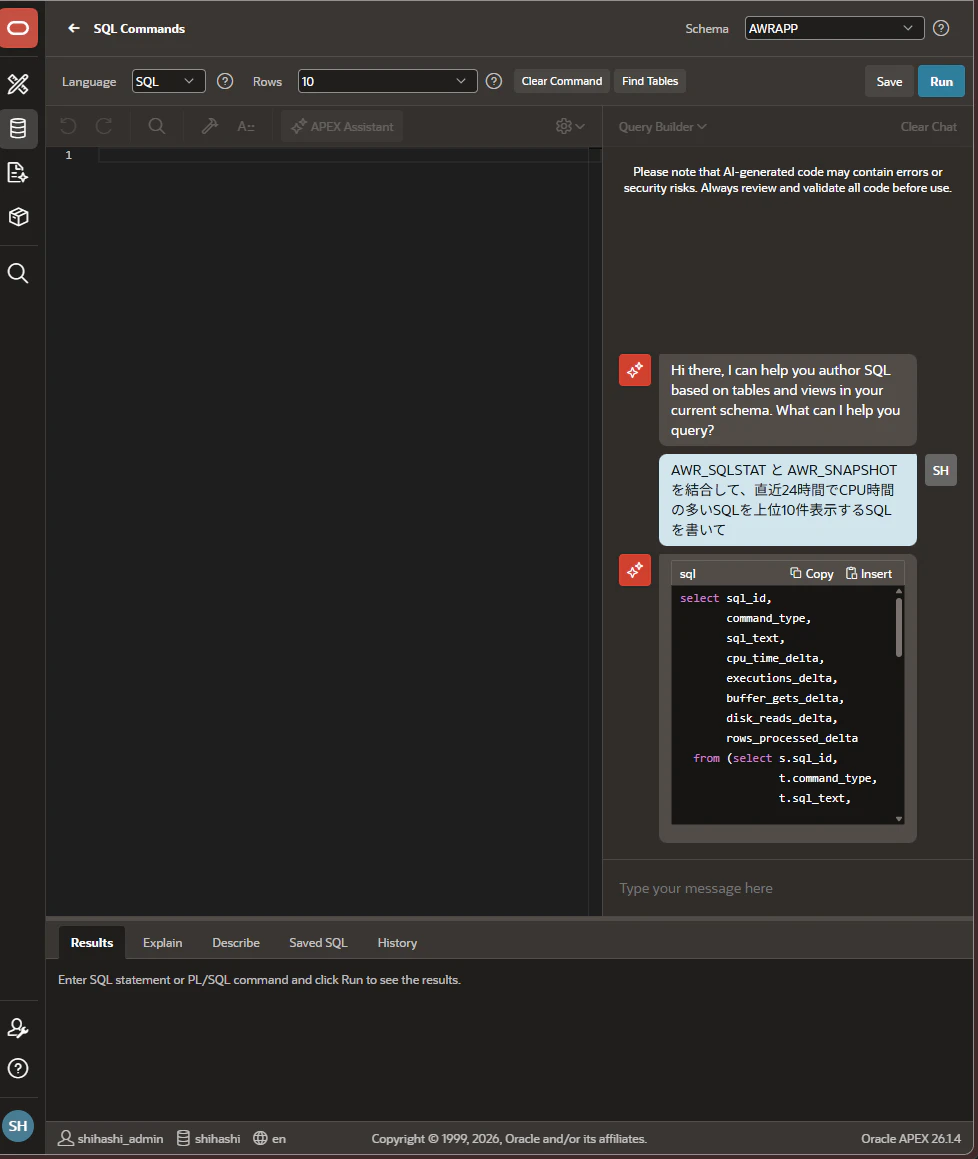
別物になりました。
snap_id / instance_number / dbid の3キー結合ができています。_DELTA 列も選んでいます。コメントに書いたことは、ちゃんと守られています。
ただ、よく見ると SUM と GROUP BY がありません。
動くが、答えが間違っている
これが今回一番困る箇所かなと思います。
このSQLはエラーになりません。実行すると結果が普通に返ってきます。それらしい表が出るので、そのまま信じてしまいそうになります。
実際に流してみました。
  b6usrg82hwsa3    cpu=   106,593,762 exec=         4
  b6usrg82hwsa3    cpu=   106,593,762 exec=         4
  62xfb47k9nry2    cpu=    79,396,183 exec=         2
  62xfb47k9nry2    cpu=    44,387,888 exec=         2
  62xfb47k9nry2    cpu=    42,213,202 exec=         1
  ...
  -> 異なるSQL_ID: 2 種類 / 10 行

上位10件のはずが、2種類のSQL_IDが重複しているだけでした。
awr_sqlstat は「スナップショット × SQL_ID × 実行計画」で行が割れます。集計せずに並べると、1スナップショット内での最大値でランキングされてしまいます。
正しく SUM して GROUP BY するとこうなります。
  62xfb47k9nry2    cpu= 1,950,337,807 exec=        49
  5dqz0hqtp9fru    cpu=   943,389,199 exec=28,967,592
  b39m8n96gxk7c    cpu=   357,849,348 exec=       236
  b6usrg82hwsa3    cpu=   274,840,007 exec=        10
  61znfd8fvgha6    cpu=   182,572,067 exec=        54
並べて比べます。
| 生成SQL | 正しい集計版 | |
|---|---|---|
| 上位10件の中身 | 2種類のSQL_IDが重複 | 10種類 |
| 1位 | b6usrg82hwsa3(1億) | 62xfb47k9nry2(19.5億) |
生成SQLが1位だと言った b6usrg82hwsa3 は、正しく集計すると4位です。CPU時間にして18倍以上の差があるSQLを見逃していたことになります。
コメントを足しても変わらなかった
原因が集計漏れだと分かったので、コメントに書けばいいだろうと考えました。
comment on table awr_sqlstat is
 'AWRのSQL別実行統計。1つのSQL_IDに対しスナップショット単位かつ実行計画単位で複数行が存在する。
  期間全体で評価する場合は必ず SQL_ID で GROUP BY し、_DELTA 列を SUM すること。
  集計せずに並べると同じSQL_IDが重複し順位が誤る';
かなり露骨に書きました。これで直るだろうと。
結果は、変わりませんでした。
SUM も GROUP BY も入らず、むしろ awr_sqltext の結合が dbid 抜きになって前回より雑になりました。
コメントを読んでいる気配がありません。
Select AI側で切り分ける
APEXアシスタント側は中身が見えないので、Select AI で切り分けることにしました。こちらにはプロファイル属性として comments と additional_instructions があります。
同じDB、同じビュー、同じモデル。プロファイルの属性だけを変えて比較します。
| パターン | 設定 | Select AIの検証 | SUM | GROUP BY |
|---|---|---|---|---|
| A | comments: false |
通過 | × | × |
| B | comments: true |
不合格 | ○ | ○ |
| D |
comments: true + additional_instructions
|
通過 | ○ | ○ |
Aは、さっきのAPEXアシスタントと同じ状態です。構文的には正しいので通ってしまいますが、集計していないので答えは誤りです。
Bが面白くて、comments: true にした瞬間に SUM と GROUP BY が入りました。コメント自体はちゃんと効きます。APEXアシスタント側に届いていなかっただけでした。
ただしBは検証に落ちています。
Sorry, unfortunately a valid SELECT statement could not be generated
理由は SQL_TEXT です。CLOB型の列を選択したまま集計しようとして、GROUP BY できずに構文エラーになっていました。集計を覚えたら、今度は別のところでつまずいたのかなと。
そこでDとして、追加指示を足しました。
期間全体で評価する指標は必ず SQL_ID で GROUP BY し、_DELTA 列を SUM すること。
SQL_TEXT は CLOB 型のため GROUP BY に使えない。集計クエリでは SQL_TEXT を選択しないこと。
出てきたSQLがこれです。
SELECT ss.SQL_ID AS "SQL_ID",
       SUM(ss.CPU_TIME_DELTA)   AS "TOTAL_CPU_TIME_MICROSEC",
       SUM(ss.EXECUTIONS_DELTA) AS "TOTAL_EXECUTIONS"
FROM "AWRAPP"."AWR_SQLSTAT" ss
JOIN "AWRAPP"."AWR_SNAPSHOT" sn
  ON  ss.SNAP_ID         = sn.SNAP_ID
  AND ss.DBID            = sn.DBID
  AND ss.INSTANCE_NUMBER = sn.INSTANCE_NUMBER
WHERE sn.END_INTERVAL_TIME > SYSTIMESTAMP - INTERVAL '24' HOUR
GROUP BY ss.SQL_ID
ORDER BY "TOTAL_CPU_TIME_MICROSEC" DESC
FETCH FIRST 10 ROWS ONLY
実行結果は、手で書いた集計版と完全に一致しました。1位は 62xfb47k9nry2、CPU時間 1,950,337,807、実行回数49回です。
考察
モデルは最初から最後まで cohere.command-a-03-2025 のままです。一度も変えていません。それでも結果はこう変わりました。
| 段階 | 渡した情報 | 生成SQLの状態 |
|---|---|---|
| 1 | 何も(スキーマが空) | 話にならない |
| 2 | ビュー=構造だけ | 3キー結合は正確。集計が抜け、1位が本来4位のSQLに |
| 3 | +コメント | 集計するが、CLOBで構文エラー |
| 4 | +追加指示 | 完成 |
思ったことを3つほど。
教えた範囲は守り、教えていない前提は落ちる。
3キー結合はコメントに書いたので守られました。集計は書かなかったので落ちました。CLOBの扱いも、書いたら直りました。きれいなくらい対応しています。逆に言えば、渡していない前提知識は期待できないということですね。
AWRで言えば「_DELTA列は差分だから合計する」なんて、触ってる人には当たり前すぎてわざわざ言葉にしない話です。そういうものほど抜け落ちるんだなと。
落ちたときにエラーではなく、それらしい誤答が返る。
これが一番やっかい。段階2のSQLは構文的に正しくて、実行できて、結果も返ってきます。数字が並んだ表を見たら「なるほど、このSQLが重いのか」で納得する可能性があります。
Oracle Databaseをメインに管理運用している担当者なら気づくでしょう。
でも知識が浅い人がやると、AIが出してきたSQLでそれっぽい答えが返ってきたので信じそうです。
同じDBでも、経路によってメタデータの渡り方が違う。
APEXアシスタントとSelect AIで、コメントの扱いが違いました。Select AIは comments: true でちゃんと読みますが、APEXアシスタントの方は(少なくとも今回の環境では)読んでいないように見えます。
「APEXから使えるようにしたから同じように動くだろう」と思っていると、ここでズレます。どの経路が何を見ているかは、意識しておいた方がよさそうです。
まとめ
-
DBMS_CLOUD_AIのregion属性ひとつで、東京のADWから大阪のOCI Generative AIを呼べる。越境は簡単 - NL2SQLの精度はモデルの性能より、渡すメタデータの設計で決まる
- スキーマに実体が無いと話にならない。ビューを作って見せるだけで別物になる
- 教えた範囲は守り、教えていない前提は落ちる
- 落ちたときにエラーではなく、それらしい誤答が返る
- コメントは効く。ただし経路によっては届いていない
最初にAPEXアシスタントを触ったときは「思ったより使えないな」で終わるところでした。でも実際はモデルの問題じゃなくて、こっちが何も教えてないだけでした。
業務で使うことを考えるなら、モデル選びに悩む前に、ビューとコメントと追加指示をどう設計するかを考えるところから始めましょう。(SELECT AIだけを使う場合も同様)