
0.Prologue
暇つぶしに、興味を引いた DNNアプリを *Interpに移植して遊んでいる。
本稿はその雑記&記録。
YuNet, Ultra-lightweight face detection, RetinaFace, CenterFaceと顔検出モデル(Face detection)を移植してきた。これらのうち Ultra以外のモデルは、おまけ(?)として顔の部品である目・鼻・口の位置も検出するのだが、基本的には顔の領域(Face BBox)を推論するモデルだった。より詳細に顔のlandmark(目・鼻・口・眉・輪郭)を検出するには、Face-alignmentに特化したモデルを用いるのがどうやら常道のようだ。つまり、
(1)顔検出で Face BBoxを検出 → (2)顔の部品検出で landmarkを検出 → (3)何らかの画像加工
の流れで顔アプリを作りましょうということらしい。
ならば、Face-alignmentをやってみるべし。
1.Original Work
一口に Face-alignmentと言っても、Deep Learning旋風が吹き荒れる以前から連綿と研究されている様で、統計的な手法、統計的機械学習な手法、Deep Learningな手法といろいろとある様だ。今回は、最もシンプルそうな下記のモデルで遊んでみる。
- InsightFace - 2D and 3D Face Analysis Project: SimpleRegression
https://github.com/deepinsight/insightface/tree/master/alignment/coordinate_reg
タイトルに "regression"(回帰)とあるので、たぶん何らかの関数のフィッティング問題を解いているのだろうが、論文も技術情報も参考文献もソースコードすらも公開されていないので、詳細は一切分からない。ただただ、下のテンプレートの点群が入力画像にフィットしたときの座標が推論結果として得られるということだけが分かっている。

勝手な想像だが、↓これらの手法のグループに分類されるものかな?
- ACR Loss: Adaptive Coordinate-based Regression Loss for Face Alignment:
https://arxiv.org/abs/2203.15835 - Face Alignment by Explicit Shape Regression:
https://www.microsoft.com/en-us/research/wp-content/uploads/2013/01/Face-Alignment-by-Explicit-Shape-Regression.pdf - Better initialization for regression-based face alignment
https://zhiwenshao.github.io/pdfs/projects/2017/zhu2017better.pdf
2.準備
SimpleRegressionの ONNXモデルは、上の「InsightFace」プロジェクトから調達する。
Google drive:
https://drive.google.com/file/d/13Pz8mH-a1s7RXpq_jFUXxaqCpDUE0oSr/view?usp=sharing
このモデルを使用するサンプル・コードが公開されているが、情報量は極端に少ない。勘と試行錯誤に頼ることになりそうだ
https://github.com/deepinsight/insightface/blob/master/alignment/coordinate_reg/image_infer.py
3.OnnxInterp用のLivebookノート
Mix.installの依存リストに記述するモジュールは下記の通り。
File.cd!(__DIR__)
# for windows JP
System.shell("chcp 65001")

Mix.install([
  {:onnx_interp, path: ".."},
  {:cimg, "~> 0.1.17"},
  {:nx, "~> 0.4.1"},
  {:kino, "~> 0.8.0"}
])
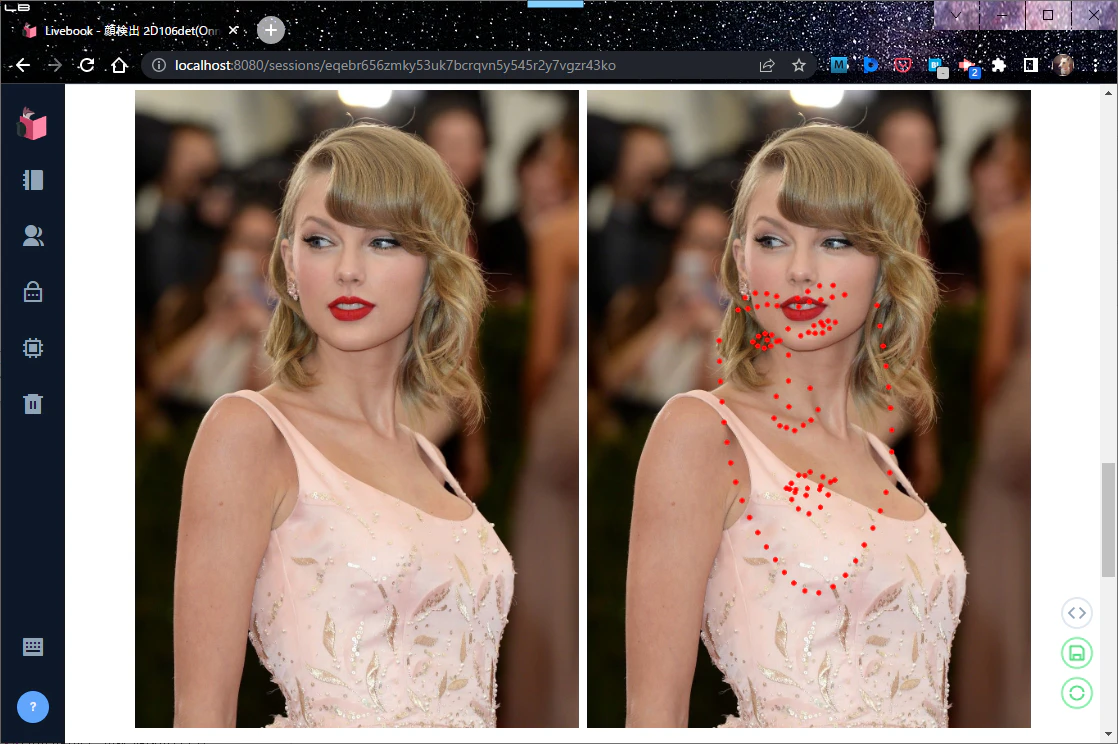
モデルの入力には、人物の顔の部分を切り出した画像を与える。試しに人物の全体像の画像を与えると下図のようになんだか訳の分からない結果となる。実アプリでは、顔検出を行う RetinaFace等とのコラボが必須ってことだな。画像のresizeは aspect比を保存せずに行った。ちょっとぐらいの歪なら許容できるだろう。画素値の変換は、単純に 8bit符号無し整数を 32bit-floatに変換すれば良いようだ。
モデルの出力は、先のテンプレートの106点の座標値が番号順かつ(x,y)順に並んだ tensor float32[1][212]。後続処理で扱い易いように reshape {106,2}してしまう。座標値の範囲を観察すると、x,yそれぞれ -1.0~1.0の範囲に収まっているので、たぶん画像の中心を(0.0,0.0)とする ±1.0の座標系で表されているのだろう。もしもこの予想が外れたら、その時に考えよう
[モデル・カード]
- inputs:
[0] f32:{None,3,192,192} - RGB画像,NCHWレイアウト,画素はRGB各値(符号なし8bit整数)をそのままfloat 32bit型に変換- outputs:
[0] f32:{1,212} - テンプレートの106点の座標値(x,y)
defmodule FaceAlign do
  @width 192
  @height 192

  alias OnnxInterp, as: NNInterp
  use NNInterp,
    model: "model/2d106det.onnx",
    inputs: [f32: {1, 3, @height, @width}],
    outputs: [f32: {1, 212}]

  def apply(img) do
    # preprocess
    input0 = img
      |> CImg.resize({@width, @height})
      |> CImg.to_binary([{:range, {0.0, 255.0}}, :nchw])

    # prediction
    output0 = session()
      |> NNInterp.set_input_tensor(0, input0)
      |> NNInterp.invoke()
      |> NNInterp.get_output_tensor(0)
      |> Nx.from_binary(:f32) |> Nx.reshape({:auto, 2})

    # postprocess
    landmark = output0
      |> Nx.add(Nx.tensor([1.0, 1.0]))
      |> Nx.divide(2.0)
      |> Nx.to_flat_list()
      |> Enum.chunk_every(2)

    {:ok, landmark}
  end
end
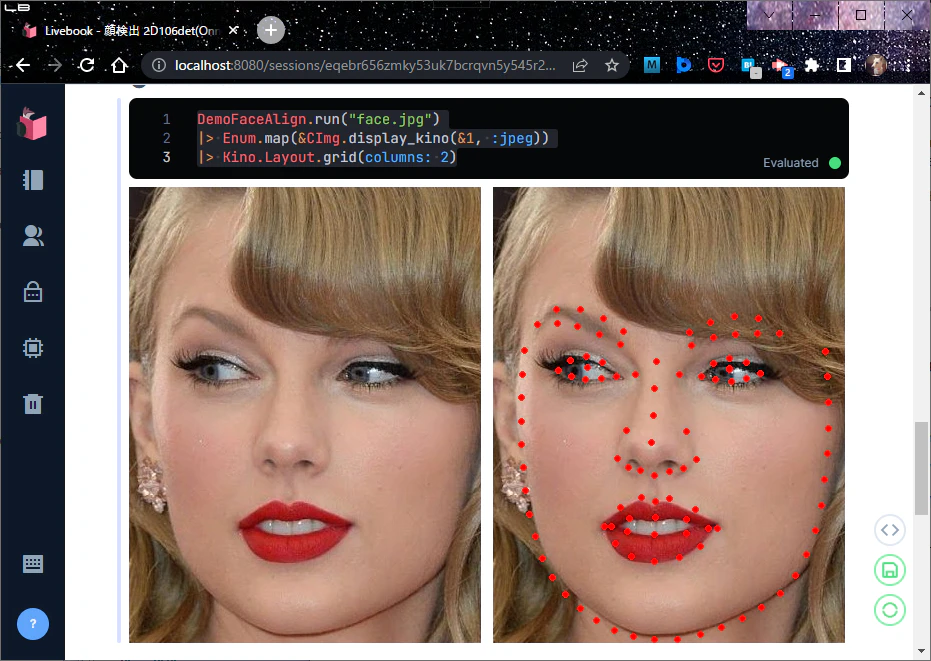
デモ・モジュール DemoFaceAlignは、FaceAlignから受け取った点列を赤丸として画像上に描画する。デモンストレーションのために、処理前後の画像をリストにして返している。
defmodule DemoFaceAlign do
  def run(path) do
    img = CImg.load(path)

    [
      img,
      with {:ok, res} = FaceAlign.apply(img) do
        draw_item(res, CImg.builder(img), :red)
      end
    ]
  end

  defp draw_item(landmark, canvas, color) do
    Enum.reduce(landmark, canvas, fn [x, y], canvas ->
      CImg.draw_marker(canvas, x, y, color, size: 2)
    end)
  end
end
4.デモンストレーション
FaceAlignを起動する。
FaceAlign.start_link([])
画像を与え、Face-alignmentを行う。
DemoFaceAlign.run("face.jpg")
|> Enum.map(&CImg.display_kino(&1, :jpeg))
|> Kino.Layout.grid(columns: 2)
5.Epilogue
技術的背景はよく分からないが、無事に Face-alignmentが動いた。Face-alignmnetの手法には、今回遊んでみた regression系のほかに heatmap系があるそうだ。機会があれば遊んでみたいと思う。たぶんどのような手法でも、顔部分の画像の切り出しが必要になるだろうから、リアルタイムな応用には画像処理のコストにも気を付ける必要があるかな。
(END)