

はじめに
案件でAIエージェントに関わる可能性があり、関連技術について調べている中で「ベクトルデータベース(Vector DB)」という言葉をよく見かけました。
これまでリレーショナルデータベース(RDB)やDWHには触れたことがありましたが、Vector DBについてはあまり理解できていなかったため、今回調べた内容をまとめてみます。
この記事では、Vector DBとは何か、なぜ生成AIで利用されるのかについて初心者向けに解説します。
この記事はこんな人向け
- Vector DBとは何か知りたい方
- RAGについて学び始めた方
- AI・LLM案件に参画予定の方
- ベクトル検索の仕組みを理解したい方
Vector DBとは?
Vector DB(ベクトルデータベース)とは、
文章や画像などを「ベクトル(数値の並び)」として保存し、意味の近いデータを高速に検索するためのデータベースです。
通常のデータベースは、
「IDが1」
「名前が田中」
のような完全一致や条件検索が得意です。
一方、Vector DBは、
「意味が近いデータを探す」
ことが得意です。
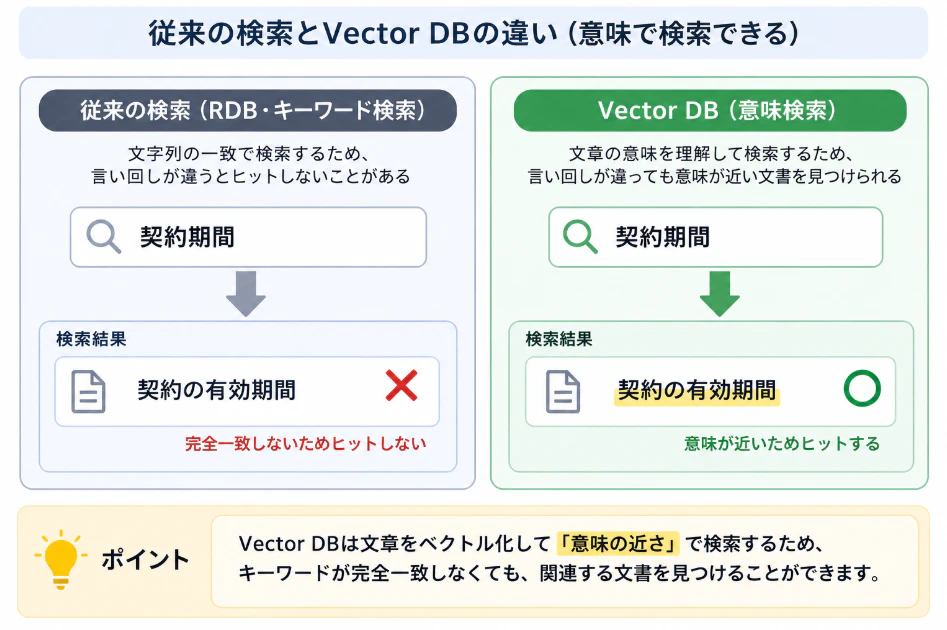
なぜ通常のRDBではダメなの?
例えば、
「契約期間について教えて」
と検索したとします。
社内文書には
契約の有効期間
と書かれていた場合、
通常のSQL検索ではヒットしない可能性があります。
一方Vector DBは↓図のように、意味が近い文章を見つけることができます。
ベクトルとは?
AIは文章をそのまま理解しているわけではありません。
文章を数百~数千個の数字に変換しています。
例えば、
「猫」
↓
[0.12, -0.42, 0.85, ...]
「犬」
↓
[0.10, -0.39, 0.88, ...]
このような数値列をベクトルと呼びます。
意味が近い文章ほど、似たようなベクトルになります。
Vector DBの役割
Vector DBは、
このベクトルを保存し、
「一番近いものはどれ?」
を高速で検索します。
イメージは次のようになります。
質問
「契約期間について教えて」
        ↓
Embedding
(文章をベクトル化)
        ↓
Vector DB
(似ている文章を検索)
        ↓
関連文書
        ↓
LLM
        ↓
回答
この流れがRAGでよく利用されています。
RDBとの違い
| 項目 | RDB | Vector DB |
|---|---|---|
| 保存するもの | 行・列のデータ | ベクトル |
| 得意な検索 | 完全一致・条件検索 | 意味検索 |
| SQL | ○ | 基本不要(製品によって対応あり) |
| AIとの相性 | △ | ◎ |
よく利用されるVector DB
代表的な製品には以下があります。
| 製品 | 特徴 |
|---|---|
| Pinecone | クラウド型で人気 |
| Weaviate | OSS版あり |
| Milvus | 大規模データ向け |
| Qdrant | 軽量で人気 |
| Chroma | 小規模・学習用途で利用されることが多い |
最近ではPostgreSQLの拡張機能であるpgvectorを利用して、既存のPostgreSQLにベクトル検索機能を追加するケースも増えています。
なぜRAGで利用されるの?
RAGでは、
ユーザーの質問に関連する情報を検索してからLLMへ渡します。
ユーザー
      ↓
質問をベクトル化
      ↓
Vector DB検索
      ↓
関連文書取得
      ↓
OpenAI API
      ↓
回答
この検索部分を担当するのがVector DBです。
個人的に調べてみて思ったこと
最初は「AI専用のデータベースなのかな?」と思っていました。
しかし実際には、
AIが理解できる形式(ベクトル)を保存し、意味で検索するためのデータベース
という位置付けであることが分かりました。
また、RAGではLLMだけでなく、Vector DBも重要な役割を担っていることを知り、AIシステムはLLM単体ではなく複数の技術を組み合わせて構築されているのだと感じました。
まとめ
Vector DBは、
意味が近いデータを高速に検索するためのデータベースです。
RDBとは役割が異なり、
- RDB:IDや条件で検索
- Vector DB:意味で検索
という違いがあります。
生成AIやRAGを構築する際には欠かせない技術の一つであり、今後AI関連案件では触れる機会も増えていきそうです。
私自身も案件で扱う可能性があるため、次はEmbedding(埋め込み)やRAGの仕組みについても学習していきたいと思います。
最後まで読んでいただき、ありがとうございました!