
アルゴリズムを勉強していると、木やグラフの探索は関門の一つです。
競プロで問題と模範解答を参考に実装を眺めてみても、探索処理の根幹の部分と問題固有の処理の部分がごちゃ混ぜになっていて、探索処理の本質部分が掴みづらく、他の問題へ応用させたい時にどうすればいいのかわからない。という悩みを抱えている人は多いのではないでしょうか。
そこで、この記事では幅優先探索、深さ優先探索の根幹の探索処理の部分に着目して、BFS,DFSを実装する時に他の問題に適用させるための基本になる考え方のプロセスを示しました。
前提
今回は、以下のような無向グラフにおける幅優先探索、深さ優先探索を考えることにします。
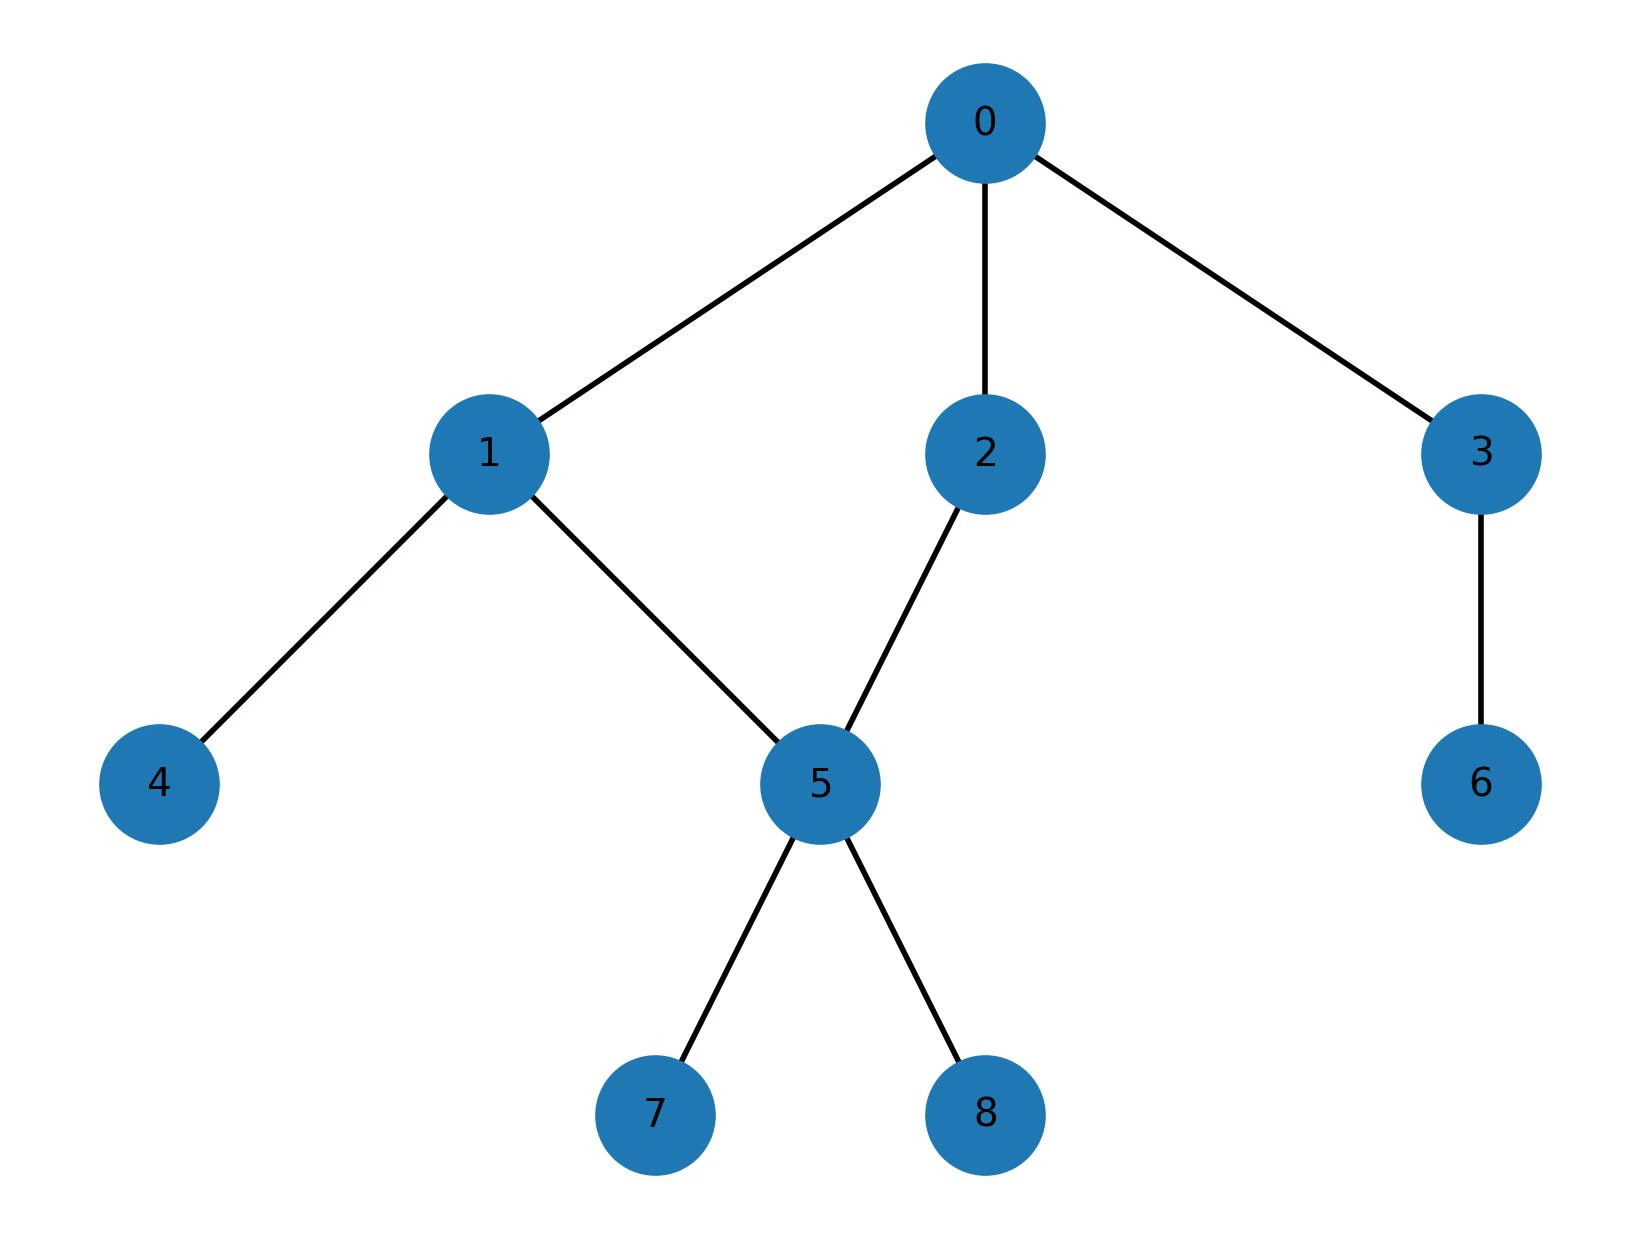
また、実際にプログラム上では、隣接リストと呼ばれる形で表現することにします。今回はPythonでの実装例を示していきます。
graph = [
    [1, 2, 3],
    [0, 4, 5],
    [0, 5],
    [0, 6],
    [1],
    [1, 2, 7, 8],
    [3],
    [5],
    [5]
]
隣接リストは、各要素のインデックスをそれぞれグラフのノードに見立てて、リストの要素にはノードにつながっているノードの情報だけを保存するデータ構造です。隣接リストでの計算量は、ノード数を${N}$,エッジ数${E}$とすると、${O(N+E)}$となります。
幅優先探索
幅優先探索は、探索中のノードにつながっているノードを優先して探索する処理です。キューというデータ構造を利用して、キューが空になるまでループを繰り返して探索するアルゴリズムです。キューには探索中のノードに隣接しているノードのインデックスを保存します。ここでは探索をスタートするノードをグラフの0番目の要素から始めるものとします。キューから探索開始位置のノードの情報を取得するとき、次のような処理になります。
queue = [0]
while queue:
    current = queue.pop(0)
そして、探索中のノードにつながっているノードの一覧を取得して、次に探索するノードをキューに入れます。
queue = [0]
while queue:
    current = queue.pop(0)
+   for idx in graph[current]:
+       queue.append(idx)
ここで一つ問題が発生します。上記の書き方だと、グラフの構造によっては、延々と同じ場所をグルグル回り続けて無限ループしてしまったり、探索済みのノードをもう一回探索してしまうなど不都合が生じます。
そのため、探索済みのノードを記録していくリストを追加して、探索済みのノードでは処理をスキップする処理を加えます。まずは、すべて未探索の状態で初期化したvisitedと呼ばれるグラフと同じ長さのリストを用意します。
queue = []
+ visited = [False for _ in range(len(graph))]
while queue:
    current = queue.pop(0)
    for idx in graph[current]:
        queue.append(idx)
一度探索したノードは、Trueに書き換えて探索済みとします。
queue = []
visited = [False for _ in range(len(graph))]
while queue:
    current = queue.pop(0)
+   visited[current] = True
    for idx in graph[current]:
        queue.append(idx)
最後に、探索済みのフラグが立っているノードに対してはスキップする処理を加えます。
queue = []
visited = [False for _ in range(len(graph))]
while queue:
    current = queue.pop(0)
+   if visited[current]:
+       continue
    visited[current] = True
    for idx in graph[current]:
+       if visited[idx]:
+           continue
        queue.append(idx)
以上から、幅優先探索では
①キューからデータを取り出す
②探索中のノードにつながっているノードをキューに加える
③探索済みのフラグが立っているノードに対してはスキップする処理を加える
の3段階で考えると見通しが良くなります。
深さ優先探索
深さ優先探索では、スタックと呼ばれるデータ構造を使ってループさせることで、いけるところまで進んで行き止まりになったら戻ってくるという動きができます。スタックは再帰関数を使うと実装できます。
ループさせる方法は違いますが、探索中のノードにつながっているノードにアクセスしていくのを繰り返すところは幅優先探索と変わりません。まずは、幅優先探索の時と同じように、探索中のノードにつながっているノードの一覧を取得して、次に探索するノードをキューに入れる処理まで考えます。
def dfs(idx):
    current = graph[idx]
    for next_idx in current:
        dfs(next_idx)

dfs(0)
そして、深さ優先探索でも探索済みのノードを再探索して無限ループになることを防ぐために、探索済み⇔未探索のノードを記録するリストを追加して、探索したノードを探索済みにするフラグを立てる処理を入れます。
+ visited = [False for _ in range(len(graph))]
def dfs(idx):
    current = graph[idx]
+   visited[idx] = True
    for next_idx in current:
        dfs(next_idx)

dfs(0)
最後に探索済みのノードは再度辿らないようにする処理を入れます。
visited = [False for _ in range(len(graph))]
def dfs(idx):
    current = graph[idx]
    visited[idx] = True
    for next_idx in current:
+       if visited[next_idx]:
+           continue
        dfs(next_idx)

dfs(0)
深さ優先探索では、
①引数に探索開始位置のインデックスを受け取る再帰関数を書く
②探索済みのノードを記録する配列を用意する
③探索したノードに探索済みのフラグを立てる処理を入れる
④探索済みのノードは再度探索しないようにする
というように整理すると、見通しが良くなります。
まとめ
最後に、幅優先探索と深さ優先探索のミニマムな実装についてそれぞれまとめます。
幅優先探索
queue = []
visited = [False for _ in range(len(graph))]
while queue:
    current = queue.pop(0)
    if visited[current]:
        continue
    visited[current] = True
    for idx in graph[current]:
        if visited[idx]:
            continue
        queue.append(idx)
①キューからデータを取り出す
②探索中のノードにつながっているノードをキューに加える
③探索済みのフラグが立っているノードに対してはスキップする処理を加える
深さ優先探索
visited = [False for _ in range(len(graph))]
def dfs(idx):
    current = graph[idx]
    visited[idx] = True
    for next_idx in current:
        if visited[next_idx]:
            continue
        dfs(next_idx)

dfs(0)
①引数に探索開始位置のインデックスを受け取る再帰関数を書く
②探索済みのノードを記録する配列を用意する
③探索したノードに探索済みのフラグを立てる処理を入れる
④探索済みのノードは再度探索しないようにする
こうして肝心な処理に絞って見ると、BFS,DFSは10行程度で実装できてしまうことが理解できたかと思います。