
はじめに
画像生成AIは年々進化していますが、現在でも
- 後頭部
- 腕組み
- 人体が重なるポーズ
など、人体構造が複雑になる場面では、不自然な生成になることがあります。
私はAIに答えを考えてもらうのではなく、自分で改善案の仮説を組み立てていくことが好きです。
もちろん専門的な知識は持っていません。
ですが現在はAIと対話しながら、自分に足りない専門知識を補ってもらい、改善案や仮説を考えることができます。
これまでにもいくつか仮説を考えましたが、
・すでに研究されていた
・すでに試されていた
・効果が限定的だった
ということがほとんどでした。
次の後頭部画像生成における改善アプローチ(過去の提案一覧)で紹介します。
ですが後頭部生成の問題について長く考えているうちに、一つの仮説にたどり着きました。
これは解決策ではなく、
「実験してみる価値があるのではないか」という研究アイデアです。
後頭部画像生成における改善アプローチ(過去の提案一覧)
・3D人形による構図の強制固定
3Dデッサン人形(ポーズ素材)を後ろ向きに配置し、それをベース(i2iやControlNetなど)として利用することで、AIの空間認識を「真後ろからの構図」に誘導するアプローチ。
・AIの「顔への執着(高報酬設定)」という仮説
AIは顔を描くことを強く優先しているように見えるため、「顔を正しく描くことへの評価が相対的に高く、後頭部の評価が低いのではないか」という仮説を考えた。
・「後ろ姿」への評価基準の見直し
顔だけではなく、後ろ姿(後頭部)を自然に描けた場合にも高く評価されるような学習・評価方法が有効ではないかという仮説。
・「正面と後ろ姿」のペアデータによる学習
同一人物の正面画像と後ろ姿をペアデータとして大量に学習させることで、「表と裏」の対応関係をより強く学習できるのではないかというアプローチ。
仮説
画像生成AIは、
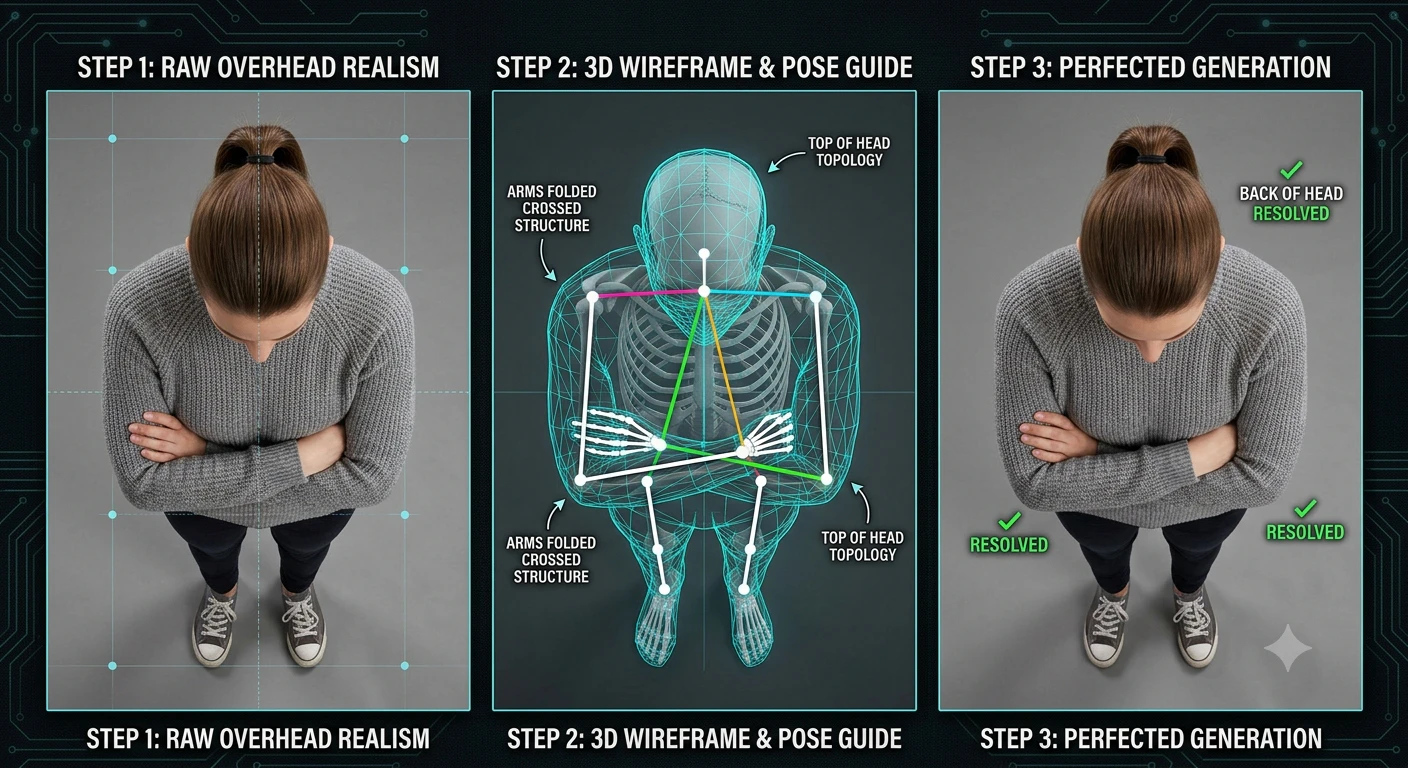
立っている人間を真上・斜め上から見た高品質データを十分に経験していない可能性がある。
そのため、
人体を2D画像としては学習していても、
3D構造の理解が不足している部分があるのではないかと考えました。
改善案
通常の実写画像だけではなく、
- 真上から見た人物
- 真上から少し角度を付けた人物
- 同じ人物の3Dワイヤーフレーム
- 骨格情報
- 3D人体モデル
を対応付けたデータを大量に学習させます。
目的は、
AIが人体を3D構造として理解しやすくなるかを検証することです。
なぜ真上なのか
普段撮影される人物写真は、
- 正面
- 横
- 少し斜め
が圧倒的に多いと思われます。
一方、
立っている人物を真上90度から撮影した画像
は日常では比較的少ないのではないかと考えています。
もしこの視点の経験が不足しているなら、
後頭部や腕組みなどの理解にも影響している可能性があります。
もちろん、これは仮説であり、実際にデータ分布を調査しないと分かりません。
ワイヤーフレームとの組み合わせ
さらに、
実写だけではなく、
同じ人物に対応する
- ワイヤーフレーム
- 骨格
- 3D人体
も同時に学習させれば、
AIは
この見た目のとき人体内部はこうなっている
という対応関係を学べるかもしれません。
検証方法
通常モデルと、
真上・斜め上・3D人体データを重点的に追加したモデルを比較し、
以下を評価します。
- 後頭部
- 腕組み
- 人体の重なり
- 複雑なポーズ
が改善するかどうか。
監視カメラAIとの共通点
監視カメラAIでは、
真上視点から人体を認識する研究が行われています。
画像生成AIでも、
そのような人体構造理解の知見を活用できる可能性があるのではないかと考えました。
おわりに
私はこの方法で改善すると断言しているわけではありません。
ただ、
「真上視点+3D人体情報を重点的に追加した場合、本当に後頭部生成が改善するのか」
という実験は、一度検証してみる価値があるのではないかと思っています。
もし既に同様の研究や実験をご存じの方や、この仮説に対する問題点・改善案があれば、ぜひ教えていただけるとうれしいです。
AIの進歩は、多くの人のアイデアや検証の積み重ねによって発展してきました。
この記事も、そのような議論のきっかけになれば幸いです。