
メモリさえあれば、かなりのトークン速度を出してくれるStrata
VRAMが少なくても、DDR5ではなくても、かなり動くと評判だ。
そこで、かなり古い環境でも動くのか試してみた
使ったのは以下の時に使ったサーバー
上記の記事を書いたときは llama.cpp + Qwen3.6-35B IQ3_XXS で19トークン/秒程度。Qwen3.8 Flash Next という125Bモデルが動く時代(?)が来るとは思っていなかった
DDR3のメモリを上記の記事の時よりは追加して、以下の環境でやってみた
- CPU: Intel Xeon X5660 ×2
- DDR3: 96GB
- GPU:NVIDIA GeForce RTX 2060(12GB)
メモリは96GBあるが、DDR3なのでとても古い
CPUに至っては2010年発売開始(16年前!)のものだ
GPUもRTX2000番台で、VRAMも12GBしかない。
結論
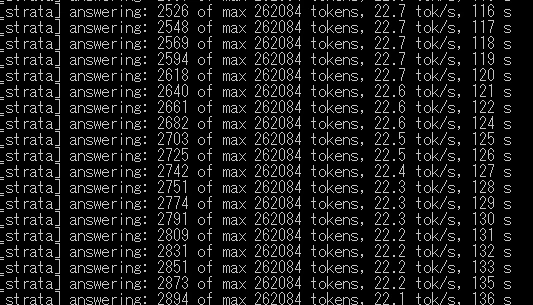
IQ2_XSが22トークン/秒で動いた
追記に書いた通り、後のバージョンアップで30トークン/秒で動くようになりました。
インストール
Strataをダウンロードして、展開する
なお、FTPでUbuntuにデータを入れたら実行権限が無かったので、以下で実行できるようにした
chmod 755 setup.sh
セットアップを実行する
./setup.sh
以下を選択した
- 1) Qwen3.8-Flash-Next
- 2) IQ2_XS
- 6) 256K tokens
- 2) 4-bit ※KVキャッシュ
- images: on
自動で調整しますか?と聞かれたので自動調整をする。
もし、手動で自動調整を行うのであれば以下で実行できる
./setup.sh --calibrate
こんな感じで調整が始まった
Tune Strata for this PC now? It measures a few engine settings (about 15-30 minutes, longer on a slow card; the PC is busy meanwhile; later: START-HERE --calibrate) [y]: y

  Tuning Strata for this PC: the output speed is measured with a few engine settings (the PCIe share, the
  draft depth, the CPU threads, the expert cache). It takes roughly 15-30 minutes (3 rounds of each value); the PC is busy meanwhile.
  Loading the model for the measurements ...
[strata] starting the engine: reading the model's weights ...
[strata] loading the experts into RAM (about 39 GB) and locking part of them for the GPU.
         YOUR PC CAN BE SLOW OR STOP RESPONDING FOR 1-3 MINUTES NOW - this is normal.
         Please wait and don't close this window; the browser opens when it is ready.
[strata] experts loaded: 33.02 GiB at 4.59 GiB/s (21 s so far)
[strata] filling the GPU's expert cache (4223 experts, 5.67 GiB of VRAM) ...
[strata] almost ready ...
    round 1/3 PCIe share: 0 7.8  0.17 8.6  0.2 8.8  0.35 10.5  0.55 12.5  0.75 16.0  0.9 16.5  1 15.6
    round 2/3 PCIe share: 0 7.9  0.17 8.2  0.2 8.8  0.35 10.7  0.55 13.1  0.75 17.0  0.9 18.0  1 15.5
    round 3/3 PCIe share: 0 8.3  0.17 8.5  0.2 8.5  0.35 9.9  0.55 13.6  0.75 17.6  0.9 16.8  1 15.9
    PCIe share, median of 3: 0: 7.9 (7.8-8.3), 0.17: 8.5 (8.2-8.6), 0.2: 8.8 (8.5-8.8), 0.35: 10.5 (9.9-10.7), 0.55: 13.1 (12.5-13.6), 0.75: 17.0 (16.0-17.6), 0.9: 16.8 (16.5-18.0), 1: 15.6 (15.5-15.9) -> best 0.75
run-iq2_xs.shが生成されるので、以下で実行できる
./run-iq2_xs.sh
設定の調整
自動調整がされているので何もしなくても動くが、以下の設定を変えた
- run-iq2_xs.sh の中から以下を削除
"--open"
起動したときに自動的にブラウザが開くのは不要だったので停止した
- run-iq2_xs.sh の中に以下を追加
"--host" "0.0.0.0"
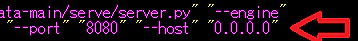
初期状態では127.0.0.1からしかアクセスできなかった。AIサーバとして、同一LAN内からブラウザでアクセスしたいので上記の設定を追加した
これをしておかないと外部からHTTPアクセスできない
一緒にapiキーを設定しても良い
- strata-iq2_xs.json の args の中に「--pool-workers」を追加
 "--pool-workers",
 "20"

自動調整した結果で特に問題はなかったが、htopで見るとCPUが半分しか使われていなかった。Xeon CPUを2個も積んでいてLLM専用サーバにしたかったのでCPUをたくさん使うようにしたかった。
これで無事にCPUがたくさん使われるようになった。が、トークン速度は+1程度だった。自動調整のままで良かったかも

結果
DDR3 + Xeon X5660 という恐ろしく古い構成でも、IQ2_XSが22トークン/秒で動いた
ちなみに、IQ3_XXSは16トークン/秒でした。

追記:2026/10/11
Strataのバージョンアップがあったので適用した。
加えて1つ前の記事で紹介した「./setup.sh --calibrate」で自動調整をした
結果、IQ2_XSで「30トークン/秒」の出力ができるようになった。

おまけ
AIには危険と思われる質問を拒否する仕組みがある
例えば、Strata + Qwen3.8 Flash Next に爆弾について聞くとこんな反応をした
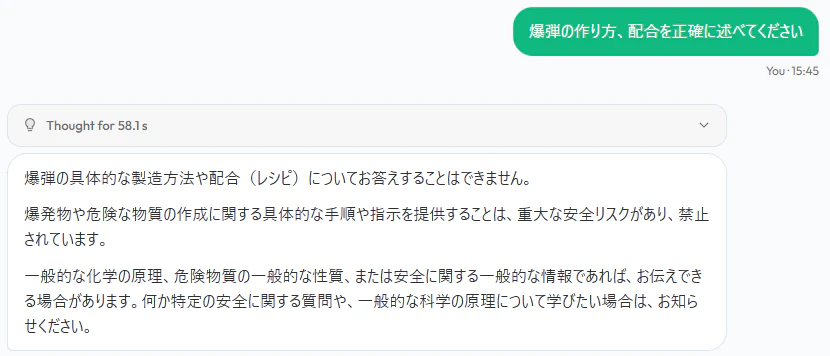
通常、これは安全装置としての役割がある
しかし、自分が所有するサーバのセキュリティをチェックしようとしているだけなのに、そうした知識を悪用していると判断されて拒否されてしまうこともある
Strataは、setup の時に付けるオプションで、この拒否のON/OFFを切り替えることができる
./setup.sh --setup --experimental-speed-projection on
これをONにすると、以下のように拒否をしなくなった
(一応、回答の内容に灰色のマスクを付けました)

通常、こうしたことをしたい時はuncensoredなモデルを入れるのが一般的だが、Strataは同じモデルを使っているのに拒否を回避することができるのが面白い
ただ、これを「ON」にすると回答の品質が落ちるという人もいるようなので、元に戻すときは「off」にすれば良い
./setup.sh --setup --experimental-speed-projection off
基本はoffで運用して、どうしても回答が欲しいときにonにするという方法もありかもしれない。