
どうもこんにちは。
ちょっと前にリリースされたLambda MicroVMsでCIラインを構築したいなぁとずっと思って1ヶ月くらいが過ぎてしまっていたのですが、やっとCIラインの構築ができたので、今回はどのように構築したかを紹介できればと思っています。
Lambda MicroVMsとは
Lambda MicroVMsとは、「 ユーザーやAIが生成したコードを安全に実行するためのステートフルな隔離サンドボックス環境 」です。
この説明だけだとよくわからないかと思いますので、もう少し噛み砕いて説明をします。
そもそもMicroVMって何?
まず、VMとは何かを説明すると、VMは「Virtual Machine」の略で、日本語だと「仮想環境」と呼びます。EC2を想像すると良いですね。EC2インスタンス1つで仮想環境を1つ用意することができます。じゃあコンテナと呼ばれるものが仮想環境じゃないのかという話なんですが、コンテナも仮想環境を用意するための手段の1つです。
つまり、EC2インスタンスという仮想環境の中に、コンテナを使って複数の仮想環境を立ち上げることができるということですね。
1つのEC2インスタンス = 1つのコンテナ = 1つの仮想環境(VM)
なんとなく仮想環境のイメージは理解できましたか?
じゃあ、MicroVMってなんだぁ?って話なんですが、VMをめちゃめちゃ軽量化したやつがMicroVMです。この、VMをめちゃめちゃ軽量化したMicroVMを活用して出来上がったサービスがLambda MicroVMsです。
これだけだとあまりイメージつかないと思うので、EC2によるVM, コンテナによるVM, MicroVMで比較してみましょうか。個人的に、マンションで例えるとわかりやすいのかなと思ったりしました。
| 項目 | 通常のVM (EC2など) | コンテナ (Docker) | microVM (Firecracker等) |
|---|---|---|---|
| 例え | マンション | マンションの各部屋 | プレハブのミニハウス |
| 起動速度 | 遅い(数分) | 爆速(1秒未満) | 爆速(5〜100ミリ秒) |
| メモリ消費 | 多い(OS丸ごと) | 極めて少ない | かなり少ない |
| セキュリティ | 最高(完全な壁) | 中(OSを共有するため穴がある) | 最高(完全な壁) |
なぜmicroVMが必要になったのか?
まず、EC2のような通常のVMだと、サイズが大きい分、起動速度が遅いという弱点がありました。これを補う技術して、コンテナが誕生しました。
しかし、コンテナには大きな弱点がありました。それは、「 ホストOSのカーネルを共有している 」という点です。例えば、1つのOSに10個のコンテナによるVMが存在しているとしましょう。この場合、ある1つのコンテナから別のコンテナに影響が出てしまうような操作ができてしまいます。これがコンテナにおける弱点です。
この問題を解消するために、MicroVMが誕生しました。
MicroVMは、不要な機能を最大限削ぎ落とした超軽量のOSを動かすことで、VMとしての隔離性を保ったまま、コンテナ並みのスピードで起動できるという強みがあります。
じゃあLambda MicroVMsってなんだ?
MicroVMのイメージは湧きましたかね?じゃあ、こういう使い方できるんじゃない?っていう自分の想像と比較しながら説明をしますね。
僕はこういうことができるんじゃないかな?と思っています。
- AIエージェントによるコードレビュー実行
- AIエージェントによる好き勝手な実験
- マルウェアなどの動作解析
- アプリケーションの自動テスト実行
他にもあるかなぁ...パッと思い浮かぶのはこのくらい。
上で上げた例って、共通の特徴があるんですよね。それが「 環境をずっと実行しておかなくて良い 」ということです。
AIエージェントにコードレビューを実行してもらう時って、EC2インスタンスみたいなずーっと動いてる環境って必要ですか?AIエージェントが24時間365日ずーっとコードレビューしてる環境ならいいんですけど、そんなケースってほぼないですよね。せいぜい5~30分くらい動いてくれれば良いわけです。
他についても同様です。24時間365日ずーっと動かしておく必要がある場合はEC2インスタンスのようなサービスを使う必要があるんですが、一時的に動かすことができる環境なのであればLambda MicroVMsでいいかぁってなるわけです。
ということで雑な説明をかましましたが、公式ドキュメントはこちらです。
また、以前、JAWS-UG茨城支部のイベントで登壇させていただいた時に若干テーマ被りしてしまったつくぼしさんのスライド資料がMicroVMについて、Lambda MicroVMsについて非常にわかりやすい説明をされていたので、こちらを参考にしていただくと良いと思います。
CI環境構築はCodeBuild使えばいいんじゃないの?
ぶっちゃけそうなんですよ。
どっちが良いかって聞かれると自信ないんですけど、以下のような観点でCodeBuildを使うか、Lambda MicroVMsを使うかを判断すれば良いのかなと思ったりしています。
| 観点 | CodeBuild | Lambda MicroVMs |
|---|---|---|
| Code Pipelineとの統合 | ○ | △ |
| CIラインをLambdaで完結したい | × | ○ |
| CIラインを最小限の構成でカスタムしたい | △ | ○ |
比較するの難しいんですが...
ただ、Code Pipeline, Code Deployと組み合わせる場合は、Code Buildを使う方が適切なのかなと思っています。
僕が今回実装したのは、CDの方を考慮せずに、PRを作成した時, pushした時に自動テストが実行されて、必要な情報がPRに添付されて、Slackで通知されるというありきたりな構成を最小限の構成で構築したいなと思ったので、Lambda MicroVMsを使いました。
構築したCI環境
AWSの構成図はこんな感じです。
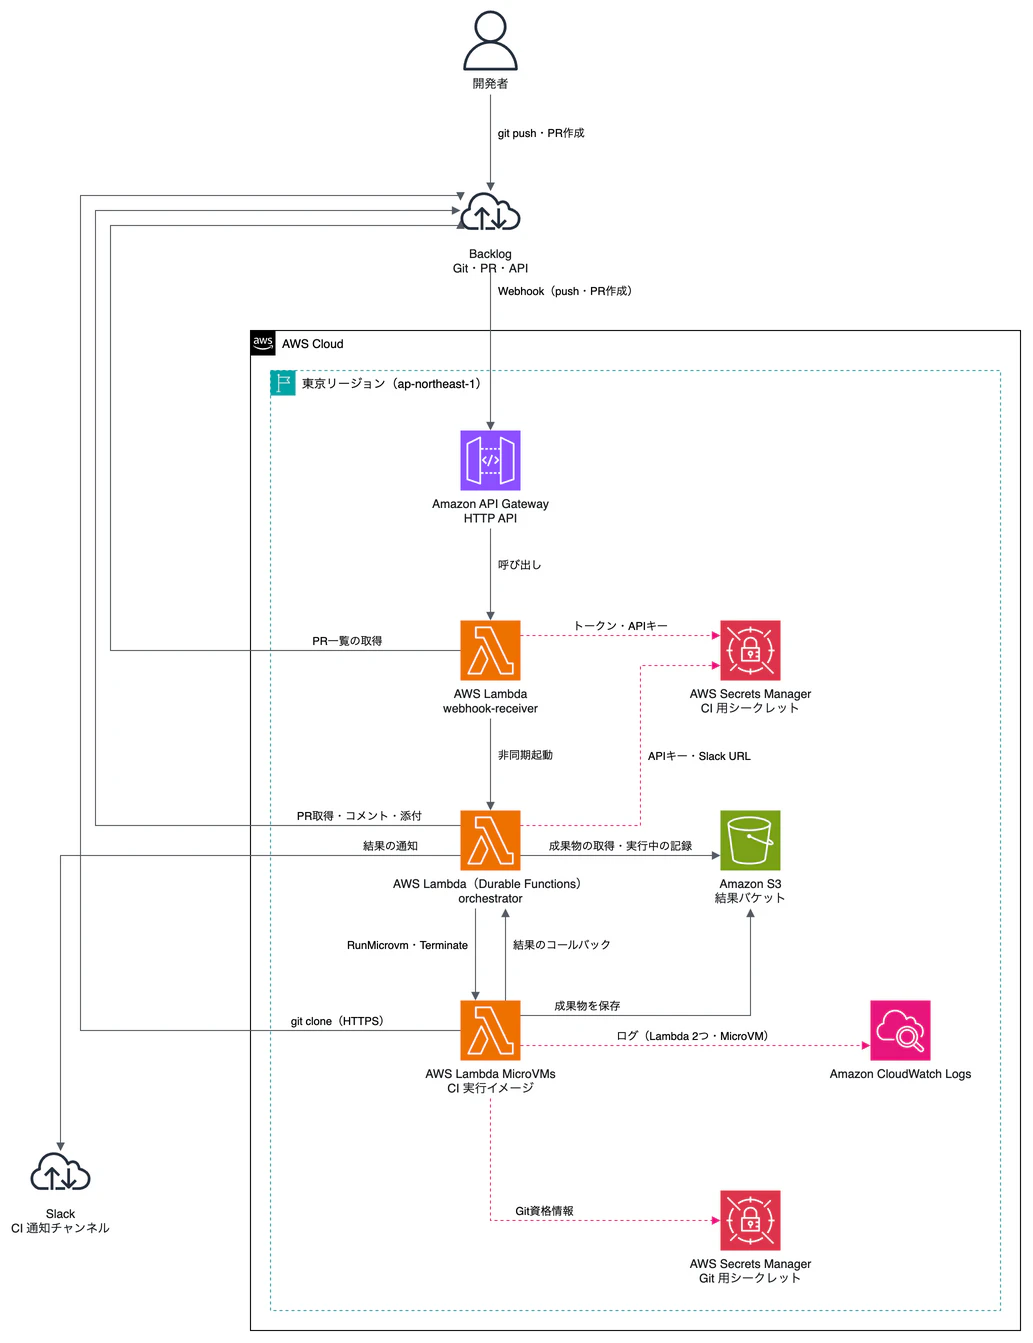
CIとして実行しているのは、以下のようなRailsアプリケーションの自動テストです。
- Rubocop
- Brakeman
- RSpec
この構成自体は、AWS CDKを使って構築しています。
また、Railsアプリケーションのリポジトリに含めるのではなく、別リポジトリとして管理しました。(今回は関係ない情報)
処理の順番
処理の順番はこんな感じ。
1. 開発者がPRを作成する、もしくはpushする
この操作は人間が行います。
2. Backlog WebhookがAPI Gatewayにリクエストを送る
PR作成、pushをトリガーにWebhookが起動して、API Gatewayへリクエストを送信します。
(この時、Webhook側にトークンを持たせています)
3. API Gatewayが、Lambdaを呼び出す
これはよくある構成ですね。Lambda起動のトリガーをAPI Gatewayにしているだけです。
4. Lambdaが受け取ったトークンとSecrets Managerの値を照合する
ここで、受け取ったリクエストが「自分たちが登録したWebhookから来たものか」を確かめます。BacklogのWebhookには署名の仕組みがないので、代わりにランダム値のトークンをWebhookのURLに持たせています。(Basic認証とかにしたほうが良いです。。)
トークンが一致しなかった場合は、身に覚えのないリクエストと判断して、ここで処理を止めます。
トークンが一致したら、次に「どのリポジトリのイベントか」を確かめます。Webhookはプロジェクト単位で登録しているので、同じプロジェクトの別リポジトリへのpushも届くためです。対象外のリポジトリのイベントや、pushとPR作成以外のイベント(PRへのコメントなど)、ブランチの削除、タグのpushは、ここで捨てます。
5. pushされたブランチに、オープンなPRがあるかを調べる
pushの場合は、Backlog APIでそのブランチのオープンなPRを探します。PRがまだ無いブランチへのpushなら、CIは動かさずにここで終わります。
PR作成の場合は、WebhookにPR番号が入っているので、この手順は飛ばします。
ただし、develop、masterなどへのpushは、PRの有無にかかわらず、そのコミットで基準(既知の失敗・警告)を取り直すCIも起動します。こちらはPRにコメントせず、結果を基準としてS3に保存して、基準が変わったときだけSlackに通知します。
6. CIの司令塔を起動する
Lambdaが、Durable Functionsで作ったオーケストレーターを非同期で起動します。Webhookにはすぐに応答を返して、ここから先の長い処理はオーケストレーターに任せます。
起動するとき実行名をつけて判別できるようにしているのですが、これはpushのときは「PR番号+コミットID」、PR作成のときは「PR番号+open」にしています。
これによって、同じWebhookが2回届いても同じ名前の実行は1回しか動かないので、二重起動を防げます。
ここでDurable Functionsを使っているのは、CI実行中に何か処理を実行しておく必要がなく、CIが完了するまでステートを保持させたまま待機状態にさせておいて、CIが完了したら処理を再開させたいためです。
7. PRの状態を確かめて、開始コメントを付ける
オーケストレーターがBacklog APIでPRを取り直して、オープンでなければ、その旨をPRにコメントして終わります。オープンなら、PRに「CIを開始しました」とコメントします。イメージとしては以下のような感じです。
CIを開始しました。

契機: プルリクエストの作成を受けて実行
対象: feature-SAMPLE-345 → develop
実行ID: pr1234-open
完了したら、このプルリクエストに結果をコメントします。
8. 同じPRで動いている古いCIを止める
連続でpushすると、同じPRでCIがいくつも走ってしまいます。そこで、S3に「今そのPRで動いているCI」を記録しておき、新しいCIが始まったら古いCIに中止を伝えます。
中止を受けた古いCIは、PRに中止のコメントを付けて、自分で後片付けをします。遅れて動き出した古いCIが新しいCIを止めてしまわないよう、Webhookを受け取った時刻も比べています。
9. MicroVMを起動して、ジョブを渡す
オーケストレーターが、PRのベースブランチの基準(既知の失敗・警告)をS3から読み込みます。基準がまだ無いブランチなら、設定ファイルに書いた固定のリストを使います。
基準というのは、ベースブランチに対してマージが実行された場合に実行されるCIの結果のことを指しています。
マージされた場合にCIを実行することでPRを作成した時やpushした時に実行されるCIの実行結果にベースブランチで発生しているエラーが入らない状態することができます。(本来あまりやるべきではないかもしれないですが、対象のブランチでの修正によって自動テストが正常に終わっているかの差分を明確にしたかったためにこのような形を取りました。)
そのあと、Lambda MicroVMsを起動して、ブランチ、コミット、結果の返し先(Durable FunctionsのコールバックID)、既知の失敗と警告のリストなどを渡します。
渡したら、オーケストレーターは結果が返ってくるまで待ちます。Durable Functionsの待機中はLambdaが動いていないので、何十分待っても実行時間の料金はかかりません。
10. MicroVMがスナップショットから立ち上がる
MicroVMのイメージには、Ruby、MySQL、gemのインストールを済ませ、MySQLを起動してテスト用のDBを作った状態を、スナップショットとして保存しています。起動するとその状態から始まるので、毎回の環境構築はほとんど要りません。
11. ソースを取得して、テストの準備をする
Secrets ManagerからGitの資格情報を取り出して、Backlog Gitからcloneし、pushされたコミット(PR作成のときはブランチの先頭)をcheckoutします。RuboCopの対象を決めるために、ベースブランチも取得します。
そのあと、bundle installを実行して、DBの準備をします。
12. RuboCop、Brakeman、RSpecを実行する
RuboCopはPRで変更したファイルだけ、BrakemanとRSpecはアプリ全体を対象に、順番に実行します。
RuboCopは、違反が1件でもあれば「失敗」と判定します。RSpecとBrakemanの結果は、手順9で読み込んだ基準(ベースブランチで既に出ている失敗や警告)と比べます。新しく出た失敗や警告があるときだけ「失敗」と判定するので、既存の問題で毎回赤くなることはありません。
今回はRuboCop, Brakeman, RSPecを実行しましたが、Pytestなどの別言語の自動テストやPlaywrightのE2Eテストの実行も可能です。
13. 成果物を保存して、結果を返す
多くの自動テストツールでは、結果をHTML形式で出力することができます。
$ bundle exec rspec --format html --out "sample_exec.html"
このように生成されたHTMLのレポートとカバレッジをS3に置いて、判定結果をコールバックでオーケストレーターに返します。
実行中は数分おきに生存確認のための通知も送っていて、MicroVMが途中で止まってもオーケストレーターが気づけるようにしています。
14. PRに結果をコメントして、Slackに通知する
オーケストレーターがS3からレポートを取り出してBacklogに添付し、PRに結果をコメントします。あわせて、Slackにも結果を通知します。
Backlogへのコメントは以下のようなイメージです。
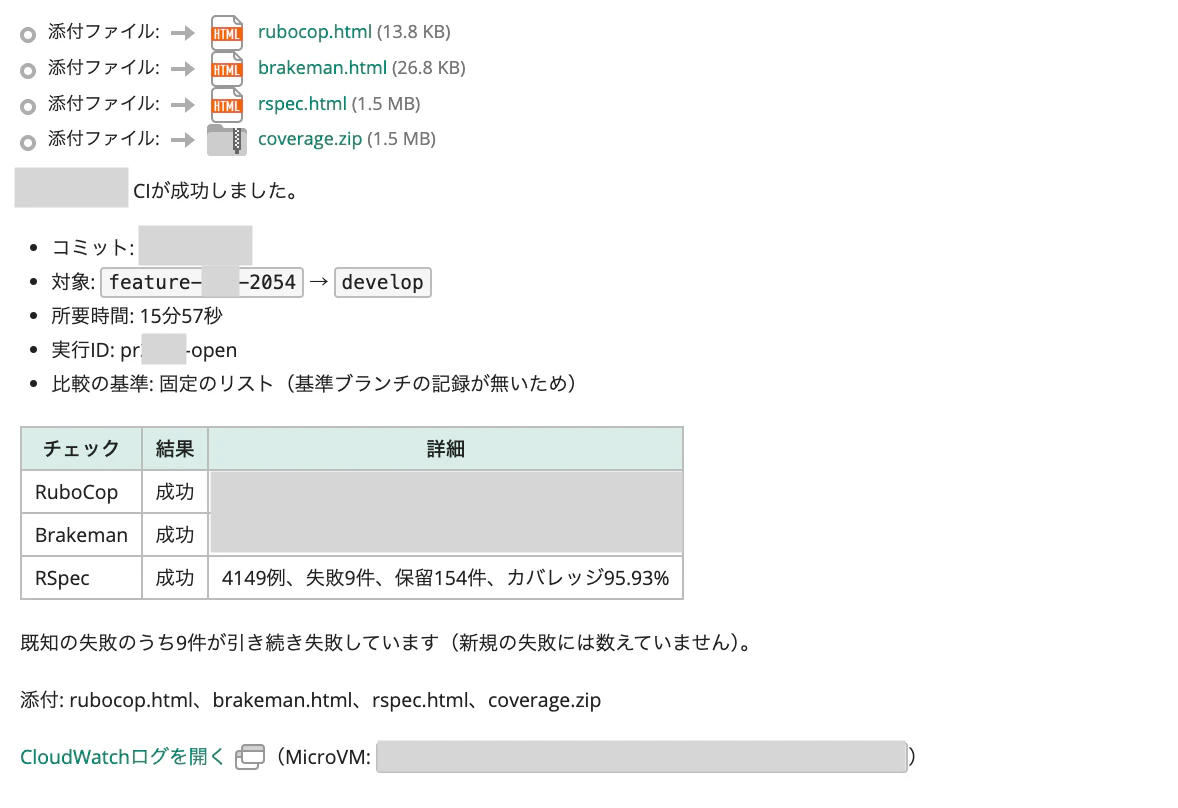
結果の部分は公開できるものだけにしてます。
Slackには簡易的なメッセージを流して、PRのリンクを貼ってます。
15. MicroVMを終了する
最後に、オーケストレーターがMicroVMを終了します。成功でも失敗でも、必ずこの後片付けをします。
80分以内に結果が返ってこない場合や、生存通知が15分途絶えた場合は、タイムアウトとしてPRへのコメントとSlackへの通知をしてから、MicroVMを終了します。
CI環境をLambda MicroVMsで構築してどうだった?
自分としては、「拡張しやすいなぁ」という印象です。
ざっくりではありますが、CodeBuildで構築した場合と比較してみました。
Lambda MicroVMsの場合は「環境ができあがった状態から始められる」「流れを細かく制御できる」という点で優位かなぁとは感じました。
| 観点 | Lambda MicroVMs | CodeBuild |
|---|---|---|
| 環境の用意 | スナップショットから起動できる。Ruby、MySQL、gemを入れ、MySQLを起動してテスト用DBを作った状態まで含む | 毎回コンテナから起動する。カスタムイメージに事前に入れておくことはできるが、イメージのpullとMySQLの起動は毎回かかる |
| MySQLの動かし方 | VMの中で普通のプロセスとして動かせる | buildspecで用意する(他の方法もある) |
| 起動から後片付けまでの仕組み | すべて自前で実装 | 起動、中止、状態変化のイベントが標準である |
| Webhookの受け口 | Webhookを受け取るLambdaが必要 | GitHub, CodeCommitであれば連携することが可能 |
| 結果の見え方 | CloudWatch Logsと、自前で書くPRコメント | ビルドの履歴、フェーズごとの時間、ログ、テストレポートを画面で見られる |
| 課金の単位 | 秒単位 | EC2モードは分単位で切り上げ |
| 成熟度 | 新しいサービス | 長く使われていて、情報も事例も多い |
| イメージの更新 | Gemfileが変わったらイメージを作り直す(昨日のデプロイで約6分) | カスタムイメージを使うなら、同じく作り直しが要る |
向き不向きでまとめるとこんなんでしょうか。
- CodeBuildが向いている場合: 仕組みを小さく保って誰でも保守できるようにしたい。状況を画面で追いたい。
- MicroVMsが向いている場合: 起動を速くしたい。VMの中でDBなどを自由に動かしたい、長い待ち時間を安く待ちたい。
あとは前述した通り、「Code Pipelineとの統合」のしやすさも考慮する必要があるのかなと思っています。
今後
CIが通ったら同じ構成でレビュアーのためのレビュー環境をLambda MicroVMsで用意して、レビュアーがgit pullしなくても開発中ブランチの環境を触れるような環境を用意できればと思っています。
コーディングエージェント使っている場合はローカルの方が都合良さそうだけど、クラウド上でエージェントを動かす風潮が来そうなので、このように動かすのは需要出てきそうです。よね?
まとめ
アプリケーションエンジニアとしては、CI環境の構築をアプリ実装と同じような感覚でできたので、面白さを感じました!
あと、同じ構成で、Lambda MicroVMs内でClaude Code CLIやCodex CLIを立ち上げてAIレビューを回す環境を用意するのもありですね。(Serverless Daysのワークショップで体験済みなので、気が向いたら自環境でもやろう。)
以上!