
どうもこんにちは。
先日ですね、ServerlessDays Tokyo 2026というイベントに参加させていただきまして、Day2のワークショップに参加させていただきました。
このワークショップで、AWS LambdaのDurable FunctionsとLambda microVMsのワークショップを体験して、より一層理解を深めたいモチベーションになったので、記事を書いています。
この記事で書くこと
- AWS LambdaのDurable Functionsを使うときの中心的なクラスである、DurableContextについて
Lambda Durable Functionsって?
自分はLambda Durable Functionsを「処理の進捗を保存し、待機,中断後も続きから再開できるワークフローをLambdaで実現する機能」と表すことができるかなと思っています。
特徴は以下です。
| 特徴 | 説明 |
|---|---|
| 実装方法 | 通常のLambda関数に近い書き方で実装可能(SDKのimport、デコレータ、Durable Executionの設定が必要) |
| チェックポイント |
step()やwait()などのDurable操作の開始、再試行、成功、失敗などの状態をチェックポイントとして保存 |
| 最長1年の待機 | 待機時間を含めたDurable Execution全体を最大1年間継続できる |
Durable Execution SDK
Lambda Durable Functionsを実装するためには以下のSDKを使います。
作成方法
AWS Lambda関数の作成と同じです。ただし、作成画面にて「永続実行」のオプションを有効にする必要があります。
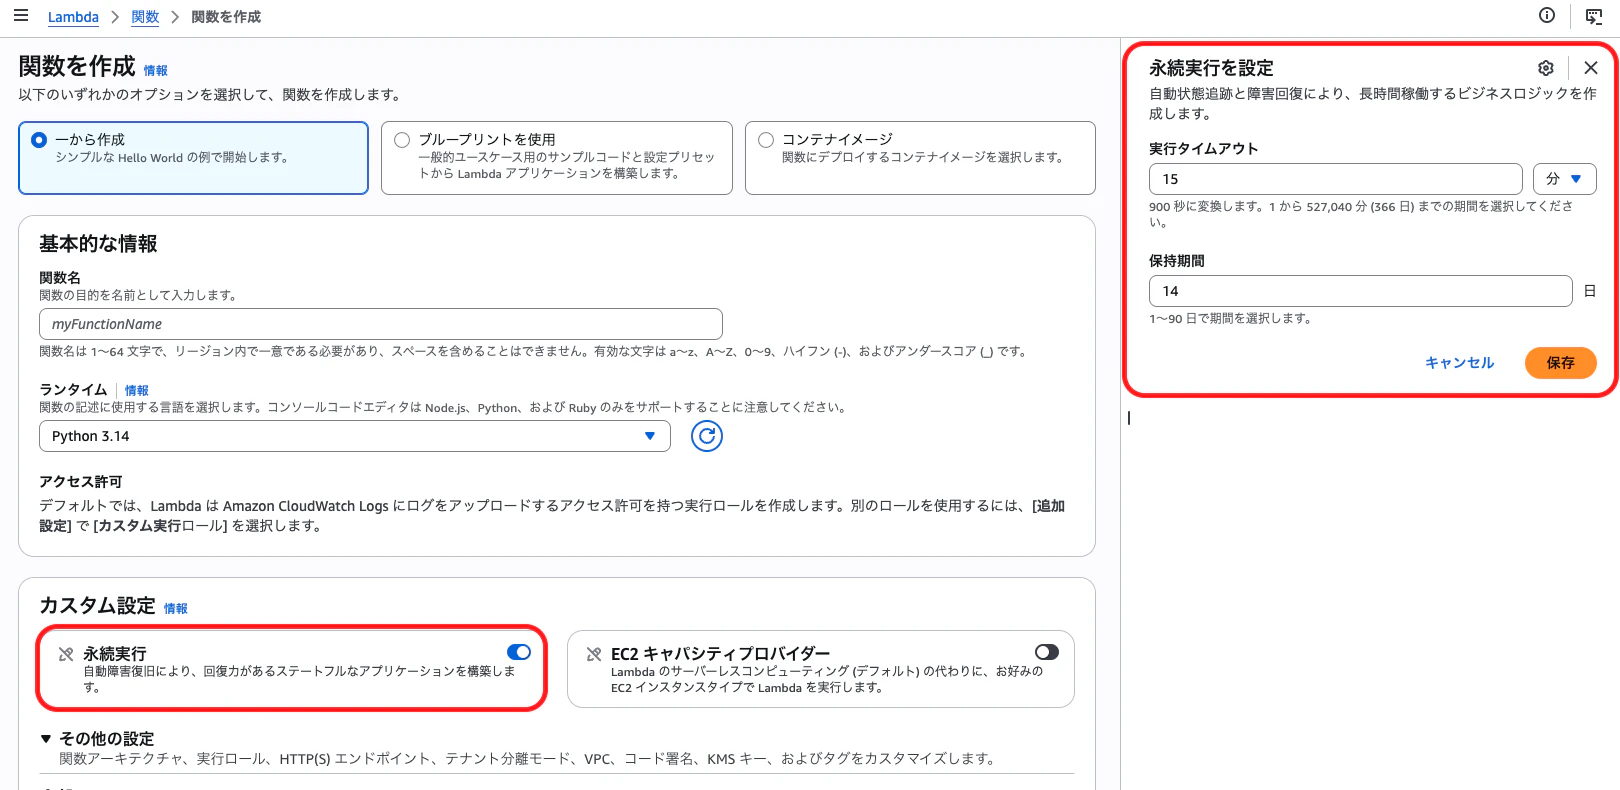
CloudFormationやCDKなどでデプロイをする場合、以下のようなオプションを記述する必要があります。
DurableConfig:                   # Durable Executionを有効にする
    ExecutionTimeout: 900        # Durable Execution全体の実行可能時間
    RetentionPeriodInDays: 7     # 処理完了後に、Durable Executionの実行履歴を保持する期間
Lambda関数側では、このDurable Executionの設定に加えて、実行ロールへの権限設定が必要です。
注意点として、ExecutionTimeoutというパラメータは通常Lambdaの15分制限とは異なるパラメータです。
Durable Executionの設定を有効にしたとしても、通常のLambda実行環境における連続した処理の最大実行時間は15分です。ExecutionTimeoutで設定する値は、Lambdaが動作している時間以外の時間(待機時間など)も含まれていることに注意してください。
また、実行ロールにAWSLambdaBasicDurableExecutionRolePolicyを追加しておく必要があります。
少なくとも、lambda:CheckpointDurableExecutionとlambda:GetDurableExecutionStateが必要になります。
Durable Functionを呼び出す時は、バージョンまたはエイリアスで修飾した関数名またはARNを使用します。そのため、IaCでデプロイする場合は、Durable Executionの設定と実行ロールだけでなく、バージョンの発行やエイリアスの作成も合わせて考える必要があります。
有効にする設定は簡単だけど、概念が難しい...
既存のLambda関数をDurable Functionsを使えるように変更することはできません。Durable Functionsを使うためにはLambda関数を作成する時に設定しておく必要があります。
サンプルコードをもとに解説
AWSマネジメントコンソール上でLambda関数(Python)を作成する時、永続実行を有効にすると、以下のようなサンプルコードが用意されています。(コメントは自分が説明するために記載したものです。)
## ① Durable Execution SDK
## ② Durationクラス
from aws_durable_execution_sdk_python.config import Duration
## ③ StepContextクラス
## ④ DurableContextクラス
from aws_durable_execution_sdk_python.context import DurableContext, StepContext, durable_step
from aws_durable_execution_sdk_python.execution import durable_execution

## ⑤ @durable_stepデコレータ
@durable_step
def my_step(step_context: StepContext, my_arg: int) -> str:
    step_context.logger.info("Hello from my_step")
    return f"from my_step: {my_arg}"

## ⑥ @durable_executionデコレータ
@durable_execution
def lambda_handler(event, context) -> dict:
    msg: str = context.step(my_step(123))

    context.wait(Duration.from_seconds(10))

    context.logger.info("Waited for 10 seconds without consuming CPU.")

    return {
        "statusCode": 200,
        "body": msg,
    }
いつも用意されてるシンプルなLambdaのサンプルコードよりも行が多かったり見慣れない記述がありますねぇ...
1つ1つ読み解いていきましょ!
① Durable Execution SDK
コード最上部でaws_durable_execution_sdk_pythonというパッケージ名が記述されていますね。これがDurable Executionを使うためのパッケージです。
ソースコードは以下にありますので、お時間ある時に読んでみるのが良いかと思います。
この記事に掲載しているSDKのソースコードは、上記コミット時点の実装を参照しています。SDKのmainブランチでは内部実装が変更される可能性がありますが、DurableContextの利用方法についてはAWS公式のSDKリファレンスも合わせて確認しています。
個人的に可読性がかなり高くて読みやすいなぁと思いました。(Pythonライブラリって結構ギュッ!ってなっていて読みづらかったりするんですよね。)
② Durationクラス
このDurationクラスが、一番仕組みがわかりやすいかなと思っています。(LoggerInterfaceクラスもわかりやすいか...)
このクラスはその名の通り、秒, 分, 時間, 日といった時間の長さを表現するためのクラスです。wait()の待機時間だけでなく、コールバックのタイムアウトやリトライ間隔などでも使われます。
## 単体で使うと↓
Duration.from_seconds(10)

## 待機させたいときは↓
context.wait(Duration.from_seconds(10))
ソースでは以下のように定義されています。
@dataclass(frozen=True)
class Duration:
    """Represents a duration stored as total seconds."""

    seconds: int = 0

    def __post_init__(self) -> None:
        if self.seconds < 0:
            msg = "Duration seconds must be positive"
            raise ValidationError(msg)

    def to_seconds(self) -> int:
        """Convert the duration to total seconds."""
        return self.seconds

    @classmethod
    def from_seconds(cls, value: float) -> Duration:
        """Create a Duration from total seconds."""
        return cls(seconds=int(value))

    @classmethod
    def from_minutes(cls, value: float) -> Duration:
        """Create a Duration from minutes."""
        return cls(seconds=int(value * 60))

    @classmethod
    def from_hours(cls, value: float) -> Duration:
        """Create a Duration from hours."""
        return cls(seconds=int(value * 3600))

    @classmethod
    def from_days(cls, value: float) -> Duration:
        """Create a Duration from days."""
        return cls(seconds=int(value * 86400))
秒, 分, 時間, 日までならユーザが任意のクラス関数を使って間隔を定義することができるようになっていますね。
ただ、returnの戻り値を見ると、引数から渡された値が全て秒単位に換算されていますね。
③ StepContextクラス
サンプルコードでいうmy_step()関数の引数として、step_context: StepContextというのが指定されていますね。ここで指定されているStepContextというのがまた1つ理解しておくと良いのかなと思っています。
StepContextというのは、「今実行しているステップ」に関する情報をステップ関数へ渡すオブジェクトです。難しく書いたんですが、このオブジェクトが持つ情報はちょろいものです。
| パラメータ | 説明 |
|---|---|
| attempt | ステップの試行回数 |
| logger | ステップの情報が付いたロガー |
パラメータ自体は少ないですが、特にloggerには、実行を識別するexecutionArnに加えて、状況に応じてoperationName, operationId, attemptなどの情報が付与されます。また、リプレイ中の重複ログを抑制する仕組みも持っています。
print()ログを出すよりも、このロガーを活用した方が得られる情報が多いかと思います。(ロガーについては後半で書きます。)
注意点として、Durable Functionにおける、ステップの実行開始やチェックポイントの保存はStepContextの担当ではありません。これらの処理は次の章で説明するDurableContextクラスの担当です。
④ DurableContextクラス
このクラスが本日の本題なんですが、このDurableContextクラスこそが、「Durable Functionの処理の進行を管理するオブジェクト」です。
DurableContextが読み込まれる流れ
Lambda関数が起動してから、ユーザからのイベントの処理が開始されるまでにDurableContextでは初期化処理が行われます。この初期化処理で、Durable Functionを理解するための重要な処理をしていると思ったので、説明をしておこうと思います。
- Lambda実行環境の起動
- Pythonモジュールをimport
- DurableContextクラスを定義
-
@durable_executionデコレータを評価 - Lambdaへのイベント到着
- デコレータが作った
wrapper()を実行 - ExecutionStateを生成してチェックポイントを読み込む
-
DurableContext.from_lambda_context()を呼ぶ - DurableContextオブジェクトを生成
-
DurableContext.__init__()が実行される - ユーザーが書いた
handler(event, durable_context)を実行
上記の流れで大事だなぁと思うのが、6,8,10です。
それぞれの関数で何がどう処理されているのかを理解することが、Durable Functionsの理解を進められる大きなステップになるかなと思います。
@durable_executionデコレータのwrapper()関数について
上記の流れの6番目でwrapper()関数が実行されるんですがね、以下のようなイメージで処理がされます。
Lambda発火!!
    │
    │ イベント
    ▼
wrapper(event, lambda_context)
    │
    ├─ Durable実行情報を解析
    ├─ 過去のチェックポイントを取得
    ├─ ExecutionStateを構築
    ├─ 元の入力イベントを復元
    ├─ DurableContextを生成
    ├─ チェックポイント処理スレッドを開始
    │
    ▼
ユーザー関数(input_event, durable_context)
    │
    ├─ context.step()
    ├─ context.wait()
    ├─ context.invoke()
    │
    ▼
wrapperが結果・中断・例外をLambda向け形式へ変換
ExecutionStateについて整理しておく必要がありそう
/src/aws_durable_execution_sdk_python/state.pyにExecutionStateクラスが用意されています。このクラスは、実行状態の取得、設定、および維持をしたり、チェックポイントの作成や保持などを行うクラスです。
このクラスのオブジェクトがさまざまな処理の前に生成されることによって、実行状態やチェックポイントを維持したり復元することができているようです。
wrapper()関数に以下のような記述があり、そこでExecutionStateという実行状態などが格納されたオブジェクトが生成されます。
        execution_state: ExecutionState = ExecutionState(
            durable_execution_arn=invocation_input.durable_execution_arn,
            initial_checkpoint_token=invocation_input.checkpoint_token,
            operations={},
            service_client=service_client,
            plugin_executor=plugin_executor,
            updated_operation_ids=invocation_input.updated_operation_ids,
        )
また、過去の処理履歴を取得する場合には、このオブジェクトに保持されているチェックポイント情報を頼りに履歴の取得が行われます。チェックポイント情報から、過去の履歴が見つかれば「リプレイ処理」、見つからなければ「初回処理」と判断がされます。
Lambda関数内で定義されるLambdaContextとの関係について
次は上記の流れの8番目について説明します。簡単に説明すると、DurableContextクラスのクラスメソッドであるfrom_lambda_contextを使って、Lambda関数自体のコンテキスト情報を含んだDurable Functions用のコンテキストを生成しています。
以下でちょっと詳しく説明しますね。
通常のLambdaの場合も、Durable Functionsの場合も、以下のようにlambda_handler関数の引数としてcontextが指定できます。
このcontextには、「関数が実行されるときのランタイムや環境、呼び出しに関する情報」が含まれています。(俗に言うLambda関数自体のコンテキスト情報)
def lambda_handler(event, context) -> dict:
# ...中略...
ここでこの後説明する@durable_executionデコレータがありがたい働きをするのですが、contextの情報を使って、DurableContextというDurable Function用のコンテキスト情報を生成してくれるんです。(以下のサンプルコードの戻り値参照)
@staticmethod
def from_lambda_context(
    state: ExecutionState,
    lambda_context: LambdaContext,
    replay_status: ReplayStatus = ReplayStatus.NEW,
):
    return DurableContext(
        state=state,
        execution_context=ExecutionContext(
            durable_execution_arn=state.durable_execution_arn
        ),
        lambda_context=lambda_context,
        parent_id=None,
        replay_status=replay_status,
    )
DurableContextというのは、@durable_executionデコレータ内で定義されているwrapper関数内で生成されています。僕たちがDurable Functionsを使う時に意識する必要はありません。
すごいオブジェクト指向的な説明になるんですが、このDurableContextのインスタンスがLambda関数内で使われるcontextとして動作するように実装がされているようです。
# デコレータをつけることによって
@durable_execution
# こんな感じで動作するようになる!
def handler(event, context: DurableContext):
    return context.step(my_step(123))
DurableContextの内部には、元のLambdaContextがlambda_contextとして保存されています。ただし、DurableContextが元のcontextの属性をそのまま代理公開するわけではないため、取り出し方が変わる点に注意が必要です。
# 従来の場合
context.aws_request_id

# DurableContextから取り出す場合
context.lambda_context.aws_request_id
DurableContext.__init__でオブジェクト化
上記の流れの10番目で__init__関数が実行されることで、オブジェクト化される時に必要な情報がオブジェクトに格納されます。
以下のコードはDurableContext.__init__のコードです。何の情報がDurableContextオブジェクトに格納されているかは、self.xxxxxx = XXXXXXXXと書かれている部分を読みましょう。属性名で何となく「これが保持されてるんだろうなぁ」というのはわかりそうです。
class DurableContext(DurableContextProtocol):
    def __init__(
        self,
        state: ExecutionState,
        execution_context: ExecutionContext,
        lambda_context: LambdaContext | None = None,
        parent_id: str | None = None,
        logger: Logger | None = None,
        step_id_prefix: str | None = None,
        replay_status: ReplayStatus = ReplayStatus.NEW,
    ) -> None:
        self.state: ExecutionState = state
        self.execution_context: ExecutionContext = execution_context
        self.lambda_context = lambda_context
        # operations inside this context use this id as their parent
        self._parent_id: str | None = parent_id
        # child operations use this to generate deterministic step ids.
        # differs from `parent_id` only for virtual contexts.
        self._step_id_prefix: str | None = (
            step_id_prefix if step_id_prefix is not None else parent_id
        )
        self._operation_id_namespace: OperationIdNamespace = OperationIdNamespace(
            self._step_id_prefix
        )
        # cached at construction to make invariant even if parent/prefix mutates.
        self._is_virtual: bool = self._parent_id != self._step_id_prefix
        self._step_counter: OrderedCounter = OrderedCounter()

        # Replay status is tracked per-context.
        # A context starts in the status inherited from its creator and refines
        # itself to NEW via look-ahead as it reaches its own replay boundary.
        # Concurrent branches each get their own child context, so the lock
        # guards refinement when branches share a context reference.
        self._replay_status: ReplayStatus = replay_status
        self._replay_status_lock: Lock = Lock()

        log_info = LogInfo(
            execution_state=state,
            parent_id=parent_id,
        )
        self._log_info = log_info
        # The logger consults THIS context's replay status for de-duplication.
        # A child inherits the parent's underlying logger/extra but must report
        # its own status, so rebind the replay source onto self.
        if logger is not None:
            self.logger: Logger = logger.with_is_replaying(self.is_replaying)
        else:
            self.logger = Logger.from_log_info(
                logger=logging.getLogger(),
                info=log_info,
                is_replaying=self.is_replaying,
            )
レシーバーにselfが指定されている場合は、「自分自身のオブジェクトに格納している」という意味になります。あらゆるモジュールの__init__関数でよく使われていますね。
DurableContextができること
@durable_executionデコレータが生成したDurableContextオブジェクトをLambdaハンドラーのcontextとして受け取ると、以下のような関数を実行できるようになります。
| 機能 | 用途 |
|---|---|
step() |
処理を実行し、結果を保存する |
wait() |
指定時間だけ実行を一時停止する |
wait_for_condition() |
条件が満たされるまで、間隔を空けて確認する |
wait_for_callback() |
外部からの応答を待つ |
invoke() |
別のLambda関数を呼び出す |
parallel() / map()
|
独立した処理を並列に進める |
run_in_child_context() |
複数のDurable操作を子の処理としてまとめる |
logger |
再実行を考慮したログを出す |
こやつらのレシーバーには、contextを指定します。つまり、以下のような記述になります。
context.step()
context.wait()
context.invoke()
ここでのcontextはDurableContextオブジェクトです。DurableContextクラスがインスタンス関数として、上記の機能を定義しているので、context.step()というような処理が実行できるようになっています。
⑤ @durable_stepデコレータ
このデコレータの役割は、「普通の関数をcontext.step()に渡せる名前付きの処理に変換する」というものです。
ソースには以下のように記載がされているんですが、わからなくても良いです。ただ、これをつけないと、上記で使われているmy_step()という関数をcontext.step(my_step(123))というような形で呼び出すことができないです。
def durable_step(
    func: Callable[Concatenate[StepContext, Params], T],
) -> Callable[Params, Callable[[StepContext], T]]:
    """Wrap your callable into a named function that a Durable step can run."""

    def wrapper(*args, **kwargs):
        def function_with_arguments(context: StepContext):
            return func(context, *args, **kwargs)

        function_with_arguments._original_name = func.__name__  # noqa: SLF001
        return function_with_arguments

    return wrapper
⑥ @durable_executionデコレータ
まぁわりと重要な説明を④でしてしまったのですが...ざっくりと説明すると「元のLambdaハンドラーを、Durable実行用のハンドラーで包むデコレータ」ですね。
さっきも示しましたが、このイメージサンプルが全てです。
# デコレータをつけることによって
@durable_execution
# こんな感じで動作するようになる!
def handler(event, context: DurableContext):
    return context.step(my_step(123))

---

# デコレータをつけないと`context`はLambdaContext
def handler(event, context: LambdaContext):
    return context.step(my_step(123))     # このコードはエラーになる
一旦休憩しましょう
ここまでで、DurableContext周りを中心に、モジュールの動きを解説しました。
ここからは、DurableContextで定義されている機能たちについてまとめていきます。
DurableContextで定義されている機能たち
step()
このstep()関数は、渡された処理を「結果をチェックポイントへ保存できるDurableな1ステップ」として実行する関数です。この関数は引数を以下のように取ります。
| 引数 | 意味 |
|---|---|
func |
実際にステップとして動かす関数 |
name |
実行履歴などで使うステップ名 |
config |
リトライ、実行セマンティクス、シリアライズ方法の設定 |
戻り値 T
|
ステップ関数の結果。初回実行時もリプレイ時も同じ形式になる |
第一引数である、funcには、StepContextを受け取るcallableを指定します。@durable_stepデコレータをつけた関数だけでなく、通常の関数やlambdaも指定できます。@durable_stepは、追加の引数を束縛したmy_step(123)という形で渡したい時や、元の関数名をステップ名の候補として保持したい時に使います。
以下がstep()関数のソースコードです。1つずつ解説していきます。
    def step(
        self,
        func: Callable[[StepContext], T],
        name: str | None = None,
        config: StepConfig | None = None,
    ) -> T:
        step_name = self._resolve_step_name(name, func)
        logger.debug("Step name: %s", step_name)
        if not config:
            config = StepConfig()
        with self._operation_replay_aware(
            OperationSubType.STEP, step_name
        ) as operation_identifier:
            executor: StepOperationExecutor[T] = StepOperationExecutor(
                func=func,
                config=config,
                state=self.state,
                operation_identifier=operation_identifier,
                context_logger=self.logger,
            )
            return executor.process()
1. ステップ名を決める
以下のコードで、このステップの名称を決めます。第2引数のnameが指定されていれば、その値が使われます。指定されていない場合は、@durable_stepがcallableに保持した_original_nameが使われます。通常の関数やlambdaでは名前が自動設定されない場合があるため、実行履歴を追いやすくしたい場合はnameを明示的に指定するのが良いです。(今説明した処理が_resolve_step_name関数で定義されています。)
step_name = self._resolve_step_name(name, func)
2. StepConfigを作る
次にステップを実行する際の設定を用意します。これは第3引数に指定します。指定する場合には以下の項目を指定する必要があります。
| 設定 | 意味 |
|---|---|
retry_strategy |
失敗時に再試行するか、何秒後に再試行するか |
step_semantics |
各リトライ試行で重複実行をどう扱うか |
serdes |
戻り値のシリアライズ・デシリアライズ方法 |
指定されていなければデフォルト設定が適用されます。
if not config:
    config = StepConfig()
デフォルトの設定は以下のように適用されます。
@dataclass(frozen=True)
class StepConfig:
    retry_strategy: Callable[[Exception, int], RetryDecision] | None = None
    step_semantics: StepSemantics = StepSemantics.AT_LEAST_ONCE_PER_RETRY
    serdes: SerDes | None = None
ここでのStepSemantics.AT_LEAST_ONCE_PER_RETRYは、「あるリトライ試行でステップ関数が少なくとも1回実行される」設定となっています。
3. ステップ用の操作IDを作る
次にステップをDurable Executionの操作として識別するための情報を作成します。
with self._operation_replay_aware(
    OperationSubType.STEP, step_name
) as operation_identifier:
例えば、Lambda関数内で以下のように実行がされたとします。
context.step(lambda _: step_a(), name="step-a")  # 1番目
context.step(lambda _: step_b(), name="step-b")  # 2番目
context.step(lambda _: step_c(), name="step-c")  # 3番目
この時、各ステップに対して実行順序に対応するIDが割り当てられます。このIDを使って、以下のような判断がされるようになります。
- このステップは以前に成功しているか
- 以前に失敗しているか
- リトライ待ちか
- まだ一度も実行されていないか
4. ステップを実行する
まず、ステップを実行するためのStepOperationExecutorオブジェクトを用意します。第1引数で渡した関数名はstep()関数の中で実行されるのではなく、このオブジェクトを通じて実行されます。
executor = StepOperationExecutor(
    func=func,
    config=config,
    state=self.state,
    operation_identifier=operation_identifier,
    context_logger=self.logger,
)
オブジェクトを用意した後、executor.process()が呼ばれて関数が実行されます。
process()関数が地味にややこしい...
まず、executorはStepOperationExecutorクラスのオブジェクトです。そして、StepOperationExecutorクラスはOperationExecutorクラスを継承しているんですが、process()関数はOperationExecutorクラスで定義されているインスタンス関数なんですよね。
このprocess()関数内で色々とチェックがされて「まだこの関数実行されてないね」ってなったら、StepOperationExecutorクラスのexecute関数が呼ばれて関数が実行されるという流れになっています。
「へぇ...」と思っときゃ良いです!笑
wait()
wait()関数は、「指定時間が経過するまでDurable Executionを中断し、その後のLambda呼び出しで処理を再開する」関数です。
ポイントは、sleep関数のように、Lambdaプロセスが動いている状態で待機しているわけではなく、チェックポイントを保存して再開可能状態にしてから待機状態になるという部分です。
実装は以下のようになっています。step()関数よりもシンプルに実装されています。
def wait(self, duration: Duration, name: str | None = None) -> None:
    """Wait for a specified amount of time."""

    seconds = duration.to_seconds()

    if seconds < 1:
        msg = "duration must be at least 1 second"
        raise ValidationError(msg)

    with self._operation_replay_aware(
        OperationSubType.WAIT, name
    ) as operation_identifier:
        wait_seconds = duration.seconds

        executor: WaitOperationExecutor = WaitOperationExecutor(
            seconds=wait_seconds,
            state=self.state,
            operation_identifier=operation_identifier,
        )

        executor.process()
引数は以下を取ります。ここでは、Durationクラスが重要です。
| 引数 | 意味 |
|---|---|
duration |
待機時間を表すDuration
|
name |
この待機操作を識別する任意の名前 |
Durationクラスを使った形で、第1引数に渡します。このクラスの説明は、上記で記載していますので、ご確認ください。
また、この関数に戻り値は存在しません。
ポイント: 待機した後の動きについて
wait()によって指定した時間が経過した場合、停止したプロセスが途中から再開するわけではありません。
Lambdaハンドラーが先頭から再実行され、成功チェックポイントや完了チェックポイントが記録されていた処理を通過するという処理がされます。これによって、外から見たら途中から再開したように見えるわけです。
wait_for_condition()
この関数は、「条件が満たされるまで、「状態確認 → 一定時間中断 → 再確認」を繰り返すDurableなポーリング処理」です。イメージとしては、前述したwait()を繰り返し行う関数です。step()やwait()と比べてかなりややこしい作りになっています。
使う時に基本形はこんな感じ。
context.wait_for_condition(
    check=check_job,     # 状態を確認するための関数
    config=config,       # 設定
)
ソースは以下のようになっています。
def wait_for_condition(
    self,
    check: Callable[[T, WaitForConditionCheckContext], T],
    config: WaitForConditionConfig[T],
    name: str | None = None,
) -> T:
    if check is None:
        raise ValidationError(
            "`check` is required for wait_for_condition"
        )

    if not config:
        raise ValidationError(
            "`config` is required for wait_for_condition"
        )

    with self._operation_replay_aware(
        OperationSubType.WAIT_FOR_CONDITION,
        name,
    ) as operation_identifier:
        executor = WaitForConditionOperationExecutor(
            check=check,
            config=config,
            state=self.state,
            operation_identifier=operation_identifier,
            context_logger=self.logger,
        )

        return executor.process()
取りうる引数は以下です。
| 引数 | 意味 |
|---|---|
check |
状態を確認し、更新後の状態を返す関数 |
config |
初期状態、待機戦略、シリアライズ方法 |
name |
この処理の名前 |
1. 状態を確認するための関数を用意する
第1引数には、関数を指定します。この関数は自前で用意する必要がありまして...決まった形で用意する必要があります。引数, 戻り値が以下のような関数を用意する必要があります。
| 引数 | 内容 |
|---|---|
state |
初回はinitial_state、2回目以降は前回の戻り値 |
context |
ロガーと現在の試行回数を持つコンテキスト |
例えばこんな感じでしょうか。
def check_job(
    state: dict,
    context: WaitForConditionCheckContext,
) -> dict:
    context.logger.info(
        "checking job",
        extra={"attempt": context.attempt},
    )

    response = job_api.get_job(state["job_id"])

    return {
        "job_id": state["job_id"],
        "status": response["status"],
    }
上記のような関数の引数にstateとcontextを指定しておきます。ただし、wait_for_condition()関数で関数を渡す時に、stateとcontextの値を指定する必要はありません。SDK側がcheckに指定した関数に対していい感じに引数を渡して実行してくれます。
# 以下のように指定するのが正しいです
check=check_job

# その場でcheck_jobを実行し、戻り値を渡してしまうので、このように渡さないようにしましょう
check=check_job(state, check_context)
2. WaitForConditionConfigを作る
次にいきましょう。wait_for_conditionの第2引数configには、WaitForConditionConfigクラスに沿った形で指定します。
@dataclass(frozen=True)
class WaitForConditionConfig(Generic[T]):
    wait_strategy: Callable[[T, int], WaitForConditionDecision]
    initial_state: T
    serdes: SerDes | None = None
wait_strategyには、待機戦略を定義した関数を指定する必要があります。自前で関数を用意することもできますが、通常はSDKのcreate_wait_strategy()を使って、設定値から待機戦略の関数を生成できます。イメージとしては以下のような感じです。
# `create_wait_strategy()`を使って待機戦略を定義
strategy = create_wait_strategy(
    WaitStrategyConfig(
        should_continue_polling=lambda state: (
            state["status"] != "COMPLETED"
        ),
        max_attempts=30,
        initial_delay=Duration.from_seconds(5),
        max_delay=Duration.from_minutes(1),
        backoff_rate=2.0,
    )
)

result = context.wait_for_condition(
    check=check_job,
    config=WaitForConditionConfig(
        initial_state={
            "job_id": "job-123",
            "status": "PENDING",
        },
        wait_strategy=strategy,   # 上記で指定した待機戦略を`wait_strategy`に指定する
    ),
    name="wait-for-job",
)
また、WaitForConditionConfigにinitial_stateが指定されていますが、ここで初期状態を定義しておきます。check=check_jobとして渡されるチェック関数が最初に実行される時にcheck_job関数の第1引数であるstateにWaitForConditionConfigのinitial_stateが渡されます。
create_wait_strategy()関数内で使われているWaitStrategyConfigは以下の属性を持っています。デフォルト値も合わせて示しておきます。
| 属性 | 説明 | デフォルト値 |
|---|---|---|
| should_continue_polling | ポーリングを続けるかの判定 | - |
| max_attempts | 最大試行回数 | 60 |
| initial_delay | 初期待機時間 | 5秒 |
| max_delay | 最大待機時間 | 5分 |
ポーリングを続けるかの判定にはshould_continue_pollingが使用されます。
should_continue_pollingがFalseを返すと条件成立としてポーリングが終了します。終了したタイミングで成功チェックポイントが保存され、最後にcheckが返した状態が返却されます。
should_continue_pollingがTrueを返した場合には、次のポーリング待機状態となります。ただし、条件が成立しないままmax_attemptsへ到達した場合は正常終了ではなく、WaitForConditionErrorが発生します。また、中断のタイミングによってcheckが再度実行される可能性を考慮し、外部状態の読み取りを中心とした冪等な処理にしておくのが安全です。
ちょっと難しかったですね...
これを使う場面は、「外部APIを使って、外部データの状態を取得したいけど、GET APIしかなくてLambda側から状態を確認しに行く必要がある時」とかが該当するかなと思います。
次で説明するwait_for_callbackを使った方がスマートに感じますが、wait_for_callbackで実現ができない時にwait_for_conditionを使うことになる場面が多いのではないかなぁと思ったりしてます。
wait_for_callback()
この関数は、「外部システムへ処理を依頼し、その外部システムから完了通知が届くまでDurable Executionを中断する」です。wait_for_condition()との違いは、Lambda側から確認しに行くのではなく、外部のシステムから通知してもらう形となることです。
ざっくりと、以下のように使います。
def submit_job(
    callback_id: str,
    submitter_context: WaitForCallbackContext,
) -> None:
    submitter_context.logger.info(
        "外部ジョブを開始する"
    )

    external_job_api.start_job(
        callback_id=callback_id,
        input_data={"order_id": "order-123"},
    )


result = context.wait_for_callback(
    submitter=submit_job,
    name="wait-for-external-job",
    config=WaitForCallbackConfig(
        timeout=Duration.from_minutes(30),
    ),
)
引数は以下を取ります。
| 引数 | 意味 |
|---|---|
submitter |
外部システムへ処理を依頼する関数 |
name |
操作の名前 |
config |
タイムアウト、ハートビート、リトライ、結果変換の設定 |
ソースは以下です。
def wait_for_callback(
    self,
    submitter: Callable[[str, WaitForCallbackContext], None],
    name: str | None = None,
    config: WaitForCallbackConfig | None = None,
) -> Any:
    step_name = self._resolve_step_name(name, submitter)

    def wait_in_child_context(context: DurableContext):
        return wait_for_callback_handler(
            context,
            submitter,
            step_name,
            config,
        )

    try:
        return self.run_in_child_context(
            wait_in_child_context,
            step_name,
            ChildConfig(
                sub_type=OperationSubType.WAIT_FOR_CALLBACK
            ),
        )
    except ChildContextError as e:
        ...
wait_for_callback()の処理は以下のようになります。
- コールバックIDを作成する
- submitterで指定された関数を実行し、コールバックIDを外部システムへ渡す
- submitterの戻り値ではなく、外部システムから送信されるコールバック結果を待機する
- 外部システムが成功または失敗の結果を送信すると、Durable Functionが再実行される
1. submitterに関数を指定する
第1引数のsubmitterでは、外部APIを実行する処理などの関数を指定します。ここで指定した関数は、内部的にcontext.step()で実行されます。また、この関数では、callback_idとsubmitter_contextが指定されます。ここでいうsubmitter_contextはWaitForCallbackContextというコンテキストが渡されます。
2. WaitForCallbackConfigを用意する
第3引数のconfigは、WaitForCallbackConfigクラスに沿った形で指定する必要があります。
| 属性 | 説明 |
|---|---|
| timeout | コールバック全体の待ち時間 |
| heartbeat_timeout | 外部処理が長時間かかる場合のハートビート期限を設定 |
| retry_strategy | submitterを実行するcontext.step()のリトライ設定 |
| serdes | 外部システムから返された結果をPythonオブジェクトへ変換 |
必ず理解しておきたいのはtimeoutです。
timeoutで設定した時間内に、外部システムからコールバックの成功または失敗の結果が送信されなければ、CallbackTimeoutErrorというクラスで定義されたタイムアウトエラーとなります。
また、外部システムの処理が長時間かかる場合は、heartbeat_timeoutも設定できます。これはSDKが外部処理を定期的に確認する間隔ではありません。外部システム側がSendDurableExecutionCallbackHeartbeat APIを定期的に呼び出し、前回のハートビートからこの時間を超えた場合にタイムアウトと判断する仕組みです。コールバック結果やハートビートを送る外部システムには、対応するSendDurableExecutionCallbackSuccess, SendDurableExecutionCallbackFailure, SendDurableExecutionCallbackHeartbeatの権限も必要です。
この関数は、Durable Functionsを使ってワークフローを実装した場合、ユーザの承認を求めるタイミングで実行され、ユーザから承認が返ってきたタイミングで処理が再開されるというような処理を実現するために使用されるケースが多いのではないでしょうか。
invoke()
この関数は、「現在のDurable Functionから、別のLambdaや別のDurable Functionを呼び出し、その結果を待つ」関数です。これは割とシンプルな作りをしているので直感的でわかりやすいかなと思っています。
動作の流れとしてはこんな感じかなぁ。
- 呼び出し先のLambda関数を開始
- 現在のDurable Executionを中断
- 呼び出し先が完了
- 現在のDurable Functionを再実行
- 結果を復元して返す
使用イメージとしてはこんな感じです。
result = context.invoke(
    function_name="process-payment",
    payload={
        "order_id": "order-123",
        "amount": 5000,
    },
    name="invoke-payment",
)
取りうる引数は以下です。
| 引数 | 意味 |
|---|---|
function_name |
呼び出すLambda関数の名前またはARN |
payload |
呼び出し先へ渡す入力 |
name |
このinvoke操作の名前 |
config |
入出力のシリアライズやテナント設定 |
ソースはこんな感じで定義がされています。
def invoke(
    self,
    function_name: str,
    payload: P,
    name: str | None = None,
    config: InvokeConfig[P, R] | None = None,
) -> R:
    if not config:
        config = InvokeConfig[P, R]()

    with self._operation_replay_aware(
        OperationSubType.CHAINED_INVOKE,
        name,
    ) as operation_identifier:
        executor = InvokeOperationExecutor(
            function_name=function_name,
            payload=payload,
            state=self.state,
            operation_identifier=operation_identifier,
            config=config,
        )

        return executor.process()
1. 呼び出すlambda関数を指定する
function_nameにLambda関数の名前を指定します。ここでは、通常のLambda関数とDurable Functionのどちらも呼び出すことが可能です。
step()やwait_for_callback()の場合は、実行したい処理をcallableとして引数に渡していたと思いますが、invoke()の場合は呼び出し先のLambda関数名またはARNを文字列で渡します。
Durable Functionを呼び出す場合は、バージョンまたはエイリアスで修飾した関数名またはARNを指定します。
2. payloadを用意する
第2引数のpayloadはそのままですね。よく使う形です。別Lambdaに渡すパラメータをpayloadとして指定します。これを別Lambdaへ送る過程で開始チェックポイントへ保存がされます。
3. InvokeConfigを用意する
第3引数のconfigはInvokeConfigの形で渡す必要があります。
@dataclass(frozen=True)
class InvokeConfig(Generic[P, R]):
    serdes_payload: SerDes[P] | None = None
    serdes_result: SerDes[R] | None = None
    tenant_id: str | None = None
| 属性 | 説明 |
|---|---|
serdes_payload |
呼び出し先へ送る値のシリアライズ方法 |
serdes_result |
呼び出し先から返された結果のデシリアライズ方法 |
tenant_id |
マルチテナント環境で呼び出しを特定テナントへ関連付ける設定 |
各属性でNoneが許可されてるので、まるまる指定しなくても問題なさそうですね。
parallel()
この関数は、「複数の関数を並行して進め、各ブランチの結果をBatchResultとして返す」ものです。
使用イメージはこんな感じですね。functionsで配列として指定されている関数が並列実行されます。内部ではワーカースレッドが使われ、同時に実行される数はmax_concurrencyで制御できます。
def load_user(ctx: DurableContext) -> dict:
    return ctx.step(
        lambda _: {"id": "user-123"},
        name="load-user",
    )


def load_orders(ctx: DurableContext) -> list:
    return ctx.step(
        lambda _: [{"id": "order-1"}],
        name="load-orders",
    )


def load_preferences(ctx: DurableContext) -> dict:
    return ctx.step(
        lambda _: {"theme": "dark"},
        name="load-preferences",
    )


batch_result = context.parallel(
    functions=[
        load_user,
        load_orders,
        load_preferences,
    ],
    name="load-user-information",
)

results = batch_result.get_results()
取りうる引数は以下です。
| 属性 | 説明 |
|---|---|
functions |
配列形式/並列実行したい関数の名称 |
name |
操作名 |
config |
parallel()における設定 |
ソースは以下のようになっています。
def parallel(
    self,
    functions: Sequence[
        Callable[[DurableContext], T]
        | ParallelBranch[T]
    ],
    name: str | None = None,
    config: ParallelConfig | None = None,
) -> BatchResult[T]:
    if config is not None:
        config.completion_config._validate_for_total(
            len(functions)
        )

    with self._operation_replay_aware(
        OperationSubType.PARALLEL,
        name,
    ) as operation_identifier:
        operation_id = operation_identifier.operation_id

        parallel_context = self.create_child_context(
            operation_id=operation_id
        )

        def parallel_in_child_context():
            return parallel_handler(
                callables=functions,
                config=config,
                execution_state=self.state,
                parallel_context=parallel_context,
                operation_identifier=operation_identifier,
                operation_id_namespace=OperationIdNamespace(
                    operation_id
                ),
            )

        return child_handler(...)
1. ParallelConfigを確認する
まず、configが指定されている場合は、completion_configの条件をブランチの総数に対して検証します。
if config is not None:
    config.completion_config._validate_for_total(
        len(functions)
    )
ParallelConfigでは、同時実行数や、何件成功・失敗したら並列処理全体を完了させるかなどを設定できます。
| 属性 | 説明 |
|---|---|
max_concurrency |
並列実行数の最大値を指定 |
completion_config |
並列実行全体をいつ完了とするかを設定 |
serdes |
並列実行全体の結果のシリアライズ方法 |
item_serdes |
個々の並列実行結果のシリアライズ方法 |
summary_generator |
シリアライズ後のBatchResultが256KBを超えた場合に、実行履歴へ保存する要約文字列を生成する関数 |
nesting_type |
各並列実行関数の子コンテキストを実行履歴にどう表すか |
configを指定しなかった場合は、同時実行数に上限を設けず、完了条件にはデフォルトのCompletionConfig.all_successful()が使われます。
2. 並列処理用の子コンテキストを作る
次に、parallel()全体を識別する操作IDを使って、並列処理用の子コンテキストを作ります。
operation_id = operation_identifier.operation_id

parallel_context = self.create_child_context(
    operation_id=operation_id
)
このparallel_contextを基準に、各ブランチにも専用のDurableContextが用意されます。各ブランチの関数は、SDKから渡された子コンテキストを使ってstep()やwait()などのDurable操作を実行します。
def load_user(ctx: DurableContext) -> dict:
    return ctx.step(
        lambda _: {"id": "user-123"},
        name="load-user",
    )
ここで外側のcontextを使うのではなく、引数として渡されたctxを使うことで、各ブランチの操作IDや実行履歴が正しい親子関係で管理されます。
3. 各ブランチを実行してBatchResultを返す
最後に、parallel_handler()へブランチの関数、設定、実行状態、子コンテキストなどを渡して並列実行します。
def parallel_in_child_context():
    return parallel_handler(
        callables=functions,
        config=config,
        execution_state=self.state,
        parallel_context=parallel_context,
        operation_identifier=operation_identifier,
        operation_id_namespace=OperationIdNamespace(
            operation_id
        ),
    )
parallel()自体は、各ブランチの状態と結果を保持するBatchResultを返します。成功したブランチの結果を配列形式で取り出す場合はget_results()を使います。ブランチの失敗はBatchResultに格納されるため、get_errors()で確認するか、throw_if_error()でエラーを送出させます。
map()
この関数は、「入力の各要素に同じ処理を並列で適用し、各処理の状態と結果をBatchResultとして返す」ものです。異なる処理を並列実行するparallel()に対して、map()は同じ処理を複数の入力へ適用する時に使います。
def process_item(
    child_context: DurableContext,
    item: dict,
    index: int,
    items: list[dict],
) -> dict:
    return child_context.step(
        lambda _: process(item),
        name=f"process-{index}",
    )


batch_result = context.map(
    inputs=items,
    func=process_item,
    name="process-items",
)

results = batch_result.get_results()
取りうる引数は以下です。
| 引数 | 意味 |
|---|---|
inputs |
処理対象となる入力の配列 |
func |
各要素に対して実行する関数 |
name |
map操作の名前 |
config |
同時実行数、完了条件、シリアライズなどの設定 |
1. 各要素を処理する関数を用意する
第2引数のfuncには、入力の各要素に対して実行する関数を指定します。この関数には、SDKから以下の4つの引数が渡されます。
| 引数 | 意味 |
|---|---|
child_context |
この要素の処理に割り当てられた子のDurableContext
|
item |
現在処理している要素 |
index |
現在処理している要素のindex |
items |
map()へ渡された入力全体 |
def process_item(
    child_context: DurableContext,
    item: dict,
    index: int,
    items: list[dict],
) -> dict:
    return child_context.step(
        lambda _: process(item),
        name=f"process-{index}",
    )
これらの引数は自分で渡す必要はありません。func=process_itemと指定すると、SDKが各要素の実行時に引数を渡します。
2. 入力ごとに子コンテキストを作って並列実行する
map()を呼び出すと、SDKはinputsの各要素に対して子コンテキストを用意し、funcを並列実行します。
batch_result = context.map(
    inputs=items,
    func=process_item,
    name="process-items",
)
同時に実行する要素数を制限したい場合は、MapConfigのmax_concurrencyを指定します。完了条件やシリアライズ方法などもMapConfigで設定できます。
map_config = MapConfig(
    max_concurrency=5,
)

batch_result = context.map(
    inputs=items,
    func=process_item,
    name="process-items",
    config=map_config,
)
3. BatchResultから結果を取り出す
map()自体の戻り値は配列ではなくBatchResultです。処理結果はget_results()で取り出します。
results = batch_result.get_results()
各要素の処理で発生したエラーもBatchResultに格納されます。get_errors()で確認するか、throw_if_error()でエラーを送出させます。
run_in_child_context()
この関数は、「複数のDurable操作を、1つの子ワークフローとしてまとめて実行する」というものです。
ごちゃごちゃ書きますが、複数のDurable操作をグループ化して管理できまっせ!ってことです。
使用イメージはこんな感じ。サンプルでは通常のPythonコードと同じようにstep()を順番に呼び出しています。
ただし、run_in_child_context()自体が直列実行を強制しているわけではないので、parallel()やmap()を呼び出すこともできます。あくまでもこの関数の役割は、複数のDurable操作を子コンテキストへまとめ、親子関係のある実行履歴として管理することです。
def process_order(
    child_context: DurableContext,
) -> dict:
    validated = child_context.step(
        lambda _: validate_order(),
        name="validate-order",
    )

    inventory = child_context.step(
        lambda _: reserve_inventory(validated),
        name="reserve-inventory",
    )

    payment = child_context.step(
        lambda _: charge_payment(inventory),
        name="charge-payment",
    )

    return {
        "validated": validated,
        "inventory": inventory,
        "payment": payment,
    }


result = context.run_in_child_context(
    func=process_order,
    name="process-order",
)
取りうる引数は以下です。
| 引数 | 意味 |
|---|---|
func |
子コンテキスト内で実行する関数 |
name |
子コンテキスト操作の名前 |
config |
結果のシリアライズや仮想コンテキスト設定 |
ソースは以下のようになっています。
def run_in_child_context(
    self,
    func: Callable[[DurableContext], T],
    name: str | None = None,
    config: ChildConfig | None = None,
) -> T:
    step_name = self._resolve_step_name(name, func)

    sub_type = (
        config.sub_type
        if config and config.sub_type
        else OperationSubType.RUN_IN_CHILD_CONTEXT
    )

    with self._operation_replay_aware(
        sub_type,
        step_name,
        operation_type=OperationType.CONTEXT,
    ) as operation_identifier:
        operation_id = operation_identifier.operation_id
        is_virtual = (
            config.is_virtual if config else False
        )

        def callable_with_child_context():
            return func(
                self.create_child_context(
                    operation_id=operation_id,
                    is_virtual=is_virtual,
                )
            )

        return child_handler(
            func=callable_with_child_context,
            state=self.state,
            operation_identifier=operation_identifier,
            config=config,
        )
1. 子コンテキストの名前と設定を決める
最初に、nameとfuncから子コンテキストの操作名を決めます。
step_name = self._resolve_step_name(name, func)
nameが指定されていれば、その値が使われます。指定されていない場合は、@durable_with_child_contextなどがcallableに保持した_original_nameが使われます。通常の関数を渡す場合は、実行履歴を追いやすくするためにnameを明示的に指定するのが良いです。
第3引数のconfigには、ChildConfigクラスに沿った形で指定します。
@dataclass(frozen=True)
class ChildConfig:
    serdes: SerDes | None = None
    sub_type: OperationSubType | None = None
    summary_generator: SummaryGenerator | None = None
    is_virtual: bool = False
| 属性 | 説明 |
|---|---|
serdes |
子コンテキスト全体の結果をシリアライズ・デシリアライズする方法 |
sub_type |
実行履歴上で使用する操作の種別 |
summary_generator |
結果が大きい場合に、実行履歴へ保存する要約文字列を生成する関数 |
is_virtual |
子コンテキスト自身の開始・完了チェックポイントを省略するかどうか |
通常のrun_in_child_context()では、configを指定しなくても問題ありません。sub_typeやis_virtualは、SDK内部の複合操作などで使われることが多い設定です。
2. 子コンテキストを作って関数を実行する
次に、子コンテキスト内で使う操作IDを取得し、そのIDを使って新しいDurableContextを作ります。
operation_id = operation_identifier.operation_id

def callable_with_child_context():
    return func(
        self.create_child_context(
            operation_id=operation_id,
            is_virtual=is_virtual,
        )
    )
子ワークフロー内では、外側のcontextを参照するのではなく、funcの引数として渡されたchild_contextを使います。これによって、子ワークフロー内の操作IDや実行履歴が正しい親子関係で管理されます。イメージとしてはこんな感じで実行履歴が管理されるようになります。
operation 1
operation 2
    operation 2-1
    operation 2-2
    operation 2-3
operation 3
3. 結果・中断・例外を親コンテキストへ伝える
作成した子コンテキストの関数は、child_handler()を通じて実行されます。正常終了した場合は、子コンテキスト全体の完了状態と結果、または結果が大きい場合はその要約がチェックポイントへ保存され、run_in_child_context()の戻り値として返されます。
リプレイされる時はプロセスの途中から再開されるのではなく、ハンドラーの先頭から実行され、チェックポイントが確認できたDurable操作をスキップします。run_in_child_context()で呼ばれた関数内でも同様の動きをします。
子コンテキスト内でwait()を実行すると、SuspendExecutionが親コンテキスト側まで伝わり、Durable Executionが一度中断されます。これはエラーではありません。指定した時間が経過するとLambdaハンドラーが再実行され、子コンテキスト内の完了済みチェックポイントを通過して、wait()より後の処理へ進みます。
子コンテキスト内で処理に失敗した場合は、子コンテキスト全体がFAILEDとなり、呼び出し側にはChildContextErrorとして伝わります。
logger
DurableContextとStepContextには、リプレイを考慮したloggerが用意されています。Durable Functionは再開時にハンドラーの先頭からリプレイされますが、このloggerは完了済みの処理をリプレイしている間の重複ログを標準で抑制します。(この辺りの動きはチェックポイント通過の動作とほぼ同じイメージですね。)
初回実行:
  処理開始           # 出力
  first_stepのログ   # 出力
  waitで中断

再実行:
  処理開始              # リプレイのため抑制
  first_step           # リプレイのため抑制
  waitを通過
  second_stepのログ     # 出力
以下のコードはLoggerInterfaceクラスの定義部分です。このProtocolからは呼び出せるログメソッドがわかりますが、付与されるメタデータやリプレイ時の抑制処理は、実装クラスであるLogger側で定義されています。
class LoggerInterface(Protocol):
    def debug(
        self, msg: object, *args: object, extra: Mapping[str, object] | None = None
    ) -> None: ...  # pragma: no cover

    def info(
        self, msg: object, *args: object, extra: Mapping[str, object] | None = None
    ) -> None: ...  # pragma: no cover

    def warning(
        self, msg: object, *args: object, extra: Mapping[str, object] | None = None
    ) -> None: ...  # pragma: no cover

    def error(
        self, msg: object, *args: object, extra: Mapping[str, object] | None = None
    ) -> None: ...  # pragma: no cover

    def exception(
        self, msg: object, *args: object, extra: Mapping[str, object] | None = None
    ) -> None: ...  # pragma: no cover
ハンドラーに渡されるDurableContextのloggerには、executionArnとrequestIdが付与されます。StepContextのloggerでは、それらに加えてoperationId, operationName, attemptなど、実行中のステップを識別する情報が付与されます。
contextに渡されるクラスによって、ログの中身が変わってきます。どの情報が必要になるので、精査してから実装に載せておきたいですね。
また、Python標準のloggingやPowertools for AWS Lambdaなど、LoggerInterfaceを満たすloggerへ差し替えたい場合はcontext.set_logger()を使うことができます。
def set_logger(
    self,
    new_logger: LoggerInterface,
):
    self.logger = Logger.from_log_info(
        logger=new_logger,
        info=self._log_info,
        is_replaying=self.is_replaying,
    )
例として、Python標準のloggingを使う場合のサンプルを載せておきます。難しいことはしてないですね。Python標準のloggingを使う場合でも、「リプレイ中のログ抑制」は行われるようになってます。
import logging

application_logger = logging.getLogger("orders")
application_logger.setLevel(logging.INFO)

@durable_execution
def handler(event, context):
    context.set_logger(application_logger)

    context.logger.info(
        "注文処理を開始",
        extra={
            "orderId": event["order_id"],
        },
    )
まとめ
DurableContextは、LambdaハンドラーからDurableな操作を実行するための中心的なオブジェクトです。step()やwait()を呼ぶと、SDKが操作の状態をチェックポイントへ保存します。Lambdaが再実行された時は、その履歴を使って完了済みの処理結果を復元し、まだ完了していない処理から実行を進めます。
通常のLambdaコードに近い形でワークフローを書けますが、外部への副作用を持つ処理の冪等性、callbackを送る側の権限、Durable Functionを呼び出す時の修飾された関数名またはARN、BatchResultに格納されたエラーの確認などは、実装時に意識しておく必要があります。
以上!