
はじめに
皆様、この記事を読んでいただきありがとうございます。
このアカウントでは、インフラエンジニア1年目の私が、普段気になったことを自分なりに解釈し、つぶやいております。
「いや、何言ってるんだ?」「その検証で合っているのか?」と思うところもあるかもしれません。その際は、ぜひコメントで優しく教えていただければ幸いです。
また、この記事は組織を代表した発言ではないことをご了承ください。
今回は、私がAWSの学習を進める中で気になった、RAGという技術に登場する文書の「ベクトル化」に注目してみました。
人間が認識している言葉の意味は、機械(LLMなど)にはどのように認識されているのでしょうか。本当に私たちの感覚と同じなのか? という疑問が出発点です。
当初は、「今のAIは私の意図をくみ取って、的確なものを返してくれる。私の感覚も認識しているはず。きっとそうだ…」と考えておりました。
しかし、検証してみると、私にとって意外な結果になりました。この結果を通して、残すドキュメントへの意識も高まりました。
では、早速検証を進めていきましょう。
対義語は、機械にとって本当に『反対』なのか?
突然ですが、「暑い」の反対は「寒い」です。
「何、当たり前のことを言っているんだ?」と思われた方も多いのではないでしょうか。
では、この二つを機械が扱う数字に変換したときも、反対になるのでしょうか。この問いに対して私は、対義語ならベクトルの矢印も180°近く開くのではないかと予想しました。
言葉が反対なら、矢印も反対になるはずです。いや、そこは本当に「なら」でつながるのか…?
そこで今回は、単語をベクトルにして角度を測り、さらに文章にした場合も比べてみました。まずは、ベクトル化が何の役に立つのかから、一緒に見ていきましょう。
言葉を数字にすると、何ができるのか
単語や文章を、数値の並びで表すことをベクトル化と呼びます。ここで扱うEmbedding(埋め込み)は、モデルを使って言葉をベクトルへ変換する仕組みです。
例えば「サーバーを再起動する手順」という文章を、数百個の数字の並びに変換します。別の文章も同じモデルで変換すれば、数字同士を比較できます。文字が完全に一致しているかだけでなく、関連する文章を探すためにも使われます。
ここで登場するのが、文書を検索してからLLMに回答を作らせるRAG(検索拡張生成)です。ベクトル検索を使う典型的な流れを、図で見てみましょう
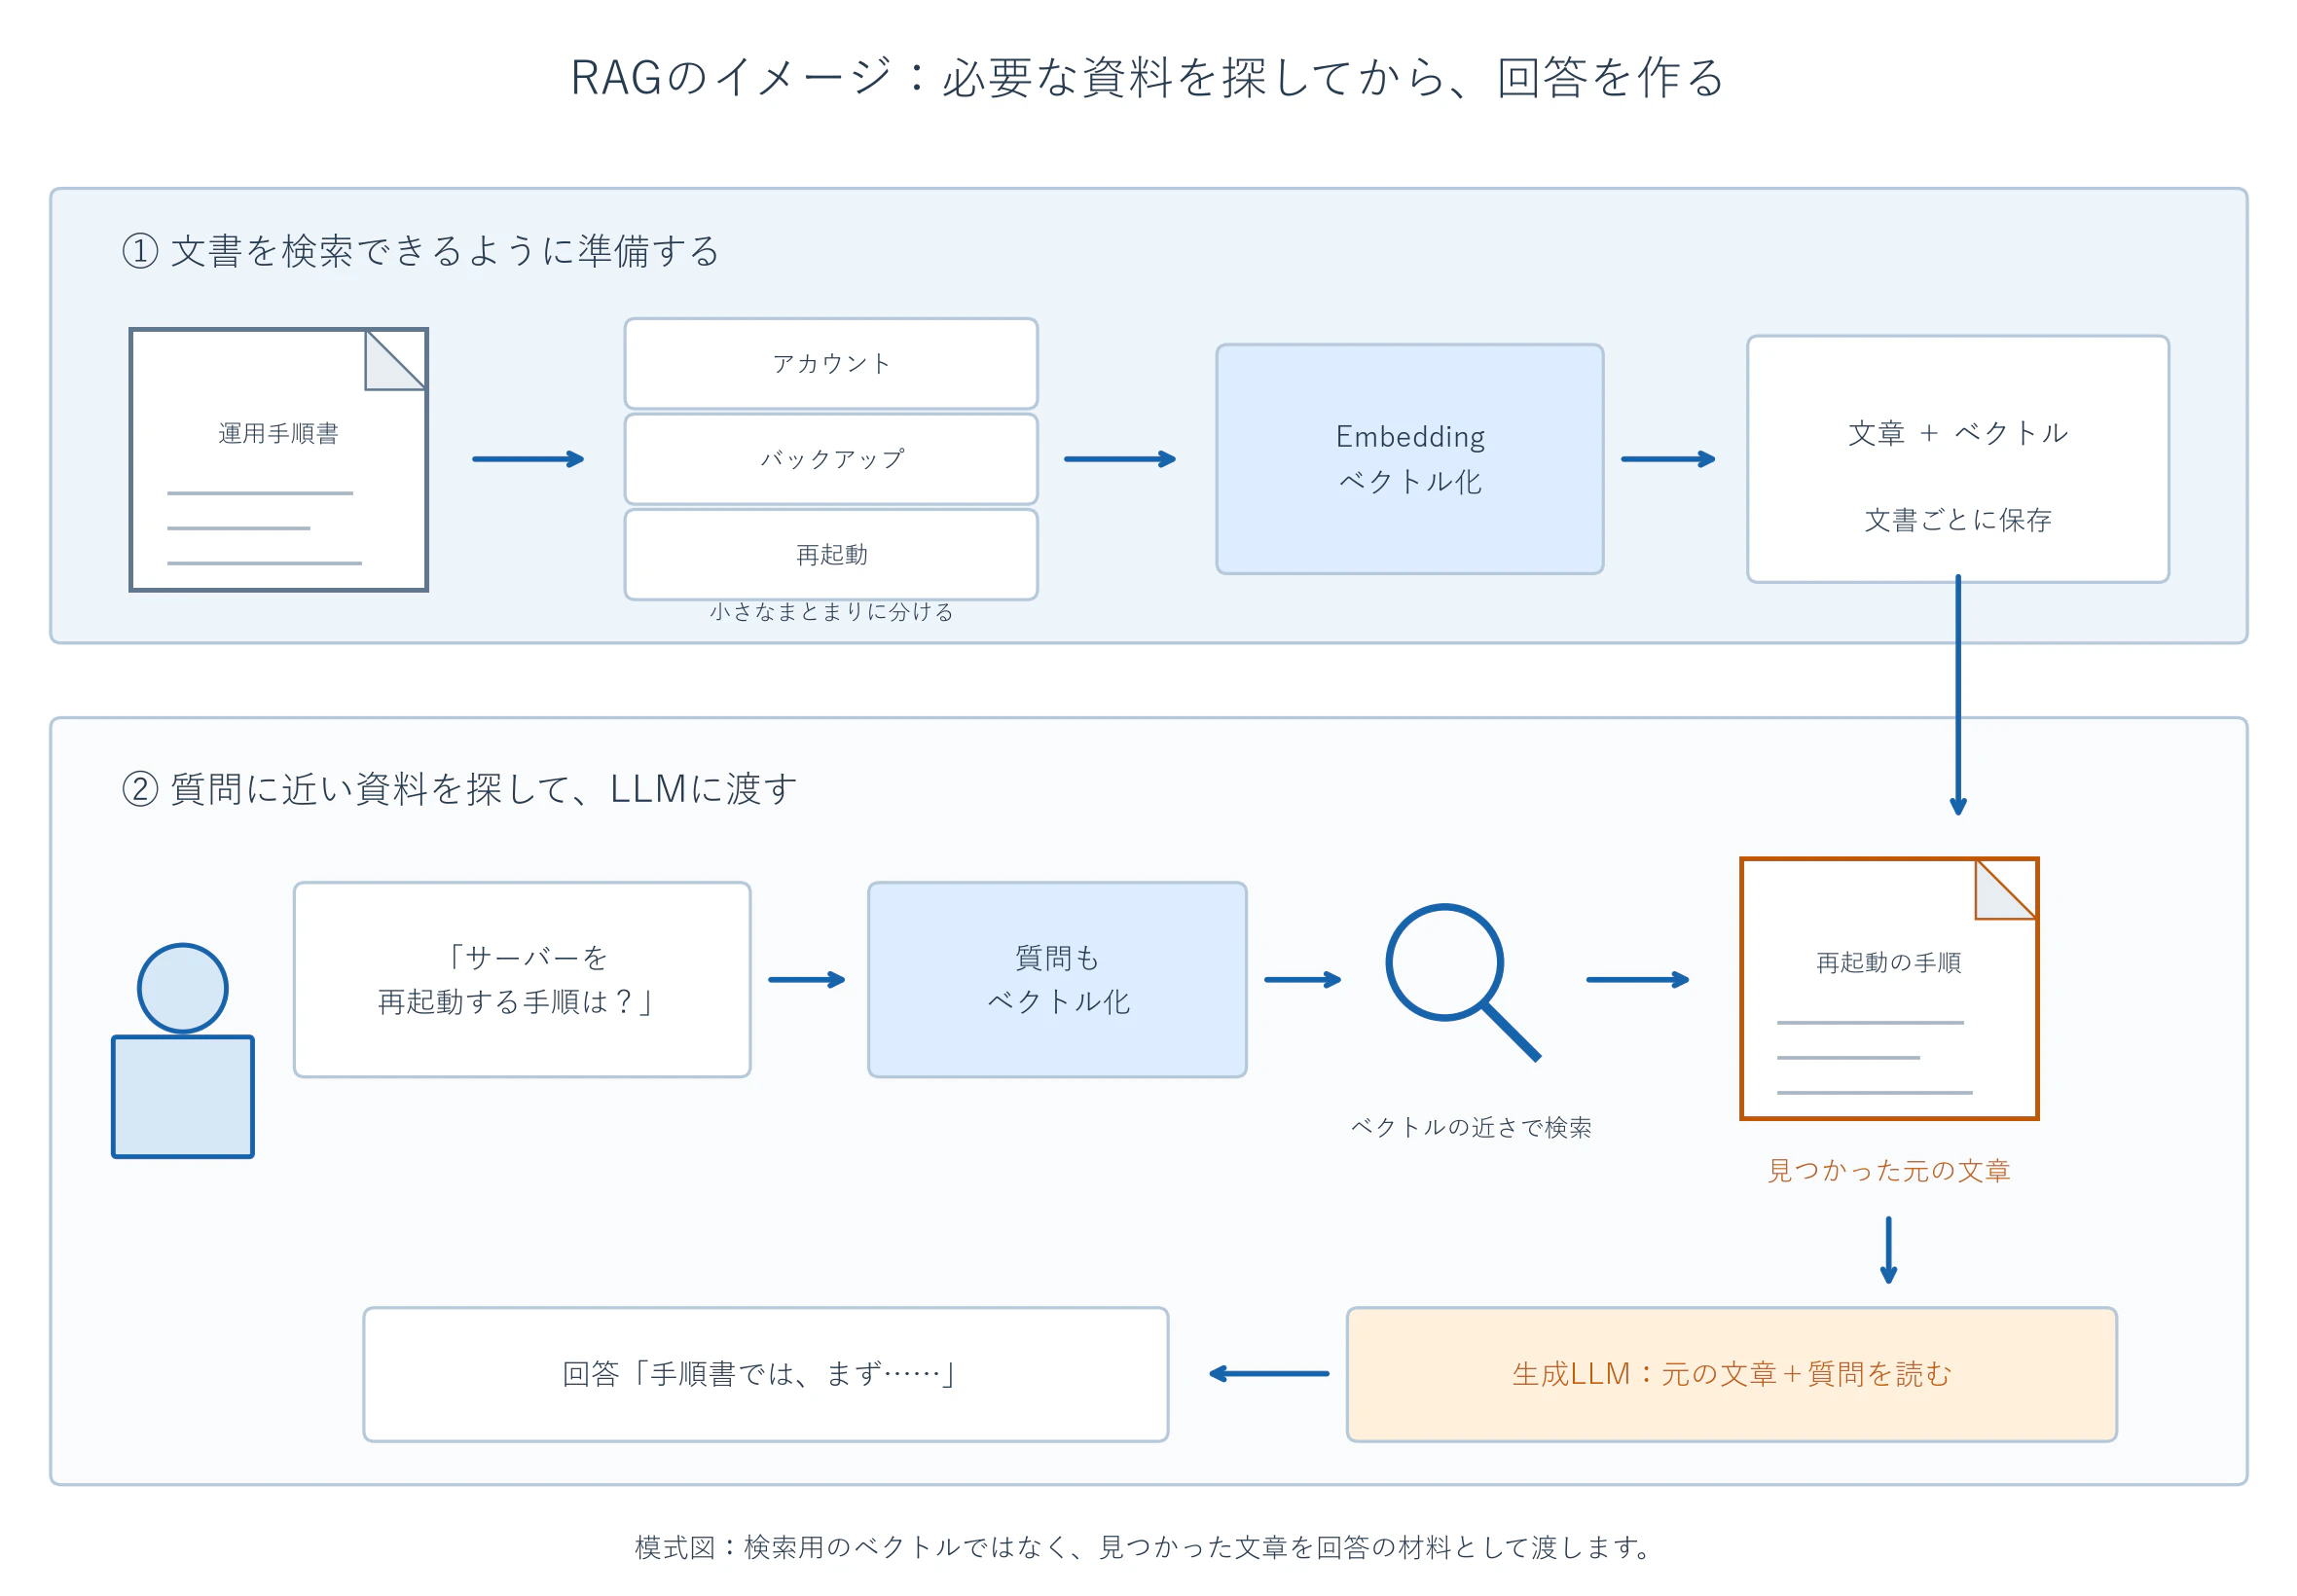
文書を小さなまとまりに分け、そのベクトルと元の文章を保存します。質問も検索用のモデルでベクトル化し、関連する文書を探します。その後、検索された文章を質問と一緒に生成LLMへ渡します。 Amazon BedrockのKnowledge Basesでも、この流れで回答を生成します。参考:AWSのRAG解説
検索に使うEmbeddingモデルと、回答を書く生成LLMには、それぞれ役割があります。今回調べるのは、前者に関わる「言葉をベクトルにしたときの関係」です。LLMに対義語を答えさせる実験ではありません。
ベクトルを、位置と矢印で見てみる
数字が二つなら、平面の横位置・縦位置として点を打てます。その点まで原点から矢印を引くと、向きと長さを持つベクトルになります。
実際のEmbeddingではもっと多くの数字を使いますが、まずは二次元の図でイメージしてみましょう。
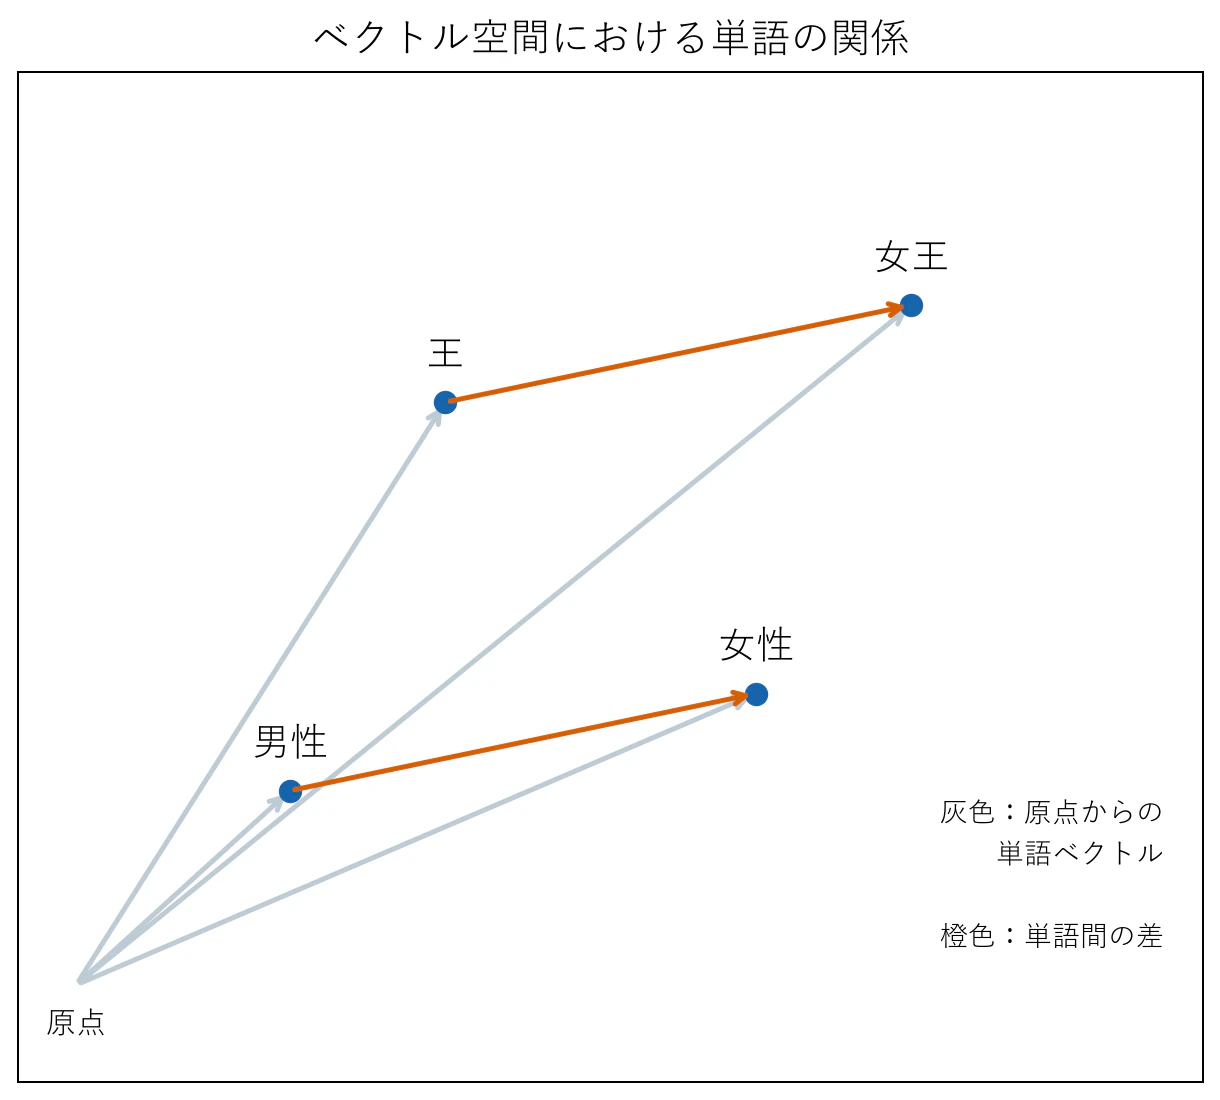
単語ベクトルの有名な例に、英語の「king − man + woman」を計算すると「queen」に近いベクトルになる、というものがあります。日本語でイメージするなら「王 − 男性 + 女性 ≈ 女王」です。元の研究でも、このような単語間の関係が報告されています。参考:Mikolovらの論文
図の橙色の矢印は、ある単語から別の単語へ移る差分を表します。「男性から女性へ」と「王から女王へ」の変化に、似た関係が表れるという考え方です。
ただし、この図の座標は説明用です。今回のモデルで測った配置ではなく、横軸や縦軸に特定の意味が付いているわけでもありません。上の計算も、どんなモデル・言語でも厳密な等式として成立する、という話ではありません。
ここで、今回比べたいのは、原点から各単語へ伸びるベクトル同士の角度です。橙色の差分の矢印とは、見ているものが違います。この二種類は分けて考えていきましょう。
角度を比べる、コサイン類似度
向きがどのくらいそろっているかを数値にする方法が、コサイン類似度です。今回はベクトルの長さを1にそろえて比較します。
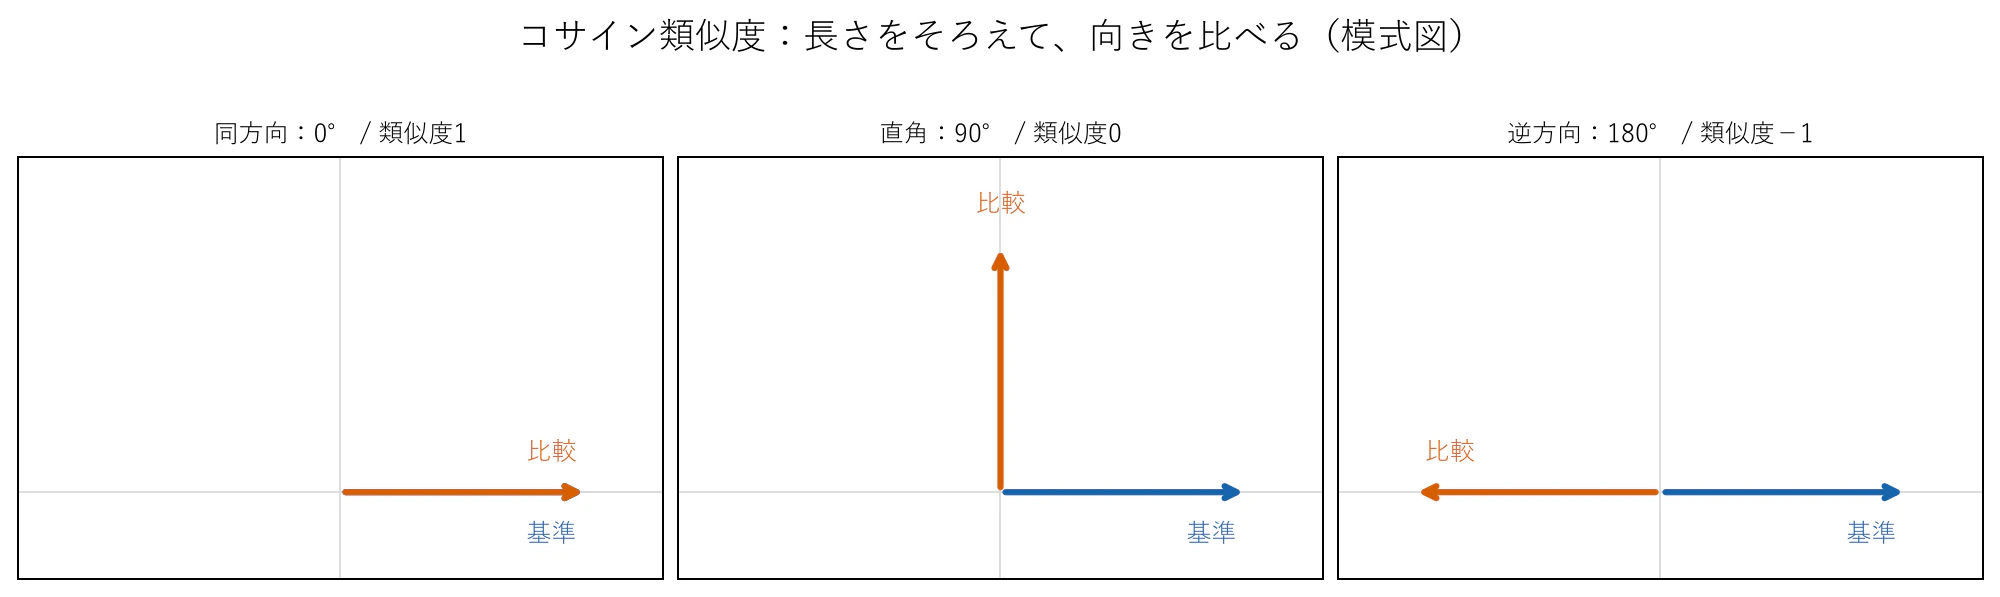
| 向き | 角度 | コサイン類似度 |
|---|---|---|
| 同じ方向 | 0° | 1 |
| 直角 | 90° | 0 |
| 逆方向 | 180° | −1 |
値が1に近いほど向きが近く、−1に近いほど逆方向です。ただし、0なら意味も完全に無関係、というわけではありません。数字が表す角度と、言葉の意味の関係は分けて見ていきます。
私の予想では、「暑い」と「寒い」なら180°近く、類似度も−1に近いはずです。では、実際に測ってみましょう。
まずはWord2Vecで測ってみる
最初は、単語ごとに固定のベクトルを持つWord2Vecを使います。日本語Wikipediaから学習した、公開済みのWikiEntVecを利用しました。モデルの配布元・学習条件
| 項目 | 条件 |
|---|---|
| モデル | WikiEntVec・20190520版、単語ベクトル |
| 次元数 | 200 |
| 対象 | 形容詞を中心とした対義語10組 |
| 比較相手 | 対義語、近い意味の語、別の性質の語3個 |
| 測定 | 合計50ペアのコサイン類似度と角度 |
ここでは「暑い」を基準に、対義語の「寒い」と、近い意味の「暖かい」を比べた結果を見ていきましょう。ただし、「近い意味」といっても、まったく同じ意味ではありません。「暑い」と「暖かい」では、温度の程度や感じ方に違いがあります。
比較する言葉は、測定前に決めておきました。対象33語はすべてモデルに収録されていたため、欠測はありませんでした。
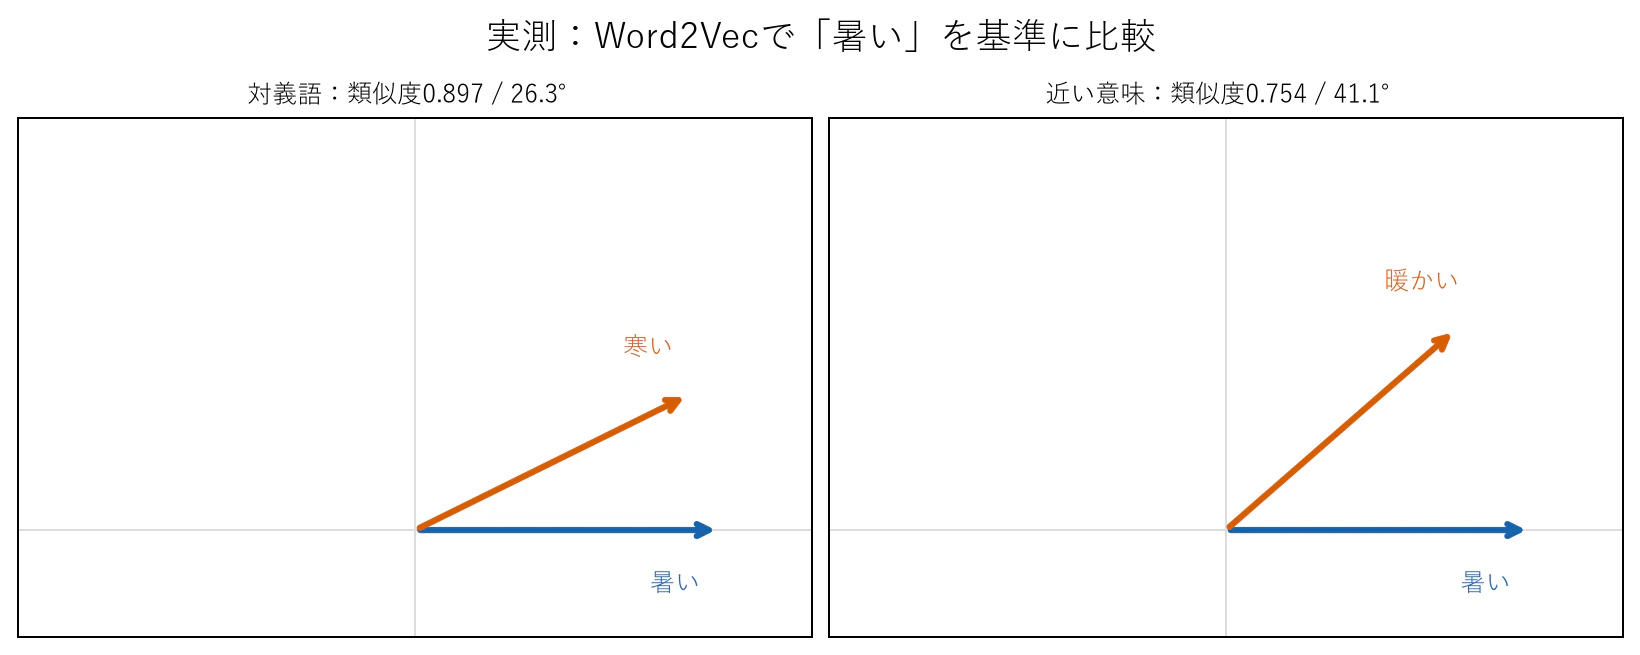
「暑い」と「寒い」の角度は約26°、コサイン類似度は約0.9
180°どころか、かなり小さい角度です。しかも「暑い」と「暖かい」は約41°で、今回のモデルでは「寒い」の方が近い向きでした。
反対だから、できれば端と端にいてほしいところでした。いや、ベクトルの配置にこちらの希望を出しても仕方がない…
10組全体でも、対義語の角度は約26〜54°。すべて90°未満でした。また、10組中7組では、対義語の方が「近い意味の語」より高い類似度でした。
単語だけだから? 文章にしてみる
では、「暑い」「寒い」と単独で渡したから、この結果になったのでしょうか。「今日は暑いです」「今日は寒いです」なら、文章として意味が対立します。
追加実験では、文章をベクトル化できる paraphrase-multilingual-MiniLM-L12-v2 を使いました。384次元のベクトルを出力する多言語モデルです。公式モデルカード
ここでモデルが替わるので、このモデルでも、単語だけの条件から測り直します。 Word2Vecの単語と別モデルの文章をそのまま比べてしまうと、モデルが違うからなのか、文章にしたからなのかが混ざってしまいます。
| 項目 | 条件 |
|---|---|
| 入力 | 単語、文章1、文章2 |
| 対象 | 同じ10組の対義語 |
| 比較相手 | 対義語、近い意味の語、別の性質の語1個 |
| 測定 | 10組×3条件×3関係=90ペア |
文章は組ごとに二種類用意し、各ペアでは比較する語以外を変えません。
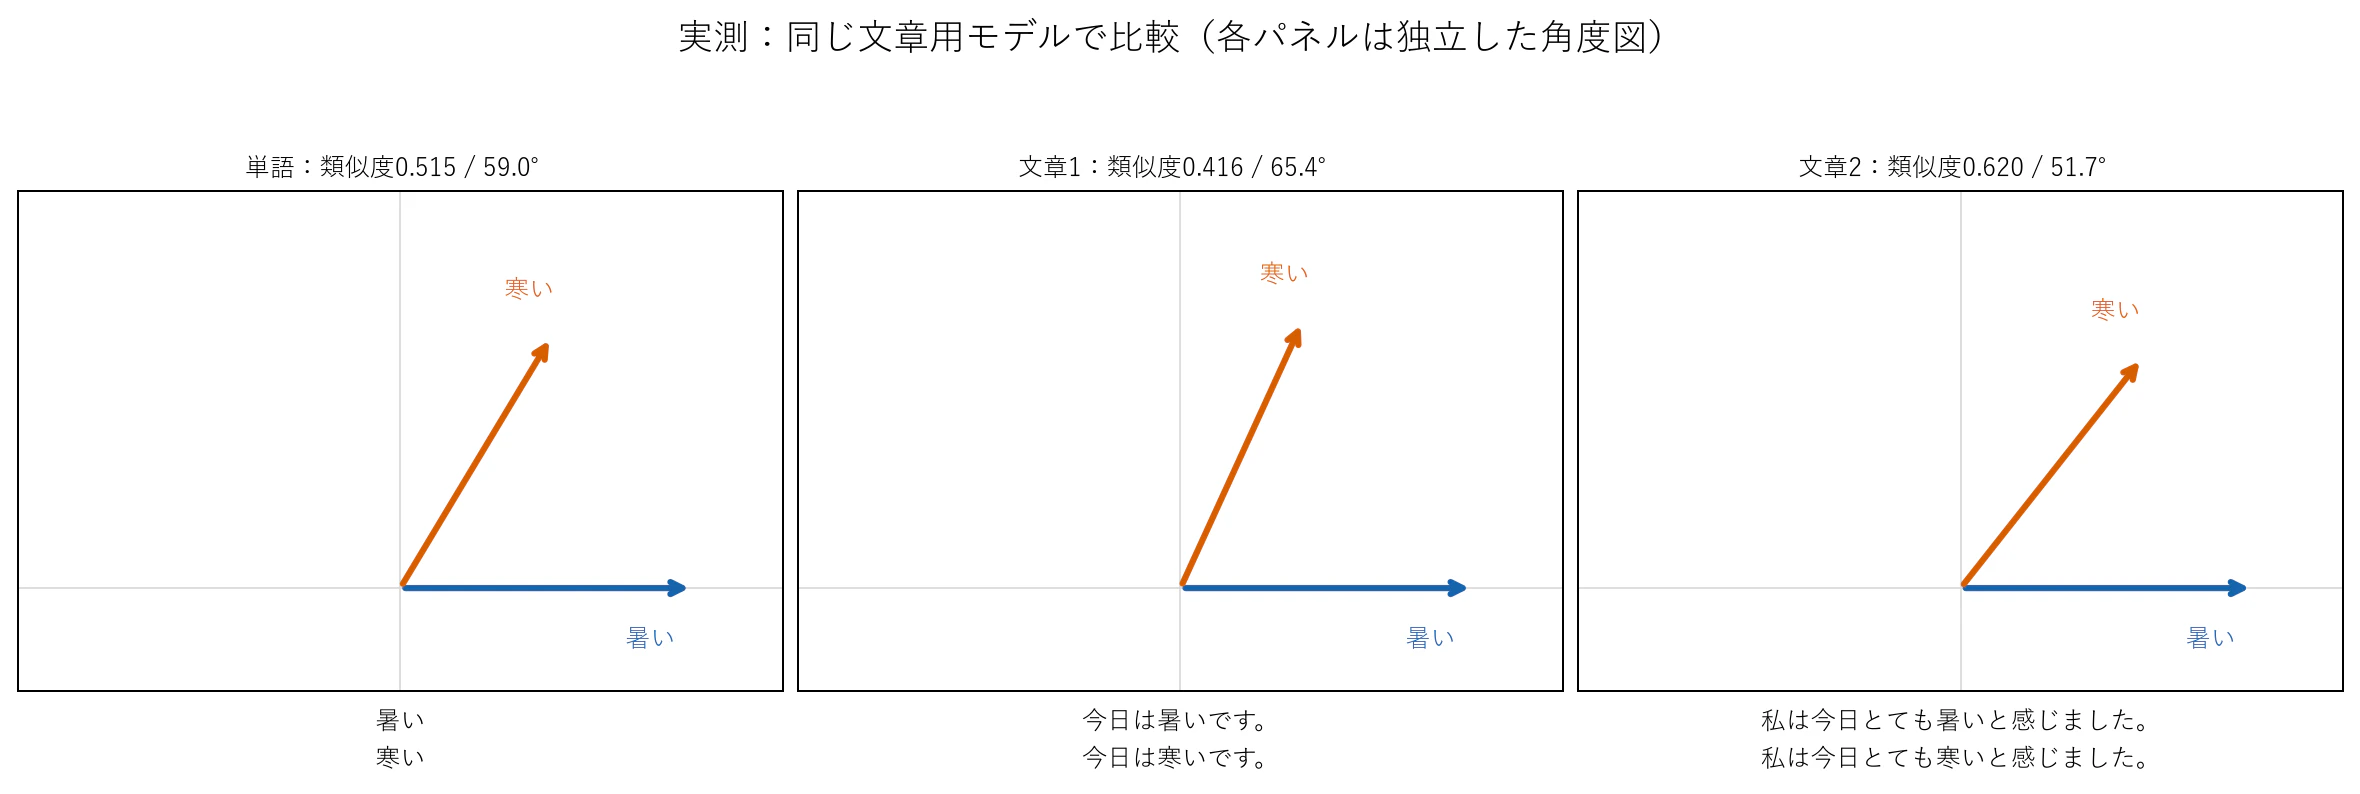
| 「暑い/寒い」を入れる形 | 角度 |
|---|---|
| 単語だけ | 59.0° |
| 今日は〜です。 | 65.4° |
| 私は今日とても〜と感じました。 | 51.7° |
短い文章では角度が広がりましたが、もう一つの文章では狭まっています。「文章にすれば反対方向に近づくはず」と考えても、そう簡単にはいかないようです。
では、全10組ではどうでしょうか。
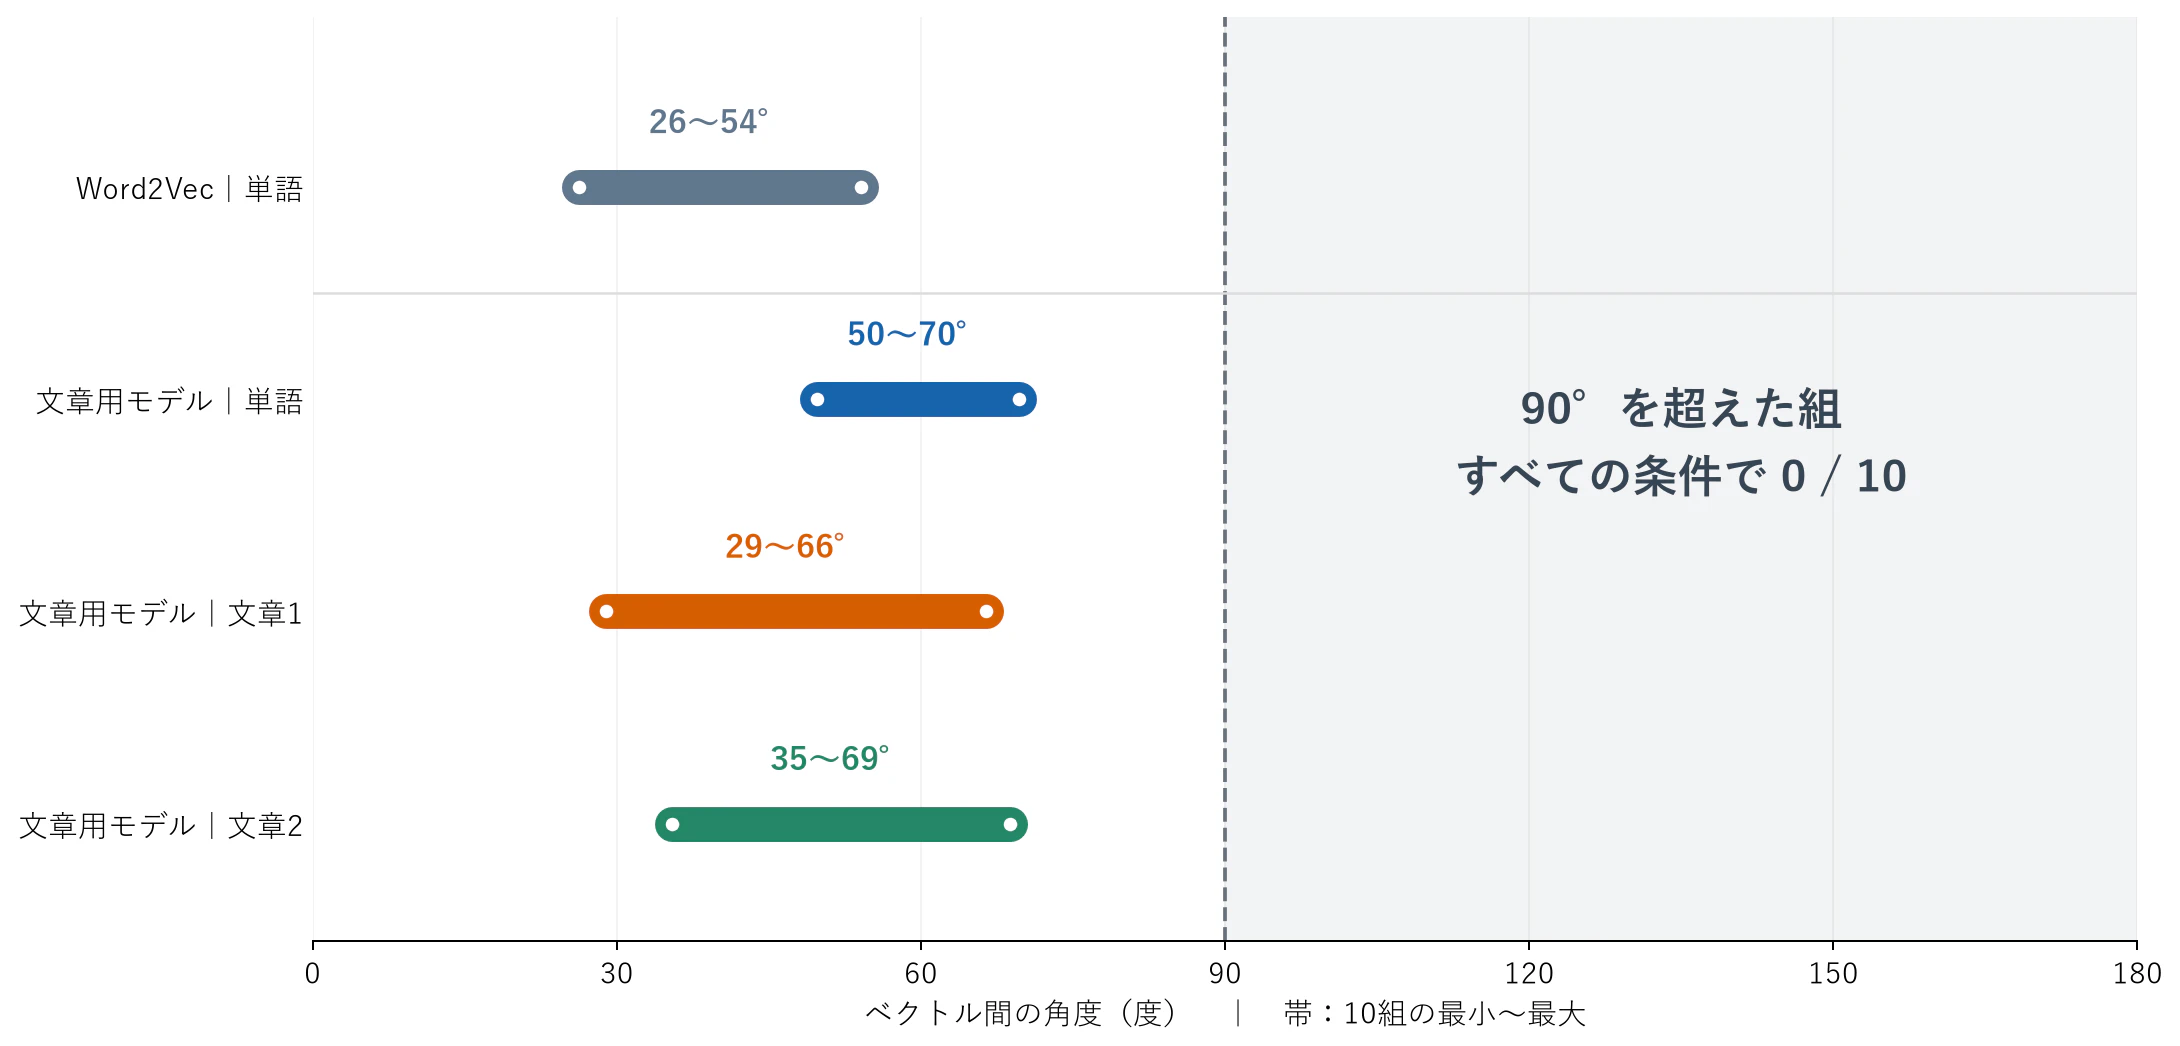
文章1の対義語は約29〜66°、文章2では約35〜69°でした。180°近くになる例はなく、90°を超えた例もありませんでした。
文章1・文章2とも、10組中8組で単語より角度が狭まりました。ただし、広がる組もあります。文章にしたときの変化は、どれも同じというわけではないようです。
なお、「文章1」「文章2」は各組で用意した別々の例文を指しています。全組で同じ文章を使っているわけではありません。
「反対方向ではない」と「違いがない」は別
ここまで見ると、「では、機械には反対の意味が分からないのか?」と思われるかもしれません。ただ、今回測ったのは、あくまで角度です。
追加モデルでは、単語・文章1・文章2のどの条件でも、10組すべてで対義語の方が近い意味の語より離れていました。
例えば「今日は〜です」では、「暑い/暖かい」は約23.9°、「暑い/寒い」は約65.4°です。逆方向ではなくても、比較相手による違いは表れています。
「意味が反対である」ことと、「ベクトルが逆方向である」こと、そして「モデルが対義関係を理解している」ことは、それぞれ別の話です。今回の角度だけで、理解できているかどうかまで答えることはできません。
対義語は同じ話題や場面で使われるから近いのではないか、というのが私の考察です。また、文章では共通する部分が増えた影響も考えられます。ただし、今回は学習データの出現状況を調べたり、これらの影響を切り分けたりしていません。
文書に何を残すかを考えるときに
今回の出発点は、私の「反対の意味なら、ベクトルも逆方向だろう」という感覚でした。しかし、実際に測ってみると、そうはなりませんでした。文章にしても、私の感覚どおりに変わるとは限らないようです。
この違いは、機械に渡す文書を整理するときにも意識しておきたいと思います。
人間が「この二つは似た内容だから、一方を省いてもよさそう」「この言葉は反対の意味だから、検索でも十分離れるだろう」と判断しても、その感覚がベクトル上の関係にそのまま表れるとは限りません。
人間が感じる意味の近さや違いと、機械が計算する近さを、同じものとして扱わない。 文書にどの文や単語を残すか考えるときも、人間が読んだ印象に加えて、実際に使うモデルや検索結果を確かめる姿勢につなげたいです。
もちろん、今回の検証で「この語を残せばよい」という正解が分かったわけではありません。語を削除する実験や、LLMの回答精度の比較も行っていません。
ただ、文書の残し方を考える前に、「機械も私と同じように捉えているはず」と思い込んでいないか、一度立ち止まってみたいと思います。それが、今回の検証から持ち帰りたいことです。
参考資料
-
WikiEntVec:モデルと学習条件 — 使用した単語ベクトルはCC BY-SA 3.0。Masatoshi Suzukiほかによる公開モデル
-
paraphrase-multilingual-MiniLM-L12-v2:モデルカード — 文章用モデル、Apache-2.0
-
Mikolov, Yih, Zweig(2013):Linguistic Regularities in Continuous Space Word Representations — 単語ベクトルと関係の例
-
AWS:RAG(検索拡張生成)とは? — ベクトル検索と回答生成の関係