
読み上げ用に Markdown を剥がす関数を書いたら、user_id が userid になりました。snake_case_name は snakecasename、1_000_000 は 1000000 です。
原因は 3 つあって、どれも「正規表現を当てる順序」と「_ を強調とみなす条件」に集約されます。直した実装と、実際に落ちた入出力を残します。
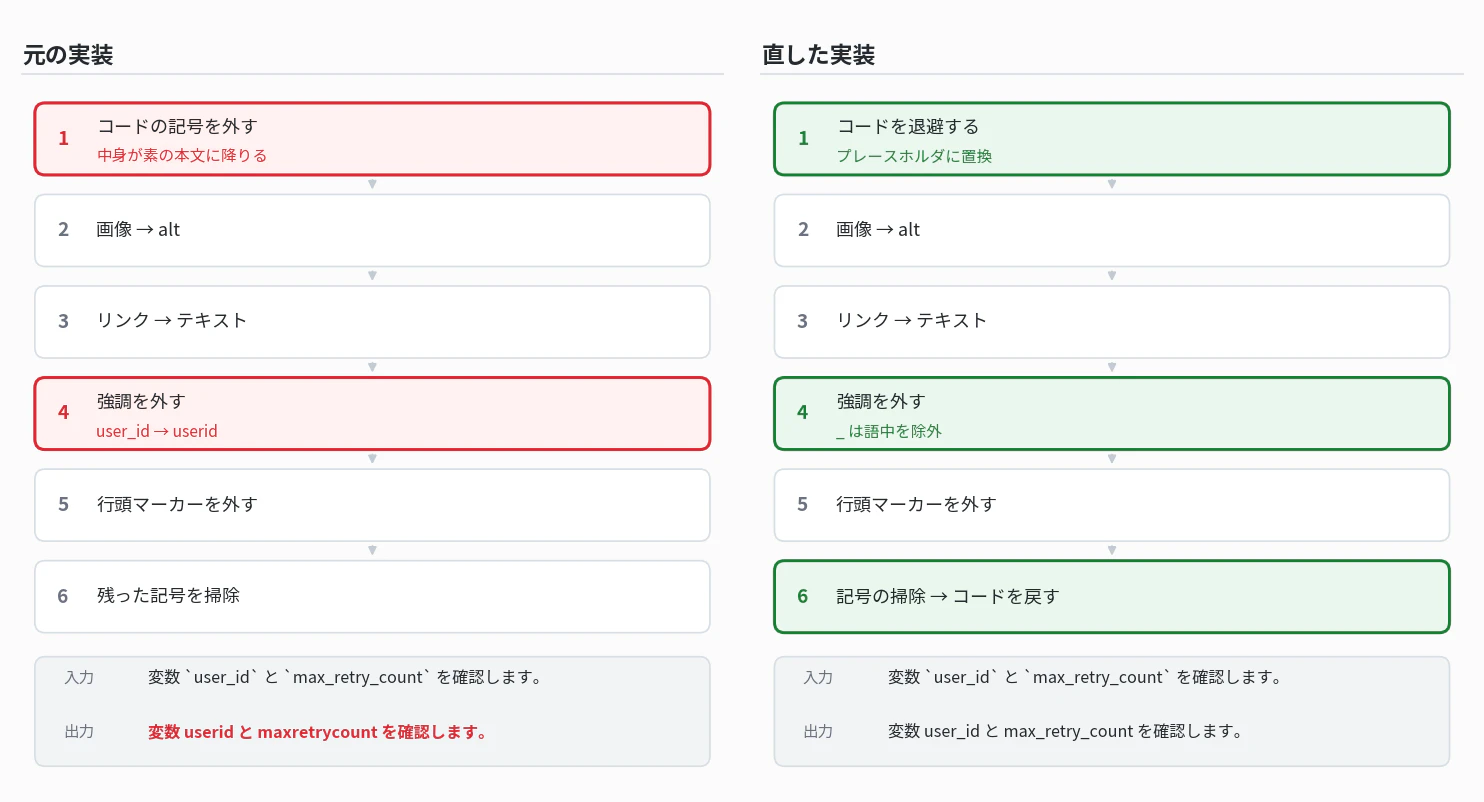
何が起きていたか
TTS に渡す直前のテキストから Markdown の記号を落とす関数です。これが元の実装でした。
export function cleanTextForTTS(input: string): string {
  let text = input;

  // コードブロック ```lang\n...\n``` → 囲みを外し、中身は残す
  text = text.replace(/```[a-zA-Z0-9]*\n?([\s\S]*?)```/g, '$1');
  // インラインコード `code` → code
  text = text.replace(/`([^`]+)`/g, '$1');
  // 画像記法 → alt テキストだけ残す
  text = text.replace(/!\[([^\]]*)\]\([^)]*\)/g, '$1');
  // リンク [text](url) → text
  text = text.replace(/\[([^\]]+)\]\([^)]*\)/g, '$1');
  // 強調 **x** *x* __x__ _x_ → x
  text = text.replace(/(\*\*|__)(.*?)\1/g, '$2');
  text = text.replace(/(\*|_)(?=\S)(.*?)(?<=\S)\1/g, '$2');
  // 見出し・引用・箇条書きの行頭マーカー
  text = text.replace(/^[ \t]*#{1,6}[ \t]+/gm, '');
  text = text.replace(/^[ \t]*>[ \t]?/gm, '');
  text = text.replace(/^[ \t]*[-*+][ \t]+/gm, '');
  text = text.replace(/^[ \t]*\d+\.[ \t]+/gm, '');
  text = text.replace(/^[ \t]*([-*_])\1{2,}[ \t]*$/gm, '');
  // 対にならなかった記号
  text = text.replace(/[*_`#]/g, '');
  text = text.replace(/[ \t]{2,}/g, ' ');
  text = text.replace(/\n{3,}/g, '\n\n');

  return text.trim();
}
記号が読み上げられる問題自体は、これで解消していました。壊れていたのは中身のほうです。
罠 1: コードの記号を外した時点で、中身は「ただの本文」になる
2 行目で `user_id` は user_id になります。ここでやっているのは「バッククォートという記号を消す」ことであって、「user_id という文字列をコードとして保護する」ことではありません。
なので 6 行目の強調の正規表現から見ると、これはもうコードではなく普通の文章です。_ が強調のデリミタとして拾われ、userid になります。
対策は、記号を外すのではなく退避して後で戻すことです。
const CODE_SLOT = '\u0000';
const literals: string[] = [];
const keep = (s: string) => `${CODE_SLOT}${literals.push(s) - 1}${CODE_SLOT}`;

// 中身を取り出し、現場にはプレースホルダだけ残す
text = text.replace(/`([^`\n]+)`/g, (_m, body: string) => keep(body));

// 最後に戻す
text = text.replace(/\u0000(\d+)\u0000/g, (_m, i: string) => literals[Number(i)] ?? '');
プレースホルダには NUL (\u0000) を使っています。LLM の出力にまず現れない文字で、\p{L} にも \p{N} にも属さないため、後段の境界判定を壊しません。
罠 2: _ は語中では強調にならない
snake_case_name と 1_000_000 を壊したのも 6 行目です。
CommonMark では、_ は語中では強調のデリミタになれません(intraword emphasis の禁止)。snake_case_name の _ はどちらも語構成文字に挟まれているので、強調ではありません。* 側にはこの制限がないので、** と * のルールはそのままにし、_ にだけ境界条件を足します。
// * は語中でも強調になる
text = text.replace(/\*\*(?=\S)([^\n]*?\S)\*\*/g, '$1');
text = text.replace(/\*(?=\S)([^*\n]*?\S)\*/g, '$1');

// _ は語中では強調にしない(CommonMark)
text = text.replace(
  /(?<![\p{L}\p{N}])(?<d>__?)(?=\S)(?<body>[^\n]*?\S)\k<d>(?![\p{L}\p{N}])/gu,
  (m, _d, body: string) => body,
);
\p{L} \p{N} を使うので u フラグが要ります。
ただし CommonMark に忠実にすると、今度は __init__ が壊れる
ここで一度つまずきました。__init__ は前後とも空白なので、CommonMark の規則では正しく強調です。剥がすと init になります。Python の dunder は技術文書に頻出するので、これは困ります。
目的を思い出すと、TTS に欲しいのは正しい HTML ではなく読めるテキストです。判断基準は「Markdown として正しいか」ではなく「読み上げが壊れないか」になります。
-
_が消えると、識別子が壊れる -
_が残っても、読み上げではほぼ影響しない
この 2 つは対称ではないので、迷ったら残す側に倒します。
/** 識別子っぽい中身(ASCII の語構成文字だけ)は強調とみなさない */
const IDENTIFIER = /^[A-Za-z0-9]+$/;

(m, _d, body: string) => (IDENTIFIER.test(body) ? m : body)
副作用として _important_ のような英語の強調記法はそのまま残ります。実用上それを消す必要がなかったので、この非対称はそのまま受け入れています。
罠 3: 画像をリンクより先に処理する
画像記法をリンクの正規表現が先に食べると、! だけが残ります。
// 画像 → リンク の順。逆にすると "!" が残る
text = text.replace(/!\[([^\]]*)\]\([^)]*\)/g, '$1');
text = text.replace(/\[([^\]]+)\]\([^)]*\)/g, '$1');
順序を入れ替えるとこうなります。
link-first : "!図1 のとおりです。"
img-first  : "図1 のとおりです。"
元の実装はこの順序を守っていたので、ここは無傷でした。3 つの中で唯一、最初から正しかった箇所です。
直した実装
const CODE_SLOT = '\u0000';

/** 識別子っぽい中身(ASCII の語構成文字だけ)は強調とみなさない */
const IDENTIFIER = /^[A-Za-z0-9]+$/;

export function cleanTextForTTS(input: string): string {
  const literals: string[] = [];
  const keep = (s: string) => `${CODE_SLOT}${literals.push(s) - 1}${CODE_SLOT}`;

  let text = input;

  // 1) コードを退避する。中身は読み上げるが、記号には触らない
  text = text.replace(/```[^\n]*\n([\s\S]*?)```/g, (_m, body: string) => keep(body.trim()));
  text = text.replace(/`([^`\n]+)`/g, (_m, body: string) => keep(body));

  // 2) 画像 → リンク の順。逆にすると "!" が残る
  text = text.replace(/!\[([^\]]*)\]\([^)]*\)/g, '$1');
  text = text.replace(/\[([^\]]+)\]\([^)]*\)/g, '$1');

  // 3) 強調。* は語中でも強調になる
  text = text.replace(/\*\*(?=\S)([^\n]*?\S)\*\*/g, '$1');
  text = text.replace(/\*(?=\S)([^*\n]*?\S)\*/g, '$1');

  // 3') 強調。_ は語中では強調にならない(CommonMark)。さらに識別子は触らない
  text = text.replace(
    /(?<![\p{L}\p{N}])(?<d>__?)(?=\S)(?<body>[^\n]*?\S)\k<d>(?![\p{L}\p{N}])/gu,
    (m, _d, body: string) => (IDENTIFIER.test(body) ? m : body),
  );

  // 4) 行頭マーカー
  text = text.replace(/^[ \t]*#{1,6}[ \t]+/gm, '');
  text = text.replace(/^[ \t]*>[ \t]?/gm, '');
  text = text.replace(/^[ \t]*[-*+][ \t]+/gm, '');
  text = text.replace(/^[ \t]*\d+\.[ \t]+/gm, '');
  text = text.replace(/^[ \t]*([-*_])\1{2,}[ \t]*$/gm, '');

  // 5) 対にならなかった記号の掃除
  text = text.replace(/[*`#]/g, '');

  // 6) 退避したコードを戻す
  text = text.replace(/\u0000(\d+)\u0000/g, (_m, i: string) => literals[Number(i)] ?? '');

  return text
    .replace(/[ \t]{2,}/g, ' ')
    .replace(/\n{3,}/g, '\n\n')
    .trim();
}
検証
同じ入力を両方に通した結果です。
| 入力 | 元の実装 | 直した実装 |
|---|---|---|
変数 user_id と max_retry_count を確認します。 |
変数 userid と maxretrycount を確認します。 | 変数 user_id と max_retry_count を確認します。 |
| この関数は snake_case_name を使います。 | この関数は snakecasename を使います。 | この関数は snake_case_name を使います。 |
| コストは 1_000_000 円です。 | コストは 1000000 円です。 | コストは 1_000_000 円です。 |
重要: a_b と c_d を混ぜないでください。 |
重要: ab と cd を混ぜないでください。 | 重要: a_b と c_d を混ぜないでください。 |
| Python の init を呼びます。 | Python の init を呼びます。 | Python の init を呼びます。 |
| これは 強調 です。 | これは 強調 です。 | これは 強調 です。 |
コードブロックと、対にならないバッククォートも見ておきます。
入力: "```ts\nconst x = a_b_c;\n```\nです。"
元の実装  : "const x = abc;\n\nです。"
直した実装: "const x = a_b_c;\nです。"

入力: "対にならない ` バッククォート"
元の実装  : "対にならない バッククォート"
直した実装: "対にならない バッククォート"
最後のケースは 5 行目の記号掃除が受け止めています。ストリーミングの途中出力では、対になっていないバッククォートが実際に来ます。
割り切ったこと
- 正規表現を 1 パスずつ当てているので、ネストした強調などは厳密には追えません。Markdown としての正しさには上限があります。
- 厳密さが要るなら、remark で AST を引いて
mdast-util-to-stringでテキストを取り出すほうが正しいです。コードスパンはinlineCodeノードとして取れるので、識別子が壊れる問題自体が起きません。 - それでも正規表現版を使っているのは、ここが読み上げのホットパスだからです。合成の直前にパーサをもう 1 つ挟む価値が、この用途では見合いませんでした。依存を増やさず 1 関数で完結することを優先しています。
この関数は、筆者が関わっている面接練習AI(AceRound)の読み上げ経路で保守しています。質問文に Markdown が混ざるのは LLM に生成させている以上避けられないので、合成の直前に 1 回通します。
まとめ
- コードは「記号を外す」のではなく「退避して戻す」。外した瞬間、中身は後段の正規表現から見てただの本文になる
-
_は語中では強調にしない(CommonMark)。ただしそれだけだと__init__が壊れるので、識別子っぽい中身には触らない - 画像 → リンク の順。逆にすると
!が残る
正規表現での Markdown 除去は、順序を 1 つ間違えると「記号が残る」のではなく「中身が消える」のが厄介でした。読み上げのように多少ノイズが残っても成立する用途では、消しすぎない側に倒すほうが安全です。