
はじめに
日頃は製造業で営業の仕事をしています。毎月求められる売上予測が難しく、売上分析も十分にできないため自身のスキル向上のため、データ分析が出来るようになりたいと思い、データ分析の勉強を6カ月かけて受講することにしました。集積したデータからどのような事が言えるのか分析手法を試行錯誤しながら日々勉強している記録です。
本記事の概要
Kaggleの中から顧客の購買行動をシミュレートするために設計されたデータを用いて、売上を予測する機械学習モデルをPythonを使って構築しました。
Pythonの分析モデルを駆使できるようにすることが今後の分析にも活きてくるので、様々な分析手法を用いてどのモデルの精度がよいのかを検証しました。
このデータセットは、顧客層、購入の詳細、ロイヤルティプログラムへの参加、取引結果に関する詳細な情報が含まれています。
【使用したデータ】https://www.kaggle.com/datasets/noeyislearning/sales-simulation/data
データの概要
このデータに以下の項目があります。
・顧客の人口統計:年齢、性別、国(フィリピン)、連絡先情報が含まれています。
・購入の詳細:製品カテゴリ、購入媒体、注文ID、取引日。
・ロイヤリティプログラム:参加ステータス、ロイヤリティ階層、階層ベースの割引率。
・割引と支払い:割引の合計、支払い方法、最終的な購入金額。
・顧客体験:各取引における顧客体験の評価。
・大規模なデータセット
【実行環境】
Google Colaboratory
Python:3.12.12
Pythonによるデータ準備
- データの読み込み
Google Colab上で files.upload() を用いてローカルPCからCSVファイルをアップロードし、
pandasを用いてデータを読み込みます。

必要なライブラリをインポートします。

データの読み込み

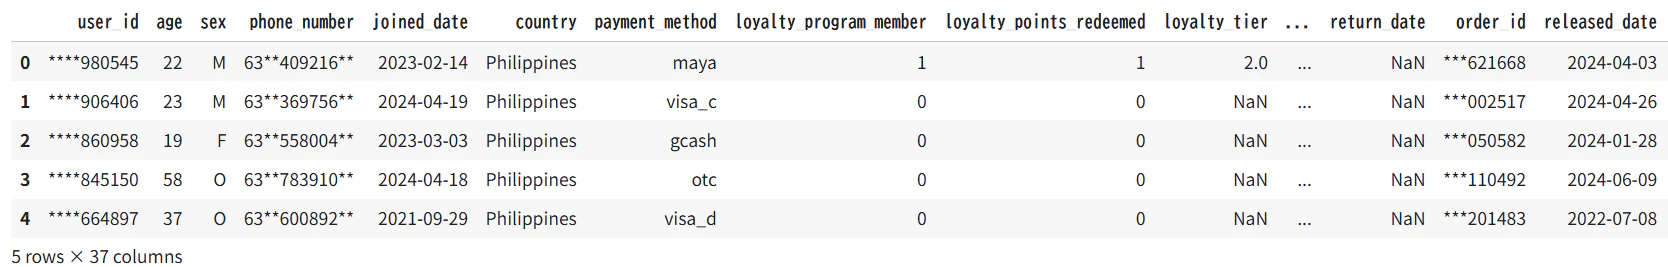
CSVデータが確実に読み込まれているか確認します。
データの基本出力
データの概要(最初・最後の行、データ型、統計量、列名)を確認します。

本データは購買単位で整理されており、分析および機械学習に利用可能な形式であることが確認できた。
また、基本統計量からは著しい外れ値は見られず、前処理後にモデル学習へ進めると判断した。
欠損値チェック

欠損の有無と場所を可視化します。
以下のように欠損が集中しているカラムがはっきりと分かります。
ただし今回は値が存在しないという意味で自然な欠損のため、クリーニングがほぼ不要なデータセット。

重複行チェック

重複した購買データは存在せず、データの一意性は保たれていると判断できる。
欠損値については、機械学習モデル構築時に補完処理を行うことで対応可能であるため、データの利用に大きな支障はないと判断した。
数値データの相関分析
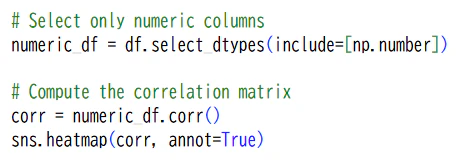

【相関からの考察】
◆ 割引関連の指標同士に強い相関があります。
これらの値同士で0.7〜0.9程度の高い相関が見られます。
tier_discount_percentage
card_discount_percentage
coupon_discount_percentage
total_discount_percentage
◆ 割引率が高いほど、購入金額は下がる(負の相関)
total_discount_percentage と
total_purchase_after_discount に 負の相関(-0.3〜-0.5) が見られます。
過度なディスカウントが必ずしも収益に結びついていない可能性が考えられます。
売上予測
ここから売上に影響を与える要因を特定して予測モデルを構築します。
① 月次売上の時系列予測(Auto-ARIMA)
→ 「いつ売上がどれくらいになるか」を予測します。
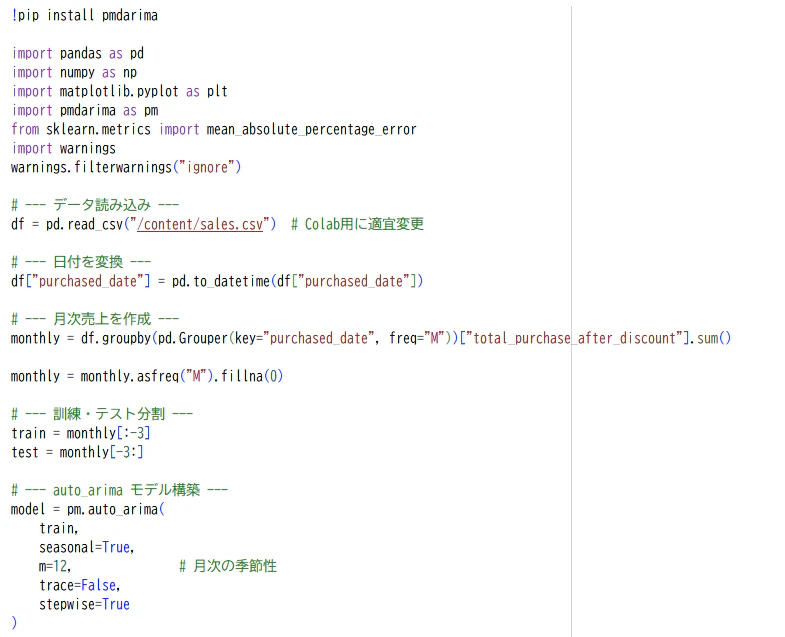

【評価】
以下のグラフが示されました。

・考察
売上データは長期的に右肩上がりで推移しており、特に直近では大きな成長が確認された。一方、Auto_ARIMA による予測は基礎的なトレンドを的確に捉えているものの、急増した実績値には追従しきれていない。MAPE は 17.25% と実務上許容できる範囲ではあるが、高成長局面に入った直近データでは予測誤差が大きくなっている。
次に別の観点からも売上予測を行なってみた。
② 特徴量を用いた売上予測(XGBoost回帰)
結論から言うと以下のような値になりました。
MAPE: 152.62 %
・考察
平均で約2倍のズレがあるというレベルでした。152%は完全に失敗です。
考えられる理由としては以下かと推測します。
理由① 今使っている特徴量が売上金額を説明できていない
売上金額(total_purchase_after_discount)に最も効くのは:
商品単価(price)
購入数量(qty)
ですが、今回使った特徴量にはprice / qty が存在しないため
モデルが金額を当てられるはずがない。
理由② 特徴量に“金額に直結する情報”がない
今使っている特徴量(年齢・割引率・配送日数など)は、
「商品そのものの価格を決める情報」を持っていません。
そのため、モデルは金額を正確に予測するための材料が足りず、
誤差(MAPE)が大きくなってしまいました。
初心者による売上予測の総括
今回、ARIMA モデルと XGBoost を用いて売上予測を実施した結果、
両モデルの精度や傾向に大きな差が生まれた。
これは、単にモデルの違いだけではなく、
扱っているデータの性質そのものが根本的に異なることが原因である。
まず、ARIMA は「時系列の売上推移」を用いて予測するため、
月ごとの売上合計やトレンド・季節性といった
時間軸に規則性があるデータに対しては一定の精度が期待できる。
一方で XGBoost は、顧客属性や割引率、配送日数、購入チャネルなど、
個々の注文データを入力として、
“1回の注文金額” を直接予測するモデルである。
しかし今回の特徴量には、
「商品そのものの価格」を判断するための情報が含まれておらず、
金額に直結する要素が欠けていた。
つまりモデルに、金額を正しく当てるための材料が十分に与えられていなかった。
このため、XGBoost の誤差は大きくなり、
ARIMA とは全く異なる結果となった。
以上より、
ARIMA と XGBoost の予測精度の差は “モデルの優劣” ではなく、
それぞれが使用しているデータ構造・目的が全く違うことに起因する。
今後精度をさらに高めるためには、
XGBoost には「商品単価」「数量」など価格に直結する特徴量の追加
ARIMA にはより長期の時系列データ・外部要因の組み込み
両モデルの役割を明確に分けて使う(例:ARIMA=全体予測、XGBoost=注文単位の予測)
といった対策が必要である。
今回データ分析を実施してどの分析がフィットするか分からない状態だったため、
四苦八苦しましたが、どのようなデータに仕上げていくとキレイな予測になるか、
やってみて理解できたのが収穫でした。
最後まで読んでいただきありがとうございました。