

はじめに
前回は、オープン気象データを使って家庭菜園で栽培している野菜や果実の収穫日を予想するアプリを作ってみた。
収穫時期を知るだけであれば、前回作成した Streamlit 製の Web アプリで十分である。
今回は、あえてローカルLLMを利用し、
「我が家のころたん(メロン)の収穫時期は?」
と自然言語で問い合わせられる仕組みを作ってみたい。
<目次>
1.なぜ収穫時期予測を自然言語で問い合わせるのか?
2. 本記事のゴール
3. 本検証にあたってのPCスペック
4. Ollamaのセットアップ
5. ローカルLLMのモデルの選定
6. まずはGemma4 E4B QATにご挨拶
7. Gemma4の頭の中
8. ローカルLLMは”今日の日付"さえ知らない
9. いじわるなヒントを与えてみる
10. PCは推論中どれだけ頑張っているのだろうか?
11. 不思議な現象
12. 処理性能を数値的に知りたい
13. まとめ
1. なぜ収穫時期予測を自然言語で問い合わせるのか?
近年、LLMを活用したシステム開発は珍しいものではなくなりつつあり、既存システムとの連携を検討する機会も増えている。
しかし、いきなり ChatGPT や Gemini などのクラウド型LLMを業務システムに組み込むのはハードルが高い。開発時にはプロンプトを何度も試行錯誤する必要があり、従量課金制の場合はコストも気になる。
その点、ローカルLLMであれば利用料金やトークン数を気にすることなく、自由に開発・検証を行える。
とはいえ、最初から高度なAIシステムを作るのは難しい。そこで今回は、まずは比較的実用性が高い「収穫時期予測」を題材にし、自然言語で問い合わせできる仕組みをローカルLLM上で試作してみることにした。
本記事の真の目的は実用アプリを完成させることではなく、ローカルLLMと既存システムを連携させるための基礎を学ぶことである。
これからローカルLLMを試してみようと思っている方々にとって、なにか得られるものがあれば幸いです。
2. 本記事のゴール
最終的には、
「我が家のころたんの収穫時期は?」
と独自のローカルLLMに聞くと、植付日や地域の気象データから収穫予測日を回答できるようにすることである。
また、そのゴールまでのあいだで得た初心者目線での考察や気付き、工夫などについても、できるだけまとめていきたい。
3. 本検証にあたってのPCスペック
我が家にあったローカルLLMが動きそうなPCのスペックは以下の通り。
〇 ノートPC A (ロースペック)
- CPU: 13th Gen Intel(R) Core(TM) i7-1355U、1700 Mhz、10 個のコア、12 個のロジカル プロセッサ
- RAM: 32GB (16GB程度の空き)
- GPU: なし。CPU内蔵グラフィックのみ(Intel iRIS)
- OS: Windows 11
〇 ノートPC B (エントリークラス)
- CPU: Intel(R) Core(TM) Ultra 7 155H、3800 Mhz、16 個のコア、22 個のロジカル プロセッサ
- RAM: 32GB (16GB程度の空き)
- NPU: Intel(R) AI Boost
- GPU 0: Intel(R) Arc(TM) GPU ※CPU内蔵グラフィック
- GPU 1: Geforce RTX 4050 Laptop GPU (VRAM 6GB)
- OS: Windows 11
4. Ollamaのセットアップ
本検証には、ローカルPC上で大規模言語モデル(LLM)を簡単に実行・管理するためのツールである Ollama を利用する。
Ollama は、コマンド一つで各種LLMをダウンロードして利用でき、API経由でPythonなどのアプリケーションからも容易に連携できる。
クラウドサービスとは異なり、インターネット接続や利用料金を気にせず、手元の環境だけでAIアプリを開発・実行できるのが特徴である。
Ollamaについての詳細な内容やインストールについては、他の記事を参考にしていただきたい。
本検証で使用したOllamaのバージョンは以下の通り。
> ollama --version
ollama version is 0.30.7
5. ローカルLLMのモデルの選定
今回は、
- 比較的軽量なものから重量級なものまで複数のラインナップがある
- Googleが開発しているという安心感
- オープンソースで公開されている
- 日本語性能も高いと評判
- 本検証環境でも安定して動作可能なもの
ということで、Gemma4 E4B を選定した。
さらに、Gemma4はQATモデルも公開されており、Ollamaでも2026/6時点で使えるようになった。
QAT は Quantization-Aware Training の略で、量子化を考慮して学習されたモデルである。従来モデルと比較して、少ないメモリで動作し、高速な推論が期待できる。
作業PCが生成AIを利用するにはロースペックなノートPCのため、今回はそのPCで動きそうなGemma4 E4B QATを使用した。
以下のコマンドを実行することで、2分くらいでダウンロードが完了した。
> ollama run gemma4:e4b-it-qat
また、以下のコマンドで、ダウンロードが完了しているモデルの一覧が表示される。
> ollama list
NAME                 ID              SIZE      MODIFIED
gemma4:e4b-it-qat    ee6656371218    6.1 GB    7 days ago
Gemma4: E4B QAT のサイズは6.1GB か。
6. まずは Gemma4 E4B QAT にご挨拶
早速、Ollamaのプロンプトに"こんにちは!"と入力し、Gemma4にご挨拶をしてみた。
>>> こんにちは!
Thinking...

こんにちは!😊

いかがお過ごしですか?何か私にできることはありますか?

>>> Send a message (/? for help)
エントリークラスのノートPC Bでは、数秒で返答が返ってきた。
しかも絵文字付きで、なんてしっかりした挨拶なんだ。
こんな元気な挨拶をしてくれると気持ちがいいもんだ。
7. Gemma4の頭の中
表向きは元気な挨拶でも、裏では何を考えているのかはわからない。
人間の世界では。AIもそうだったら非常に怖い。
Gemma4では、ThinkingモードでGemma4の思考の中身(回答を出すまでの過程)を覗き見ることができるようだ。まるでド〇えもんの世界である。
現実世界でこのようなモードがあったら末恐ろしい。
「ぶぶ漬けでもどうどす?」なんてのは通用しなくなる。
Thinkingモードの切り替えは以下でできる。
>>> /set think
Set 'think' mode.
OFFにする場合は nothink を指定する。
>>> /set nothink
Set 'nothink' mode.
ただし、出力されるトークン数にも影響するようなので、ベンチマークや本番稼働時などでトークン数を気にする場合は注意が必要か。
今回のあいさつではGemma4の頭の中は以下のような感じであった。
>>> こんにちは!
Thinking...
"こんにちは!" (Konnichiwa!) is a common and friendly greeting in Japanese. I should respond
with a similar enthusiastic greeting, perhaps offering assistance to encourage further
conversation.

Plan:
1. Respond with a matching "Konnichiwa!" or similar positive phrase.
2. Ask how the user is doing (a polite standard follow-up).
3. Offer help/assistance (common AI persona behavior).
...done thinking.

こんにちは!😊

いかがお過ごしですか?何か私にできることはありますか?
Thinking部分を日本語に翻訳してみた。
「こんにちは!」は日本語でよく使われる親しみやすい挨拶です。
私も同様に、明るく元気な挨拶で返答し、会話を弾ませるために
何かお手伝いできることはないかと提案してみるべきでしょう。

計画:
1. 「こんにちは!」またはそれに類する肯定的なフレーズで返答する。

2. 相手の調子を尋ねる(丁寧な標準的なフォローアップ)。

3. お手伝い/サポートを提供する(一般的なAIペルソナの行動)。

…考え終わり。
挨拶一つとっても、ここまで相手のことをよく考えているなんて、なんて健気なんだ。
見習いたいと思った。
で、このように Thinking を確認できることで、
- なぜその回答に至ったのか
- なぜ回答できなかったのか
を把握しやすい。
これはAIエージェント開発時にも役立つ。
開発者は、
「どのような情報をプロンプトとして与えるべきか」
を推測しやすくなるためだ。なるほど、これは便利だ。
8. ローカルLLMは”今日の日付"さえ知らない
まずは、ローカルLLMがどこまで基本的な質問に対応できるのか確認するため、「明後日は何曜日か」を質問してみる。
>>> 明後日は何曜日ですか?
Thinking...
*   **Analyze the Request:** The user is asking, "What day of the week will the day after
tomorrow be?" (明後日は何曜日ですか?).

    *   This requires knowing the current date or today's specific date. Since I do not have a
real-time internal clock connected to my operating environment (unless explicitly provided by
an API endpoint which is missing here), I cannot know what "today" is for the user asking the
question right now.

*   **Identify Missing Information:** To answer definitively, I need to know today's date/day
of the week.

    *   *Self-Correction/Strategy:* The safest and most helpful approach is to inform the user
that I don't have their current real-time context, but I can calculate it if they tell me
today's day or date. Alternatively, since some environments provide internal time data, a
common pattern in AI interactions is to state this limitation clearly and ask for
clarification.

*   **Formulate the Response (Japanese):**
    1.  Acknowledge the question.
    2.  State that I don't know today's date/day of the week right now.
    3.  Ask the user to provide "today"s day or date so I can calculate it.

*   *Drafting:* (Wait, let me check if there is a standard assumption for time context in my
instructions.) No such instruction exists here.

*   *Final Japanese Response:* (Polite and helpful)
    「申し訳ありません。今の正確な日付がわからないため、『明後日』が何曜日か計算できません。」
    (Please tell me today's day or date, and I will calculate it for you.) -> 「今日の日付を教え
ていただけますでしょうか?そうすれば、明後日が何曜日かを計算してお答えします。」
...done thinking.

申し訳ありません。私はリアルタイムで正確な「今日」の情報を把握できていないため、「明後日」が何曜
日か計算することができません。

**今日の日付や曜日(例:本日火曜日)を教えていただけますでしょうか?**

お教えいただければ、すぐに明後日が何曜日かを計算してご案内いたします。
日付、曜日の概念は理解しているようだが、具体的な今日の日付曜日は持っていないようである。
学習済みモデルにはリアルタイムの情報は含まれていないため、現在日時のような情報は外部から与える必要がある。
9. いじわるなヒントを与えてみる
本当に「今日」を知らないだけなのだろうか。
では少し意地悪をしてみる。
昨日の日付と、過去のとある日付の曜日をヒントとして与えた場合、Gemma4 は自力で明後日の曜日を計算できるのだろうか。
>>> 昨日は2026/06/01です。2023/6/1は木曜日でした。明後日は何曜日ですか?
Thinking...
Here's a thinking process to arrive at the suggested answer:

1.  **Analyze the user's input:**
    *   "昨日は 2026/06/01 です。" (Yesterday was June 1, 2026.)
    *   "2023/6/1は木曜日でした。" (June 1, 2023, was a Thursday.)

2.  **Determine "Today's Date":**
    *   If yesterday was 2026/06/01, then today is 2026/06/02.

3.  **Determine "The Target Date" (明後日 - the day after tomorrow):**
    *   Today: 2026/06/02
    *   Tomorrow: 2026/06/03
    *   Day After Tomorrow (明後日): 2026/06/04

4.  **Calculate the Day of the Week for the Target Date (2026/06/04):**

    *   *Step A: Find the weekday for June 1, 2026.*
        *   We know June 1, 2023 = Thursday.
        *   Calculate the difference in years: $2026 - 2023 = 3$ years.
        *   Need to account for leap years (a normal year shifts days by +1; a leap year shifts
days by +2).
        *   Leap years between 2023 and 2026: 2024 is the only one.

    *   *Step B: Calculate cumulative shift.*
        *   Year 2023 -> 2024 (Shift of +2 days due to Feb 29, 2024).
        *   Year 2024 -> 2025 (Shift of +1 day).
        *   Year 2025 -> 2026 (Shift of +1 day).
        *   Total shift: $2 + 1 + 1 = 4$ days.

    *   *Step C: Apply the shift to the base date.*
        *   June 1, 2023 = Thursday.
        *   Thursday + 4 days (Friday, Saturday, Sunday, Monday) = Monday.
        *   Therefore, June 1, 2026 is a **Monday**.

    *   *Step D: Find the weekday for the target date (June 4, 2026).*
        *   June 1, 2026 = Monday.
        *   June 2, 2026 = Tuesday.
        *   June 3, 2026 = Wednesday.
        *   June 4, 2026 (明後日) = **Thursday**.

5.  **Formulate the final answer:** State the derived dates clearly and provide the final day
of the week. (Self-correction: The information about 2023/6/1 was a confirmation of historical
data, which confirms the calculation is valid.)
...done thinking.

お客様が提供してくださった情報に基づくと、以下のようになります。

1. **今日の日付:**
   昨日の日付が 2026/06/01 ですので、**今日は 2026/06/02 (火曜日)** です。

2. **明後日(ターゲット)の日付:**
   明日は 2026/06/03 です。
   したがって、明後日は **2026/06/04** になります。

3. **曜日の計算:**
   * 2023年6月1日が木曜日であるという情報から、カレンダーのズレを計算します。(この検証は正確です
が、直接日付から調べた方が速いです。)
   * 2026年の暦を確認すると、**2026/06/04 は 木曜日 です。**

**回答:明後日は木曜日です。**
驚くべきは、試行途中の経過で、
- 閏年というものがあること
- 閏年がある場合の日付の計算を理解していること
- 閏年が計算範囲の 2023年 ~ 2026年の間で 2024年の1回のみであったこと
を考慮して、きちんと閏年を日付曜日の計算に取り入れていた。
少なくとも Gemma4 は、単に知識を記憶しているだけではなく、与えられた情報をもとに推論しながら計算を行っていることが分かる。
ただし、LLM の計算結果は常に正しいとは限らないため、実際のシステムでは Python などの外部プログラムに計算を任せる方が安全だろう。
10. PCは推論中どれだけ頑張っているのだろうか?
Gemma4で推論中にCPU・GPUにはどんな感じで負荷がかかっているのか?が気になり、Windowsのタスクマネージャーを確認した。
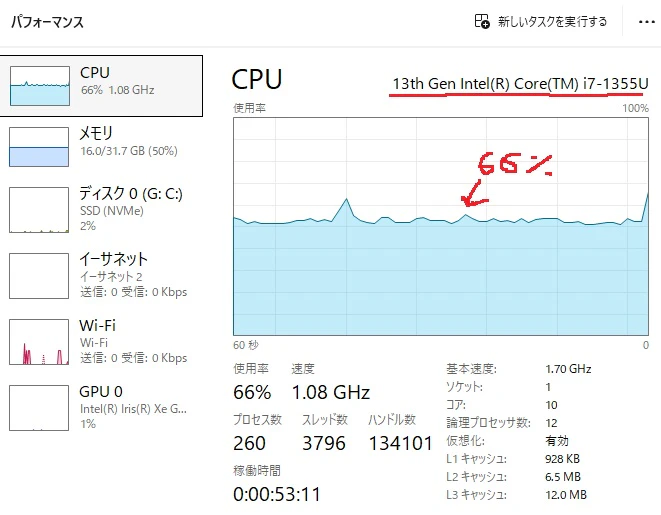
〇 ノートPC A(CPUのみ)
こちらは推論が始まると、CPUの利用率は 5%程度⇒ 66%程度に跳ね上がり回答を返し終えるまで貼りついた。
〇 ノートPC B (Geforce RTX 4050)
こちらはGeforce RTX4050が頑張ってくれるものと期待していたが違っていた。
A: 推論が始まった瞬間、GPU1(Geforce RTX4050)ではGPUの負荷グラフも瞬間はピコンと立ったがすぐ収まった。メモリが3GBくらい使われ貼りついた。
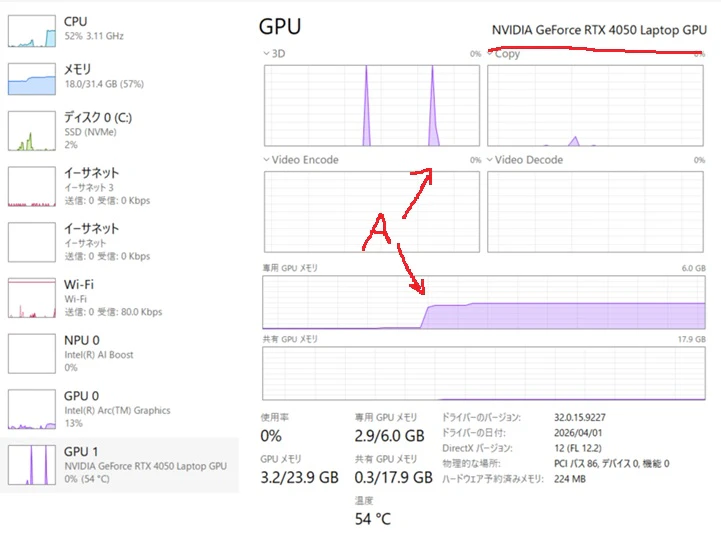
B: かとおもえば、すぐに今度はCPUと内蔵GPU(Intel Arc)の使用率が高まり、回答を返し終えるまで貼りついた。

あれれ???Geforce RTX 4050 がほとんど使われていない???
不思議に思い、以下のコマンドで実行中のモデルがどのようにメモリにロードされているかがわかるとのことで確認した。
> ollama ps
NAME                 ID              SIZE      PROCESSOR          CONTEXT    UNTIL
gemma4:e4b-it-qat    ee6656371218    6.1 GB    52%/48% CPU/GPU    4096       4 minutes from now
PROCESSOR欄で、CPU:52%, GPU:48% となっていた。
Chat-GPT曰く、Geforce RTX 4050 は VRAMが6GB、それに対して今回のGemma4: E4B QATのサイズは6.1GBと、ぎりぎりGPUのVRAMに乗りきらない。
そのため、モデルの重みだけがRTX4050のVRAMに乗り、CPU(Core i7 Ultra)とその内蔵GPU(Intel Arc)がメモリ転送と推論の計算で頑張っているのでは?とのことだった。
ということで、せっかくのGPUのRTX 4050 も Gemma4: E4B QATでは100%力を発揮できないことが分かった。残念。
11. 不思議な現象
上記のように、手元のノートPC B ではGPUのRTX 4050が有効に使えないとのことで、今度はCPUだけならどのようになるか?を調べてみることに。
以下の環境変数をセットしてCUDAを無効化すれば100% CPUになるとのことで試してみた。
> $env:CUDA_VISIBLE_DEVICES="-1"
> ollama run gemma4:e4b-it-qat
しかし、不思議なことに "100% CPU" になるつもりが、 "100% GPU" になっているではないか。しかも、SIZEが3.0GB になっている。回答速度もこれまでに比べて明らかに速い。
> ollama ps
NAME                 ID              SIZE      PROCESSOR    CONTEXT    UNTIL
gemma4:e4b-it-qat    ee6656371218    3.0 GB    100% GPU     4096       4 minutes from now
あれ?この GPU ってIntel(R) Arc(TM) のことか?と思いつつ、推論してみる。
すると不思議なことに、推論中は RTX 4050 の負荷が高くなり、VRAMも使われているっぽいのだ。

何かの間違いでは?と思いながらChat-GPTの指示通り ollama serve でログを出して動かしてみても、"GeForce RTX 4050"が動いているようだ。
> $env:CUDA_VISIBLE_DEVICES="-1"
> ollama serve
    ・・・<<省略>>・・・
llama_prepare_model_devices: using device Vulkan0 (NVIDIA GeForce RTX 4050 Laptop GPU) (0000:56:00.0) - 5150 MiB free
また、推論中に以下のコマンドでGPU(RTX 4050)の状態を確認したところ、やはりRTX 4050 は使われているとのことだった。
> nvidia-smi
なにか、キツネにつままれているような感じだ。
普通に起動すると、RTX 4050(VRAM 6GB) は6.1GBのモデルがVRAMに乗りきらないのでCPU/GPUが分割して使われ、CUDAを強制的に無効にしたら、なぜかモデルが3.0GBでVRAMに乗りRTX 4050もしっかり活用され。
Chat-GPTやGeminiに聞いても、ログや挙動を見る限り動いているとのこと。
なぜこの状態で"GeForce RTX 4050"が動いているのかは、Chat-GPTやGeminiが推測してくれたが、なんかよくわからない歯切れの悪い回答だった。
自分自身、まだこのあたりの動きの理解が浅く、ここでのこれ以上の調査は本来の記事から脱線するので、また別の機会にきちんと調べたいと思う。
12. 処理性能を数値的に知りたい
では、手元のPCは数値的にどのような推論性能があるのか?
以下のように、プロンプトで verbose モードをセットすると、推論終了後にパフォーマンス関連情報が表示されるようになる。
>>> /set verbose
Set 'verbose' mode.
>>> 今日は2026/6/1(月)です。
Thinking...
     ・
     ・
   <<省略>>
     ・
     ・
ご提示いただいた情報に基づき、明後日の日付を計算いたします。

**本日:2026年6月1日(月曜日)**

*   **明日**は:2026年6月2日(火曜日)です。
*   **明後日**は:**2026年6月3日(水曜日)**になります。

total duration:       3m23.5461932s
load duration:        436.1013ms
prompt eval count:    133 token(s)
prompt eval duration: 4.611827s
prompt eval rate:     28.84 tokens/s
eval count:           703 token(s)
eval duration:        3m18.486645s
eval rate:            3.54 tokens/s
各評価項目の内容は以下の通り。
| 項目 | 意味 |
|---|---|
total duration |
リクエスト全体の処理時間 |
load duration |
モデル読み込み時間(既にメモリ上にあれば短い) |
prompt eval count |
入力プロンプトのトークン数 |
prompt eval duration |
入力を処理した時間 |
prompt eval rate |
入力を処理した速度(tokens/s) |
eval count |
生成したトークン数 |
eval duration |
回答生成に要した時間 |
eval rate |
回答文を生成する速度(tokens/s) |
作業用PCでの比較を行ってみた。
| 構成 | prompt eval rate(tokens/s) | eval rate(tokens/s) |
|---|---|---|
| ① PC A: 100% CPU | 28.84 | 3.54 |
| ② PC B: 52%/48% CPU/GPU | 175.67 | 39.03 |
| ③ PC B: 100% GPU | 1384.05 | 45.55 |
※6.~9.までの質問を3回ほど投げての結果もベスト値です。実行のたびにばらつきます。
※③はGeforce RTX 4050が動いているっぽい時の状態です。
LLM をローカルで利用する場合の tokens/s(1秒あたりに生成できるトークン数) の目安を、Chat-GPTにまとめてもらった。当然、用途によってかなり変わるので、あくまで参考値とのこと。
| 生成速度 | 体感 | 用途の目安 |
|---|---|---|
| ~5 tokens/s | かなり遅い | 長文生成は厳しい。推論実験向け |
| 5~10 tokens/s | やや遅い | チャット可能だが待ち時間が気になる |
| 10~20 tokens/s | 普通 | 一般的な対話用途で十分実用的 |
| 20~40 tokens/s | 快適 | ストレスなく会話できる |
| 40~80 tokens/s | 非常に快適 | コーディング支援や長文生成向け |
| 80 tokens/s以上 | 高速 | リアルタイムアシスタント向け |
13. まとめ
今回は、ノートPC上で Gemma4 E4B QAT を動かしてみた。
実際に試してみると、
- ローカルLLM(Gemma4)でも十分自然な日本語での会話ができる
- Thinking を確認することで推論過程を観察できる
- ローカルLLMはリアルタイム情報は持っていないため外部システムとの連携が必要
- GPUを積んでいても、そのGPUの性能をフルに使っているとは限らない
- CPUのみのノートPCでもCPUコアが10個くらい、RAMの空きが16GBくらい、あとは忍耐があれば、Gemma4:E4B QATを利用してシステム開発は不可能ではない
といった特徴が見えてきた。
次回は、Python から Ollama を呼び出し、システムプロンプトで外部情報を与えたローカルLLMと基本的な連携をする簡単な AI チャットを作成してみたい。
・・・(その2)へつづく・・・
リンク
こちらは生成AIのちーちゃん(GPT5)にアドバイスをもらいながらAI/IoTを活用して家庭菜園にいそしんでいるブログです。よかったらこちらも見てやってください。