
概要
個人的な備忘録を兼ねたPyTorchの基本的な解説とまとめです。
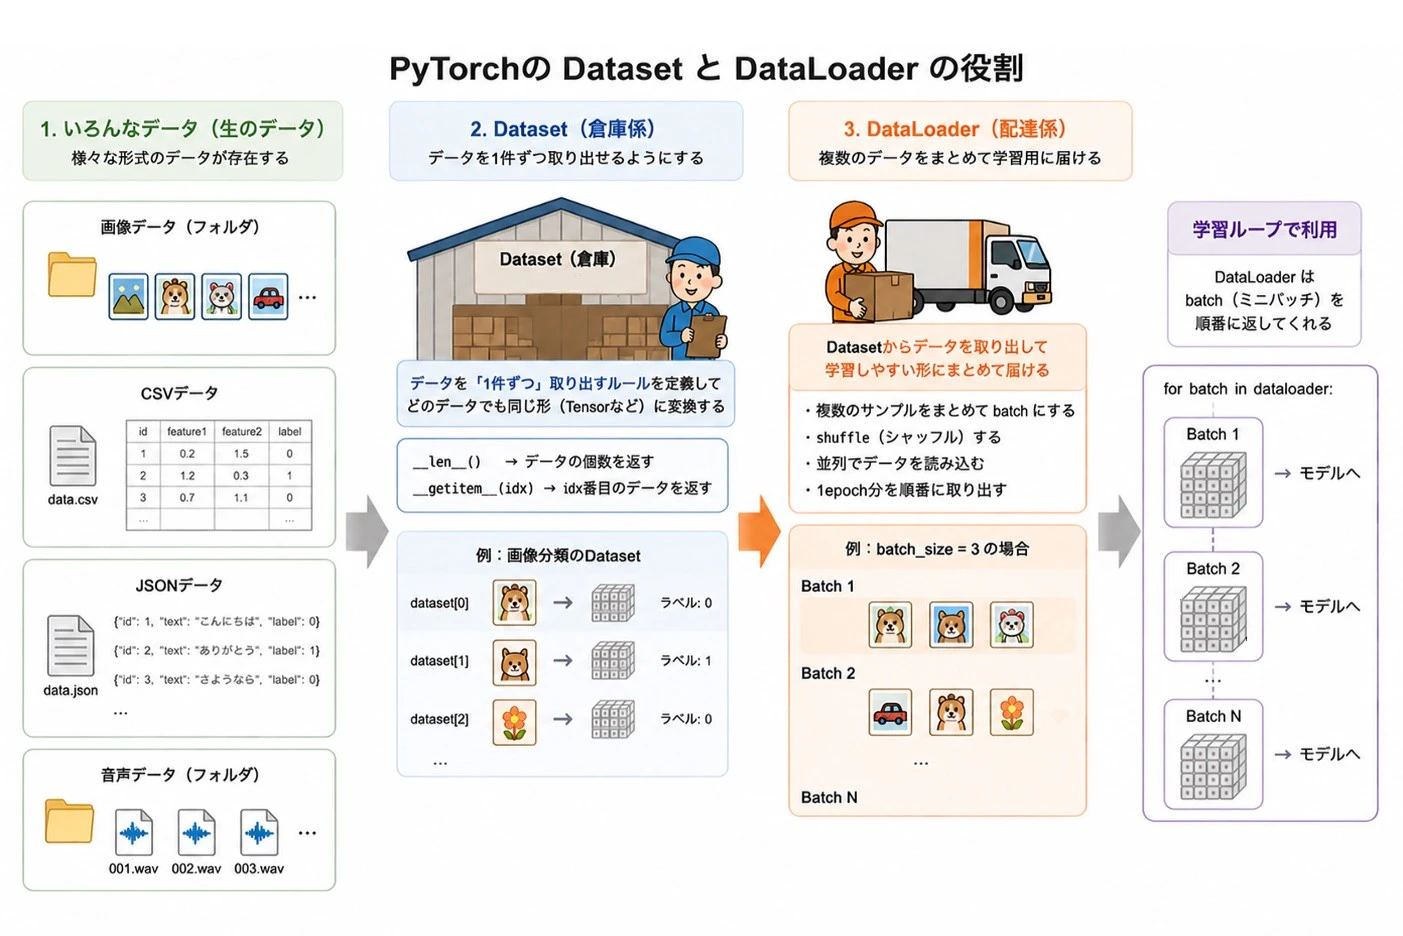
PyTorchのDataLoaderクラスはDatasetクラスと合わせて利用することで威力を発揮します。前回のDatasetクラスに続いて、DataLoaderクラスのカスタマイズについてまとめておきたいと思います。とりわけcollate_fnについて探るのが今回の目的となります。
DatasetとDataLoaderのコンボによって、異なる系列長のデータも扱うことが可能になるはず🔥
公式のチュートリアル
扱いたいテーマ
- Datasetクラスのカスタマイズ方法 (第33回)
- DataLoaderのcollate_fnを使ってみる (今回・第34回)
- 可変長データでの文章分類 (次回)
- 可変長データでのBERTタイプの事前学習
- HuggingFaceのライブラリーとつなげてみる (予定)
演習用のファイル
- サンプルデータ1:ramen_data.csv
- ラーメンの種類分類の架空のデータセット
- サンプルデータ2:history_text_label_id.jsonl
- wikipediaの日本史関連から取得した時代区分分類のテキストデータ
- コード: sample_34.ipynb
- 登場するコードをひとまとめにしたもの
1. DataLoader
PyTorchのドキュメントによるとDataLoaderは次のように1文で説明されています。
Documentationでの解説
Data loader combines a dataset and a sampler, and provides an iterable over the given dataset.
PLaMo翻訳
データローダーはデータセットとサンプラーを統合し、指定されたデータセットに対する反復可能なオブジェクトを提供します。
「データ (dataset) から、指定されたルール (shuffleやcollate_fn) に従って、ミニバッチ (batch_size) を自動で作成、モデルに供給してくれる仕組み」という感じ😆1
datasetはDatasetクラスで作成した変数(オブジェクト)なのでDatasetクラスを継承したカスタム版のオブジェクトも対象となります。DataLoaderはDatasetクラスと合わせて使うことで真価を発揮するクラスとなります。
1.1 基本形と使い方
DataLoderの基本的な使い方を確認しておきます。といっても、何度も利用しているような気がするのですが
# datasetはDatasetクラスで作成した変数
dataloader = DataLoader(
    dataset = dataset,
    batch_size = 8,
    shuffle = True    # default: False
)
説明メモ
使い方は、オプションを指定するだけ
- Datasetクラスで作成したdataset
- batch_sizeでミニバッチサイズをいくつにするのかを指定
- shuffle=Trueによってデータ構成時にシャッフル、エポック毎にもシャッフルされます2
実際にデータを呼び出すときは?
for data in dataloader:
    # dataに対する処理
    # 例 datasetの値がidsとlabelのキーを持つ辞書の場合
    # x = data["ids"]
    # t = data["label"]
for文でループ
1.2 TensorDatasetと組み合わせてみた
ラーメン分類問題 (第3回)で利用したCSVファイルを使ってみたいと思います。利用するデータはramen_data.csvです。
表1:ramen_data.csvのサンプル
| 脂質含有量 | スープの濃度 | 塩分濃度 | 後味の持続時間 | 透明度 | ラーメンタイプ | ラーメンタイプID |
|---|---|---|---|---|---|---|
| 3.2 | 3.9 | 5.5 | 1.9 | 8.7 | あっさり | 0 |
| 2.8 | 3.7 | 5.2 | 1.5 | 5.9 | あっさり | 0 |
表の形のデータなので基本形のままDataLoaderが利用できます。DatasetクラスについてはPyTorch既成のTensorDataestを利用します。よく利用する形が既に用意されています。公式Documentを参考にしました。
import torch
import numpy as np
from torch.utils.data import TensorDataset
from torch.utils.data import DataLoader

# ラーメン分類CSVファイル
filename = "./data/ramen_data.csv"
x = np.loadtxt(filename, delimiter=",", skiprows=1, usecols=(0,1,2,3,4))
t = np.loadtxt(filename, delimiter=",", skiprows=1, usecols=(6))
x = torch.FloatTensor(x)
t = torch.LongTensor(t)

# Datasetクラスのカスタム版
dataset = TensorDataset(x,t) # x,tがtorch.tensorでないと使えない

# 基本形のまま利用できる
dataloader = DataLoader(
    dataset = dataset,
    batch_size = 4,
    shuffle = True
)

for x, t in dataloader:
    # dataに対する処理
    print(f"{x=}")
    print(f"{t=}")
意味なくプリントしてみた!batch_size=4で指定したサイズのデータ数で(x,t)が供給されます。shuffle=Trueなので毎回表示される値が異なるはず
x=tensor([[ 7.7000,  9.6000,  4.8000,  7.5000,  1.7000],
        [ 7.6000, 10.0000,  4.9000,  6.1000,  2.0000],
        [ 3.1000,  3.1000,  5.7000,  2.6000,  6.5000],
        [ 5.3000,  7.7000,  9.6000,  3.7000,  6.8000]])
t=tensor([1, 1, 0, 2])
DataLoaderの引数であるdatasetはDatasetクラスの出力であればよいのでtorch.tensor以外(numpy配列やリスト)でも、もちろんOKです。
1.3 カスタム版Datasetクラスと組み合わせてみた
TensorDatasetはtorch.tensorが入出力で利用されます。numpy配列で入出力するカスタム版Datasetでも試してみました。MyDataset02やMyDataset03については、第33回を参考にしてください。
# (1) CSVファイル読み込み numpy配列
filename = "./data/ramen_data.csv"
x = np.loadtxt(filename, delimiter=",", skiprows=1, usecols=(0,1,2,3,4))
t = np.loadtxt(filename, delimiter=",", skiprows=1, usecols=(6))

# カスタム版Datasetクラス
class MyDataset02(Dataset):
    def __init__(self, x,t):
        self.x = x   # 入力データ
        self.t = t   # 教師データ
    def __len__(self):
        return len(self.t)
    # (2) 入出力するデータのタイプによって適宜修正
    def __getitem__(self, index):
        return {
            "data":  np.array(self.x[index], dtype=np.float32),
            "label": np.array(self.t[index], dtype=np.int64)
            }

# (3)
dataset = MyDataset02(x,t)

# (4)
dataloader = DataLoader(
    dataset = dataset,
    batch_size = 4,
    shuffle = True
)
# (5)
for data in dataloader:
    # dataに対する処理
    print(f"{data=}")
    break
# data={'data': tensor([[ 4.0000,  6.1000,  9.4000,  4.7000,  4.0000],
#         [ 7.6000, 10.0000,  4.9000,  6.1000,  2.0000],
#         [ 3.1000,  4.3000,  6.2000,  1.9000,  8.2000],
#         [ 9.6000,  8.8000,  7.4000,  7.8000,  1.3000]]),
#       'label': tensor([2, 1, 0, 1])}
#
説明メモ
- (1) numpy配列のまま利用します。
- (2) Datasetのカスタマイズ部分です。__getitem__の部分戻り値をnumpy配列の辞書形式にしてみました。
{"data": np配列, "label": np配列(ラベル番号)}
- (3) カスタマイズしたDatasetクラスのMyDataset02を使います3 dataset[0]はnumpy配列の辞書タイプです。
- (4) datasetをDataLoaderに入力。バッチサイズを4、シャッフルありとしました。
- (5) DataLoaderの出力値は、torch.tensorになっています😆
PyTorch Documentationのdata部分によると、デフォルトで働くcollate_fnによってtorch.tensorへ変換されているようです。
1.4 データの形状が異なる場合(そのままだとエラー)
分類問題のデータのようにID列の系列長が異なるデータをDataLoaderのdatasetにそのまま利用すると...collate_fnを指定しない場合、エラー
デフォルトだとミニバッチ毎にデータの形状を自動で揃えられないっぽい。
class MyDataset03(Dataset):
    # (1) dataがデータフレームになっている
    def __init__(self, data):
        self.data = data

    def __len__(self):
        return len(self.data)

    # (2) データの形式で適宜修正
    def __getitem__(self, index):
        item = self.data.iloc[index]   # データフレームのindex行を取得したいので data.iloc[]を使う
        tensor_x = torch.tensor(item["ids"], dtype=torch.long)
        tensor_t = torch.tensor(item["label"], dtype=torch.long)
        return {"ids": tensor_x, "label": tensor_t}


data_filename = "./data/text_label_id.jsonl"       # 分類問題のデータ
df = pd.read_json(data_filename, lines=True)

dataset = MyDataset03(df)


dataloader = DataLoader(
    dataset = dataset,
    batch_size = 4,
)

print(next(iter(dataloader)))
# RuntimeError: stack expects each tensor to be equal size, but got [12] at entry 0 and [22] at entry 1
# PLaMo翻訳
# RuntimeError: stack は各テンソルのサイズが等しいことを期待
# していますが、エントリ 0 では [12]、エントリ 1 では [22] と
# なっています
説明メモ
- text_label_id.jsonlに収められているID列のidsはデータ毎に長さが異なります。
- 基本形に従ってDataLoaderを使うと、「長さが違うよ〜という」エラーになります。
異なる長さのデータを扱うには、collate_fn機能を活用する必要があります。
2. collate_fnの作成
DataLoaderのオプションにあるcollate_fn関数を作成することで「ミニバッチ毎にデータの形状揃える」ことが可能になります。他にもなにか活用できそう。しかし!collate_fnって難しそう😱
第29回でBERTのMASKを作成するときにも登場したのですが、長くて大変だった 😂 今回は簡単な例からまとめておきます。
2.1 collate_fnとは?
collate_fnといっても、Datasetクラスのデータを整えてミニバッチにまとめる関数というニュアンスっぽい。引数と戻り値が決められている関数のようです。
pytorchのdocumentationには、1文の解説があります。
Documentationでの解説
collate_fn (Callable, optional) – merges a list of samples to form a mini-batch of Tensor(s). Used when using batched loading from a map-style dataset.
PLaMo翻訳
collate_fn (呼び出し可能オブジェクト、オプション) – サンプルリストを結合して Tensor のミニバッチを形成する。マップスタイルのデータセットからバッチ処理で読み込む場合に使用する。
Callableなものなら何でも良さそうなので、実際は関数以外にも、クラスを利用して表現することも可能だと思います。
collate_fn関数の引数batchは、Datasetクラスのデータで、具体的には次の例1や例2で表現する batch となります。Datasetで扱うデータによって異なるので少しだけ注意です🌵
# ramen_data.csvでの場合
dataset = MyDataset02(x,t)

# dataset[0] = {'data': array([3.2, 3.9, 5.5, 1.9, 8.7], dtype=float32), 'label': array(0)}
# batch = [dataset[0], dataset[1],..., dataset[k]]
例1はMyDataset02を利用しているので、出力値は、dataとlabelをキーに持つnumpy配列になります。
# text_label_id.jsonlでの場合
dataset = MyDataset03(df)

# dataset[0]
# {'ids': tensor([  1,  29,  90,   5,  46,   8,  88,  97,   5, 105,   6,   2]),
#  'label': tensor(0)}
# batch = [dataset[0], dataset[1],..., dataset[k]]
例2はMyDataset03を利用しているので、出力値は、idsとlabelをキーに持つtorch.tensorになります。
collate_fn関数の引数が「どのような型のリストになるのか」に注目すれば作成できそうです🌸
2.2 tensor値を持つ辞書形式に変換するcollate_fn
例1に対応する形で、「numpy配列のリストを受け取りtorch.tensorにする」だけのcollate_fnを作成してみました。
ramen_data.csvとMyDataset02に対応した素朴なcollate_fnのサンプルとなります。xが入力データ、tがラベルIDとなります。
import torch

def sample_collate_fn(batch):
    # (1) batch[0]はdataとlabelをキーに持つnumpy配列
    data = torch.as_tensor(np.stack([x["data"] for x in batch]), dtype=torch.float)
    labels = torch.as_tensor(np.stack([x["label"] for x in batch]), dtype=torch.long)
    # 辞書形式で出力
    return {"data": data, "label": labels}

dataset = MyDataset02(x,t)

# (2)
dataloader = DataLoader(
    dataset,
    batch_size=4,
    shuffle=True,
    collate_fn=sample_collate_fn,
    )

print(next(iter(dataloader)))
# {'data': tensor([[5.6000, 6.3000, 9.2000, 4.3000, 5.6000],
#         [3.3000, 3.7000, 6.6000, 2.2000, 8.4000],
#         [8.4000, 8.4000, 6.4000, 5.8000, 1.9000],
#         [3.1000, 3.0000, 4.0000, 2.1000, 7.0000]]),
# 'label': tensor([2, 0, 1, 0])}
説明メモ
- (1) torch.as_tensorを利用して、numpy配列をテンソル化します。
- 辞書形式で出力します。
- (2) batch_size=4でデータを分割。実際の出力結果からも4個あることが確認できます。
2.3 異なる系列長のデータをミニバッチごとに揃えるcollate_fn
テキスト分類データのidsはデータによって系列長が異なっています。collate_fnによって、ミニバッチ化されたデータの中では<pad>を使い等長になるように調整してみましょう。これで、DataLoaderも動作するはずです。
歴史時代区分データであるhistory_text_label_id.jsonlとMyDataset03に対応した、等長化を目的とするcollate_fnを作成してみます。pad_sequenceを使いpaddingしていきます。
from torch.nn.utils.rnn import pad_sequence

def padding_collate_fn(batch):
    # (1) 入力されるデータがtensorなのでそのまま活用
    ids_list = [x["ids"] for x in batch]
    labels = torch.stack([x["label"] for x in batch])
    # (2) pad_id = 0としています
    padded_ids = pad_sequence(ids_list, batch_first=True, padding_value=0)
    # (3) padマスクの作成
    attention_mask = (padded_ids != 0).long()  # 実トークン=1, <pad>=0
    # (4)
    return {"ids": padded_ids, "attention_mask": attention_mask, "label": labels}

# dfはテキスト分類のデータ
dataset = MyDataset03(df)

dataloader = DataLoader(
    dataset = dataset,
    batch_size=4,
    shuffle = True,
    collate_fn=padding_collate_fn,
    )

next(iter(dataloader))
# {'ids': tensor([[   1,  481,  250,  238,  262,    8,  817,  577,   15,  325,  577,   15, 1029,  577,   15,  844,  577,   15,  196,  577,    5, 1978,  577,  782,  497,   10,  235,   62,   75,    8,  104,  325, 667, 1742,  729,   19,  231,  126,   23,  669,   17,   23,  669,    5,  412, 1347,   20,    7,  158,  134,   18,    6,    2],
#          [   1,  301,  250,    3,   98,  261,   10,  363, 1062, 1079,  159,    9,  234,  928,    5,    3,   17,    3,    5, 1370,    3,   20,    7,  447, 1970,    3,   38,    9,   79,   94,    6,    2, 0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0],
#          [   1,  498,  650,  262, 1071,   98,   25,    3, 1628, 1639,  602,  437,    3,   64,   10,  928,    3,   16,  302, 1728,  194,  198,    8,    3,  677,    8,  989,  804, 1291,  804,    9,  364,  564,   18,    6,    2,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0],
#          [   1,  745,   23,  106, 1946, 1811,  298,   51,   26,   17,   43,  481,  131,  131,   26,   17,  675,  209,   68,   26,   20,   20,    8,  355,   23,  186,  743,   39, 1908,   15,  701,  184, 648,  213,   30,   38, 1071, 1806,  413,    9,  236,  122,   15,  800,  400,    6,    2,    0,    0,    0,    0,    0,    0]]),
#  'attention_mask': tensor([[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1],
#         [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
#         [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
#         [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0]]),
#  'label': tensor([0, 2, 0, 2])}
説明メモ
dataset = MyDataset03(df)についてdataset[0]の値は、
{'ids': tensor([ 1, 29, 90, 5, 46, 8, 88, 97, 5, 105, 6, 2]),
'label': tensor(0)}
という、テンソルとなります。すでにテンソルになっている点を考慮して、collate_fnを作成します。
- (1) pad_sequenceを使えるように、テンソルのリストにします。x["ids"]はtorch.tensorなので、並べる形でOKです。label側はstackで対応します。label側は戻り値として利用します。入力されるデータのタイプに応じて適宜変更が必要となります。
- (2) pad_sequenceを使って、リスト内の系列長を等長化します。<pad>のIDを0としています。
- (3) <pad>が使われている部分を0、それ以外のトークンを1とするマスクも作成してみました。同様に<pad>部分にID「-100」という損失時に計算を除外するIDを割り当てることも可能です。
- (4) 戻り値は、Hugging Faceっぽい感じの辞書形式にしてみました4。
わかりにくいのですがミニバッチごとに系列長が揃うデータとなっています。
2.4 クラスを使って表現してみた
padding_collate_fnと同じ処理をクラスを利用して記述してみました。複雑な状況の時、役立つ方法かもしれないと信じたい😉
クラスを使うときのポイントは、
collator = PaddingCollator()
という形でインスタンス化する時、クラス内で定義した__call__()部分がcollator()として呼ばれることを活用します。
class PaddingCollator:
    """
    padding_collate_fn をクラスで表現したバージョン
    """
    # (1)
    def __init__(self, pad_id=0):
        self.pad_id = pad_id

    # (2) padding_collate_fnと同じ
    def __call__(self, batch):
        ids_list = [x["ids"] for x in batch]
        labels = torch.stack([x["label"] for x in batch])
        padded_ids = pad_sequence(ids_list, batch_first=True, padding_value=self.pad_id)
        attention_mask = (padded_ids != self.pad_id).long()  # 実トークン=1, <pad>=0
        return {"ids": padded_ids, "attention_mask": attention_mask, "label": labels}

# (3) __call__の特徴を利用して、collatorを関数として機能させる
collator = PaddingCollator(pad_id=0)

dataset = MyDataset03(df)

# (4) インスタンスがそのまま callable なので関数のように記述してもOK
dataloader = DataLoader(
    dataset = dataset,
    batch_size=4,
    shuffle = True,
    collate_fn = collator,
    # collate_fn=PaddingCollator(pad_id=0), # 直接書いてもOK
    )

print(next(iter(dataloader)))
# {'ids': tensor([[   1, 1128,   16, 1818,  138,    5,  126,  133,   50,   70,   16,  251,    8,  161,  109,  303,   49,  115,  136,  133,   10,  282, 1942,  221,  136,  127,   16,  501,  475,    7, 1950,  324, 163,    6,    2,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0],
#          [   1,   64, 1795,   11, 1991,   23,    9,  566, 1942,  221,   23, 1956,    5,  659, 1861,   79,    9, 1932,   62,  461,    6,    2,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0,    0],
#          [   1,  248,  543,  526,   11,  460,    8,  300,  146,   11, 1044,   12,    5,  264,  174,   10, 1304, 1587,   48,   22,  467,   80,    9,  588,  549,  222,  496,   24,  294,  309,   17,  170, 1287,  949,  470,   20,    9,  412, 1877,  103,  282, 1409,  638,   12, 1756,   48,  168,    8,  419,  467,    5,   44,   23,    5,  305,  370,   12,  512,   34,   13, 1076,  705,    5,  130],
#          [   1,  759,   80,    5,  447,  199,   11,  657,  474,  129,  433,  496,    5,  447, 1431, 1631,  812, 1764, 1407,  285, 1813,  572,  879, 1044,  501,  555,    3, 1764, 1407,    5,  605,    8,  1976, 1735,  879, 1976, 1735,  555, 1780,  236, 1994,    3, 1266, 1764, 1407,   38,   14,  447,  199, 1764, 1407,   16,   29,  844,  586, 1901, 1879,  768, 1316,    8,    3,  227, 1049,  205]]),
#  'attention_mask': tensor([[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
#          [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
#          [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1],
#          [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1]]),
#  'label': tensor([4, 3, 3, 1])}
説明メモ
- (1) <pad>のIDを指定できるようにしてみました。__init__部分で初期状態を決められるので用途が広がりそうな予感がします🍀
- (2) 特殊メソッドの
__call__を利用して、padding_collate_fnと等しい処理を行わせます。 - (3) collator = PaddingCollator(pad_id=0)とインスタンス化することで、collatorが関数
collator(batch)のように機能します。 - (4) collate_fn=PaddingCollator(pad_id=0)とオプション欄に直接記述してもOK🌵
- DataLoder()の前に、collator = PaddingCollator(pad_id=0)と宣言して、collate_fn=collatorと記述してもOKです。
classを利用する方法は複雑な処理をcollate_fnに任せる場合に活躍してくれるはず
次回
DatasetとDataLoaderのカスタマイズ方法についてまとめてみました。これらを利用してID列を事前に等長化しない形でのテキスト分類やBERTタイプの事前学習に挑戦してみたいと考えています。
目次
参考
- PyTorchのチュートリアル: Fashion-MNIST を題材にして解説してあります。Further Reading まで読み進めるとどんどん深みにハマります😅
- DataLoaderのshuffleについて:DataLoaderのシャフルに焦点をあてたもの。参考になります。
- PyTorch DataLoader完全ガイド:詳しい。完全ガイドというだけのことはあります。必見かと。
- Pytorch – DataLoader の使い方について解説:num_workers数での実験など参考情報が渋い。オプションの詳しい解説が有用です。