
はじめに
前回は ChEMBL から EGFR 阻害剤のデータを取得し,Lipinski フィルタと
PAINS フィルタで信頼性の高い 2797 化合物に絞り込み,
フィンガープリントによる類似度検索でゲフィチニブに似た化合物を探しました.
今回は3つのことに取り組みます.
1つ目はフィルタリング後の2797化合物が化学空間のどこに分布しているかを,t-SNE(t-distributed Stochastic Neighbor Embedding)という次元削減手法で可視化します.
2つ目は,最大共通部分構造(MCS: Maximum Common Substructure)を使って,活性の高い化合物に共通する骨格を探します.
3つ目は,機械学習で EGFR 阻害活性(pIC50)を予測するQSAR(定量的構造活性相関)モデルを構築します.
データセットの読み込み
前回行った,データセットの読み込みとLipinski・PAINSフィルタリングによる化合物の絞り込みを行います.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from rdkit import Chem
from rdkit.Chem import Draw, Descriptors, AllChem
from rdkit import DataStructs
from rdkit.Chem.FilterCatalog import FilterCatalog, FilterCatalogParams

# データ取得 + Mol オブジェクト作成
url = "https://raw.githubusercontent.com/volkamerlab/teachopencadd/master/teachopencadd/talktorials/T001_query_chembl/data/EGFR_compounds.csv"
df = pd.read_csv(url)
df["mol"] = df["smiles"].apply(Chem.MolFromSmiles)
df = df[df["mol"].notnull()].reset_index(drop=True)

# Lipinski フィルタ
df["Lipinski_pass"] = (
    (df["mol"].apply(Descriptors.MolWt) <= 500) &
    (df["mol"].apply(Descriptors.MolLogP) <= 5) &
    (df["mol"].apply(Descriptors.NumHDonors) <= 5) &
    (df["mol"].apply(Descriptors.NumHAcceptors) <= 10)
)

# PAINS フィルタ
params = FilterCatalogParams()
params.AddCatalog(FilterCatalogParams.FilterCatalogs.PAINS)
catalog = FilterCatalog(params)
df["is_PAINS"] = df["mol"].apply(catalog.HasMatch)

# 両方通過した化合物だけ残す
df_filtered = df[(df["Lipinski_pass"]) & (~df["is_PAINS"])].reset_index(drop=True)
print(f"フィルタリング後: {len(df_filtered)}件")
t-SNE(t-distributed Stochastic Neighbor Embedding)とは
高次元のデータを構造(近さの関係)を保ちながら2次元に圧縮する手法です.
元データ: 2797化合物 × 2048次元(フィンガープリント)
t-SNE後: 2797化合物 × 2次元(x, y 座標)
このように作られた二次元プロットにおいては,近い点(似た分子)は2次元でも近くに,遠い点(異なる分子)は遠くに配置されます.似た構造の分子がクラスタを作ります.
散布図のようにも見えますが,軸の値自体に意味はなく,意味があるのは点と点の相対的な位置関係(近いか遠いか)だけです.
全体の構造(クラスタの有無,分布の偏り)が一目でわかります.
フィンガープリントはこれまで機械学習の特徴量,二分子の類似度計算に使ってきましたが,今回は全分子の分布を2次元に可視化するために使います.
ゲフィチニブはデータセットに CHEMBL939 として含まれていますが,参照点として明示的にプロット上で目立たせるため,別途追加しています.
from sklearn.manifold import TSNE
from rdkit.Chem import AllChem

# フィルタリング後のデータでフィンガープリントを計算
fps_filtered = np.array([
    np.array(AllChem.GetMorganFingerprintAsBitVect(mol, radius=2, nBits=2048))
    for mol in df_filtered["mol"]
])
print(f"フィンガープリントの形: {fps_filtered.shape}")

# ゲフィチニブを参照点として追加
gefitinib = Chem.MolFromSmiles("COc1cc2ncnc(Nc3ccc(F)c(Cl)c3)c2cc1OCCCN1CCOCC1")
gefitinib_fp = np.array(AllChem.GetMorganFingerprintAsBitVect(gefitinib, radius=2, nBits=2048))
fps_with_ref = np.vstack([fps_filtered, gefitinib_fp.reshape(1, -1)])

# t-SNE で2次元に圧縮
tsne = TSNE(n_components=2, random_state=42, perplexity=30)
coords = tsne.fit_transform(fps_with_ref)
TSNEの引数について
- n_components=2:圧縮後の次元数.2次元にするので2.3にすれば3次元もつくれる.
- perplexity=30:「各点が何個の近傍を見るか」の目安
小さい(5〜10) → 局所的な構造を重視(小さなクラスタが見える)
大きい(30〜50) → 大域的な構造を重視(全体の配置が見える)
30 はデフォルト値で,ほとんどの場合これで OK
続いて描画に移ります.
coordsの中身は([x1, y1], [x2, y2], [x3, y3], ...)という配列になっています.coords[:-1]が元の化合物群,coords[-1] がゲフィチニブの座標になります.
# 描画(化合物群 [:-1, 0]は最後を除いた全ての化合物のx座標)
plt.figure(figsize=(10, 8))
scatter = plt.scatter(coords[:-1, 0], coords[:-1, 1],
                      c=df_filtered["pIC50"], cmap="viridis",
                      alpha=0.5, s=15)
plt.scatter(coords[-1, 0], coords[-1, 1],
            color="red", marker="*", s=300, edgecolor="black",
            label="Gefitinib", zorder=5)
plt.colorbar(scatter, label="pIC50")
plt.xlabel("t-SNE 1")
plt.ylabel("t-SNE 2")
plt.title("Chemical Space with Gefitinib (red star)")
plt.legend()
plt.show()
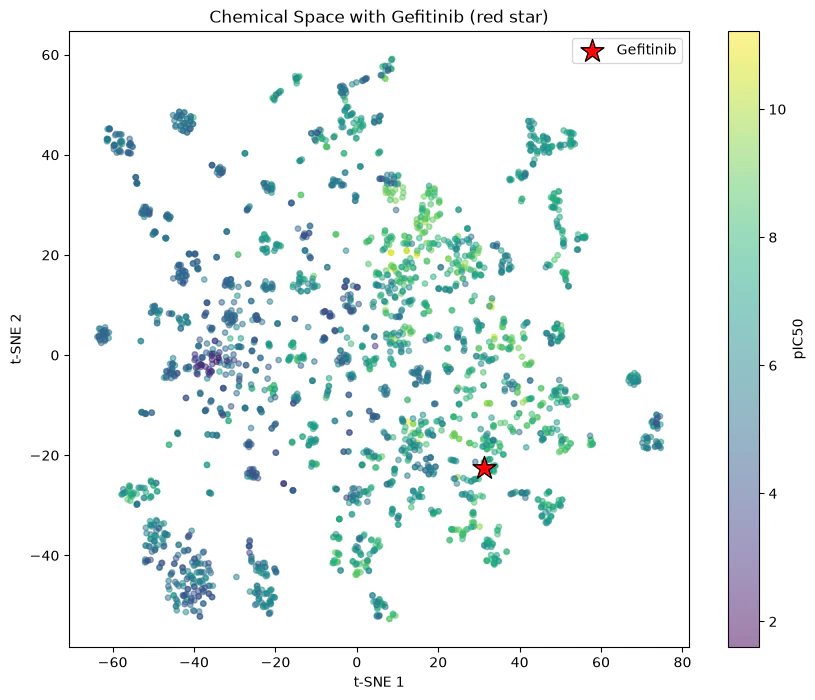
このt-SNE図(ケミカルスペースマップ)からいくつかのことが読み取れます.
まず,似た構造の分子があつまってクラスタ(塊)を形成していることが分かります.
クラスタごとの色の分布を見ると,高活性(黄色)の領域と低活性(紫)の領域が見える部分もありますが,クラスタ内でも色が混ざっていることが多く,構造だけでは活性を完全には決められなさそうです.
ゲフィチニブ(赤い星)は化学空間の端ではなく,周囲に他の分子が散在する位置にいます.
完全な中心ではありませんが,孤立した特殊な構造ではなく,類似の構造を持つ化合物群の中に位置していることが分かります.
また,全体的に広く分布しており,多様な化学空間がカバーされています.
実際の創薬では,t-SNE で化学空間を俯瞰した後,以下のように進めるそうです.
- 有望な領域(高活性の分子が集まるクラスタ)を特定 → MCS で共通骨格の調査やQSAR モデルの構築
- 空白領域を狙って新しい骨格を設計
今回は化学空間の俯瞰までとしますが,いつかクラスタ分析や空白領域の定量的な探索など,深掘りしてみたいと思います.
最大共通部分構造(MCS)
次に,活性が高い化合物に共通する骨格を探します.MCS(Maximum Common Substructure)は,2つ以上の分子に共通する最も大きな部分構造を見つける手法です.
「活性が高い分子に共通する構造 = 活性に重要な構造」という考察に役に立ちます.
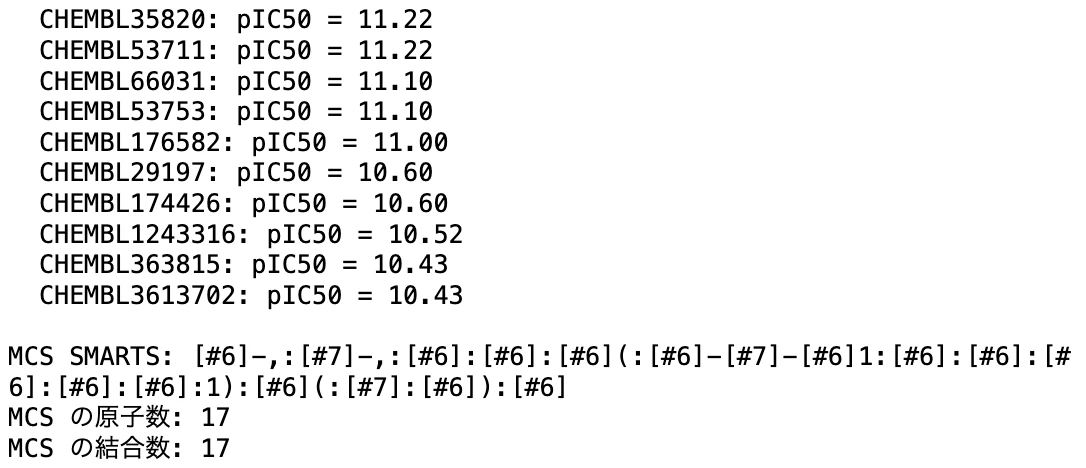
まずは,活性の高い化合物 Top 10 の MCS を探します.
from rdkit.Chem import rdFMCS

# pIC50 が高い Top 10 の分子
top10 = df_filtered.nlargest(10, "pIC50")

for _, row in top10.iterrows():
    print(f"  {row['molecule_chembl_id']}: pIC50 = {row['pIC50']:.2f}")

# Top 10 の Mol オブジェクトのリスト
mols_top10 = [mol for mol in top10["mol"] if mol is not None]

# MCS を計算
mcs_result = rdFMCS.FindMCS(mols_top10, threshold=0.8, timeout=60)
print(f"\nMCS SMARTS: {mcs_result.smartsString}")
print(f"MCS の原子数: {mcs_result.numAtoms}")
print(f"MCS の結合数: {mcs_result.numBonds}")
rdFMCS.FindMCSのパラメータについて
- threshold=0.8:
80% 以上(ここでは10分子中8分子以上)が共有する構造を探す
1.0 だと全分子が共有する構造(小さくなりがち)
0.8 だと少し緩くして,より大きな共通構造を拾える - timeout=60: 計算の制限時間(秒)
mcs_result.smartsStringで部分構造のパターンが表示されますが,これじゃいまいちわからないので,実際の分子構造を見てみます.構造を可視化し,MCSをハイライトします.
from rdkit.Chem import AllChem, Draw
from rdkit.Chem import MolFromSmarts

# MCS のパターンを Mol オブジェクトに変換
mcs_mol = MolFromSmarts(mcs_result.smartsString)

# Top 10 の分子で MCS 部分をハイライトして描画
legends = [f"{row['molecule_chembl_id']}\npIC50={row['pIC50']:.1f}"
           for _, row in top10.iterrows()]

# 各分子で MCS にマッチする原子を取得
highlights = []
for mol in mols_top10:
    match = mol.GetSubstructMatch(mcs_mol)
    highlights.append(list(match))

img = Draw.MolsToGridImage(mols_top10, molsPerRow=5, subImgSize=(300, 250),
                            legends=legends, highlightAtomLists=highlights)
display(img)
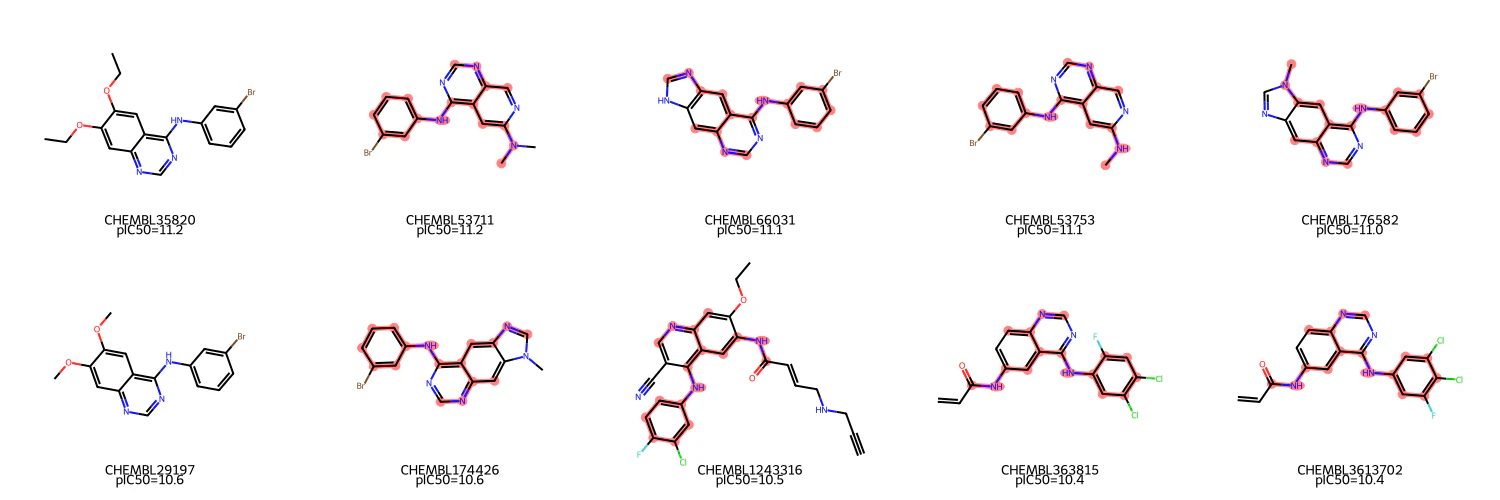
「ピラジン/ピリミジンを含む多環芳香環ーNHーフェニル基」という骨格がTop 10 のうち8分子以上に共通していることがわかります.この大きな共通構造(17原子)は,強い阻害剤が同じ基本骨格の誘導体群であることを示しています.
弱い阻害剤の MCS も比較してみます.
# pIC50 が低い Bottom 10 の分子
bottom10 = df_filtered.nsmallest(10, "pIC50")
mols_bottom10 = [mol for mol in bottom10["mol"] if mol is not None]

mcs_bottom = rdFMCS.FindMCS(mols_bottom10, threshold=0.8, timeout=60)
print(f"MCS SMARTS: {mcs_bottom.smartsString}")
print(f"MCS の原子数: {mcs_bottom.numAtoms}")
print(f"MCS の結合数: {mcs_bottom.numBonds}")
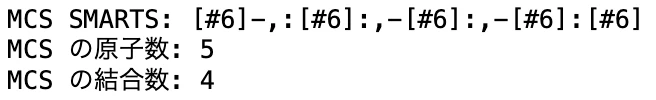
5原子(炭素の鎖+芳香環の断片)しか共通していないことから,弱い阻害剤は構造がバラバラだということがわかります.一応,実際に構造を見てみます.
# Bottom 10 の MCS を可視化
mcs_mol_bottom = MolFromSmarts(mcs_bottom.smartsString)

legends_bottom = [f"{row['molecule_chembl_id']}\npIC50={row['pIC50']:.1f}"
                  for _, row in bottom10.iterrows()]

highlights_bottom = []
for mol in mols_bottom10:
    match = mol.GetSubstructMatch(mcs_mol_bottom)
    highlights_bottom.append(list(match))

img = Draw.MolsToGridImage(mols_bottom10, molsPerRow=5, subImgSize=(300, 250),
                            legends=legends_bottom,
                            highlightAtomLists=highlights_bottom)
display(img)
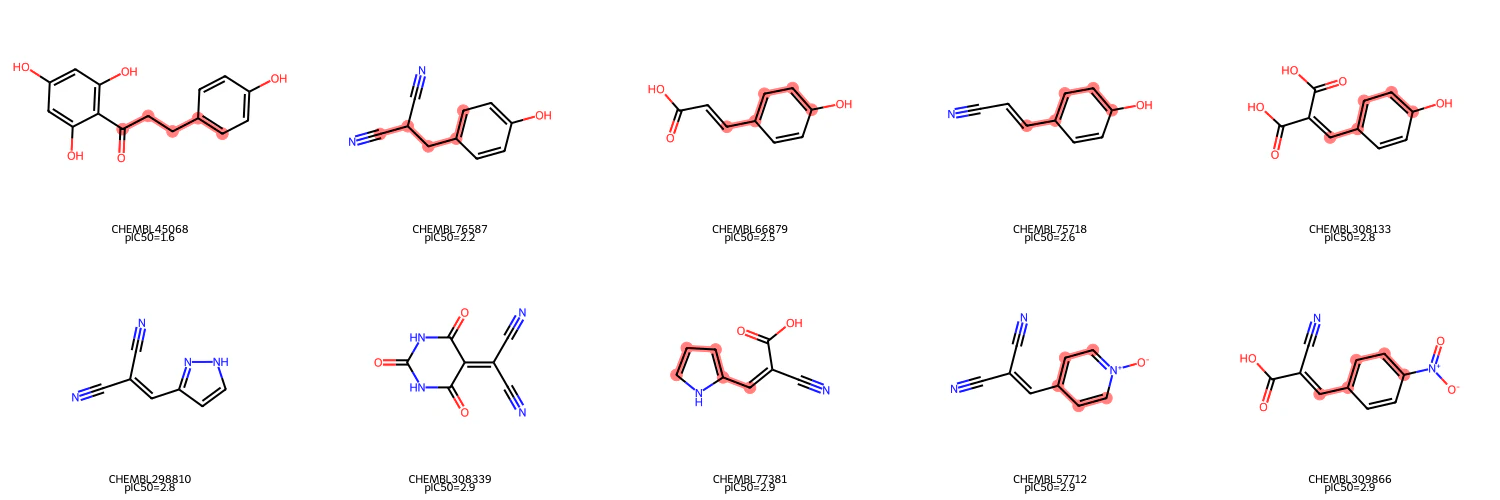
これらの強い骨格と弱い骨格の対比から,「EGFR を阻害するには,この骨格が必要」 という構造活性相関(SAR)が,MCS から見えたと言えます.この骨格をベースに置換基を変えて最適化するというアプローチが実務的には考えられます.
QSAR: 機械学習で薬物活性を予測
最後に,機械学習でEGFR 阻害活性(pIC50)を予測するQSAR(定量的構造活性相関)モデルを構築します.
ただし,EDAで記述子と pIC50 の相関は最大でも r = 0.26 と弱いとわかった通り,活性予測は溶解度予測より本質的に難しいことが予想されます.活性はタンパク質との結合という複雑な現象に支配されるためです.
データセットとして,フィルタリング後の2797化合物を用いてモデル作成を行います.
記述子とフィンガープリントの計算
前回の溶解度予測で使用したRDKit記述子(9個)と Morgan フィンガープリント(2048ビット)を計算しました.
from rdkit.Chem import Descriptors, AllChem

# RDKit 記述子を計算
df_filtered["MolWt"] = df_filtered["mol"].apply(Descriptors.MolWt)
df_filtered["MolLogP"] = df_filtered["mol"].apply(Descriptors.MolLogP)
df_filtered["TPSA"] = df_filtered["mol"].apply(Descriptors.TPSA)
df_filtered["NumHDonors"] = df_filtered["mol"].apply(Descriptors.NumHDonors)
df_filtered["NumHAcceptors"] = df_filtered["mol"].apply(Descriptors.NumHAcceptors)
df_filtered["NumRotatableBonds"] = df_filtered["mol"].apply(Descriptors.NumRotatableBonds)
df_filtered["NumAromaticRings"] = df_filtered["mol"].apply(Descriptors.NumAromaticRings)
df_filtered["RingCount"] = df_filtered["mol"].apply(Descriptors.RingCount)
df_filtered["FractionCSP3"] = df_filtered["mol"].apply(Descriptors.FractionCSP3)

desc_cols = ["MolWt", "MolLogP", "TPSA", "NumHDonors", "NumHAcceptors",
             "NumRotatableBonds", "NumAromaticRings", "RingCount", "FractionCSP3"]

# Morgan フィンガープリント
fps = np.array([
    np.array(AllChem.GetMorganFingerprintAsBitVect(mol, radius=2, nBits=2048))
    for mol in df_filtered["mol"]
])

# 特徴量セットを準備
X_desc = df_filtered[desc_cols].values
X_fp = fps
X_both = np.hstack([X_desc, fps])
y = df_filtered["pIC50"].values

print(f"化合物数: {len(y)}")
print(f"記述子: {X_desc.shape}")
print(f"フィンガープリント: {X_fp.shape}")
print(f"記述子 + FP: {X_both.shape}")
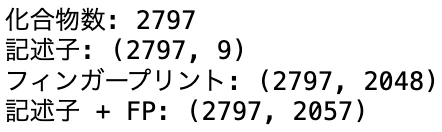
特徴量セット × モデルの比較
記述子のみ(X_desc),フィンガープリント(FP)のみ(X_fp),両方(X_both)の3パターンを,LightGBM(非線形)で比較しました.
なお,今回のデータは pIC50 の降順でソートされていたため,CV の KFold に shuffle=True を指定しないと各 fold が偏ってCV が崩壊するという問題がありました.(KFold のデフォルトは shuffle=False で,データの並び順のまま分割)
from lightgbm import LGBMRegressor
from sklearn.model_selection import cross_val_score, KFold

# データが pIC50 の降順でソートされているため shuffle=True が必要
kf = KFold(n_splits=5, shuffle=True, random_state=42)
model_lgb = LGBMRegressor(n_estimators=200, random_state=42, verbose=-1)

for feat_name, X_data in [
    ("記述子のみ (9個)", X_desc),
    ("FP のみ (2048個)", X_fp),
    ("記述子 + FP (2057個)", X_both),
]:
    cv = cross_val_score(model_lgb, X_data, y, cv=kf, scoring="r2")
    print(f"  {feat_name}: R² = {cv.mean():.4f} (±{cv.std():.4f})")
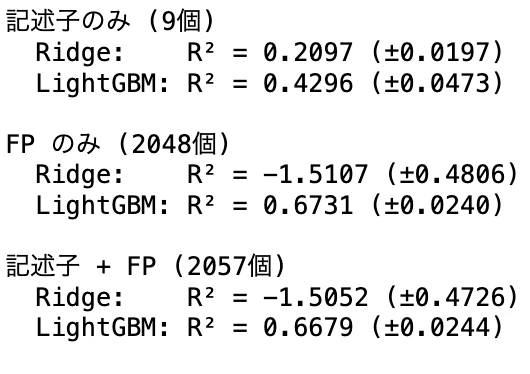
| 特徴量 | LightGBM CV R² |
|---|---|
| 記述子のみ(9個) | 0.430 |
| FP のみ(2048個) | 0.673 |
| 記述子 + FP(2057個) | 0.668 |
FP のみが最良で,記述子を追加しても改善しませんでした.
以前取り組んだ溶解度予測では記述子(R² = 0.89)が FP(R² = 0.71)を上回っていましたが,今回は完全に逆転しています.
溶解度は LogP という1つの物性で大部分が説明できたため記述子が強かったのに対し,EGFR 阻害活性は MCS で確認した「含窒素芳香環-NH-フェニル基」のような部分構造の情報が重要で,それを持つフィンガープリントの方が有効だったと解釈できます.
RDKit記述子が活性予測に効果的だったらそっちの検討もやろうと思いましたが,FPだけの方が有効だったので,今回は行いませんでした.
予測 vs 実測プロット
FP + LightGBM で予測 vs 実測プロットを作成します.
from sklearn.model_selection import train_test_split
from sklearn.metrics import r2_score

# 最良モデル(FP + LightGBM)で予測 vs 実測プロット
X_train, X_test, y_train, y_test = train_test_split(
    X_fp, y, test_size=0.2, random_state=42, shuffle=True
)

best_model = LGBMRegressor(n_estimators=200, random_state=42, verbose=-1)
best_model.fit(X_train, y_train)
y_pred = best_model.predict(X_test)

plt.figure(figsize=(7, 7))
plt.scatter(y_test, y_pred, alpha=0.3, s=15)
plt.plot([2, 12], [2, 12], "r--", label="ideal")
plt.xlabel("Measured pIC50")
plt.ylabel("Predicted pIC50")
plt.title(f"QSAR: LightGBM (FP only, test R²={r2_score(y_test, y_pred):.3f})")
plt.legend()
plt.show()
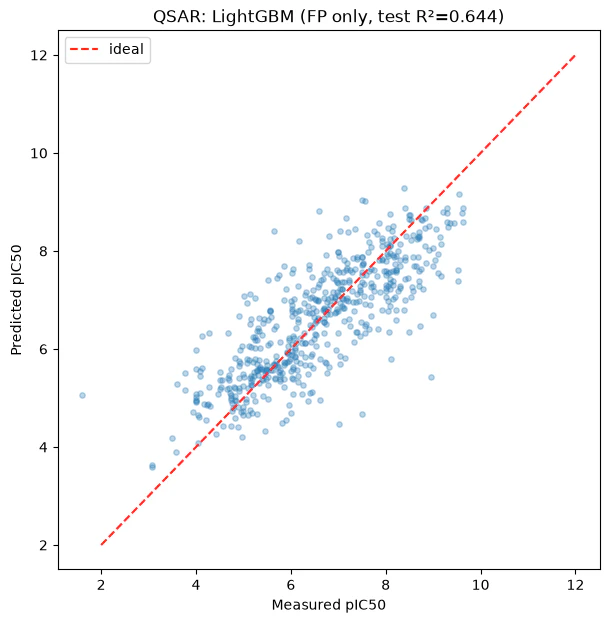
R² = 0.644という結果で,溶解度予測をした時と比べるとばらつきが大きいですが,全体的に点線に沿う傾向は見えます.
(CV R² = 0.673 との差は,1回の train/test 分割による変動です)
QSAR モデルの妥当性の基準として,外部テストセットの R² > 0.6 が提唱されています("Beware of q²!",J. Mol. Graphics Modell., 20, 269-276).
今回の結果はこの基準をクリアしており,2D 構造情報による QSAR として妥当な結果と言えます.
なお,TeachOpenCADD のオリジナル T022 では,MACCS Keys を入力とした 2層ニューラルネットワークで pIC50を予測しており,テストセットの MAE < 1.0 と報告されています.
# MAEの計算
from sklearn.metrics import mean_absolute_error

mae = mean_absolute_error(y_test, y_pred)
print(f"MAE: {mae:.3f}")
今回の LightGBM モデルの MAE は 0.643 で,これを下回る結果となりました.NN を使わずとも,適切な特徴量(Morgan FP)と木系モデルの組み合わせで同等以上の性能が得られることが確認できました.
分類への切り替え
回帰ではR² = 0.67 とまずまずといったレベルでした.
問題設定を「pIC50 の値を正確に予測する」から「効くか効かないかを判定する」に切り替えてみます.
実際の創薬でも,正確な pIC50 の値よりも「活性があるかどうか」のスクリーニングが重要な場面は多く,大量の候補分子をまず Active/Inactive に振り分けてからActiveと予測された分子だけを追加検証する,という流れは一般的だそうです.
閾値は pIC50 = 6.5(IC50 ≈ 316 nM)に設定しました.IC50 < 1 μM(= pIC50 > 6)が「活性あり」の大まかな基準として創薬で広く使われており,6.5 はそのやや厳しめの値です.
# 分類に切り替え
from sklearn.model_selection import cross_val_score
from sklearn.metrics import classification_report
from lightgbm import LGBMClassifier

# pIC50 >= 6.5 を Active,< 6.5 を Inactiveとしてデータセットを分割
threshold = 6.5
y_class = (y >= threshold).astype(int)
print(f"閾値: pIC50 = {threshold}) ")
print(f"Active:   {y_class.sum()}件 ({y_class.mean()*100:.1f}%)")
print(f"Inactive: {(1-y_class).sum()}件 ({(1-y_class.mean())*100:.1f}%)")

# LightGBM で分類
clf = LGBMClassifier(n_estimators=200, random_state=42, verbose=-1)
cv_clf = cross_val_score(clf, X_fp, y_class, cv=kf, scoring="accuracy")
print(f"\nCV Accuracy: {cv_clf.mean():.4f} (±{cv_clf.std():.4f})")

# precision/recall も確認
from sklearn.model_selection import cross_val_predict
y_pred_class = cross_val_predict(clf, X_fp, y_class, cv=kf)
print(f"\n{classification_report(y_class, y_pred_class, target_names=['Inactive', 'Active'])}")
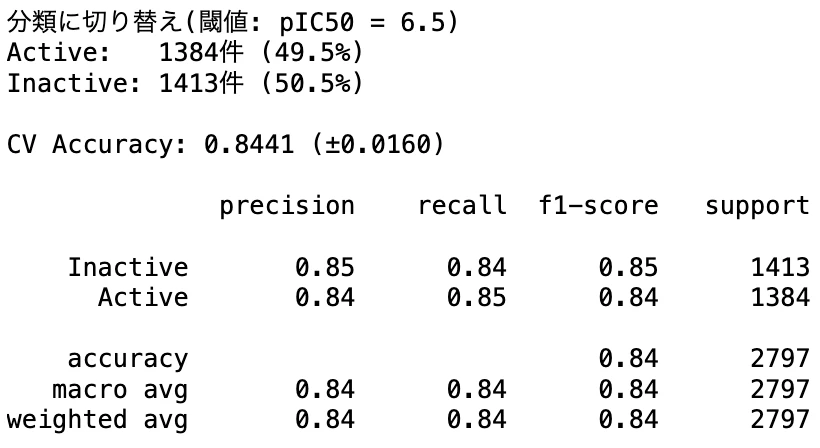
Active と Inactive の件数がほぼ半々(49.5% / 50.5%)であり,pIC50 = 6.5というのは妥当な基準でした.
結果としてはAccuracy = 0.844 で,precision/recall もほぼ均等でした.
Active と Inactive の件数がほぼ半々なので,クラスの偏りによる見かけ上の高精度ではなく,両方をバランスよく予測できていると言えます.
回帰では R² = 0.67 と「まずまず」だった予測が,分類に切り替えることで Accuracy = 0.84 と実用的な精度になりました.
「正確な数値の予測」が難しい場合でも,「効くか効かないか」の判定なら十分な精度が出せるということがわかり,戦略の変更は実務の際にも参考にしたいと思いました.
実際の創薬では,この分類モデルで Active と予測された化合物に対して,ドッキングシミュレーション(タンパク質との3D的な結合の評価)やさらに詳細な評価を行い,最終的に実験で合成・検証する化合物を絞り込んでいくそうです.
まとめ
本シリーズでは,TeachOpenCADD の T001〜T006 および T022 を参考に,EGFR 阻害剤を題材として創薬ケモインフォマティクスの基礎を学びました.
取り組んだ内容を振り返ると:
| 内容 | 手法 |
|---|---|
| データ取得・EDA | ChEMBL,pIC50 の分布確認 |
| フィルタリング | Lipinski(物性),PAINS(偽陽性除外) |
| 類似度検索 | Morgan FP + Tanimoto 類似度 |
| 化学空間の可視化 | t-SNE |
| 共通骨格の探索 | MCS |
| 活性予測 | LightGBM による QSAR,分類への切り替え |
活性予測では,フィンガープリント + LightGBM で CV R² = 0.673 と,2D 構造情報だけでもある程度の予測が可能であることが分かりました.
また,回帰から分類に切り替えることで Accuracy = 0.844 と実用的な精度が得られるという学びもありました.
データ取得 → フィルタリング → 化学空間の可視化 → 共通構造の探索 → QSAR モデル構築という一連の流れは,様々なトピックに対しても応用できそうで勉強になりました.