
重要度分析レポートを出力する拡張ノードをBobに作成させる
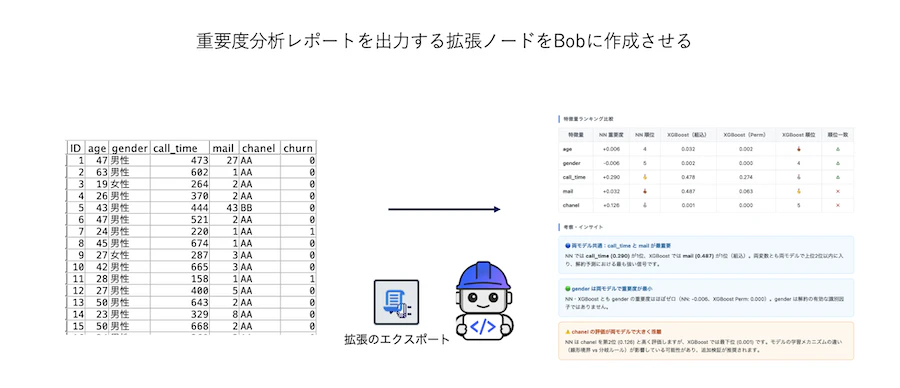
SPSS Modelerにはアルゴリズム毎に重要度を表示させられますがまとめて比較することができません。
1.想定される利用目的
・複数の予測モデルの比較評価
2.サンプルストリームとデータのダウンロード
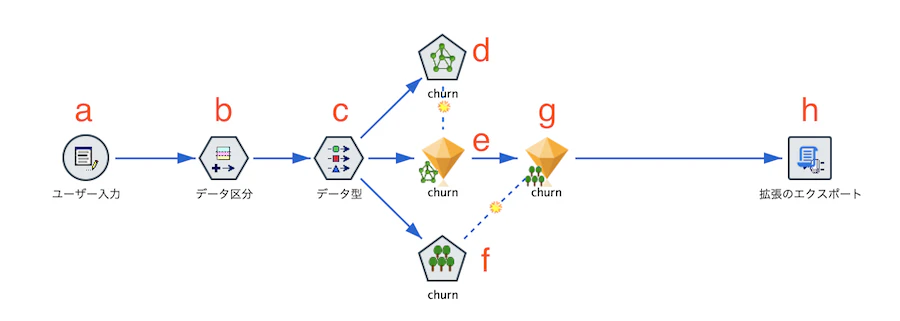
ストリーム
3.サンプルストリームの説明
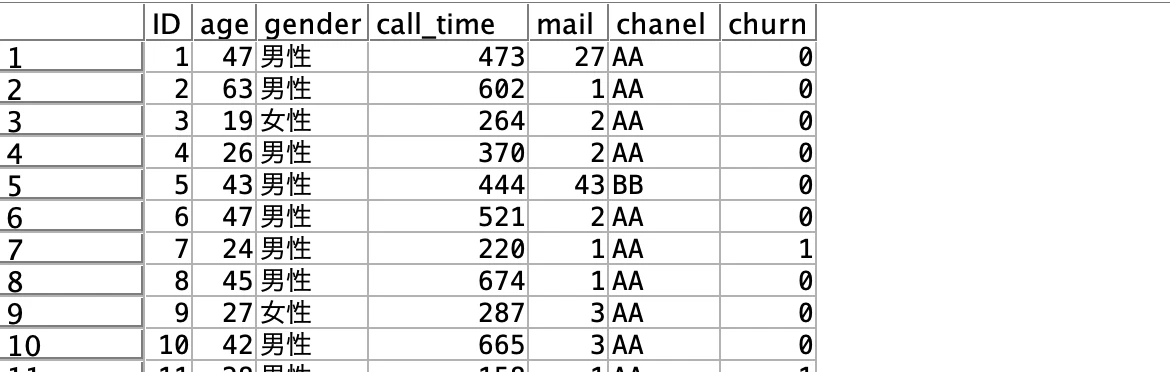
a.入力するデータは以下の通りです。解約(Churn)を予測するためのデータセットです。
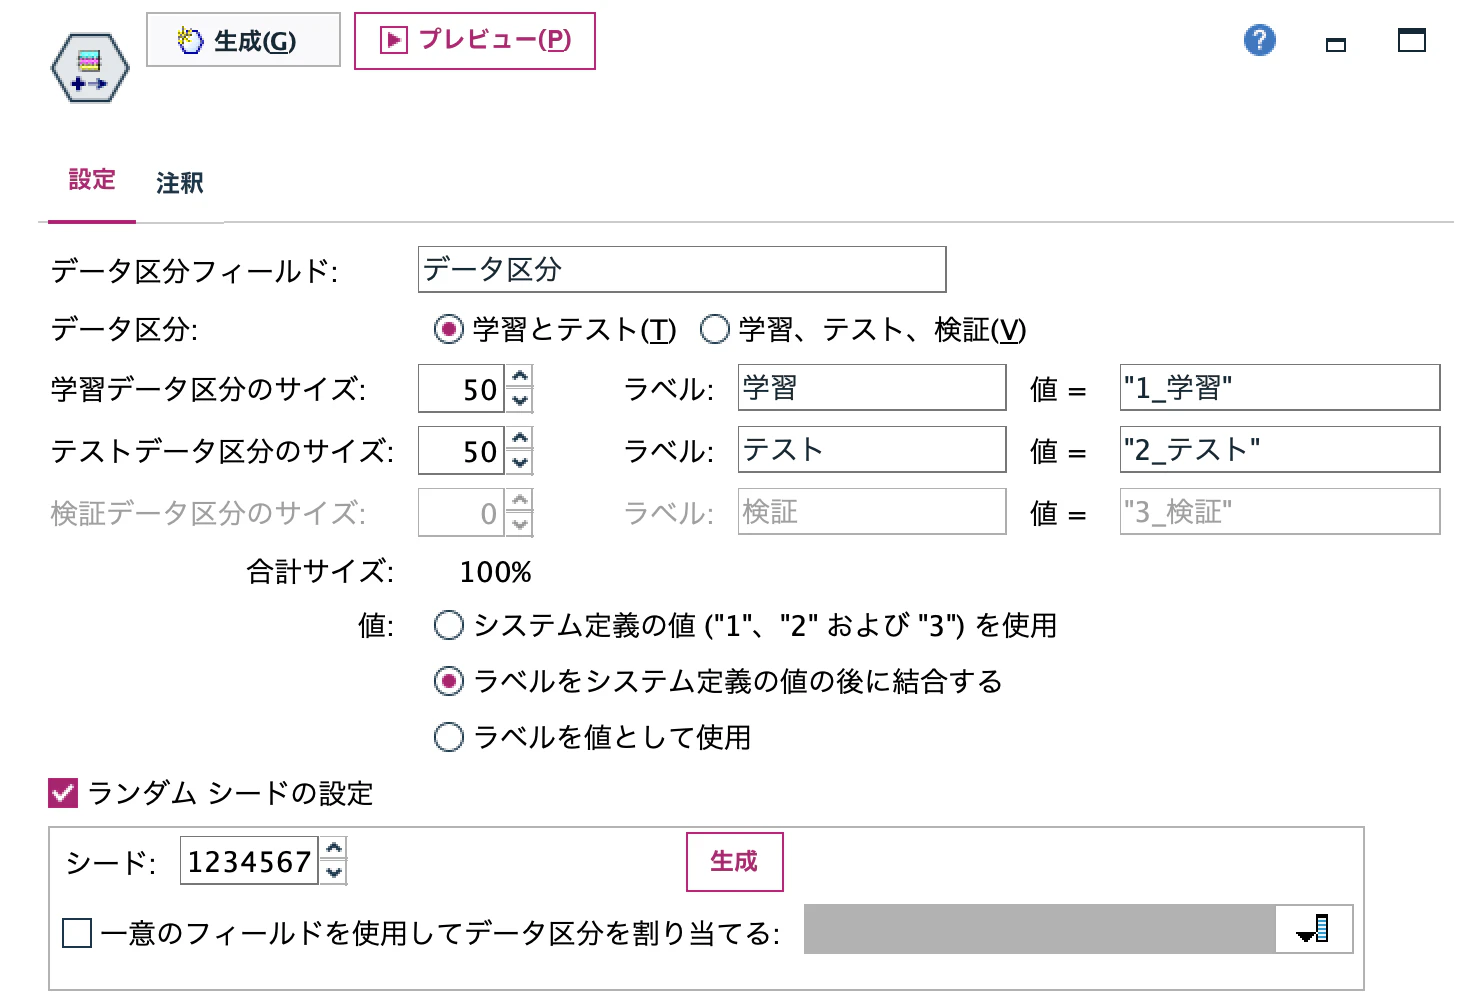
b.[データ区分]ノードを編集します。初期設定を利用します。
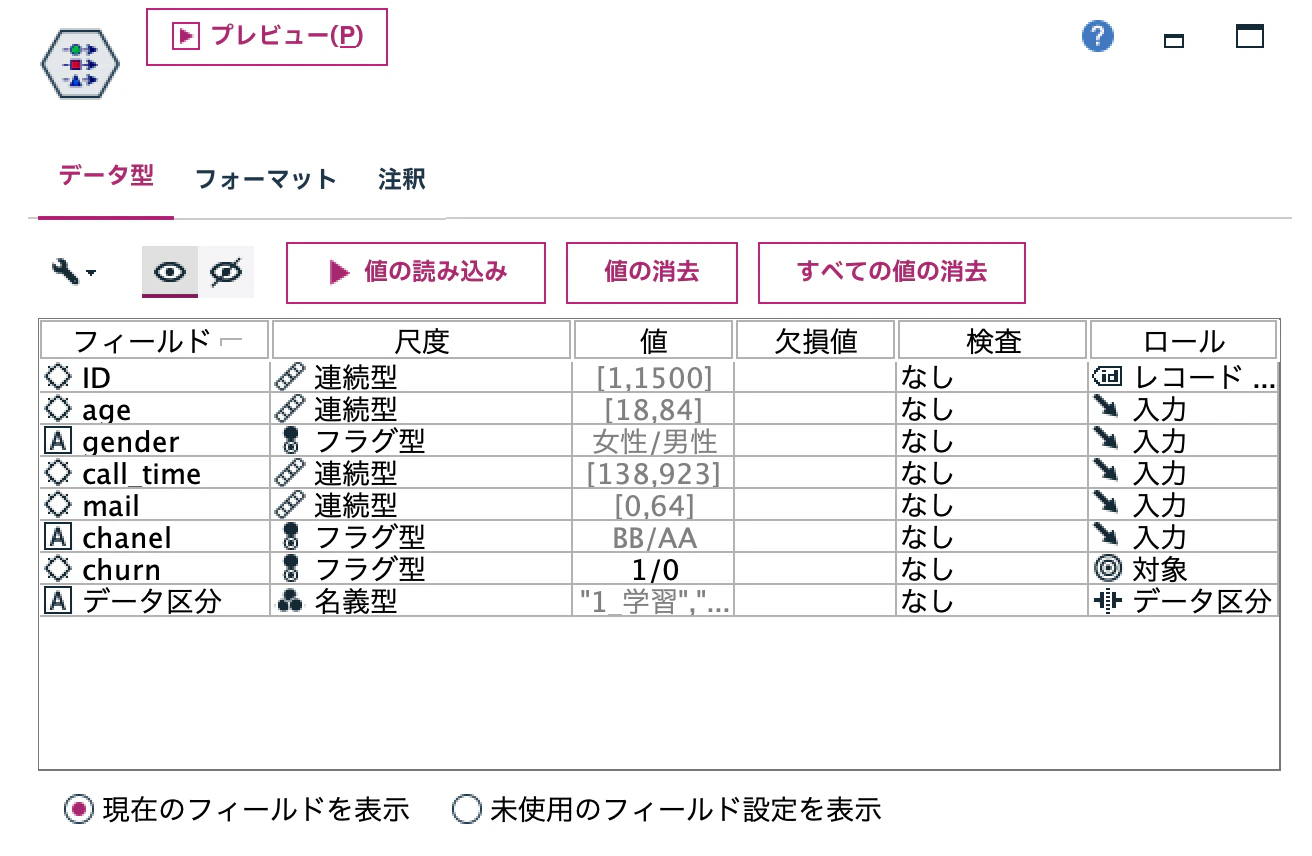
c.[データ型]ノードを編集します。ロールとデータの型を設定します。
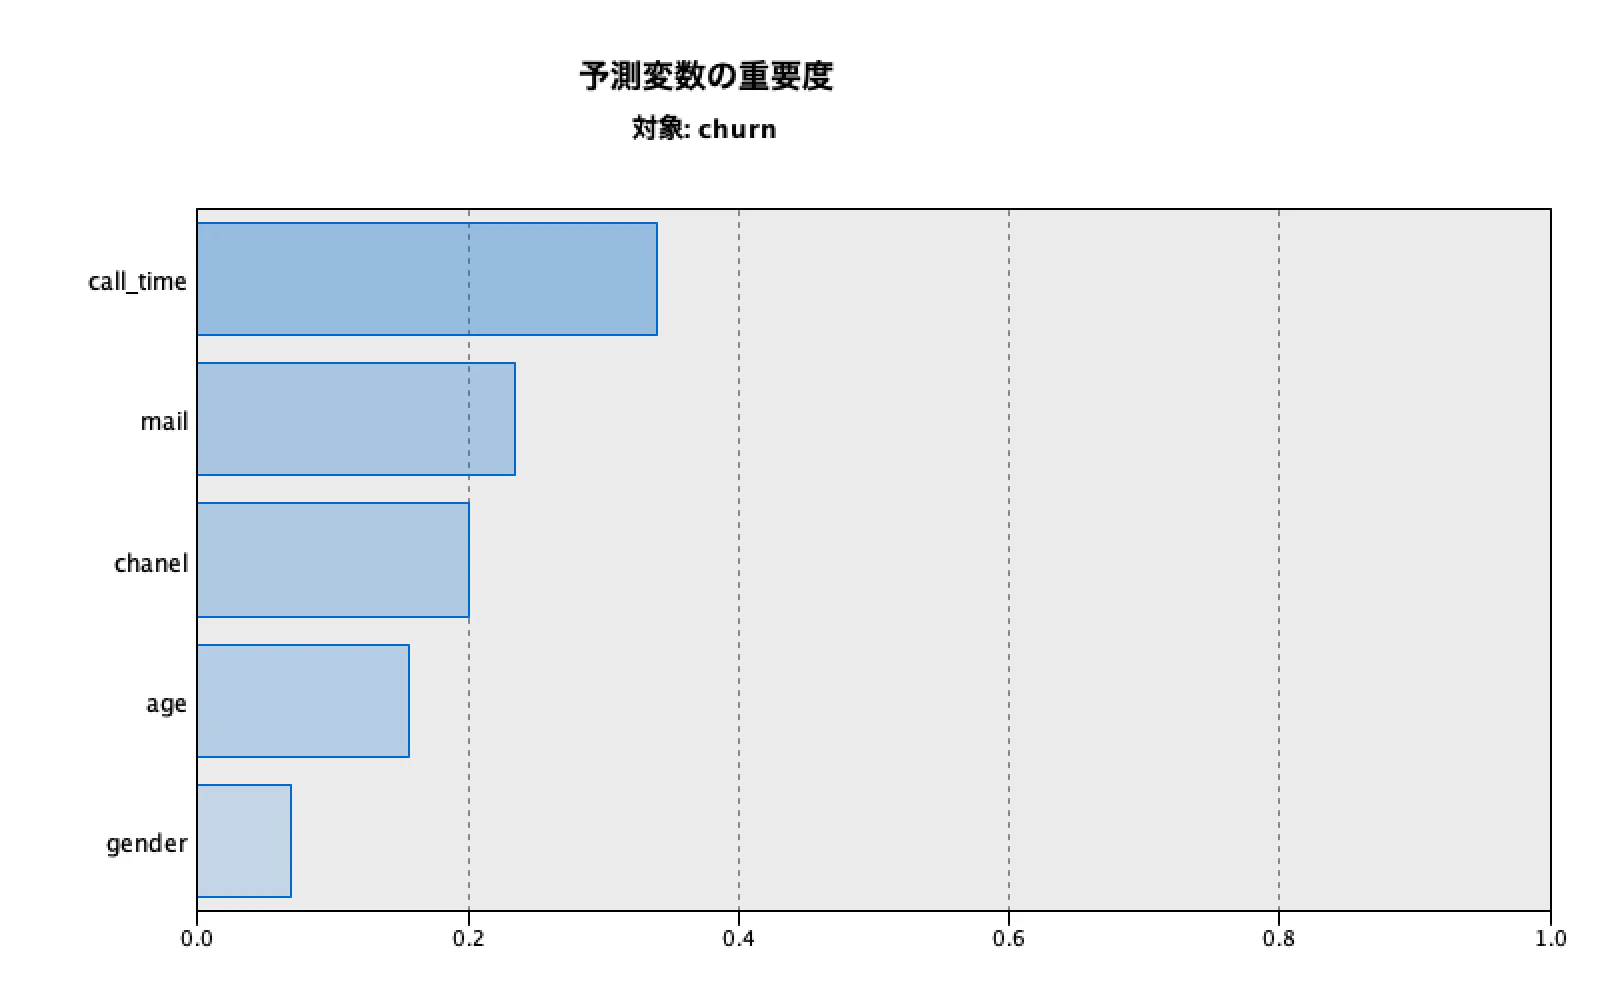
d.[ニューラルネット]ノードを初期設定のまま実行します。
e.[ニューラルネット]モデルナゲットを編集します。重要度分析の表示を確認します。
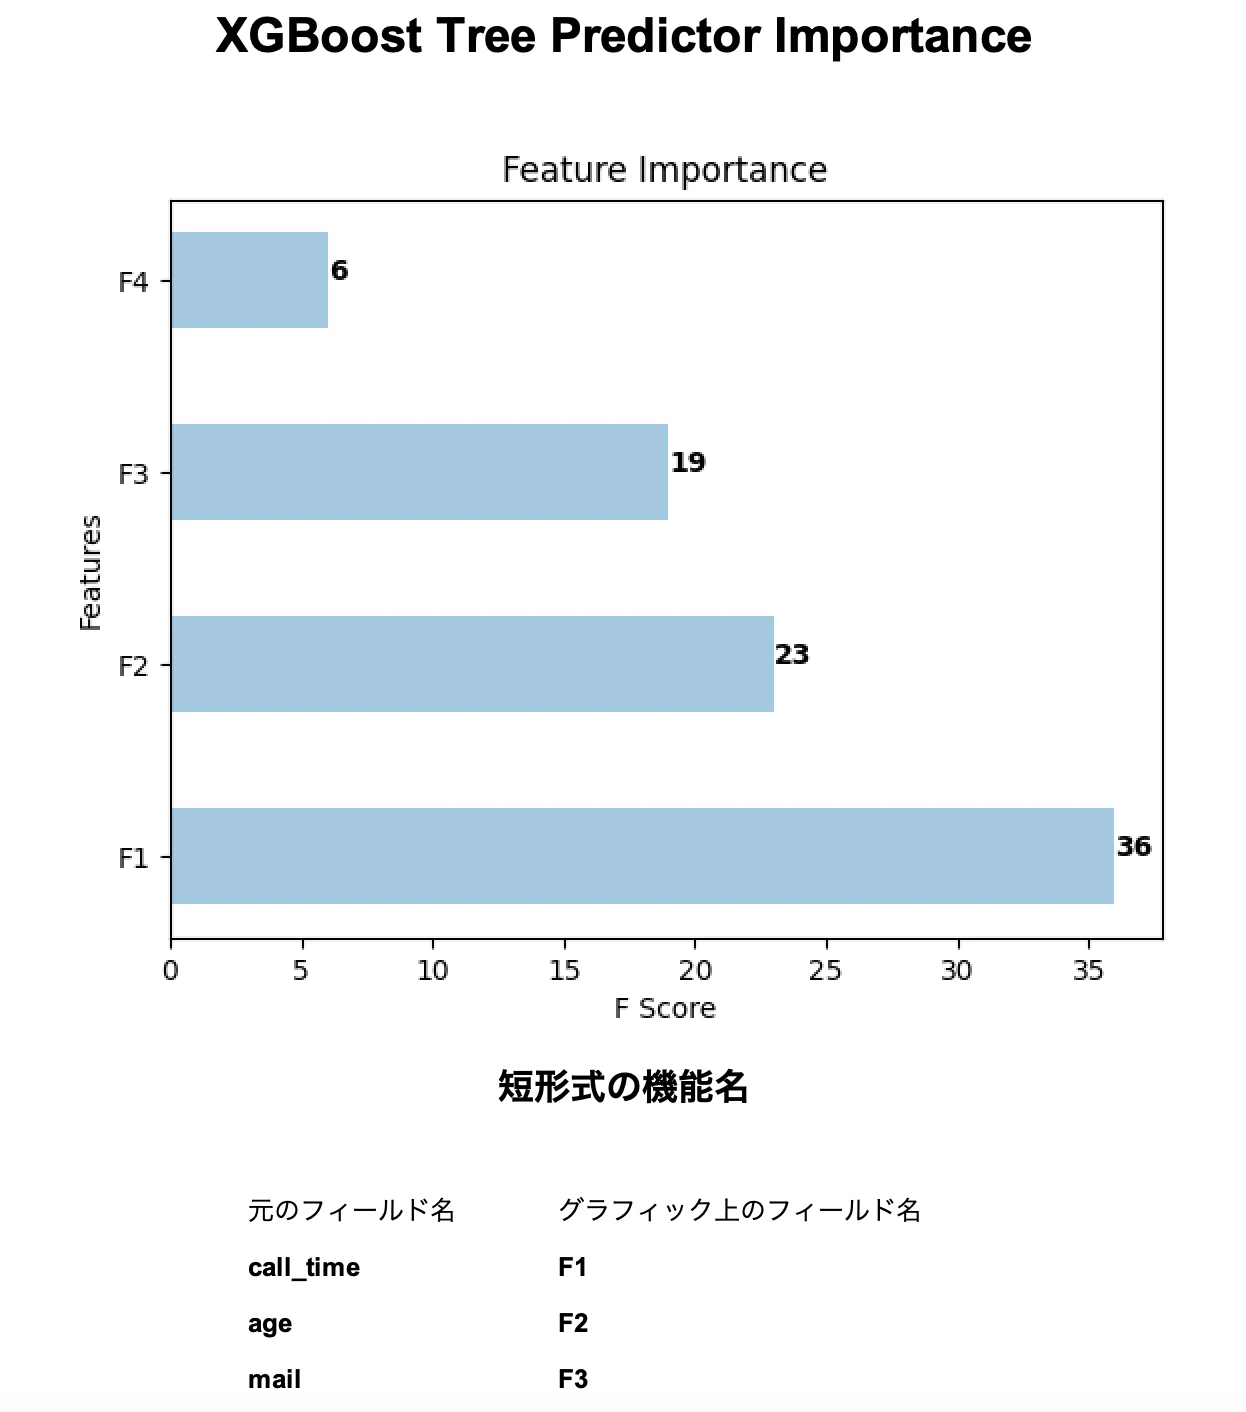
f.[XgBoostツリー]ノードを初期設定のまま実行します。
g.[XgBoostツリー]モデルナゲットを編集します。重要度分析の表示を確認します。
h.[拡張のエクスポート]ノードを編集します。スクリプトをどのようにBobに書かせたかは後述します。
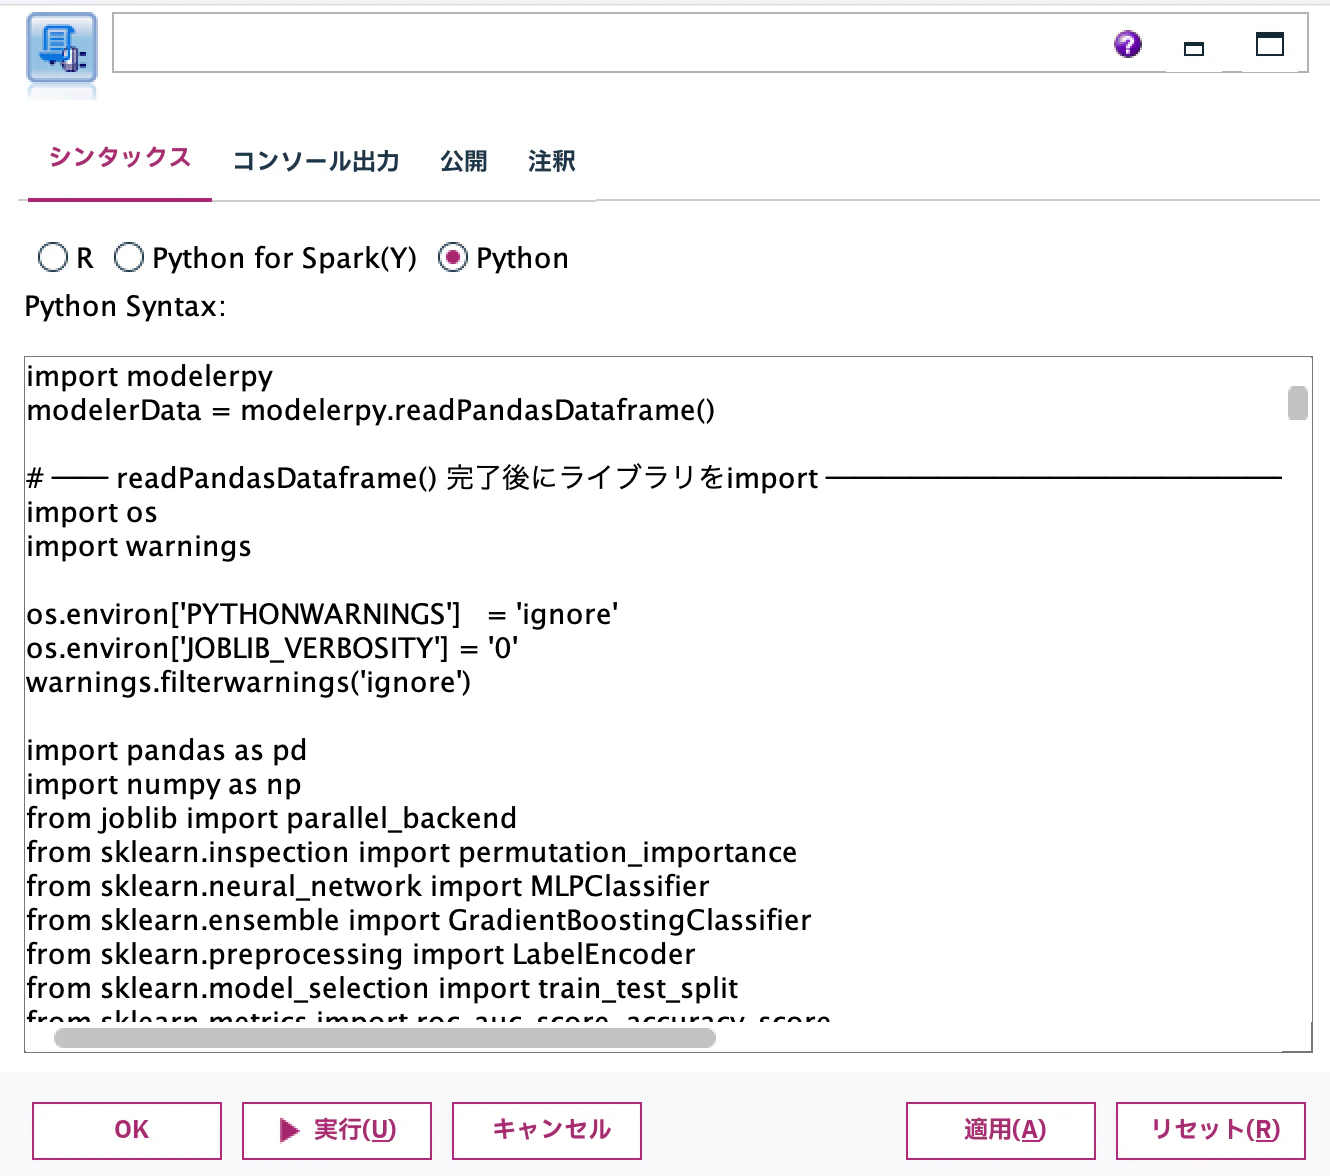
[実行]します。デスクトップにHTMLファイルが生成されます。
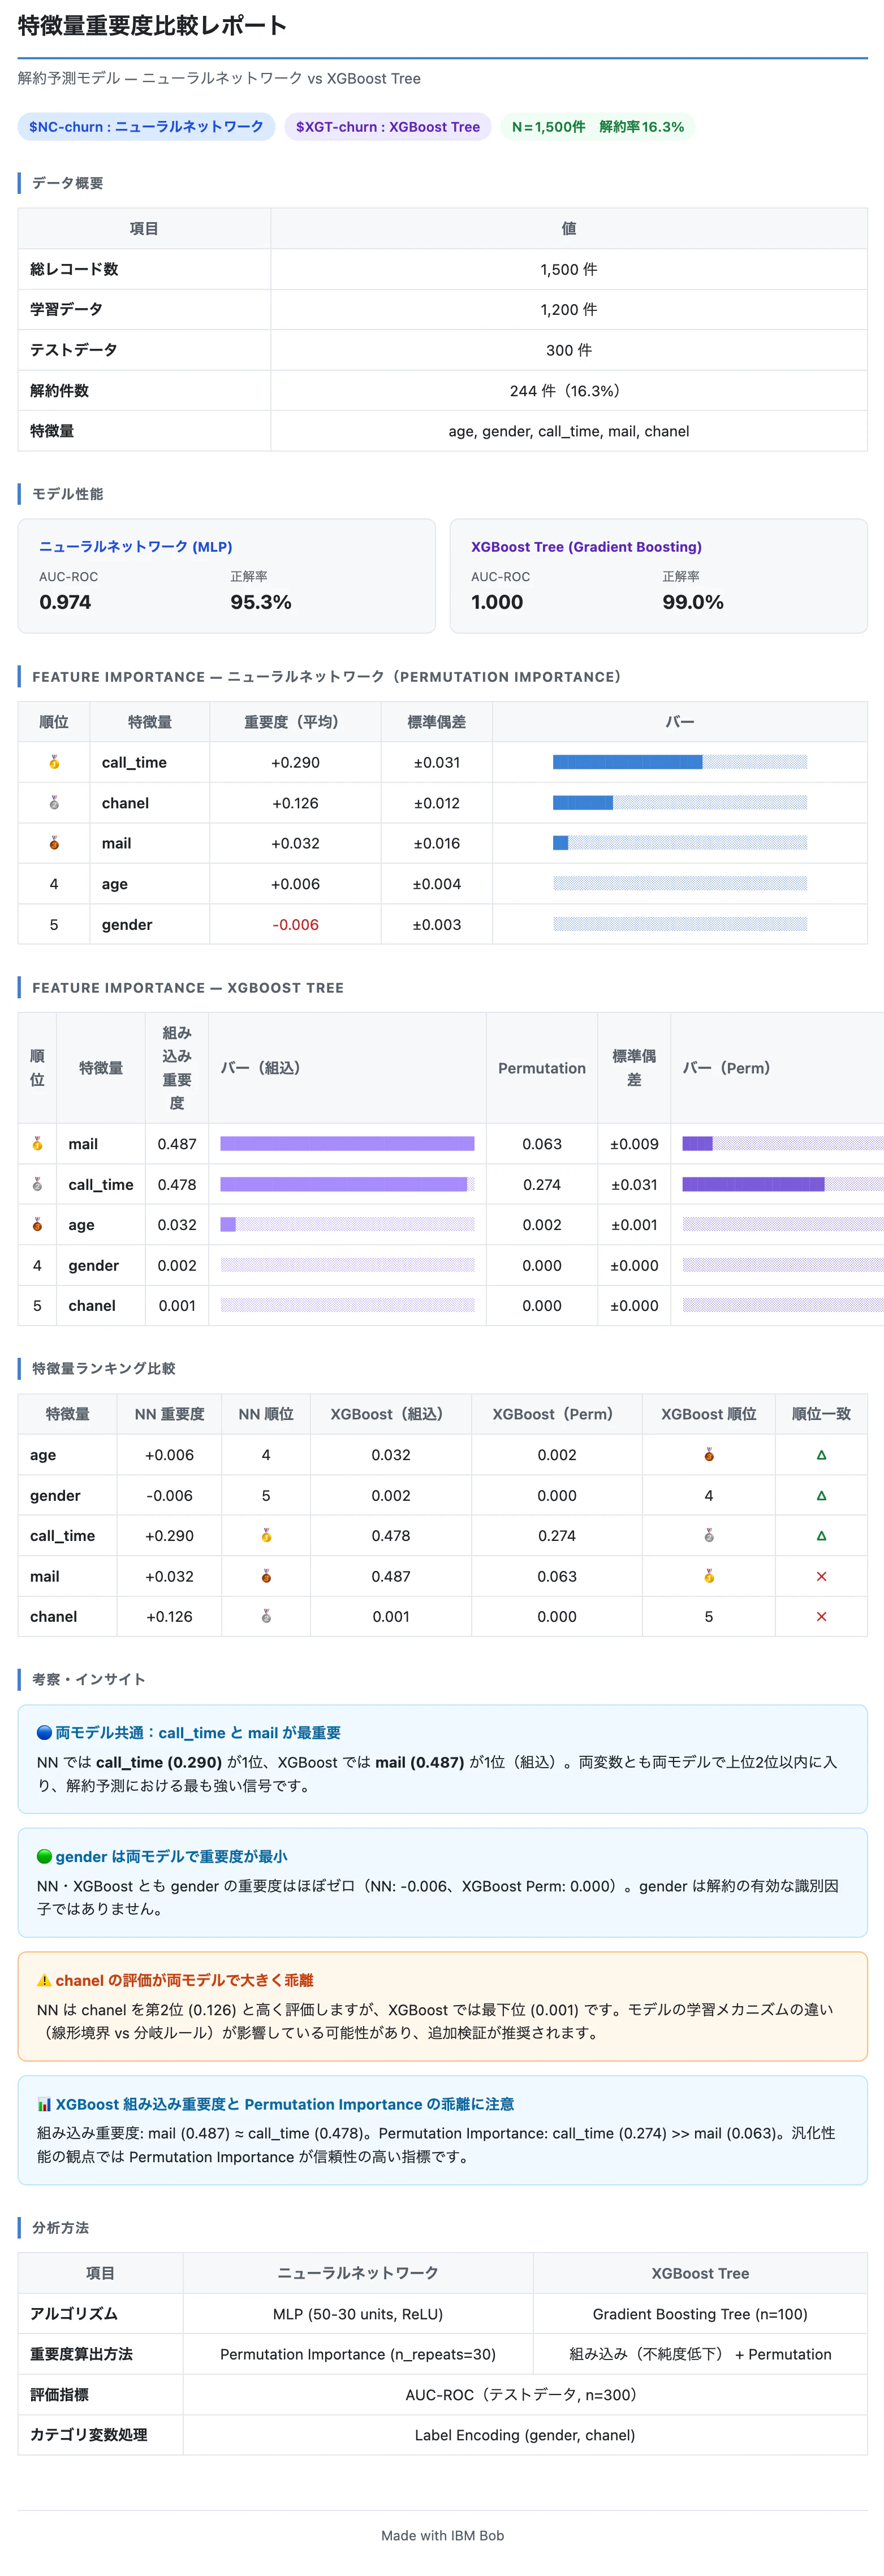
HTMLファイルの内容を確認します。
Bobによるスクリプトの作成手順
1.Bobを起動して、作業フォルダを指定します。

2.SPSS Modeler[拡張のエクスポート]ノードからサンプル構文をコピーします。

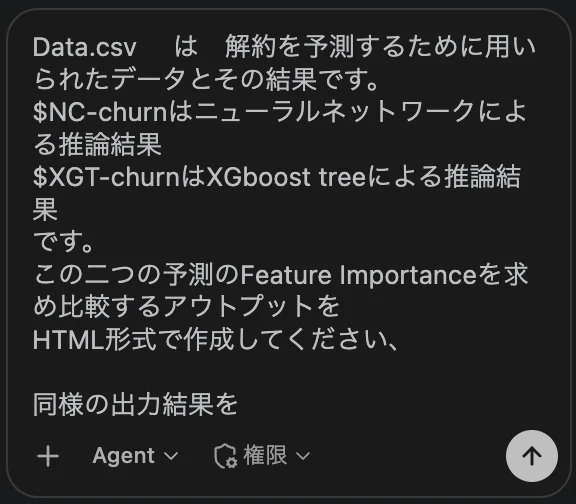
3.プロンプトを作成します。サンプル構文をペーストします。
プロンプト
Data.csv     は 解約を予測するために用いられたデータとその結果です。
$NC-churnはニューラルネットワークによる推論結果
$XGT-churnはXGboost treeによる推論結果
です。
この二つの予測のFeature Importanceを求め比較するアウトプットを
HTML形式で作成してください、

同様の出力結果を

SPSS Modelerの拡張の出力ノードで表示するするネイティブPython APIスクリプトを書いてください。

- 拡張の出力ノードのスクリプトの解説として
@https://www.ibm.com/docs/ja/spss-modeler/18.6.0?topic=spark-native-python-apis を参考にしてください。
- シバンは不要です。

###Use this code to import data from Modeler to Python
#import modelerpy
#modelerData = modelerpy.readPandasDataframe()
#modelerDataModel = modelerpy.getDataModel()
4.プロンプトを実行します。
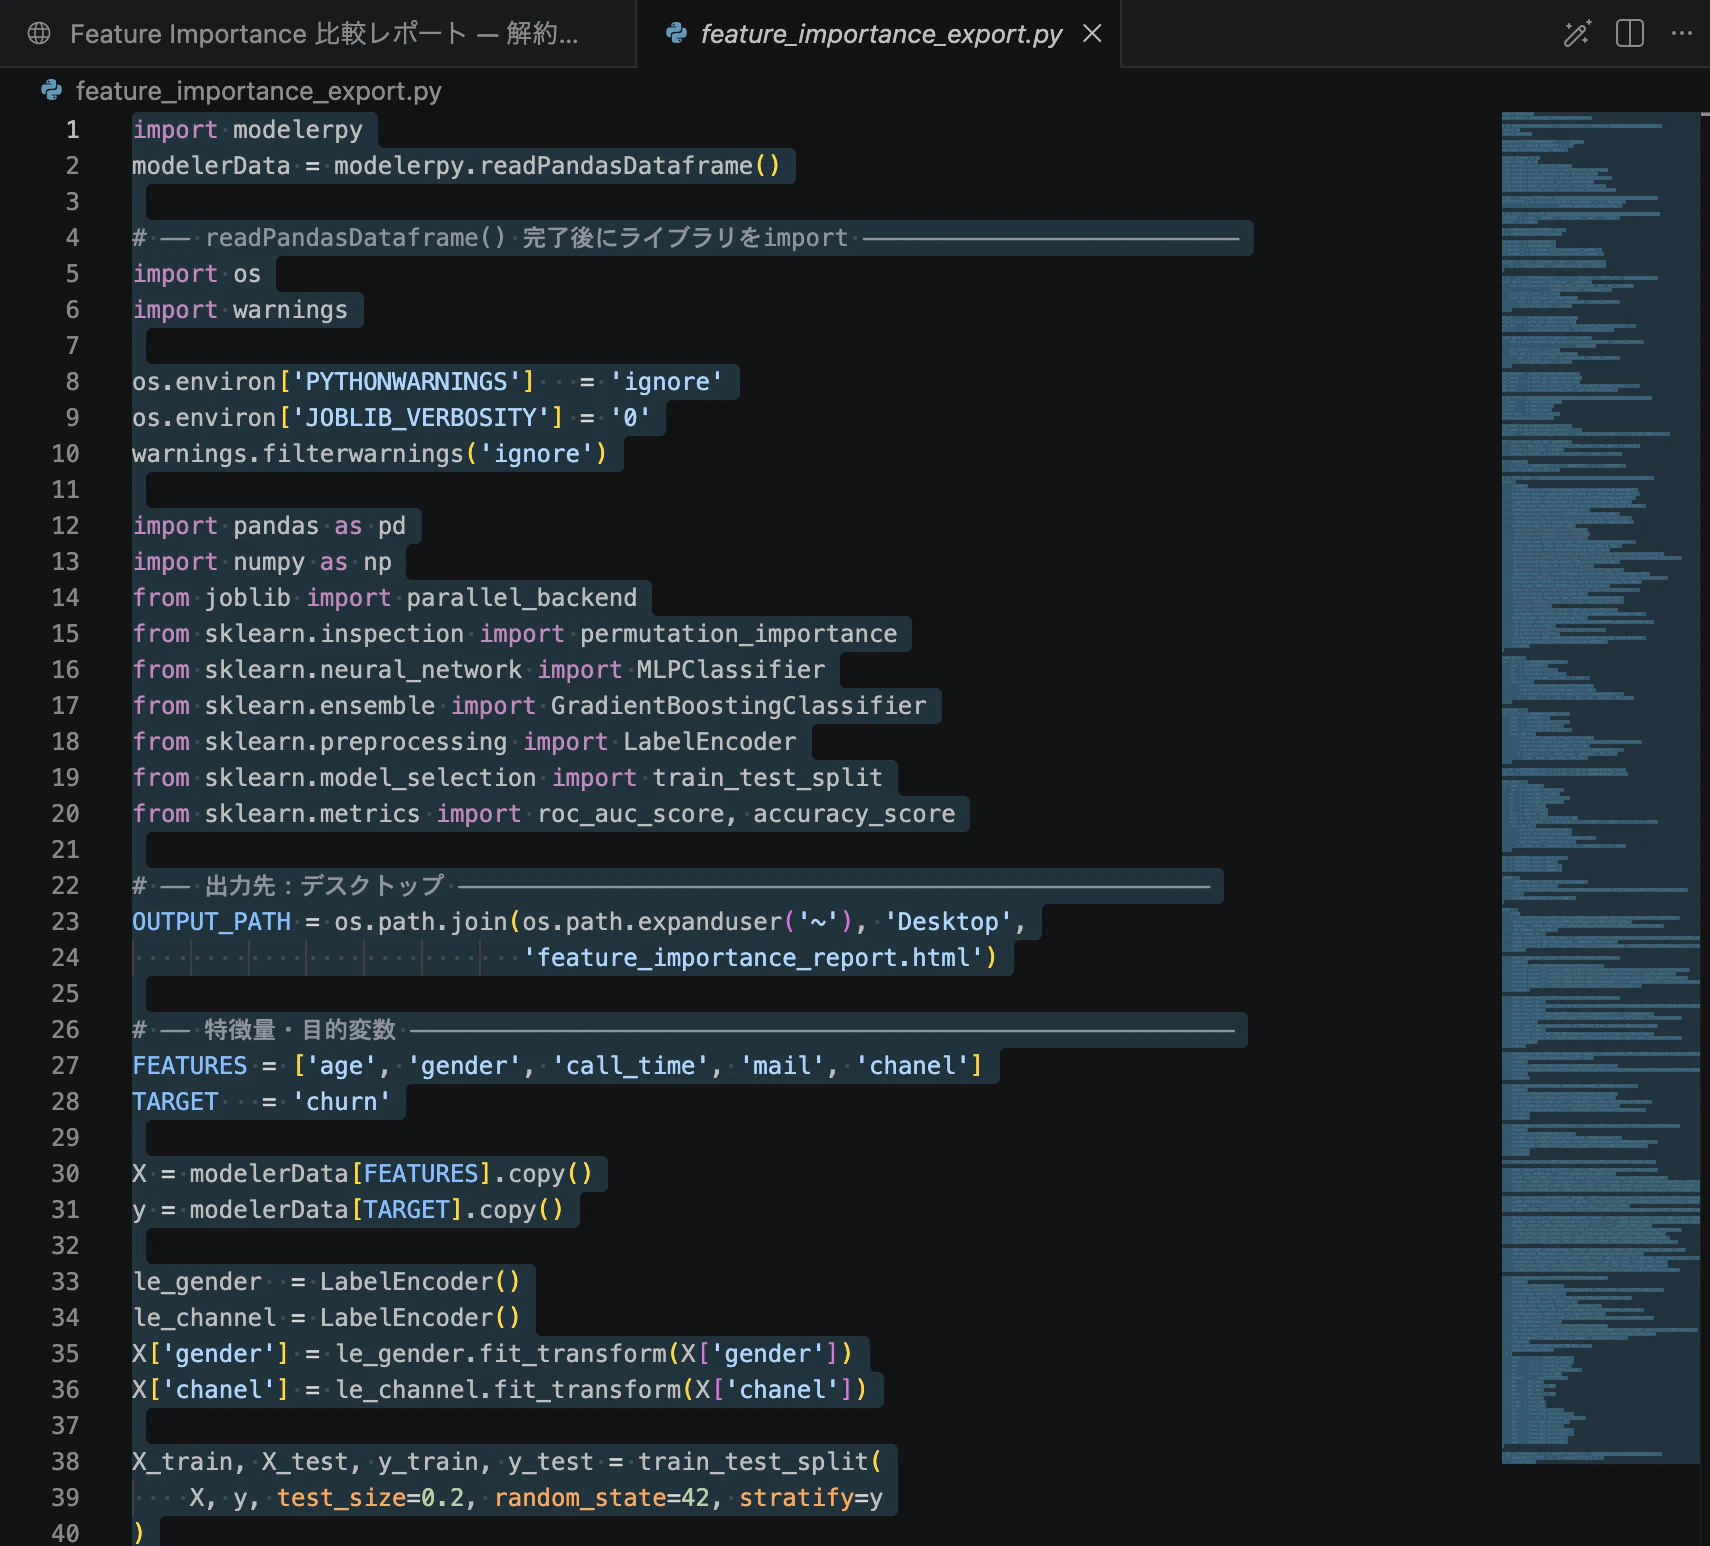
5.拡張のエクスポート内で利用するpythonスクリプトが生成されます。
注意事項
複数モデルがどの入力変数を重視したかを検討するために利用します。単独モデルの利用は従来通りの方法で解釈します。
4.参考情報
Bobと拡張ノードで外部の地図に座標地点を描画させる
SPSS Modeler ノードリファレンス目次
SPSS Modeler 逆引きストリーム集(データ加工)