
はじめに
自己紹介
皆さん、こんにちは、Udemy講師の斉藤賢哉です。私はこれまで、約30年にわたって企業システムの開発に携わってきました。現在も現役のアーキテクトとして、重要システムの技術設計やソリューションの選定を担当しています。直近では、システム開発へのAI適用(AI駆動開発)という全社的な施策でリーダーを務めています。
セミナーでの登壇や雑誌への技術記事の寄稿を行ってきたほか、以下の書籍も執筆しています。
- 「マスタリング Java EE 5」(翔泳社、2007年)
- 「アプリケーションアーキテクチャ設計パターン」(技術評論社、2017年)
- 「Javaエンジニアのためのソフトウェアテスト実践入門」(技術評論社、2024年)
Udemy講座のご紹介
この記事の内容は、私が講師を務めるUdemy講座『新 Java Advanced編 / AI対応版』の一部の範囲をカバーしたものです。『新 Java Advanced編 / AI対応版』はこちらのリンクから購入できます。
この講座は、以下のような皆様にお薦めします。
- Javaの基礎を学び終え、設計とレビューができるエンジニアを目指す方
- AIが書いた並行処理や入出力のコードに潜むリスクを、仕組みから見抜けるようになりたい方
- フレームワークの裏で使われるリフレクションやアノテーションの仕組みを理解したい方
- 「Oracle認定Javaプログラマ」Goldの範囲を、仕組みから理解したい方
AIとチャットできるオールインワンの学習環境をリリースしました
Udemy講座の演習を動かすための学習環境として、Windows向けのデスクトップアプリ「Codinable(コーディナブル)」をリリースしました。
エディタ、実行結果、テスト結果、SQL、Webブラウザ、そしてAIチャットを1つの画面にまとめた、オールインワンの学習環境です。
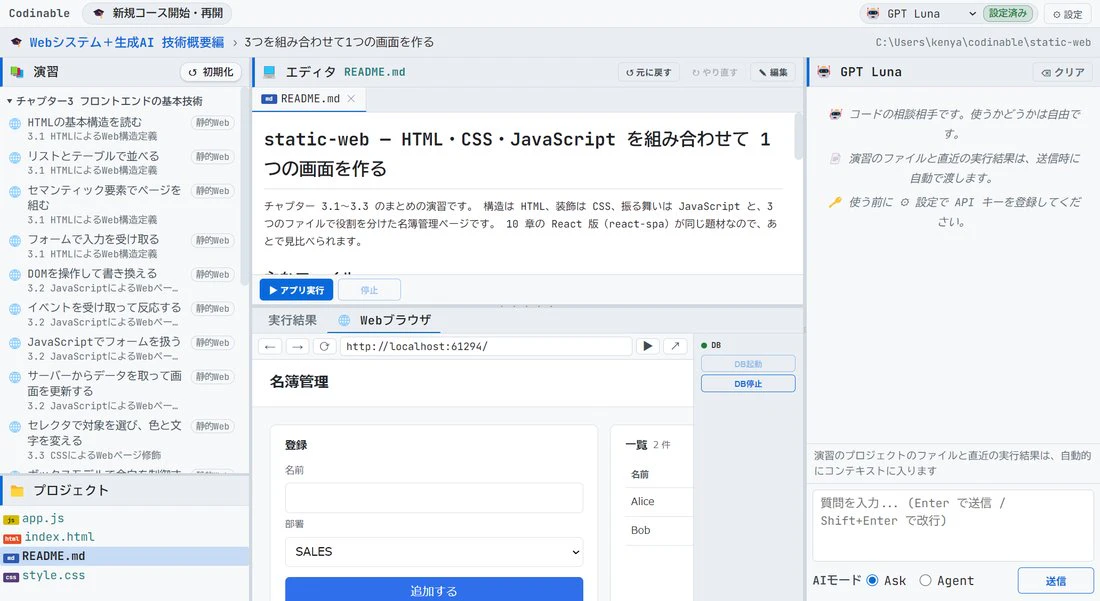
学習に必要なものは、すべてCodinableの中で完結します。
- 演習の実行環境(Java 25、Gradle、Bashなど)が一式同梱されており、JDKのインストールや環境変数の設定は不要です
- インストールして「新規コース開始・再開」からコースを選ぶだけで、講座のすべての演習がそのまま動きます
- 書き換えて動かなくなっても、「初期化」で配布時の状態に戻せます
- 開いている演習のファイルと実行結果を踏まえて、AIに質問したり(Askモード)、ファイルの書き換えを指示したり(Agentモード)できます
AIに書き換えを指示し、差分を確かめてから実行する、というAI駆動開発の基本の流れを、Codinableの中だけで安全に体験できます。

AIチャットは、受講者ご自身が生成AIサービス(Anthropic、OpenAI、Googleのいずれか)のAPIキーを登録して使うBYOK(Bring Your Own Key)方式です。利用料金は各社から直接請求されます。APIキーを登録しなくても、AIチャット以外の機能はすべて使えます。
Codinableのインストーラは、以下のGitHubのReleasesページからダウンロードできます(64ビット版のWindows 10/11、管理者権限は不要)。
この記事を含むシリーズ全体像
この記事はJava SEの一部の機能・仕様を取り上げたものですが、一連のシリーズになっており、シリーズ全体でJava SEを網羅しています。また認定資格である「Oracle認定Javaプログラマ」(Silver、Gold)の範囲もカバーしています。シリーズの全体像および「Oracle認定Javaプログラマ」の範囲との対応関係については、以下を参照ください。
3.1 スレッドの仕組みとスレッドセーフ
チャプターの概要
本チャプターでは、マルチスレッドのプログラムがどのように動くのかを、メモリーの配置と時間の流れの図で取り上げます。スレッドごとに持つスタックと全スレッドで共有するヒープの関係から出発し、競合状態、可視性、同期化とロック、デッドロック、スレッド間通信、共有しない設計(イミュータブルとスレッドローカル)、仮想スレッドを順に整理します。並行処理の不具合は、テストで再現しにくく、コードを読んだだけでは気付きにくいものです。AIが書いた並行処理のコードをレビューするときに「どこが共有され、誰がいつ書き換えるか」を判断できるようになることが、本チャプターの目標です。チャプター3.2と3.3で取り上げる並行処理ユーティリティは、本チャプターの仕組みの上に成り立っています。
3.1.1 スレッドとメモリーの関係
本レッスンでは、スレッドが何を個別に持ち、何を共有しているかを整理します。この区別が、以降のすべてのレビューの出発点になります。
プロセス・スレッドとメモリー
プロセスとは、プログラムの実行単位のことです。Javaでは、メインクラスを実行するとJVMという1つのプロセスが立ち上がり、mainメソッドを実行するメインスレッドが起動します。スレッドとは、プロセスの中で命令を逐次的に実行する単位で、1つのプロセスの中に複数のスレッドを持てます。
スレッドとメモリーの関係を、図で確かめます。

- 1つのJVMプロセスの中に、メインスレッド、スレッドA、スレッドBの3つのスレッドがある
- 各スレッドは自分専用のスタックを持ち、メソッドのローカル変数と引数はそのスタックに置かれる
- ヒープは1つだけで、
newで生成したインスタンス(例:Sharedインスタンス)はヒープに置かれる - スレッドAのスタックの変数
sharedとスレッドBのスタックの変数sharedから、ヒープ上の同じSharedインスタンスへ矢印が向かう - ラベル「ローカル変数はスレッドごと」「インスタンスのフィールドは共有され得る」
ローカル変数は他のスレッドから見えないため、それだけを使う処理は安全です。問題が起きるのは、複数のスレッドがヒープ上の同じインスタンスへの参照を持ち、そのフィールドを書き換えるときです。レビューでは「この変数はスタックにあるのか、ヒープ上の共有インスタンスのフィールドなのか」を最初に見分けます。
逐次処理・並列処理と非同期呼び出し
逐次処理とは、タスクを順番に処理することです。並列処理とは、複数のスレッドでタスクを同時に処理することで、CPUのコアを有効に使い、スループット(単位時間あたりの処理量)を高めます。なお、並行処理は「複数のタスクを切り替えながら、同時に動いているように見せること」で、並列処理を含む上位の概念です。
逐次処理とマルチスレッドによる並列処理の違いを、図で比較します。

- 左の逐次処理では、1つのスレッド①が処理A、処理B、処理Cを順に実行する
- 右の並列処理では、スレッド①、スレッド②、スレッド③が処理A、処理B、処理Cを同時に実行する
- 並列処理では、全体の処理時間が短くなる
スレッドの起動は、一種の非同期呼び出しです。同期呼び出しでは呼び出し元が結果を待ちますが(ブロッキング)、別スレッドとして起動した処理の終了は待ちません。

- 上段の同期呼び出しでは、FooがBarを呼び出し、Barの処理中はFooが待機する(ブロッキング)
- Barの処理が終わると、戻り値がFooへ返る
- 下段の非同期呼び出しでは、FooがBarのスレッドを起動し、FooとBarが並列して処理を進める
- Fooは、Barの実行結果を何らかの方法で受け取る(受け取らないこともある)
非同期に起動した処理の結果を受け取る仕組みは、チャプター3.2のExecutorフレームワーク参照。
スレッドの作成とstart()
スレッドはjava.lang.Threadクラスで表し、実行するタスクはrun()メソッドに書きます。タスクをRunnableインタフェース(またはラムダ式)で作り、Threadに渡す方法が一般的です。Threadを継承してrun()をオーバーライドする方法もあります。
- 03_thread_concurrent: pro.kensait.java.advanced.lsn_3_1_1.runnable.Main_Lambda
int data = 3;
Thread t = new Thread(() -> { //【1】
    // dataを1000億回足し込むタスク(省略)
});
System.out.println("[ Main ] start");
t.start(); //【2】
System.out.println("[ Main ] finish");
- 【1】
Runnableは抽象メソッドを1つだけ持つ関数型インタフェースのため、タスクをラムダ式で書けます。ラムダ式から参照するローカル変数dataは、実質的にfinalである必要があります。 - 【2】
start()を呼ぶと、新しいスレッドが作られ、その上でrun()が実行されます。メインスレッドは終了を待たずに次の行へ進むため、[ Main ] finishが先に表示されます。
start()とrun()の直接呼び出しは、見た目が似ていても動きがまったく異なります。

- 左は
t.start()の場合で、メインスレッドのスタックとは別に新しいスレッドのスタックが作られ、run()のフレームはそちらに積まれる - 右は
t.run()の場合で、新しいスタックは作られず、run()のフレームはメインスレッドのスタックに積まれる - 左ではメインスレッドと新しいスレッドが並列に進み、右ではメインスレッドが
run()の終了まで待つ - 下に「
run()の直接呼び出しはただのメソッド呼び出しで、マルチスレッドにならない」と注記がある
レビューの観点
-
run()を直接呼び出していないか。並列に動かすつもりならstart()(またはExecutorへの投入)になっているかを確かめる - スレッドの間で受け渡しているのが、ローカル変数(安全)なのか、共有インスタンスのフィールド(要注意)なのかを見分ける
- スタティックフィールドや、シングルトンのインスタンスのフィールドに、リクエストごとの値を書き込んでいないか(すべてのスレッドで共有される)
- 本番のコードで
Threadを大量に直接生成していないか。多くの場合はExecutor(チャプター3.2参照)に任せるべきである
3.1.2 スレッドの状態と待ち合わせ・割り込み
本レッスンでは、スレッドが起動から終了までにたどる状態と、待ち合わせ(join())、一時停止(sleep())、割り込み(interrupt())の関係を整理します。止まらないスレッドや、割り込みを握りつぶすコードを見抜けるようになります。
スレッドの状態遷移
start()を呼ぶと、スレッドは「実行可能状態」(CPUの割り当て待ち)になり、CPUが割り当てられると「実行状態」になります。一時停止、待ち合わせ、wait()、ロックの解放待ちで「待機状態」に入り、条件が整うと実行可能状態に戻ります。
スレッドの状態遷移を、図で整理します。

- 初期状態のスレッドは、start()を呼ぶと実行可能状態(CPUの割り当て待ち)になる
- CPUが割り当てられるとrun()が呼ばれ、実行状態(タスクの実行中)になる
- sleep()による一時停止、join()による待ち合わせ、wait()による待機、ロックの解放待ちで、待機状態(タスクの中断中)になる
- sleep()の終了、join()の待ち合わせの終了、notify()による再開、ロックの取得で、実行可能状態に戻る
- run()が終了すると、終了状態になる
Javaでは、状態は列挙型Thread.Stateで定義され、getState()で取得できます。スレッドダンプ(実行中の全スレッドの状態とスタックトレースの一覧)でもこの名前が表示されるため、止まったプログラムの調査で役立ちます。
【表】Thread.Stateの定数と本チャプターの状態の対応
| 定数 | 本チャプターの状態 | 遷移する主な契機 |
|---|---|---|
NEW |
初期状態 | スレッドを生成した直後 |
RUNNABLE |
実行可能状態、実行状態 |
start()の呼び出し(JVMは両者を区別しない) |
BLOCKED |
待機状態 | 同期化によるロックの解放待ち |
WAITING |
待機状態 |
join()やwait()による、時間の指定のない待機 |
TIMED_WAITING |
待機状態 |
sleep()や、時間を指定したjoin()、wait()による待機 |
TERMINATED |
終了状態 |
run()の終了 |
join()による待ち合わせ
join()は、呼び出したスレッドを、対象のスレッドが終了するまで待たせます。次のコードは、8秒かかるスレッドt1と5秒かかるスレッドt2を起動し、両方の終了を待ちます。
- 03_thread_concurrent: pro.kensait.java.advanced.lsn_3_1_1.join.Main
MyParaThread t1 = new MyParaThread("foo", 8000L); // 8秒間一時停止するスレッド
t1.start();
MyParaThread t2 = new MyParaThread("bar", 5000L); // 5秒間一時停止するスレッド
t2.start();
t1.join(); //【1】
t2.join(); //【2】
System.out.println("メインスレッド終了"); //【3】
- 【1】t1の終了まで、メインスレッドが待機します。
- 【2】t2は5秒の時点で終わっているため、ここではすぐに処理が進みます。
- 【3】2つのスレッドが両方とも終了してから表示されます。
join()はInterruptedExceptionを送出する可能性があります。
3つのスレッドの時間の流れを、タイムラインで確かめます。

- 横軸は時間(0秒〜8秒)で、上からメインスレッド、t1("foo")、t2("bar")の3本の帯が並ぶ
- 0秒の時点で、メインスレッドがt1とt2を
start()する - t1の帯は0秒から8秒まで、t2の帯は0秒から5秒まで続く
- メインスレッドの帯は0秒から8秒まで「t1.join()で待機(WAITING)」と表示される
- 5秒の時点でt2が終わり、8秒の時点でt1が終わると、メインスレッドが「メインスレッド終了」を表示する
割り込みによる協調的な停止
スレッドを外から強制的に止めるstop()は、ロックを不整合な状態のまま解放する危険があるため、現在のJavaでは使えません。止めたいスレッドにはinterrupt()で割り込みを通知し、スレッド自身がそれに応じて処理を終えます。sleep()やjoin()、wait()で待機中のスレッドに割り込むと、InterruptedExceptionが送出されます。
割り込みが届いてから停止するまでの流れを、図で示します。

- 左のメインスレッドが、右のワーカースレッドに対して
interrupt()を呼び出す - ワーカースレッドには「割り込み状態」のフラグが立つ
- ワーカースレッドが
sleep()で待機中ならInterruptedExceptionが送出され、計算のループ中ならThread.currentThread().isInterrupted()で気付く - ワーカースレッドは後片付けをして
run()を抜け、終了状態になる - 下に「割り込みは停止の要求の通知であり、強制停止ではない。応じるかどうかはスレッド側のコードで決まる」と注記がある
InterruptedExceptionをcatchして何もしないと、割り込みの通知が消え、スレッドは止まりません。
// 問題のあるコード:割り込みを握りつぶす
try {
    Thread.sleep(1000);
} catch (InterruptedException e) {
    // 何もしない
}

// 良いコード:割り込み状態を立て直して、呼び出し元に伝える
try {
    Thread.sleep(1000);
} catch (InterruptedException e) {
    Thread.currentThread().interrupt();
    return; // 処理を終える
}
- 例外が送出されると割り込み状態のフラグはクリアされるため、そのまま処理を続けると、停止の通知が失われます。
- 自分で処理を終えないときは、
Thread.currentThread().interrupt()で割り込み状態を立て直すか、例外を呼び出し元へ伝えます。
レビューの観点
-
catch (InterruptedException e) {}のように、割り込みを握りつぶしていないか - 長いループや無限ループのタスクが、割り込み(
isInterrupted())や停止の合図を確認しているか。確認しないタスクはshutdownNow()でも止まらない -
join()や待機に、必要ならタイムアウトが付いているか(相手が終わらないと永久に待つ) - 実行順序を
sleep()の時間で調整していないか。sleep()は順序を保証しない。待ち合わせにはjoin()や同期化支援(チャプター3.3参照)を使う
3.1.3 競合状態・可視性と同期化
本レッスンでは、共有インスタンスを複数のスレッドが書き換えるときに起きる「競合状態」と「可視性」の問題、そしてsynchronizedによる同期化を取り上げます。並行処理の不具合のうち、テストで最も見つけにくい種類です。
競合状態と更新の消失
2つのスレッドが同じSharedインスタンスに値を足し込む例を以下に示します。addData()は「読み出す→計算する→書き戻す」の3段階に分かれています。
- 03_thread_concurrent: pro.kensait.java.advanced.lsn_3_1_2.unsafe.Shared
public class Shared {
    private int data;

    public Shared(int data) {
        this.data = data;
    }

    public void addData(int num) {
        int tmp = this.data + num; //【1】
        sleepAWhile(10); //【2】
        this.data = tmp; //【3】
    }

    public int getData() {
        return data;
    }
}
- 【1】現在の値を読み出し、加算した結果をローカル変数
tmp(スタック上)に保持します。 - 【2】10ミリ秒の一時停止で、他のスレッドが割り込む機会を意図的に作っています。
- 【3】ヒープ上のフィールド
dataに書き戻します。 -
lsn_3_1_2.unsafe.Mainは、この1つのインスタンスを2つのスレッドに渡し、それぞれが1と2を10回ずつ足し込みます。最終的な値は30になるはずですが、実行するたびに異なる値になります。
このように、複数のスレッドの実行の順序(タイミング)によって結果が変わる状態を、競合状態(レースコンディション)と呼びます。addData()は途中に他のスレッドが割り込める、つまり「アトミック」ではありません。
2つのスレッドの割り込みによって更新が失われる様子を、図で示します。

- スレッド1(加算値1)とスレッド2(加算値2)は、共有インスタンス(Shared)のdataフィールドを更新する
- ①スレッド1がdataの10を読み出し、tmpは11になる
- ②スレッド2も、書き戻される前のdataの10を読み出し、tmpは12になる
- ③スレッド1がdataに11を書き戻す
- ④スレッド2がdataに12を書き戻し、dataは12になる
- 本来は13になるはずが、スレッド1の加算が失われる
sleepAWhile()が無くても、同じことは起こります。count++の1行でさえ、内部では「読み出し・加算・書き込み」の3つの操作に分かれるからです。

- ソースコードの
count++の1行が、矢印で「①読み出し(ヒープのcountを読む)」「②加算(CPUで1を足す)」「③書き込み(ヒープのcountに戻す)」の3つの箱に分解される - 横に、スレッドAとスレッドBの操作が①A、①B、②A、②B、③A、③Bの順に交互に並ぶ例がある
- 結果として、countは2増えるはずが1しか増えない
- 下に「1行に見えてもアトミックとは限らない」と注記がある
可視性の問題
競合状態とは別に、「あるスレッドが書き込んだ値が、別のスレッドからいつ見えるか」という可視性の問題があります。CPUはメモリーの値をコアごとのキャッシュに保持し、JITコンパイラーは値の読み出しをループの外へ移すなどの最適化を行います。そのため、同期化していないフィールドの変更は、別のスレッドからいつまでも見えない可能性があります。
可視性の問題が起きる仕組みを、図で確かめます。

- 上にヒープ上の共有フィールド
running = trueがある - 左のコア1で動くスレッドAが
running = falseを書き込むが、値はまずコア1のキャッシュに入る - 右のコア2で動くスレッドBは、自分のキャッシュ(または最適化で保持した値)の
running = trueを読み続け、ループを抜けない -
volatileやsynchronizedを使うと、書き込みがヒープへ反映され、読み出しは最新の値を見ることが保証される(矢印「書き込み→ヒープ→読み出し」)
停止の合図をフィールドで伝えるコードを比べます。
// 問題のあるコード:別スレッドから見えないことがある
private boolean running = true;

// 良いコード:volatileで書き込みが他のスレッドから見えることを保証する
private volatile boolean running = true;

public void run() {
    while (running) { /* 処理 */ }
}
public void stop() { running = false; } // 別のスレッドから呼ばれる
-
volatileを付けたフィールドは、書き込みが他のスレッドの後続の読み出しから必ず見えます。 - ただし
volatileは「読み出し・加算・書き込み」をまとめてアトミックにはしません。volatile int countにcount++をしても、更新の消失は防げません。
Javaのメモリーモデルでは、「ロックの解放→同じロックの取得」「volatileへの書き込み→その読み出し」「start()の呼び出し→起動したスレッドの処理」「スレッドの終了→join()からの復帰」の前後で、書き込みが見えることが保証されます。この関係を happens-before(先行発生)と呼びます。保証の無い経路で値を受け渡すコードは、可視性の問題を抱えます。
synchronizedによる同期化
同期化とは、あるスレッドがロックを取得している間、同じロックを取得しようとする他のスレッドを待たせる仕組みです(排他制御)。Javaではsynchronizedキーワードを使います。すべてのインスタンスは1つのロック(モニター)を持っており、synchronizedメソッドはthisのロックを、synchronized (obj) { … }ブロックは指定したオブジェクトのロックを取得します。
- 03_thread_concurrent: pro.kensait.java.advanced.lsn_3_1_2.safe.Shared
synchronized public void addData(int num) { //【1】
    int tmp = this.data + num;
    sleepAWhile(10);
    this.data = tmp;
}
- 【1】メソッド全体が同期化され、「読み出し・計算・書き戻し」の途中に他のスレッドが入れなくなります。
-
lsn_3_1_2.safe.Mainを実行すると、最終的な値は常に30になります。 - ロックの取得と解放は、同時に可視性も保証します。同期化した書き込みの値は、同じロックを取得した読み出しから見えます。
ロックを持つスレッドと待つスレッドの関係を、図で示します。

- ヒープ上の
Sharedインスタンスに、鍵のアイコンの付いた「ロック(モニター)」がある - スレッド1がロックを取得して
addData()を実行している(状態RUNNABLE) - スレッド2は同じロックを取得しようとして入口で待たされている(状態BLOCKED)
- スレッド1がメソッドを抜けてロックを解放すると、スレッド2がロックを取得して
addData()に入る - 下に「同じオブジェクトのロックを使うスレッド同士だけが排他される」と注記がある
同期化は「同じロック」を使うときだけ効果があります。読み出しのgetData()を同期化しない、書き込みごとに別のロックを使う、といった誤りは、テストでは見つけにくい典型的な不具合です。
レビューの観点
- 共有インスタンスのフィールドに対する「読み出し→判定・計算→書き込み」(例:
count++、if (x == null) x = new ...)が、1つのロックの中で行われているか - そのフィールドに触れるすべての経路(書き込みだけでなく読み出しも)が、同じロックで同期化されているか
- 停止の合図などのフラグを、
volatileも同期化も無しに別スレッドから書き換えていないか -
volatileを付けただけでcount++をスレッドセーフだと思い込んでいないか - 同期化の範囲が広すぎないか。ロックの中でネットワーク通信や
sleep()などの時間のかかる処理をしていると、他のスレッドが長く待たされる
3.1.4 デッドロックと明示的なロック
本レッスンでは、複数のロックを使うときに起きるデッドロックの仕組みと、その防ぎ方、ReentrantReadWriteLockによる明示的なロックを取り上げます。
デッドロックの発生の仕組み
スレッドが2つのロックを取得するとき、スレッドごとに取得の順番が異なると、お互いが相手のロックの解放を待って処理が止まることがあります。これをデッドロックと呼びます。
デッドロックが発生する様子を、図で示します。

- ①スレッドt1はインスタンスAのロックを取り、スレッドt2はインスタンスBのロックを取る
- ②スレッドt1は、インスタンスBのロックの解放を待つ
- ②スレッドt2は、インスタンスAのロックの解放を待つ
- お互いが相手のロックの解放を待ち、処理が停止する
デッドロックが発生するスレッドのコードを以下に示します。
- 03_thread_concurrent: pro.kensait.java.advanced.lsn_3_1_2.deadlock.DeadlockThread
@Override
public void run() {
    while (true) {
        synchronized (shared1) { //【1】
            shared1.addData(num);
            synchronized (shared2) { //【2】
                shared2.addData(num);
            }
        }
    }
}
- 【1】まず
shared1のロックを取得します。 - 【2】
shared1のロックを保持したまま、shared2のロックを取得します。 -
lsn_3_1_2.deadlock.Mainは、t1にはinstanceA、instanceBの順に、t2には逆のinstanceB、instanceAの順に渡します。しばらくは順調に出力が続きますが、いずれ出力が止まり、プログラムは終了しないまま停止します。
デッドロックは、2つのスレッドの処理が特定の順序で重なったときだけ起こります。その時間の流れを、タイムラインで確かめます。

- 横軸は時間で、上がスレッドt1、下がスレッドt2の帯である
- 時刻1でt1がAのロックを取得し、ほぼ同時にt2がBのロックを取得する
- 時刻2でt1がBのロックを要求して待機(BLOCKED)に入り、t2がAのロックを要求して待機(BLOCKED)に入る
- 時刻2以降、両方の帯が「BLOCKED」のまま右端まで続き、どちらも進まない
- 上の余白に「順序がずれたタイミングでは起きないため、テストを何度か通っても安心できない」と注記がある
ロックの順序の統一
デッドロックを防ぐ基本は、すべてのスレッドでロックを取得する順序を統一することです。順序が同じなら、先にAを取得したスレッドだけがBへ進めるため、循環した待ちが生まれません。
ロックの順序をそろえた場合とそろえない場合を、図で比べます。

- 左は「順序がばらばら」で、t1はA→B、t2はB→Aの順に取得し、AとBの間に循環する待ちの矢印ができる
- 右は「順序を統一」で、t1もt2もA→Bの順に取得し、t2はAの前で待つだけで循環ができない
- 右の下に「例: IDの小さいインスタンスから順にロックする」とルールの例がある
- 左に「デッドロックの可能性あり」、右に「デッドロックしない」のラベルがある
ほかにも、ロックを保持したまま別のロックを取らない設計にする、LockインタフェースのtryLock()でタイムアウト付きで取得を試み、取れなければ持っているロックを解放してやり直す、といった方法があります。
ReentrantReadWriteLockによる明示的なロック
java.util.concurrent.locksパッケージのロックを使うと、ロックの取得と解放をメソッドで明示的に行えます。ReentrantReadWriteLockは、読み込みロックと書き込みロックを使い分けられるロックです。
- 03_thread_concurrent: pro.kensait.java.advanced.lsn_3_1_2.readwritelock.Shared
private ReentrantReadWriteLock lock = new ReentrantReadWriteLock();

public void addData(int num) {
    WriteLock writelock = lock.writeLock();
    writelock.lock(); //【1】
    try {
        int tmp = this.data + num;
        sleepAWhile(10);
        this.data = tmp;
    } finally {
        writelock.unlock(); //【2】
    }
}
// getData()はreadLock()で同じように読み込みロックを取得・解放する(省略)
- 【1】書き込みロックを取得します。書き込みロックを持つスレッドがいる間、他のスレッドは書き込みロックも読み込みロックも取得できません。
- 【2】
unlock()は必ずfinallyブロックで呼びます。例外が発生しても確実に解放するためです。synchronizedと異なり、解放を忘れるとロックは永久に保持されたままになります。
読み込みロックと書き込みロックの関係を、図で示します。

- 左の「読み込みロック」には、読み込みスレッド1、2、3が同時に入っている(読み込み同士は待たない)
- 右の「書き込みロック」には、書き込みスレッドが1つだけ入っており、他の読み込みスレッドと書き込みスレッドは外で待っている
- 中央の表に「読み込み+読み込み=同時に可」「読み込み+書き込み=待つ」「書き込み+書き込み=待つ」の3行がある
- 下に「読み込みが多く書き込みが少ないデータに向く」と注記がある
レビューの観点
- 2つ以上のロックを入れ子で取得していないか。取得している場合、すべての経路でロックの順序がそろっているか
-
lock()の直後にtryがあり、unlock()がfinallyの中にあるか。lock()をtryの中に書いて、取得に失敗したのにunlock()を呼ぶ形になっていないか - ロックを保持したまま、外部のコード(コールバック、リスナー、他のクラスの
synchronizedメソッド)を呼び出していないか。相手の中で別のロックを取るとデッドロックの原因になる - プログラムが止まったときは、スレッドダンプで
BLOCKEDのスレッドと、それぞれが待っているロックを確かめる
3.1.5 wait()とnotify()によるスレッド間通信
本レッスンでは、共有インスタンスを介して、あるスレッドが条件を満たすまで別のスレッドを待たせる仕組みを取り上げます。実際の開発ではチャプター3.3の同期化支援や並行コレクションを使うことが多いため、ここでは仕組みと、低レベルのAPIを使うコードの誤りを見抜く観点に絞ります。
ウェイトセットの仕組み
すべてのインスタンスは、待機中のスレッドを格納する「ウェイトセット」を持っています。ロックを持ったスレッドがwait()を呼ぶと、ロックを解放してウェイトセットに入り、待機します。別のスレッドが同じインスタンスのnotify()(1つだけ再開)またはnotifyAll()(すべて再開)を呼ぶと、待機していたスレッドが再開します。いずれもjava.lang.Objectのメソッドで、synchronizedの中で呼ぶ必要があります。
ウェイトセットを介した2つのスレッドの協調を、図で示します。

- ウェイトセットは、スレッドA・Bで共有されたインスタンスが持つ
- スレッドAがwait()メソッドを呼び出すと、ウェイトセットに入り、続きの処理を待機する
- スレッドBがnotify()/notifyAll()メソッドを呼び出すと、ウェイトセットに通知が届く
- 通知を受けたスレッドAは、ウェイトセットから出て処理が再開される
計算結果を待つ具体例
FooThreadは、BarThreadが5秒かけて計算した結果を、共有するSharedインスタンスを介して受け取ります。
- 03_thread_concurrent: pro.kensait.java.advanced.lsn_3_1_3.Shared
public synchronized Integer getAndWaitData() {
    if (data == null) { //【1】
        try {
            wait(); //【2】
        } catch (InterruptedException ie) {
            throw new RuntimeException(ie);
        }
    }
    return data;
}

public synchronized void setAndNotifyData(Integer data) {
    this.data = data;
    notify(); //【3】
}
- 【1】計算結果がまだ無いかを確かめます。
- 【2】結果が無ければ、ロックを解放してウェイトセットで待機します。
- 【3】
BarThreadが結果を格納し、待機中のスレッドに通知します。通知を受けたFooThreadはロックを取得し直してからwait()から戻り、12345を受け取ります。
2つのスレッドの時間の流れを、タイムラインで確かめます。

- 横軸は時間(0秒〜5秒)で、上がFooThread、下がBarThread、中央に共有インスタンス
Shared(data = null)の帯がある - 0秒の時点で、FooThreadが
getAndWaitData()を呼び、dataがnullのためwait()でウェイトセットに入る(WAITING) - BarThreadは0秒から5秒まで計算を行う
- 5秒の時点で、BarThreadが
setAndNotifyData(12345)を呼び、dataが12345になりnotify()が届く - FooThreadがロックを取得し直して再開し、「result => 12345」を表示する
whileで条件を確かめ直す
このサンプルは分かりやすさのためifでwait()を呼んでいますが、通知が無くてもスレッドが再開することがあり(スプリアスウェイクアップ)、notifyAll()で複数のスレッドが再開した場合は、条件がすでに満たされていない可能性もあります。そのためwait()は、条件を確かめ直すループの中で呼ぶのが定石です。
ifとwhileの違いを、図で比べます。

- 左の
if版では、再開したスレッドが条件を確かめ直さずにreturn dataへ進み、nullを返してしまう経路がある - 右の
while版では、再開したスレッドがwhile (data == null)に戻り、条件が満たされていなければ再びwait()する - 左に「スプリアスウェイクアップ・他スレッドの先取りで誤動作」、右に「条件が満たされたときだけ先へ進む」のラベルがある
レビューの観点
-
wait()がwhileループの中で呼ばれているか(ifになっていないか) -
wait()/notify()が、条件となるフィールドと同じオブジェクトのロック(synchronized)の中で呼ばれているか。そうでないとIllegalMonitorStateExceptionになる - 待機するスレッドが複数あり得るのに
notify()を使っていないか(起こしたいスレッドが起きない)。迷う場合はnotifyAll()にする - そもそも
wait()/notify()を自作する必要があるか。CountDownLatchやBlockingQueue(チャプター3.3参照)、Future(チャプター3.2参照)で置き換えられないか
3.1.6 共有しない設計:イミュータブルとスレッドローカル
本レッスンでは、ロックで守るのではなく「書き換えられる状態を共有しない」ことでスレッドセーフにする設計を取り上げます。同期化よりも単純で誤りが入りにくいため、設計を指示するときにまず検討する選択肢です。
イミュータブルなオブジェクト
イミュータブルとは、インスタンスの生成後に値を変更できないことです(Udemyコース「新・Java Basic編・AI対応版」参照)。書き換えが起きないため、何も同期化しなくても、複数のスレッドから安全に読めます。String、ラッパークラス、BigDecimal、レコードクラス(チャプター9.1参照)、List.of()で作ったリストなどがイミュータブルです。
- 03_thread_concurrent: pro.kensait.java.advanced.lsn_3_1_2.immutable.MyThread
@Override
public void run() {
    for (int i = 0; i < 10; i++) {
        property = property + "!"; //【1】
    }
}
- 【1】文字列の連結は、元の
Stringを書き換えるのではなく、新しいStringを生成して自分のフィールドに代入し直します。 -
lsn_3_1_2.immutable.Mainで同じ"foo"を2つのスレッドに渡しても、互いに影響せず、両方ともfoo!!!!!!!!!!になります。
ただし、フィールドをfinalにしただけでは不十分です。参照先のオブジェクトが書き換え可能なら、その中身は変えられてしまいます。

- 左の「浅いイミュータブル」では、
finalフィールドitemsがヒープ上のArrayListを指し、ゲッターで受け取った別のスレッドがadd()で中身を書き換えている - 右の「完全なイミュータブル」では、
finalフィールドitemsがList.of()で作った変更できないリストを指し、add()はUnsupportedOperationExceptionになる - 左に「参照は変わらないが中身が変わる」、右に「参照も中身も変わらない」のラベルがある
- 下に「コンストラクタで受け取ったリストは
List.copyOf()でコピーして保持する」と注記がある
スレッドローカル
スレッドローカル(java.lang.ThreadLocal)は、スレッドごとに別々の値を持つ変数です。同じThreadLocalの変数を参照しても、スレッドごとに異なる値が返るため、値は他のスレッドと共有されません。
- 03_thread_concurrent: pro.kensait.java.advanced.lsn_3_1_4.ThreadLocalHolder
public class ThreadLocalHolder {
    private static ThreadLocal<Map<String, String>> context =
            new ThreadLocal<>() { //【1】
        @Override
        public Map<String, String> initialValue() {
            return new HashMap<String, String>();
        }
    };

    public static Map<String, String> get() {
        return context.get(); //【2】
    }
}
- 【1】
initialValue()をオーバーライドし、スレッドごとの初期値として空のHashMapを生成します。ThreadLocal.withInitial(HashMap::new)と書いても同じです。 - 【2】呼び出したスレッドに固有のマップを返します。
-
lsn_3_1_4.MyThreadはrun()でキー"name"に"Alice"を格納し、引数を渡さずに呼び出したFoo#process()の中で、同じキーで"Alice"を取り出します。
スレッドローカルの値が、どこに保持されているかを図で確かめます。

- ヒープ上に
ThreadLocalの変数contextが1つある - スレッドAとスレッドBは、それぞれ自分専用の格納領域を持ち、その中に
contextをキーとしたマップがある - スレッドAの領域には{name=Alice}、スレッドBの領域には{name=Bob}が入っている
- スレッドAの
MyThread#run()とFoo#process()は、引数を経由せずに同じ{name=Alice}にたどり着く
スレッドプールでの値の残留とスコープ付き値
アプリケーションサーバーやExecutorでは、スレッドはプールされて使い回されます。スレッドローカルの値をremove()で消さないと、前のリクエストの値が次のリクエストに残ります。

- スレッドプールのスレッド①が、リクエスト1でスレッドローカルに「ユーザー: Alice」を格納する
- リクエスト1が終わっても
remove()されず、スレッド①はプールに戻る - スレッド①がリクエスト2(ユーザーBob)に割り当てられ、スレッドローカルから「Alice」を読んでしまう
- 右に「対策」として
try { … } finally { holder.remove(); }のコードと「必ず消す」の注記がある
また、スレッドローカルは同じスレッドの中に限定されたグローバル変数のようなもので、多用すると処理の流れが追いにくくなります。仮想スレッドを大量に起動する場合は、スレッドごとの値がメモリーの使用量を増やします。Java 25では、スコープ付き値(Scoped Values、java.lang.ScopedValueクラス)が正式な機能になりました。値を共有できる範囲をメソッドの呼び出しの範囲に限定し、その範囲を抜けると自動的に破棄される仕組みで、スレッドローカルに代わる選択肢です。
レビューの観点
- 複数のスレッドで共有するクラスを、イミュータブル(
finalフィールド、セッターなし、可変オブジェクトは防御的にコピー)にできないか。設計の段階でまず検討する -
finalフィールドがArrayListや配列などの可変オブジェクトを指し、それをゲッターでそのまま返していないか - スレッドローカルに値を格納するコードに、
finallyでのremove()が対になっているか - スレッドローカルを、引数で渡せば済む値の受け渡しに使っていないか
3.1.7 仮想スレッド
本レッスンでは、Java 21で正式な機能になった仮想スレッドの仕組みと、向いている処理・向いていない処理を取り上げます。AIが「仮想スレッドにすれば速くなる」と提案したときに、その妥当性を判断できるようになります。
プラットフォームスレッドと仮想スレッド
これまでのスレッドは、OSのスレッドと1対1に対応するプラットフォームスレッドです。生成や切り替えのコストが大きく、同時に起動できる数に限りがあるため、スレッドプールで使い回してきました。仮想スレッドは、JVMが管理する軽量なスレッドで、少数のプラットフォームスレッド(キャリアスレッド)の上で実行されます。
2種類のスレッドとOSのスレッドの対応を、図で比べます。

- 左の「プラットフォームスレッド」では、Javaのスレッド3本がOSのスレッド3本とそれぞれ1対1に対応する
- 右の「仮想スレッド」では、多数の仮想スレッド(V1〜V8など)が、少数のキャリアスレッド(C1、C2)の上で順番に実行される
- キャリアスレッドはOSのスレッドと1対1に対応する
- 左の下に「数千程度が上限の目安・プールで使い回す」、右の下に「数十万以上も可能・タスクごとに生成して使い捨てる」と注記がある
マウントとアンマウント
仮想スレッドがネットワーク通信やファイルの入出力などで待ち状態になると、JVMはその仮想スレッドをキャリアスレッドから外し(アンマウント)、別の仮想スレッドを載せて実行します(マウント)。待っている間にOSのスレッドを占有しないため、待ち時間の長いタスクを大量に同時実行できます。
キャリアスレッドの上で仮想スレッドが入れ替わる様子を、タイムラインで示します。

- 横軸は時間で、1本のキャリアスレッドC1の帯がある
- 最初にV1がC1に載って実行し、V1がHTTP通信の応答待ちになるとC1から外れる
- 空いたC1にV2が載って実行し、V2もデータベースの応答待ちになると外れて、空いたC1にV3が載る
- V1の応答が届くと、V1は再びC1(または別のキャリアスレッド)に載って続きを実行する
- 下に「待ち時間の間もキャリアスレッドは働き続ける」と注記がある
仮想スレッドもThreadクラスのインスタンスで、これまでと同じAPIを使えます。
Thread vt = Thread.ofVirtual() //【1】
        .name("virtual-foo")
        .start(() -> { //【2】
            System.out.println("isVirtual => " + Thread.currentThread().isVirtual());
            sleepAWhile(1000);
        });
vt.join(); //【3】
- 【1】
Thread.ofVirtual()で仮想スレッド用のビルダーを取得します。 - 【2】
start()にタスクを渡すと、仮想スレッドが生成・起動されます。Thread.startVirtualThread(タスク)とも書けます。 - 【3】
join()などのAPIは、プラットフォームスレッドと同じです。多数のタスクを実行する場合は、Executors.newVirtualThreadPerTaskExecutor()(チャプター3.2参照)を使います。
仮想スレッドは、待ち時間の長い処理を大量にこなすための仕組みで、計算処理そのものを速くするものではありません。CPUを使い続けるタスクでは、CPUのコア数以上に速くなりません。なお、Java 21ではsynchronizedの中で待ち状態になると仮想スレッドがキャリアスレッドを占有し続ける問題(ピン留め)がありましたが、Java 24でsynchronizedによるピン留めは解消されました(ネイティブメソッドの実行中などは、引き続きピン留めが起きます)。
レビューの観点
- 仮想スレッドを使う理由が「待ち時間の長いI/Oを大量に同時実行する」ことになっているか。計算処理の高速化を目的にしていないか
- 仮想スレッドをプールしていないか。仮想スレッドはタスクごとに生成し、使い捨てる
- 仮想スレッドで同時実行数が増えた結果、データベースの接続数や外部APIの呼び出し回数の上限を超えないか。上限がある資源には、同時実行数を制限する仕組み(接続プールなど)が必要である
- 仮想スレッドごとに大きな値をスレッドローカルに持たせていないか
このチャプターで学んだこと
本チャプターでは、以下を取り上げました。
- スレッドごとのスタックと共有されるヒープの関係と、共有インスタンスのフィールドが並行処理の不具合の源になることについて
- スレッドの状態遷移、
join()による待ち合わせ、interrupt()による協調的な停止と、割り込みを握りつぶさないことについて - 競合状態と可視性の仕組み、
synchronizedとvolatileの役割と限界について - デッドロックの発生の仕組みとロックの順序の統一、
ReentrantReadWriteLockのfinallyによる確実な解放について -
wait()/notify()の仕組みと、条件をwhileで確かめ直すことについて - イミュータブルとスレッドローカル・スコープ付き値による「共有しない設計」と、仮想スレッドの向き・不向きについて